第 5 节 / 共 5 节
加餐:面试复盘
面试复盘
一、面试中的主要问题
1、项目准备不充分
现象:简历里的项目看上去太简单或者有严重缺陷,项目必要性存疑
方案和需求之间不匹配,合理性存疑
无法给出技术方案细节和项目成果细节
和面试官沟通比较表面化,谈不到关键点上
本质:没有实际操作一个项目从背景调查、方案选型、组件选型、开发测试、上线部署、总结反思的全过程
即使考虑过某些点,但是没有系统化思考,没有落实到纸面上,并思考合理性。
2、RAG和Agent这两个体系说不清楚
现象:无法理清整体结构,并系统化的表述出来
无法说明关键节点(要怎么做?为什么这么做?有哪些候选?可能发生哪些问题?怎样改进?)
无法说清项目实施中可能会发生哪些问题,怎样改进
无法说清项目还有哪些改进空间
本质:只是跟着老师把课程走了一遍,没有总结归纳,没有深入思考
3、基础知识不扎实
现象:神经网络和大模型的基础知识只知道大概,不知道细节,只能泛泛而谈,禁不起追问。中间有不少错误
也有可能确实了解,但是表达成问题,无法系统性地把问题讲清楚
本质:基础理论部分只听课,没有复习,没有深入思考
4、与面试官谈话无法掌握主动权
现象:信心不足,现场露怯
表达能力差,无法系统化地说明一个复杂系统
容易被面试官带到非核心项目上,然后卡死在细节上
容易被面试官带偏到一个不熟悉的领域,被单方面暴打
本质:准备不够充分,没有考虑谈话方式
二、项目准备
自信心不是一种心理概念,是物理概念
永远不要相信以弱胜强,但要相信善于发挥主观能动性,可以造成整体弱但是局部强
项目文档是面试者的内功,没有这个基础,其他工作都是花拳绣腿。
1、什么是项目经验?
项目经验是你亲身经历一个项目背景调查、方案选型、组件选型、开发测试、上线部署、总结反思全流程时产生的总结和思考,没有这个经历无法构成项目经验,没有总结和思考,也无法构成项目经验
     刚入职的实习生,从未经历过任何项目实战,自己也从未考虑过项目怎样落地
     打扫卫生的阿姨,跟了一个项目组10年,历经大小项目40多个
     5年工作经验,主要在做开发,项目调研、方案选型等环节基本上附和项目组里的大牛,很少思考项目收益和改进方案。
     入职一年,多次提出项目改进建议,部分建议被采纳,被驳回的建议虚心请教其中缺陷,并实操验证
     没有实战经验,但曾在多个业务场景下模拟做方案,并对关键环节进行过实操验证,对各种做法的优缺点有一定的了解
项目经历可以模拟,可以自己动手实操,不一定非要在企业里实际经历,但是总结和思考无法替代。
2、 为什么要准备项目文档?
总体实力:敌强我弱,只有把谈话限于某个特定范围,才有取胜的机会
怎样选取这个范围?
业务上强于对手(面试者的权威超过面试官)
技术上不弱于对手(双方可以对等讨论)
3、核心项目与非核心项目
虚与实
关键领域要能和面试官硬碰硬,必须有核心项目作为支撑点
要造成更大的声势,表明还经历过更多领域,做过更多项目
4、 项目数量
如果是应届生,可以一个核心项目加一个非核心项目
1-3年工作经验,至少两个核心项目加两个非核心项目
3年以上工作经验,可以3个核心项目,多个非核心项目,总体不超过7个,选取典型项目,质量大于数量(因为已经有很多项目经验)
5、 核心项目和非核心项目怎样准备?
参见《怎样组织项目文档》
非核心项目可以适当化简,整体方案和关键点要能讲清楚,细节数据可以记不清楚,但数量级要正确
6、项目架构示例
办公助手
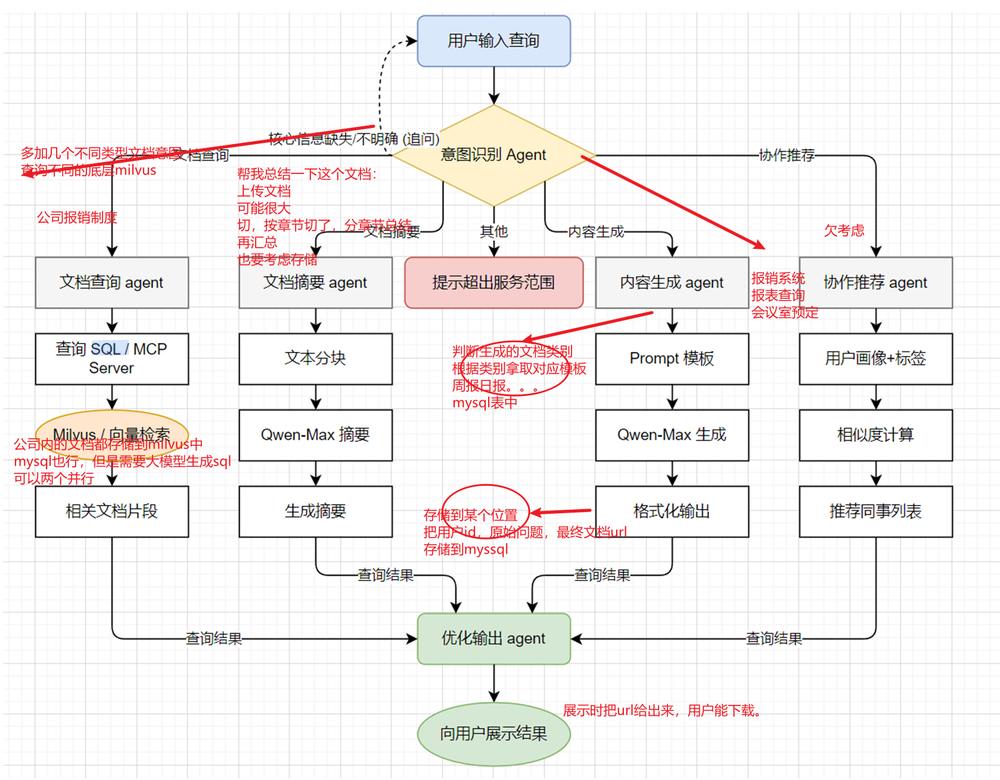
主要问题:
a、实际需求存疑,文档查询用这套体系会比较吃亏;摘要这个需求实际价值是什么;内容生成不可能这么简单;协作推荐有推荐系统,速度快,质量高,为什么要用智能体来做?
b、有较严重的结构缺陷,内容生成不需要检索资料?没有MCP?
c、难以想象这个项目的资金投下去会产生什么收益
金融理财
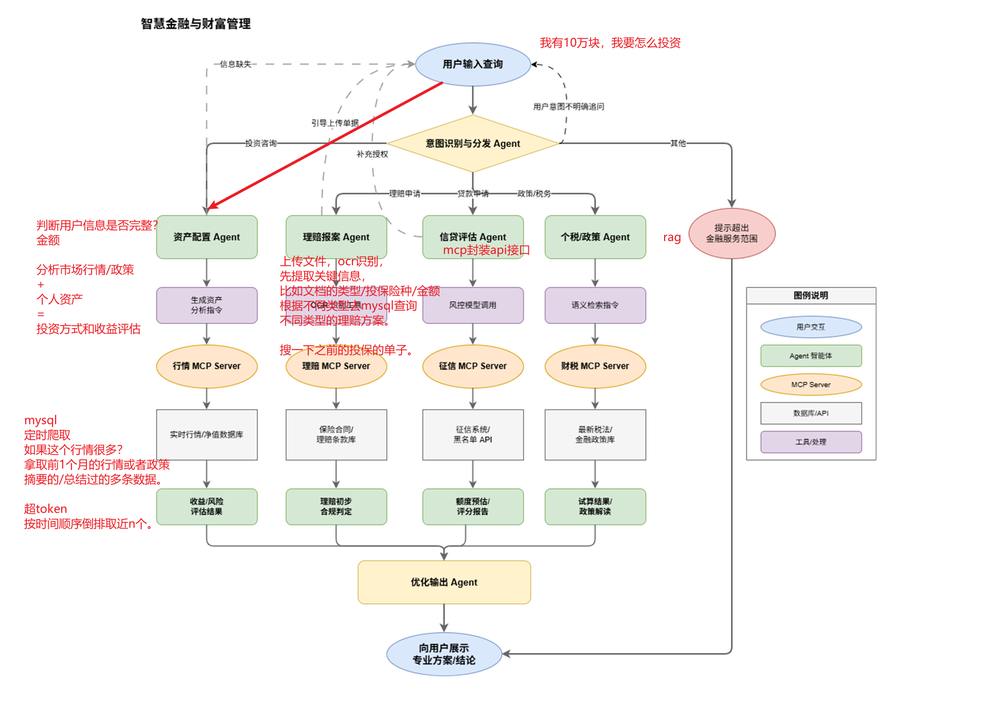
优点:
a、垂直领域选取比较好
b、整体结构比较合理,没有明显功能缺失
缺点:
a、金融理财的子领域远远大于图中描绘的内容,至少还应包括:国家政策与金融监管,严格的端到端加密和生物识别认证,各个金融子市场(股票、债券、期货、贵金属等)行情获取与机会推荐,用户信息收集与画像,第三方接口(支付软件、银行、各金融子市场软件)
b、资产配置不仅仅和行情有关,还必须了解当事人现有资产分配情况
d、行情数据用爬虫爬取不可靠,关键信息要使用商用数据
d、理赔报案不仅仅只有保险合同和理赔条款,涉及到身份验证、投保单调取、定损、核查、理赔方案等一系列的业务步骤
e、信贷评估不仅和征信系统有关,还包括现有资产配置,各类配置风险评估,整体风控汇总,个人已有信贷记录、个人消费记录等一系列因素
财务助手
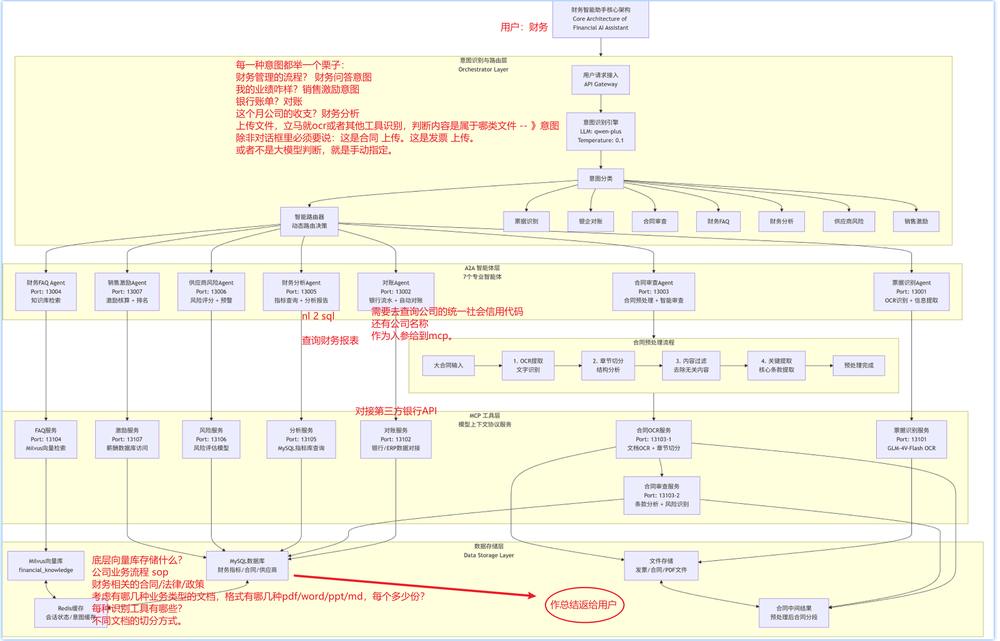
优点:
a、垂直领域选取比较好
b、整体结构很完整,几个子领域基本覆盖了财务日常办公的大部分需求
c、技术架构合理,各智能体功能切分比较好;A2A-MCP的架构运用合理,综合运用多种存储中间件,各司其职;
缺点:
a、兜底方案在哪里?
b、业务需要进一步细化,例如:对账不光需要对接银行数据,还需要对接企业信息数据库;供应商风险还需要对接企查查之类的企业信息平台查询经营情况,投资情况、法律纠纷与判决结果等
c、自动化程度需要进一步提升,可以根据上传文件类型分析用户意图,而不是每次都要用户给出明确指令。
三、RAG和Agent两个体系说不清楚
描述一个复杂体系,要考虑描述的思路或者逻辑性
基本符合“总-分-总”的结构,先从整体上描述全貌,再逐一解析关键点,最后指出其中的薄弱环节和改进措施
agent的体系描述参照《怎样组织项目文档》
下面主要看一下RAG系统
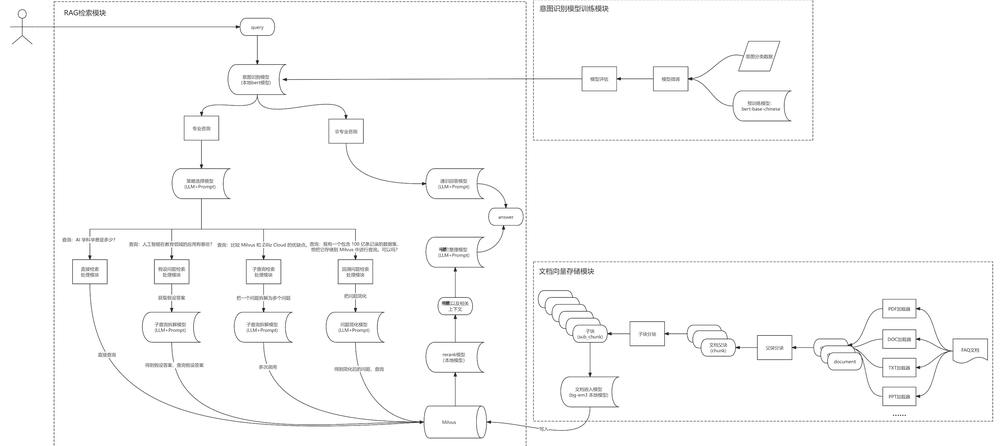
任意复杂度的RAG系统都可以看作两条主要的业务流:数据入库和用户检索
简单RAG系统要解决的主要问题是:
-
文本资料如何读入
-
文本块怎样切分
-
用哪个嵌入模型
| 模型名称 | 核心优点 | 主要缺点 | 典型适用场景 |
|---|---|---|---|
| Word2Vec | 轻量快速,适合大规模文本训练,生成低维稠密向量 | 静态词表示,无法区分一词多义,忽略上下文语义 | 早期简单文本分类、词相似度计算场景 |
| GloVe | 基于全局词统计生成向量,能更好捕捉词间语义关系 | 依赖大规模语料的全局统计数据,动态语义适配差 | 通用词向量预训练、传统NLP基础任务 |
| BERT / Sentence-BERT | 动态感知上下文语义,解决一词多义问题,适配绝大多数NLP任务 | 计算复杂度高,资源占用大,原生长文本处理能力有限 | 通用语义匹配、基础句向量生成场景 |
| BGE系列(bge-small/base/large/m3) | 中英双语能力强,中文语义理解精准,支持多语言,RAG场景表现优异 | 部分小众语种支持不足,极端专业领域需微调 | 中文RAG知识库、多语言检索、语义匹配系统 |
| E5 / E5-v2 | 通用泛化性强,效果稳定,基于对比学习优化嵌入质量 | 中文原生适配弱于国产模型,长文本处理成本高 | 通用英文检索、跨领域语义相似度任务 |
| GTE系列 | 阿里开源,中英文表现均衡,1024维版本兼顾精度与效率,支持超长文本大维度版本 | 超大维度版本存储和计算成本指数上升 | 中文企业级搜索、高精准度语义匹配场景 |
| MiniLM / DistilBERT | 极致轻量,推理速度极快,资源占用极低 | 语义表达能力有限,复杂任务精度不足 | 低配置设备部署、高并发轻量检索场景 |
| nomic-embed-text | 嵌入质量高,易集成,文档生态完善,速度与精度平衡 | 原生侧重英文优化,非英文语种支持一般,资源消耗略高 | 英文为主的RAG系统、快速搭建向量检索原型 |
| OpenAI text-embedding-3系列 | 闭源API调用便捷,支持超长上下文,泛化性强 | 数据需外传,调用成本随量级上升,无本地化权限 | 海外业务快速落地、无需本地部署的通用语义任务 |
- 用哪个向量数据库
| 数据库 | 主要场景 | GPU加速 | 标量字段 | 核心特点 | 适用规模 |
|---|---|---|---|---|---|
| Pinecone | SaaS服务,快速上线 | 云端自动 | ✅ | 全托管,API简单 | 中小型项目 |
| Chroma | 开发测试,轻量应用 | ❌ | ✅ | 轻量,内存优先 | 原型开发 |
| Weaviate | 生产级应用 | 可选 | ✅ | 多模态,GraphQL | 中大型系统 |
| Milvus | 大规模向量检索 | ✅ | ✅ | 分布式,高性能 | 超大规模 |
| Qdrant | 高性能场景 | ✅ | ✅ | Rust编写,云原生 | 生产环境 |
| FAISS | 研究开发 | ✅ | ❌ | 纯向量库,灵活 | 算法研究 |
-
怎样检索候选块
-
怎样写提示词
-
用哪个大模型整合结果
这些既是容易出问题的点,也是有可能调优产生重大优化效果的点
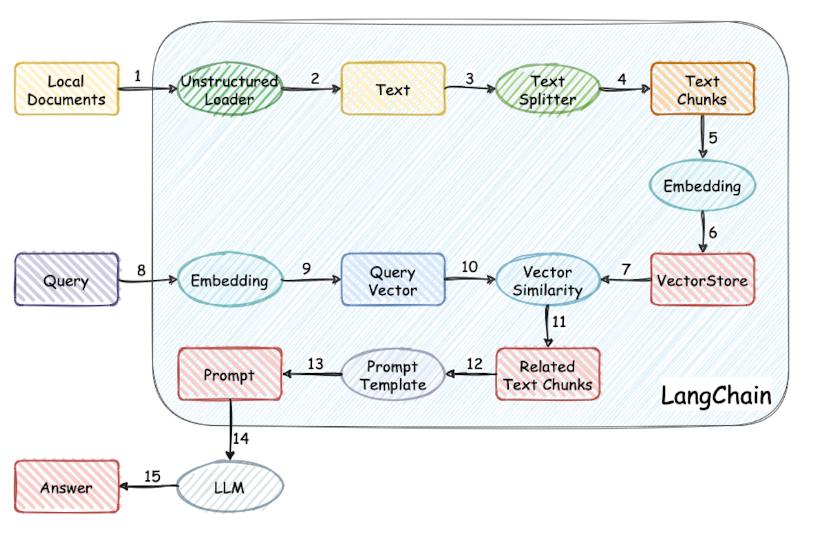
复杂RAG系统在此基础上,增加了更多的细节
- 各种格式和内容的资料如何读入
- 父子切块
- 意图识别
- 意图改写
- 稀疏向量检索与稠密向量检索
- 重排序
四、怎样写简历?
1、你的目的是什么?
求职
让人第一眼看到你为什么适合这个岗位
尽量不要添加噪声
绝不要让人误解,认为你不合适这个岗位
2、什么该写,什么不该写?
与根本目标一致的内容展开写
智能体、RAG系统、大模型微调、多模态应用
主要技能、核心项目、关键技术点、项目收益
与根本目标无关的内容尽量不写
个人兴趣爱好(除非能展现你对人工智能领域的热爱)
自我评价(除非能展现你对人工智能的进一步认知)
无效的自我评价
本人性格沉稳细致,有较强的执行力和问题解决能力,能快速适应新环境与新岗位要求。工作中注重团队协作,善于倾听他人意见,对待任务严谨负责,确保各项工作按时保质完成。
拥有扎实的专业基础,学习能力较强,乐于主动接触新领域知识。日常工作中习惯提前梳理目标、拆解进度,遇到问题能主动复盘优化,希望能在岗位上为团队创造实际价值。
待人真诚友善,沟通表达顺畅,既能独立完成分配的工作,也能配合团队推进跨部门项目。对待工作始终保持积极心态,愿意从基础做起,在实践中不断提升自身能力。
有效的自我评价
长期聚焦风电运维智能化、RAG、多智能体与大模型应用,对领域知识建模、模型微调和系统优化有持续积累。
对人工智能领域的新技术有强烈的学习兴趣,最近正在关注以Kimi-K3、qwen3.6等原生多模态模型,也读了一些论文,包括《Scaling Laws for Native Multimodal Models》和《UniDDT: Unifying Multimodal Understanding and Generation with Decoupled Diffusion Transformer》
具备较强的工程落地和跨团队协作能力,能够在复杂业务场景中快速推进智能体项目开发、调优和落地。
与根本目标相冲突的内容绝对不写(不说),同一个事实可以用很多个角度观察
我之前做市场营销--最近我很深入地学习了大模型和智能体

没有真实落地项目--仔细研究了某个项目

在项目里打杂--负责项目里的**工作(你亲眼看见牛人们做过的,可以自己复现)

          --项目的整体架构、技术方案(你参加项目讨论会亲耳听到牛人们激烈争论过的)

在上家公司干不下去了跑路--希望使用更多的新技术,谋求更好的个人发展
3、什么先写,什么后写?
酒香也怕巷子深
操作系统给和语言:熟练掌握Python、Linux常用命令,代码风格规范,注重可维护性。
框架与算法:掌握PyTorch,对主流NLP算法(如文本分类、命名实体识别、关系抽取)有丰富实践。
模型原理:深入掌握RNN/LSTM/GRU等经典序列模型,并对Transformer架构及多头Attention机制有深入理解。
知识图谱与 GraphRAG:具备知识图谱建模与 GraphRAG 检索增强实践经验,能够将图谱查询与向量召回融合用于多跳推理和根因分析。
预训练模型:熟练掌握 BERT、GPT 等预训练模型,具备 PEFT 轻量化微调经验,熟悉 LoRA / QLoRA 等参数高效训练方法,可用于领域问答、文本分类和实体抽取任务。
RAG与检索增强:具备完整的 RAG 系统设计与实现经验,熟悉结构化检索、向量检索、混合检索、重排序、Parent-Child Chunking 与 Query Routing。
多智能体与编排:深入理解 A2A、MCP,熟悉 LangGraph / LangChain 等智能体框架,能够构建有状态、多步骤、多角色的 Agent 编排流程。
AI编程:熟练掌握Vibe Coding能力,使用ClaudeCode、Cursor、WorkBuddy等工具提升研发效率。
前后端交互:RestfulAPI、WebSocket、GraphQL等形式。
前端技术:熟练掌握Vue、ElementUI、Websocket、NodeJS、TS等前端开发技术和框架。
开发工具:熟练使用Git、VS Code、Pycharm等开发工具。
```
多智能体与编排:深入理解 A2A、MCP,熟悉 LangGraph / LangChain 等智能体框架,能够构建有状态、多步骤、多角色的 Agent 编排流程。
RAG与检索增强:具备完整的 RAG 系统设计与实现经验,熟悉结构化检索、向量检索、混合检索、重排序、Parent-Child Chunking 与 Query Routing。
大模型微调:熟练掌握在垂直领域对大模型进行LoRA微调的技能,对微调过程涉及的数据集处理、模型选型、微调优化、高效部署等环节都非常熟悉。
AI编程:熟练掌握Vibe Coding能力,使用ClaudeCode、Cursor、WorkBuddy等工具提升研发效率。
4、什么详写,什么略写?
核心项目一定要详写,绝不能简略,要充分展示成果,引起对方兴趣和提问
非核心项目一定要略写,最好不要详写。一则言多必失;二则控制简历总长度
五、面试表达
0、信息收集
面试公司的基本业务领域,成就(互联网)
部门的规划,尤其是大模型相关的(hr,面试邀约电话)
团队的核心目标、技术路线与规划(teamleader)
1、紧扣你的目标
面试很短,你说的每一句话都应该围绕求职这个核心目标
你的核心技术能够满足对方的下一步发展需求
2、应该怎么说?
自我介绍只有5分钟(太多?太少?没有重点)
我是谁,我的主要研究方向,我的主要成就,我的主要项目,下一步的发展规划(最好能和目标公司吻合)
结构化描述
总分总结构---总分、并列、综合
- 项目整体背景、整体技术方案
- 关键技术点 1,2,3,4
- 回顾项目收益,总结经验教训
有详有略
核心项目与非核心项目
关键技术点与一般技术点
重点落在哪里?
重点落在你的核心技术与对方需求的结合点上
3、掌握主动权
软性引导对方的谈话范围
通过详略、重点
可以在一段对话需要转换的时候埋勾子。
硬性引导对方的谈话范围
特定业务范围,特定技术范围,不熟悉的方案经过实际语料测试效果较差,充分准备的方案初始表现就很好
非核心项目不够典型,核心项目才能代表你的最高水平
咱们可以现在**范围内讨论,稍后扩展到您说的这个领域
考虑过您说的这个方案,但因为**原因放弃了(成本,保密,效果...)
4、展示诚意,主动了解更多信息
团队未来一年的核心目标,当前进展,难点在哪里?
团队的资源:人员配备,算力,语料
如果我过来,承担什么角色?