第 2 节 / 共 5 节
数据清洗与 BERT P-Tuning 实战
数据清洗
学习目标
- 从哪些角度判断数据是否合格
- 数据有问题怎样处理
一、检查数据集
1 准确性
1.1 粗略检查
1.2 人工抽查
数量抽查
比例抽查
1.3 大模型抽查
见代码a_cleanData.py
2 完整性
如果数据包含多个字段,各个字段缺失情况?关键字段尽量不要缺失
3 一致性
各字段数据是否一致?
日期:"2025-03-12",”二零二五年三月十二日“,”3月十二日“,”二月初六“
性别:”男“,”female“,”未知“,”-1“
4 均衡性
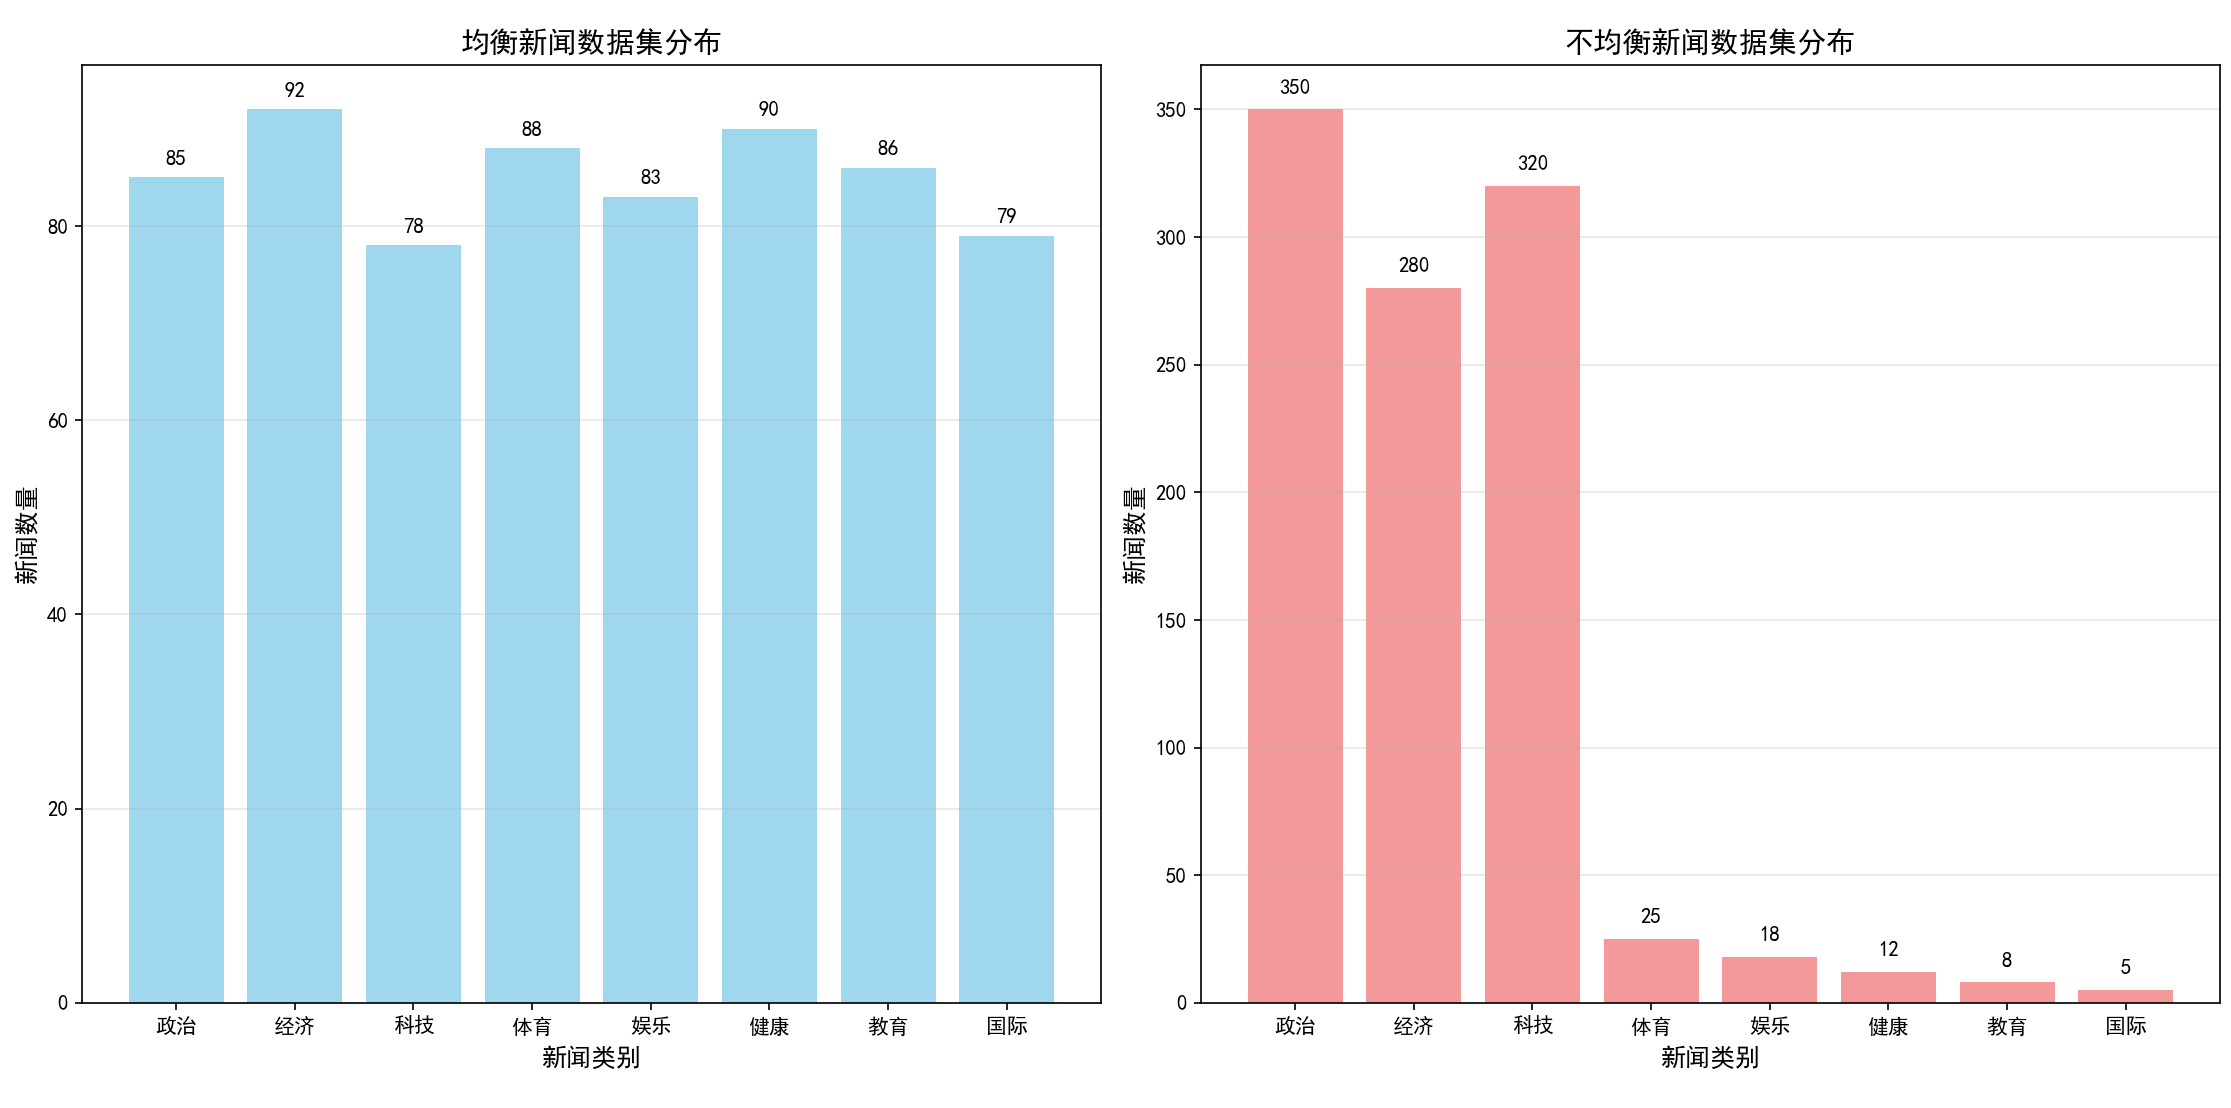
5 文本长度
很多模型有最大长度限制,要注意文本长度,避免引入脏数据。
衣服 在你们家买了多少次了,都是熟客了,你们居然这么不上心,发的货根本不对,在这样的话,下次买家人衣服就不来你们家了。
衣服 在你们家买了多少次了,都是熟客了,你们居然这么不上
如果做截断必须验证正确性
当然也可以考虑直接删除
6 多样性
同一个类别内部也是有结构的,比如评价衣服,可以有颜色、款式、价格、商家态度、发货速度等很多个方面,如果多样性不足,即使样本总量足够,也很可能效果不好。
7 隐藏的0号规则
0号规则高于一切,但需要对行业和需求有深刻洞察。
需求合理吗?
二、数据生成
- 多样性
- 长度
- 分类结果唯一
- 避免显式特征
多任务微调
Qwen+LoRA的多任务微调
一 需求分析
1 背景
电商场景已有任务评论文本分类
衣服 裤子买的非常值得,甚是欢喜,质量和手感都非常的棒
电商场景的进一步发展,有了更多的任务需求,新增识别SPO三元组需求
文本内容:如何演好自己的角色,请读《演员自我修养》《喜剧之王》周星驰崛起于穷困潦倒之中的独门秘笈。
输出结果:[{"predicate": "主演", "object_type": "人物", "subject_type": "影视作品", "object": "周星驰", "subject": "喜剧之王"}]"}
2 需求
- 需要完成分类任务和SPO三元组任务
- 暂时只有一张消费级显卡可供部署,这张卡只能部署一个基座模型。
- 快速上线,快速迭代
- 请求流量较小,每天1000左右
3 资源
- 训练语料较少,没有标注团队支持
- 暂时只有一张消费级显卡可供训练
- 可用算法人员只有你一个
二 方案评估
1 小模型方案
不论是机器学习模型,还是小规模神经网络模型,都存在语料不足的问题,而且效果预期较差
2 预训练模型方案
不擅长处理较复杂的生成任务,预期三元组任务效果较差
3 大模型方案
大参数量模型效果好,但是部署成本过高?
小参数量模型可以满足消费级显卡要求,但预计效果较差,需要微调
三 方案细化
3.1 基座模型选择
怎样选择基座模型?
- 在同体量模型中性能出色
- 一直持续不断更新
国内基座模型研发的巅峰时期是2023年,宣称自研或者发布大模型的企业(市场主体)约有200-300家,科研机构、高校、非盈利机构等约2000家,各个模型系列的性能差异很大。
2026年市场大洗牌后,被认为有持续迭代能力的有10家左右。很多的模型系列停止更新,退出竞争。
比较典型的系列有ChatGLM(注意:不是GLM),和baichuan
| 模型名称 | 发布时间 |
|---|---|
| ChatGLM-6B | 2023年3月 |
| ChatGLM2 | 2023年6月 |
| ChatGLM3 | 2023年10月 |
| ChatGLM4 | 2024年1月 |
| 模型名称 | 发布时间 | 备注 |
|---|---|---|
| Baichuan 1 | 2023年6月 | 同期较强 |
| Baichuan 2 | 2023年9月 | 同期较强 |
| Baichuan 3 | 2024年1月 | 上下文调整为4096(上一代是192K) |
| Baichuan 4 | 2024年5月 | |
| Baichuan4-Finance | 2024年12月 | 金融领域强化 |
| Baichuan-M1-preview | 2025年1月 | 深度思考+多模态(通用基座停滞) |
| Baichuan-M3 | 2026年1月 | 医疗领域 |
qwen系列模型发布时间
| 模型名称 | 发布时间 | 备注 |
|---|---|---|
| Qwen1.0 | 2023年8月 | 同期较强 |
| Qwen1.5 | 2024年2月 | 同期较强,引入MOE混合专家架构 |
| Qwen2.0 | 2024年6月 | 同期较强 |
| Qwen2.5 | 2024年11月 | 同期非常强,多模态体系 |
| Qwen3.0 | 2025年4月 | 同期非常强,集成“快思考+慢思考”混合推理模式 |
| Qwen3.5 | 2026年2月 | 同期非常强,原生支持多模态 |
| Qwen3.6 | 2026年4月 | 同期非常强,稀疏MOE混合架构,1M上下文 |
| Qwen3.7 | 2026年5月 | 同期非常强,超长自主任务,编程能力优化,多模态能力升级(闭源) |
3.2 全精度模型还是量化模型
尽量选择量化模型
精度变化对模型效果影响有限
参数规模变化对模型效果影响巨大
3.3 整合训练还是分别训练
LORA微调分水岭:qlora+vllm
3.3.1 以前的做法
LoRA微调刚刚发明的时候,曾经一度只能使用全精度模型训练;如果需要量化,必须LoRA和基座模型合并之后再量化。也就是说,LoRA是和基座模型绑定到一起了。在这种情况下,如果要尽可能节省计算资源,只能考虑将多个任务合并到一起,进行整合训练。
在这种情况下,怎样训练和部署更好?
-
整合训练:可以只部署一个模型,节省计算卡。但多个任务互相绑定,微调一个任务需要顾及对其他任务的影响。
-
分别训练:多个任务之间完全解耦。但需要更多的显卡。
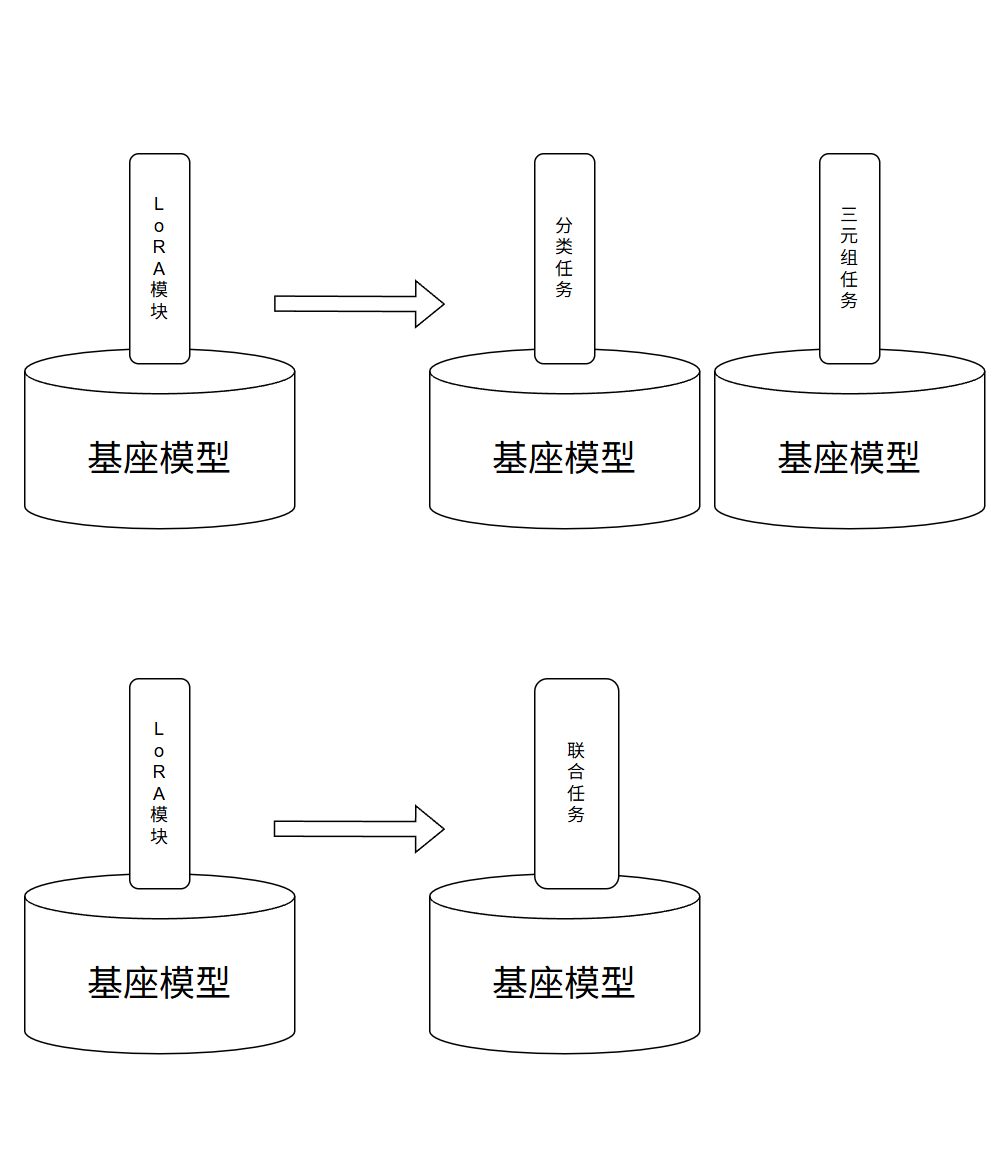
3.3.2 现在的做法
现在允许直接对量化模型进行训练,不存在LoRA和基座模型的绑定问题。
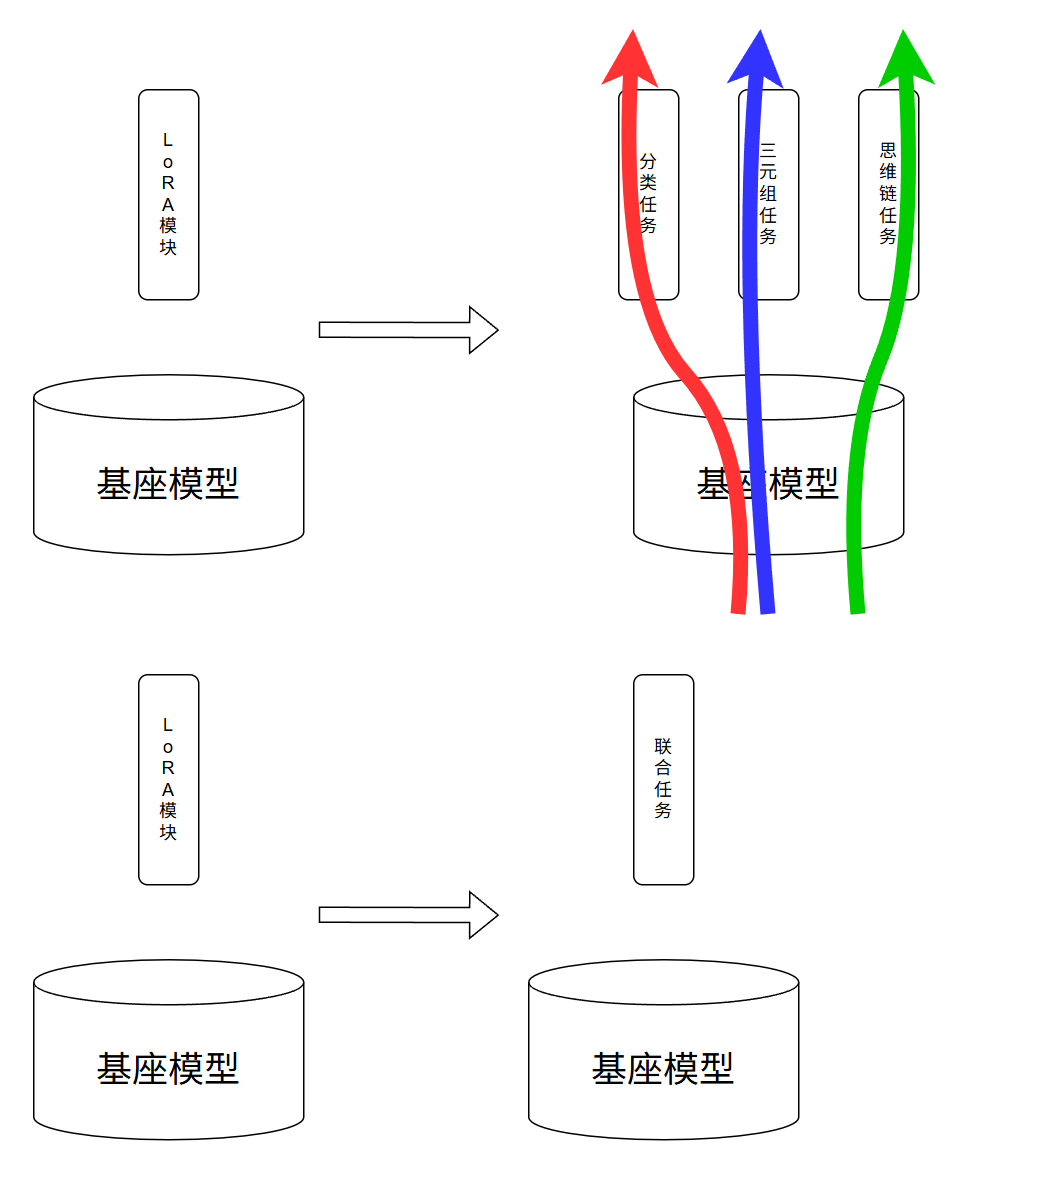
这种情况下,哪种训练训练和部署方式更好?
- 整合训练:没有明显优点。但多个任务互相绑定,微调一个任务需要顾及对其他任务的影响。
- 分别训练:多个任务之间完全解耦。没有明显缺点。
3.4 最终定案
原计划用chatglm-6B,根据实际情况调整为qwen2.5-3b-instruct的int4版本。
两个模型分别训练+vllm多LoRA部署。
四 LoRA微调介绍
1 全参数微调的缺陷
全参数微调有几个重大的缺陷
1.1 训练成本高
全参数微调,需要更新千亿甚至万亿级别的参数,会消耗大量计算资源,为了调整海量参数时不跑偏,还需要准备相当规模的数据集,费时费力。
1.2 训练时间长
全参数微调训练时间会比较长,有些场合需要快速迭代,跟不上业务的节奏
1.3 灾难性遗忘
全参数微调需要根据新任务,调整和重构预训练模型的所有参数,有可能导致原有的知识表征被破坏,导致新任务上表现虽好,但是旧任务上的表现急剧下降,这就是大模型的灾难性遗忘。
2 LoRA
LoRA微调的全程是Low-Rank Adaptation,这种方法通过引入低秩矩阵分解,可以通过仅训练少量参数实现大模型的适配。
- 每个transformer结构添加低秩旁路
- 矩阵A高斯初始化
- 矩阵B初始化为全0矩阵
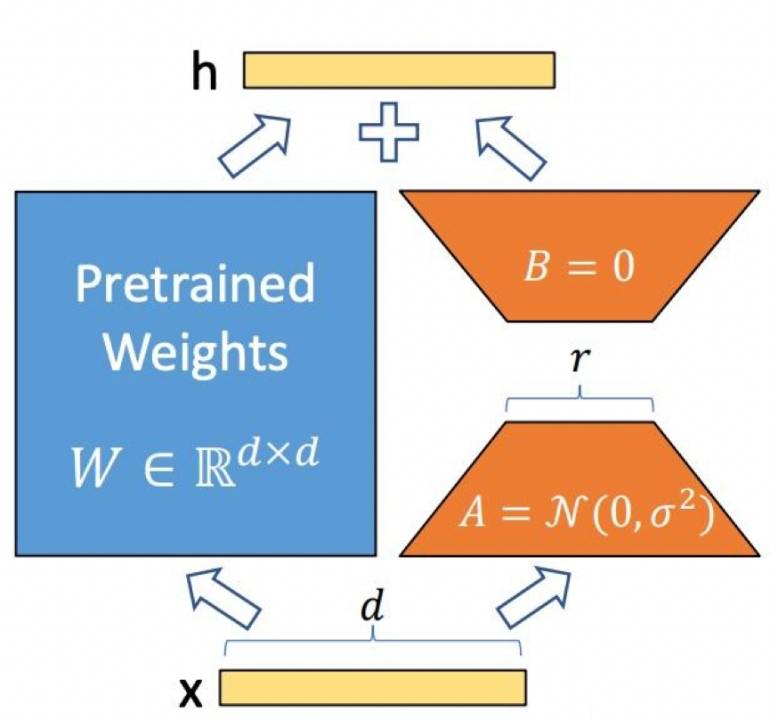
3 LoRA微调怎样避免这些问题?
需要训练一个巨大的参数矩阵\(W_{M*N}\),为了避免灾难性遗忘,训练的时候,我们不能调整原始矩阵,而是要调整一个同样大小的矩阵\(ΔW_{M*N}\),使得推理时可以用\(W_{M*N}+αΔW_{M*N}\)代替原来的\(W_{M*N}\)。
此时训练的参数量仍未M*N,如何改善?
机器学习里的PCA使用过一个思路:矩阵分解。很多算法都使用类似的方法降低计算量(潜在语义分析LSA,推荐系统里的协同过滤)
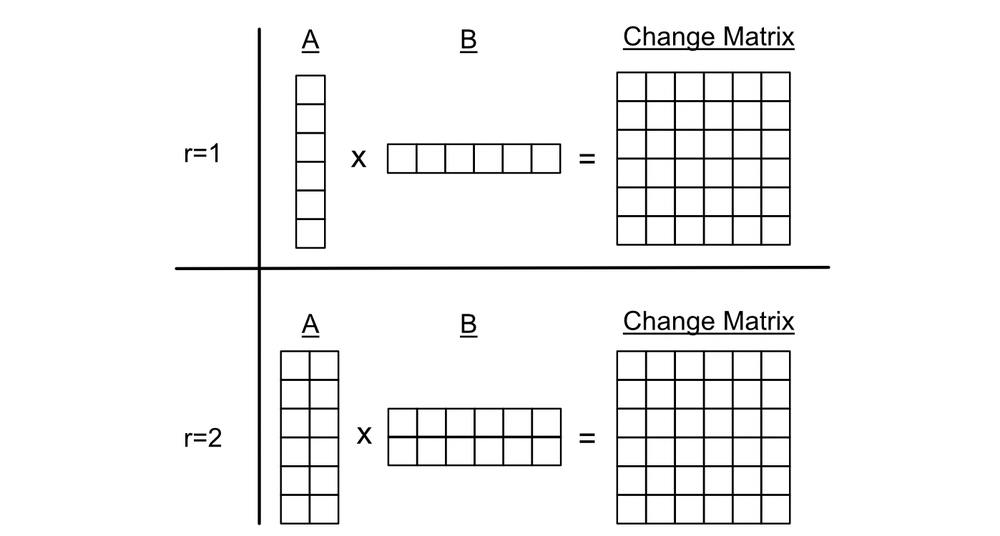
不是真正地训练一个巨大的矩阵\(ΔW_{M*N}\),而是训练两个小型矩阵\(A_{M*r}\)和\(B_{r*N}\),使得\(A_{M*r}*B_{r*N}≈ΔW_{M*N}\),只要这两个结果足够近似,在工程上就是可行的。
如果r远小于M 、N,就可以极大地压缩参数量。
假设M=300000,N=500000,那么\(ΔW_{M*N}\)的总参数量为M*N=1500亿。
如果取r=16,那么\(A_{M*r}\)的参数量为M*r=480万,
同理\(B_{r*N}\)的参数量为r*N=800万,
总参数量为1280万,仅为\(ΔW_{M*N}\)总参数量的0.000085,即不到万分之一。
五 训练工具
常用的训练工具很多,比如 LLaMA-Factory、SFTTrainer、Unsloth、XTuner、DeepSpeed等,今天介绍一种比较常用的LLaMA-Factory
1 LLaMA-Factory简介
实际工作时,与学习时有一定的差异,会用一些工具提升工作效率
LLaMA-Factory 是一个封装比较完善的LLM微调工具,可以仅使用命令行与webui微调大模型,对微调工作提供了各种支持。
多种模型:LLaMA、LLaVA、Mistral、Mixtral-MoE、Qwen、Qwen2-VL、DeepSeek、Yi、Gemma、ChatGLM、Phi 等等100+。
集成方法:(增量)预训练、(多模态)指令监督微调、奖励模型训练、PPO 训练、DPO 训练、KTO 训练、ORPO 训练等等。
多种精度:16 比特全参数微调、冻结微调、LoRA 微调和基于 AQLM/AWQ/GPTQ/LLM.int8/HQQ/EETQ 的 2/3/4/5/6/8 比特 QLoRA 微调。
先进算法:GaLore、BAdam、APOLLO、Adam-mini、DoRA、LongLoRA、LLaMA Pro、Mixture-of-Depths、LoRA+、LoftQ 和 PiSSA。
git地址:https://github.com/hiyouga/LLaMA-Factory
2 环境搭建
2.1 创建虚拟环境
conda create --name llamaFactory python==3.11
conda activate llamaFactory
2.2 安装
#根据自己的显卡,安装pytorch
pip3 install torch torchvision torchaudio --index-url https://mirrors.nju.edu.cn/pytorch/whl/cu126

#获取LLaMA-Factory源码,
git clone --depth 1 https://github.com/hiyouga/LLaMA-Factory.git
#解压并进入LLaMA-Factory目录
cd LLaMA-Factory
pip install -e ".[torch,metrics]"

#如果报错:No matching distribution found for setuptools>=61.0
pip install -r requirements.txt -i https://mirrors.tuna.tsinghua.edu.cn/pypi/web/simple
pip install --no-build-isolation --no-index --find-links=./ --no-deps -e ".[torch,metrics]"

#安装加速包
pip install auto_gptq==0.7.1 optimum==1.24.0 pydantic==2.10.6 openai
3 数据格式
3.1 alpaca格式
整个数据集是一个json对象的list,具体数据格式为:
[
  {
    "instruction": "用户指令(必填)",
    "input": "用户输入(选填)",
    "output": "模型回答(必填)",
    "system": "系统提示词(选填)",
    "history": [
      ["第一轮指令(选填)", "第一轮回答(选填)"],
      ["第二轮指令(选填)", "第二轮回答(选填)"]
    ]
  }
]
例子比如单轮(alpaca_data_zh_51k.json 中的例子, 数据集在data/dataset_info.json中注册为alpaca_zh)
{
  "instruction": "写一个有效的比较语句",
  "input": "篮球和足球",
  "output": "篮球和足球都是受欢迎的运动。"
}
和多轮 (oaast_sft_zh.json 中的例子, 数据集在data/dataset_info.json中注册为oaast_sft_zh)
{
  "instruction": "谢谢",
  "input": "",
  "output": "不用谢! 很高兴我提供的信息能够帮助到你! 如果还有什么其他问题也可以向我提问。",
  "history": [
    [
      "请你给我写一个面试准备计划,我想要去面试微软的程序员岗位",
      "首先,你可以去微软官网寻找招聘信息并申请面试。\n其次,您可以在社交媒体平台寻找微软公司对程序员的面试问题,并做好准备。\n最后,您可以自己对面试过程进行模拟,熟悉话题并减少紧张感。\n我希望你能面试成功。"
    ]
  ]
}
3.2 sharegpt
[
  {
    "conversations": [
      {
        "from": "human",
        "value": "user instruction"
      },
      {
        "from": "gpt",
        "value": "model response"
      },
      ...
    ],
    "system": "system prompt (optional)",
    "tools": "tool description (optional)"
  }
]
- conversations: 包含一系列对话对象,每个对象都由发言者(from)和发言内容(value)组成。from可以是人类、机器或是外部请求等,都可以自定义。
- system: 可选,系统提示或者说是prompt、角色设定等。类似于alpaca格式中的system字段。
- tools: 描述功能信息(尤其是外部请求的描述),这些工具可能被模型用来执行某些任务或获取更多信息。
例子:
[
  {
    "conversations": [
      # 提问
      {
        "from": "human",
        "value": "我想知道明天济南的天气预报。"
      },
      {
        "from": "function_call",
        "value": "{\"name\": \"get_weather_forecast\", \"arguments\": {\"location\": \"济南\", \"date\": \"明天\"}}"
      },
      # 回答
      {
        "from": "observation",
        "value": "{\"temperature_high\": 25, \"temperature_low\": 18, \"condition\": \"多云\", \"humidity\": 60}"
      },
      {
        "from": "gpt",
        "value": "明天济南的天气预报显示是多云,最高温度约为25摄氏度,最低温度约为18摄氏度,湿度为60%。"
      },
      ...
    ],
    "system": "你是一位智能助手,能够帮助用户查询各种信息。",
    "tools": "["
    "{\"name\": \"get_weather_forecast\", "
    "\"description\": \"获取指定地点的天气预报\", "
    "\"parameters\": "
    "   {\"type\": \"object\","
    "    \"properties\": "
    "       {\"location\": {\"type\": \"string\", \"description\": \"要查询天气的地点\"}, "
    "        \"date\": {\"type\": \"string\", \"description\": \"查询的日期(例如:'明天', '后天')\"}"
    "       }, "
    "    \"required\": "
    "       [\"location\", \"date\"]"
    "   }"
    "}"
    "]"
  }
]
在sharegpt格式的数据集中,function_call字段用于表示模型调用外部函数或工具的行为。这种机制允许模型与外部服务交互,以获取额外的信息或执行特定任务。这在许多实际应用中非常有用,比如查询天气、检索数据库等
3.3 注册文件
数据集所在目录下必须有一个dataset_info.json文件,格式为:
{
"chat-train": { #数据集名称
"file_name": "train.jsonl" #数据集文件
}
}
4 LLaMA-Factory的使用
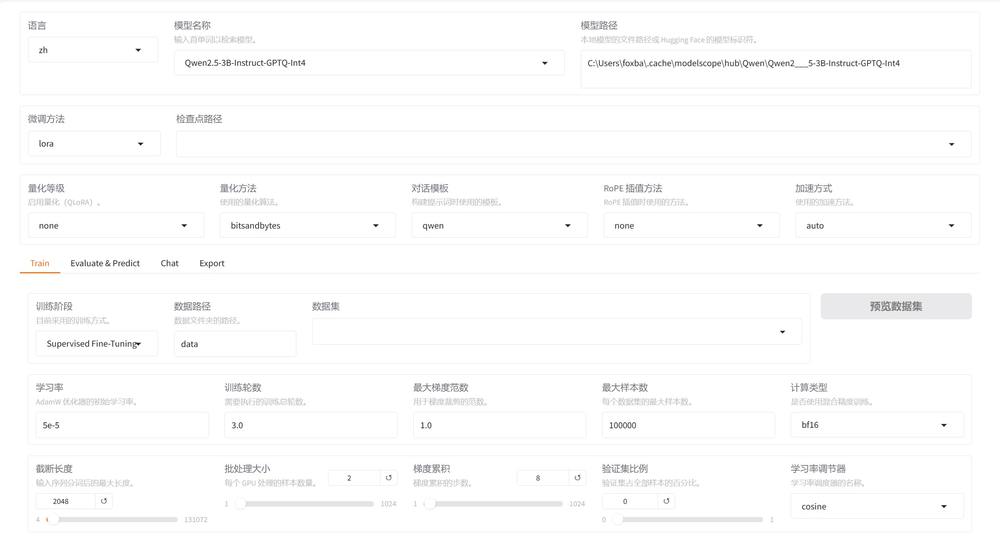
4.1 使用webui
在Anaconda Prompt中输入以下命令
conda activate llamafactory-3.11
llamafactory-cli webui
本地操作系统,启动后在浏览器上输入 http://localhost:7860,进入webui页面
4.2 命令行
llamafactory-cli train \
--stage sft \
--do_train True \
--model_name_or_path D:\docker-volume\llamafactory\models\Qwen2.5-3B-Instruct-GPTQ-Int4 \
--preprocessing_num_workers 16 \
--finetuning_type lora \
--template qwen \
--flash_attn auto \
--dataset_dir D:\docker-volume\llamafactory\data \
--dataset chat-train \
--cutoff_len 6000 \
--learning_rate 0.0001 \
--num_train_epochs 1.0 \
--max_samples 100000 \
--per_device_train_batch_size 2 \
--gradient_accumulation_steps 2 \
--lr_scheduler_type cosine \
--max_grad_norm 1.0 \
--logging_steps 5 \
--save_steps 100 \
--warmup_steps 10 \
--packing False \
--report_to none \
--output_dir D:/docker-volume/llamafactory/saves/train_2026-07-16-07-55-05 \
--bf16 True \
--plot_loss True \
--trust_remote_code True \
--ddp_timeout 180000000 \
--include_num_input_tokens_seen True \
--optim adamw_torch \
--quantization_bit 4 \
--quantization_method bitsandbytes \
--double_quantization True \
--lora_rank 16 \
--lora_alpha 16 \
--lora_dropout 0 \
--lora_target all
六 训练过程
1 指定基座模型
模型名称:Qwen2.5-3B-Instruct-GPTQ-Int4
模型路径:D:\docker-volume\llamafactory\models\Qwen2.5-3B-Instruct-GPTQ-Int4
检查点路径:
2 指定数据集
数据路径:D:\docker-volume\llamafactory\data
数据集:分类任务cate-train,三元组spo-train
3 指定训练的基本性质
微调方法:LoRA
量化等级:4
训练阶段:Supervised fine-tuning
4 指定重要参数
学习率:1e-4 或者 5e-5
截断长度:分类800,三元组1800
训练轮数:3.0
批处理大小:2
梯度累计:2
预热步数:10
LoRA的秩:8
LoRA缩放系数:16
LoRA随机丢弃:0.1
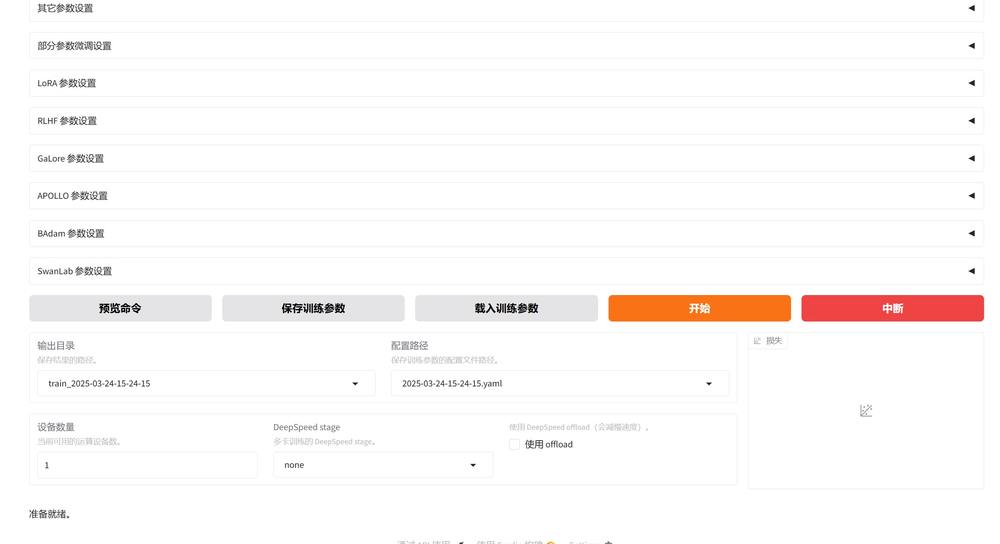
5 指定训练完成后的模型存储位置
D:/docker-volume/llamafactory/saves/
6 开始训练
点击开始按钮
7 检查训练结果
7.1 加载基座模型
set "CUDA_VISIBLE_DEVICES=0" && set "API_PORT=8000" && llamafactory-cli api ^
    --model_name_or_path D:\docker-volume\llamafactory\models\Qwen2.5-3B-Instruct-GPTQ-Int4
7.2 加载基座模型+LoRA
加载分类模型
set "CUDA_VISIBLE_DEVICES=0" && set "API_PORT=8000" && llamafactory-cli api ^
    --model_name_or_path D:\docker-volume\llamafactory\models\Qwen2.5-3B-Instruct-GPTQ-Int4 ^
    --adapter_name_or_path D:\docker-volume\llamafactory\saves\train_2025-05-24-17-56-24\checkpoint-120 ^
    --finetuning_type lora
加载三元组模型
set "CUDA_VISIBLE_DEVICES=0" && set "API_PORT=8000" && llamafactory-cli api ^
    --model_name_or_path D:\docker-volume\llamafactory\models\Qwen2.5-3B-Instruct-GPTQ-Int4 ^
    --adapter_name_or_path D:\docker-volume\llamafactory\saves\train_2025-05-24-20-00-00\checkpoint-375 ^
    --finetuning_type lora
加载思维链模型
set "CUDA_VISIBLE_DEVICES=0" && set "API_PORT=8000" && llamafactory-cli api ^
    --model_name_or_path D:\docker-volume\llamafactory\models\Qwen2.5-3B-Instruct-GPTQ-Int4 ^
    --adapter_name_or_path D:\docker-volume\llamafactory\saves\train_2025-03-20-20-41-50/checkpoint-1250 ^
    --finetuning_type lora
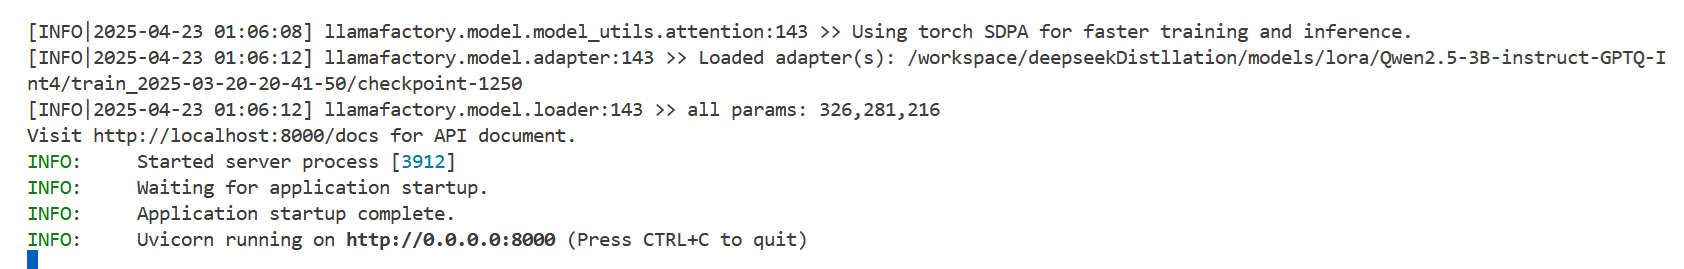
如果见到下面的信息,就代表api服务已经启动完毕
7.3 使用代码访问服务
可以用代码访问部署好的api server
def callServer(input):
    port = 8000
    client = OpenAI(
        api_key="0",
        base_url="http://localhost:{}/v1".format(os.environ.get("API_PORT", port)),
    )
    messages = []
    messages.append({"role": "user", "content": input})
    result = client.chat.completions.create(messages=messages, model="test",max_tokens=6000)
    return result.choices[0].message.content

if __name__ == "__main__":
    input = "对于「初三女生在搀扶跌倒老奶奶后反被冤枉,但仍选择资助她千元」的新闻事件,你有什么看法?"
    a = time.time()
    result = callServer(input)
    b = time.time()
    print("输出长度:"+str(len(result))+"字  耗时:"+str(b-a)+"秒  输出速度:"+str(len(result)/(b-a))+"字/秒")
    print(result)
访问时,可以观察显卡的实时状态,windows在命令行里启动nvidia-smi -l 1,linux 使用 watch -n 1 nvidia-smi
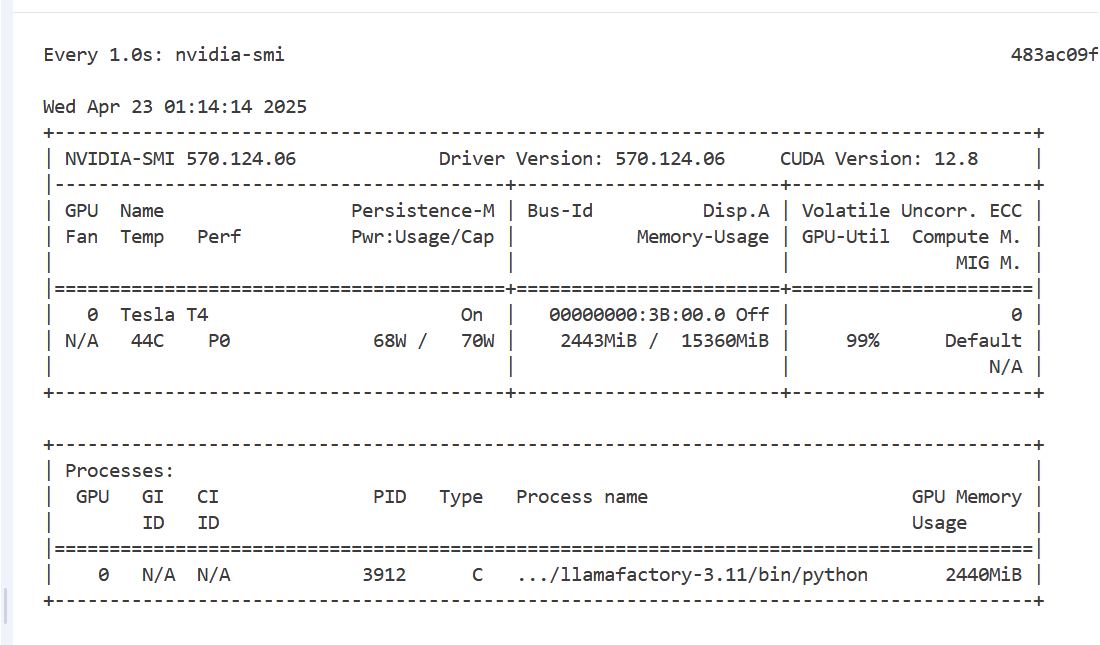
分类任务:
输出长度:2字 耗时:2.99秒 输出速度:0.67字/秒
酒店
三元组任务:
输出长度:214字 耗时:20.87秒 输出速度:10.25字/秒
[{"predicate": "出生日期", "object_type": "Date", "subject_type": "人物", "object": "1924年", "subject": "王炳煌"}, {"predicate": "出生地", "object_type": "地点", "subject_type": "人物", "object": "福建省南安县水头镇山前村", "subject": "王炳煌"}]
思维链任务:
输出长度:2344字 耗时:295.4秒 输出速度:7.94字/秒
嗯,用户让我对一个新闻事件的看法,新闻是关于初三女生搀扶跌倒的奶奶,结果被冤枉,但还是资助了她1000元。首先,我需要理解这个事件的核心,也就是事件的起因、过程和结果,然后分析背后的原因,以及可能的社会影响。首先,事件的起因是初三女生在搀扶老奶奶时,可能因为没看到摔倒的原因,导致被误解。这可能涉及到公众对行为的认知,比如见义勇为的正确性,以及社会对弱势群体的保护。然后是事件的结果,女生被冤枉,但仍然选择资助,这可能显示了她的道德和勇气,以及她对弱势群体的同情。
接下来,我需要考虑社会背景。中国社会对老人的尊重和扶助文化,以及公众对见义勇为的普遍认知。同时,媒体的报道方式,是否可能加剧了事件的复杂性,比如是否过分渲染了冤枉的可能性,从而影响公众对事件的理解。
然后,可能的道德评判。女生的资助行为是否值得赞扬,是否需要考虑她的实际处境,比如她是否有能力承担这样的经济负担。同时,事件中是否存在其他因素,比如监控缺失或媒体的报道不准确,导致冤枉事件的发生。
还要考虑法律和伦理问题。虽然资助是出于善良,但是否需要有法律或道德上的补偿机制来保护被冤枉者。另外,类似事件在不同文化或法律体系中的处理方式可能不同,比如中国法律对见义勇为的保护措施,以及国际上类似案例的处理。
可能的深层次问题包括社会对弱势群体的救助意识,以及媒体在事件传播中的角色。比如,是否媒体的报道在一定程度上推动了事件的复杂化,甚至被误解为“见义勇为者反被冤枉”的现象,从而影响公众对见义勇为行为的理解。
另外,女生资助的行为是否值得赞扬,以及她的资助是否真的解决了问题。可能需要讨论是否应该对见义勇为者提供经济补偿,或者是否有其他更合适的解决方式。
最后,总结时需要平衡各方观点,既肯定女生的勇气和道德,又指出事件的复杂性,以及需要改进的地方,比如媒体和法律如何更好地处理类似事件,以及如何保护被冤枉者的权益。
对于“初三女生搀扶跌倒老奶奶后反被冤枉,但仍选择资助她千元”的事件,可以从以下几个维度进行分析:
一、事件的核心矛盾与社会认知
行为动机与误解
- 女生的行为符合社会对“见义勇为”的期待,但因缺乏明确证据(如监控缺失)或公众认知偏差,被错误指控为“讹诈”或“占便宜”。这种“冤枉”现象反映出社会对见义勇为的复杂认知:一方面强调“扶起老人”是道德义务,另一方面又因信息不对称导致误解。
- 关键点:事件揭示了“见义勇为”在法律与道德层面的模糊地带,需要明确的法律保护机制和公众教育。经济资助的道德与法律考量
- 女生的资助行为体现了善良与同情心,但是否应被社会“买单”?需要讨论经济救助的合理边界:是否需要法律制度明确见义勇为者的经济补偿,避免因误解导致的经济负担。
- 争议焦点:资助是否属于“合理补偿”?是否应有制度化的救济渠道?
二、事件背后的深层问题
社会信任危机与媒体责任
- 事件的传播过程中,媒体可能过度渲染“冤枉”的可能性,加剧公众对事件的恐慌。这种报道方式可能掩盖事件本质,模糊责任归属,导致被冤枉者权益受损。
- 社会影响:事件可能引发公众对媒体真实性的质疑,甚至影响社会对见义勇为行为的理性认知。道德与法律的边界
- 女生的道德行为与法律权益的冲突:她本应获得社会的认可,但因“冤枉”可能陷入困境。需要探讨法律如何保护“见义勇为”者,避免因误解而引发的社会矛盾。
- 法律建议:完善见义勇为者的法律保护机制,明确经济补偿或免责条款,降低被冤枉的风险。代际价值观的碰撞
- 事件中女生的资助行为可能引发代际价值观的碰撞:年轻人因同情心而牺牲个人权益,与老年人对“被讹诈”的本能警惕形成冲突。这种冲突需要通过社会教育引导代际理解,避免“代际仇恨”。
三、可能的解决方案
完善法律制度
- 强化见义勇为者的法律保护,明确免责条款(如“无恶意讹诈”)和补偿机制(如设立见义勇为基金),降低被冤枉的风险。
- 案例参考:如美国的“见义勇为法”(Good Samaritan Law)和中国的见义勇为条例,为行为者提供法律保障。建立透明的事件处理机制
- 媒体报道需客观公正,避免过度渲染“冤枉”可能性。地方政府或相关部门应及时介入调查,避免信息不对称加剧误解。
- 典型案例:日本“扶起老人”事件中,媒体和法律通过透明调查明确责任,避免了类似事件的负面影响。增强公众教育与社会责任感
- 通过学校、社区和媒体加强道德教育,培养公众对弱势群体的同情心与责任感,同时提高对法律和道德边界的认知。
- 教育建议:将“见义勇为”与“尊重法律”结合,避免“道德优越感”导致的冲突。
四、总结:道德与法律的平衡
事件中的女生选择资助老奶奶,体现了道德勇气与善良之心,但其权益应得到社会的合理保障。关键在于:
- 完善法律制度:明确“见义勇为”的法律地位,减少误解风险。
- 透明调查机制:通过公正的调查,厘清责任归属,避免冤枉事件。
- 代际理解:引导代际对话,消除因价值观差异导致的冲突。最终,事件的启示是:道德行为不应以牺牲法律权益为代价,社会需要通过制度设计,让善良者得到应有的尊重与保护。
七 重要参数
LLaMA-Factory训练过程中用到的参数非常多,按照重要程度整理如下:
8.1 极重要,本次训练模型和数据路径
| 参数名称 | 说明 |
|---|---|
| 模型名称 | 基座模型的名称 |
| 模型路径 | 基座模型的路径 |
| 检查点路径 | 开始的checkpoint路径,如果不需要可以为空 |
| 数据路径 | 数据存放的目录 |
| 数据集 | dataset_info.json中记录的哪一个数据集 |
| 输出目录 | 训练好的模型的路径,windows下默认在 D:\docker-volume\llamafactory\saves\ |
| 训练参数目录 | D:\docker-volume\llamafactory\saves\ |
| 对话模板 | 和使用的基座模型一致 |
8.2 极重要,决定本次训练的基本性质
| 参数名称 | 说明 |
|---|---|
| 微调方法 | full--全参数训练 freeze--冻结一部分参数 LoRA--使用LoRA微调 |
| 训练阶段 | 属于哪个训练阶段 Supervised Fine-Tuning:进一步做有监督训练 Reward Modeling:奖励建模,用于强化学习 PPO:强化学习算法之一,用于增强多次迭代中的稳定性 DPO:强化学习算法之一,用于避免策略和价值函数之间的相互影响,提高学习效率 KTO:知识转移方法,可以强化学习效率和最终效果 Pre-Training:预训练 本次实验选Supervised Fine-Tuning |
| 量化等级 | none:不做量化 8:8位量化 4:4位量化 |
8.3 重要,决定本次训练的整体效果
| 参数名称 | 说明 |
|---|---|
| 学习率 | 0.1 一般只用于探索,没人会真的用 0.01 从头训练的标准模型初始学习率 0.001 已经快接近优化目标时做细致调整时采用 0.0001 模型接近收敛时做微调 0.00005 预训练阶段的最后微调 |
| 截断长度 | 本次实验 分类800,三元组1800 |
| 训练轮数 | 学习的特性较简单 ,1轮即可,如果数据集太小,不应选择太多轮数,可以考虑数据增强。 |
| 批处理大小 | 根据显存的情况调整 |
| 梯度累计 | 批处理大小*梯度累计决定了梯度更新的频率 |
| 预热步数 | 建议使用,防止参数剧烈震荡 |
| LoRA的秩 | 学到信息的丰富程度 |
| LoRA缩放系数 | LoRA的重要程度 |
| LoRA随机丢弃 | 随机丢弃LoRA层权重的概率,是一种正则化方法,方式模型过度依赖LoRA |
八 高效部署
可选的部署工具很多,例如vllm、HuggingFace TGI、FasterTransformer、DeepSpeed-Inference等
1 vllm介绍
微调后的模型使用vllm的api server部署
CUDA_VISIBLE_DEVICES=0 API_PORT=8000 vllm serve /mnt/d/docker-volume/llamafactory/models/Qwen2.5-3B-Instruct-GPTQ-Int4 \
    --enable-lora \
    --lora-modules cot=/mnt/d/docker-volume/llamafactory/saves/train_2025-03-20-20-41-50/checkpoint-1250/ cat=/mnt/d/docker-volume/llamafactory/saves/Qwen2.5-3B-Instruct-GPTQ-Int4/LoRA/train_2025-05-24-17-56-24/checkpoint-120/ spo=/mnt/d/docker-volume/llamafactory/saves/Qwen2.5-3B-Instruct-GPTQ-Int4/LoRA/train_2025-05-24-20-00-00/checkpoint-375/
分类任务:
输出长度:2字 耗时:15.18秒 输出速度:0.13字/秒
酒店
三元组任务:
输出长度:109字 耗时:3.31秒 输出速度:32.94字/秒
[{"predicate": "出生地", "object_type": "地点", "subject_type": "人物", "object": "福建省南安县水头镇山前村", "subject": "王炳煌"}]
思维链任务:
输出长度:2015字 耗时:17.81秒 输出速度:113.15字/秒
嗯,用户问的是关于初三女生搀扶跌倒老奶奶反被冤枉,但仍然资助她一千元的新闻事件的看法。首先,我需要理解这个事件的核心问题是什么。可能涉及道德、法律、社会关系等方面。首先,事件本身是关于一个学生在帮助老人后被误解,甚至可能面临法律纠纷,但她仍然选择给予老人经济上的支持。这看起来是一个典型的道德困境,尤其是在现代社会中,年轻人可能会因为担心法律或舆论而犹豫是否伸出援手。
接下来,我需要考虑不同角度的看法。一方面,有人可能会觉得她很勇敢,主动承担了社会责任,值得赞扬。另一方面,也有人可能认为她在法律上处于不利地位,容易受到伤害,或者她的行为可能被误解为诈骗。
然后,我应该分析这种事件背后的社会现象。在中国,类似的事情确实存在,比如老人摔倒后无人扶起的情况,以及年轻人在帮助他人时面临的潜在风险。这个问题反映了社会对助人的态度,尤其是年轻人的顾虑。
另外,用户可能想知道这样的事件对公众的影响,比如如何平衡道德与法律,或者如何鼓励更多人参与公益。可能还需要探讨法律保护机制,比如是否有必要修改相关法规,或者加强社会教育,让年轻人知道如何正确处理此类情况。
还要考虑用户的深层需求,他们可能希望了解如何在实际生活中处理类似情况,或者如何通过媒体或公共平台传播正确的价值观。此外,可能还涉及到媒体的报道方式是否公正,以及公众舆论的形成过程。
最后,我需要确保回答结构清晰,涵盖多个方面,并且保持客观,不偏袒任何一方。同时,语言要通俗易懂,避免使用过于专业的术语,让用户能够理解和接受不同的观点。
关于“初三女生搀扶跌倒老奶奶反被冤枉,仍选择资助她1000元”的事件,这是一个典型的社会伦理与法律问题的结合体,折射出当前社会在助人行为中的复杂心理和价值取向。以下是对此事的几点思考:
一、事件核心:道德勇气与法律风险的悖论
道德层面的抉择
女生的行动本质上是对“助人为乐”传统美德的践行,她以实际行动弥补了法律可能带来的后果,体现了对他人生命的尊重和责任担当。这种行为超越了传统道德框架下的"见义勇为",更接近现代伦理学中的"利他主义"——即在风险面前依然选择付出而非逃避。法律层面的困境
事件中存在法律空白地带,现行法律对见义勇为的保护范围模糊不清。例如,如果女生因救助行为遭受侵权,法律是否能提供有效救济?若其行为被认定为"无因管理",是否需要承担赔偿责任?这些法律空白可能成为其后续维权的障碍。二、社会背景:老龄化社会的道德焦虑
信任危机与代际冲突
在老龄化加剧的背景下,公众对陌生人之间的信任度下降,导致类似事件更容易引发道德恐慌。当传统"扶不扶"的价值观遭遇法律现实时,代际差异(如年轻一代的法律意识与老年人的信任模式)成为矛盾焦点。媒体叙事的伦理挑战
新闻报道往往聚焦于事件的戏剧性反转,忽视了当事人背后的复杂处境。例如,女孩在救助过程中是否已尽到合理注意义务?媒体应承担何种责任?过度渲染"英雄"形象可能掩盖事件的多元真相。三、政策与制度的缺失
见义勇为立法滞后
我国《民法典》第184条虽规定"自愿实施紧急救助行为造成受助人损害的,不承担民事责任",但缺乏具体执行细则。地方实践中,类似事件常因证据不足陷入法律真空。社会支持体系脆弱
当地民政部门虽介入调解,但缺乏系统性的救助机制。女性群体在法律援助中的弱势地位,可能使此类事件的解决陷入困局。四、未来方向:构建多重保护机制
完善法律保障体系
推动地方立法细化"见义勇为"条款,明确免责条件;建立专门的法律援助基金,为受害方提供专业咨询与维权支持。强化社区支持网络
发展社区互助组织,建立邻里守望机制。例如,可推广"社区微救助"项目,通过社会组织协调资源,降低个人救助风险。重塑社会信任文化
开展"尊老爱幼"主题宣传活动,通过典型案例教育公众。同时,探索"道德银行"等激励机制,鼓励公民在遵守法律前提下积极履行社会责任。五、个人反思:个体行动的边界
面对此类事件,我们不应简单归结为"道德绑架"或"法律漏洞"。关键在于如何平衡个人权益与社会价值,以及如何在制度框架内赋予个体更多的行动自由。正如女孩所言:"我愿意承担后果,因为我相信每个人都有救人的本能。" 这种勇气值得肯定,但同时也提醒我们在制度设计中需留有弹性空间,让善良的初衷得以落地。总之,这一事件既是一次道德与法律的角力,也是社会伦理转型的缩影。它警示我们:在复杂的社会环境中,唯有通过制度创新与文化重构,才能真正实现"助人为乐"与"自我保护"的和谐共存。
2 vllm的优势
2.1 缓存优化
2.1.1 decoder系模型的推理方式
注意decoder-only的block和原始模型相比,有较大的变动。
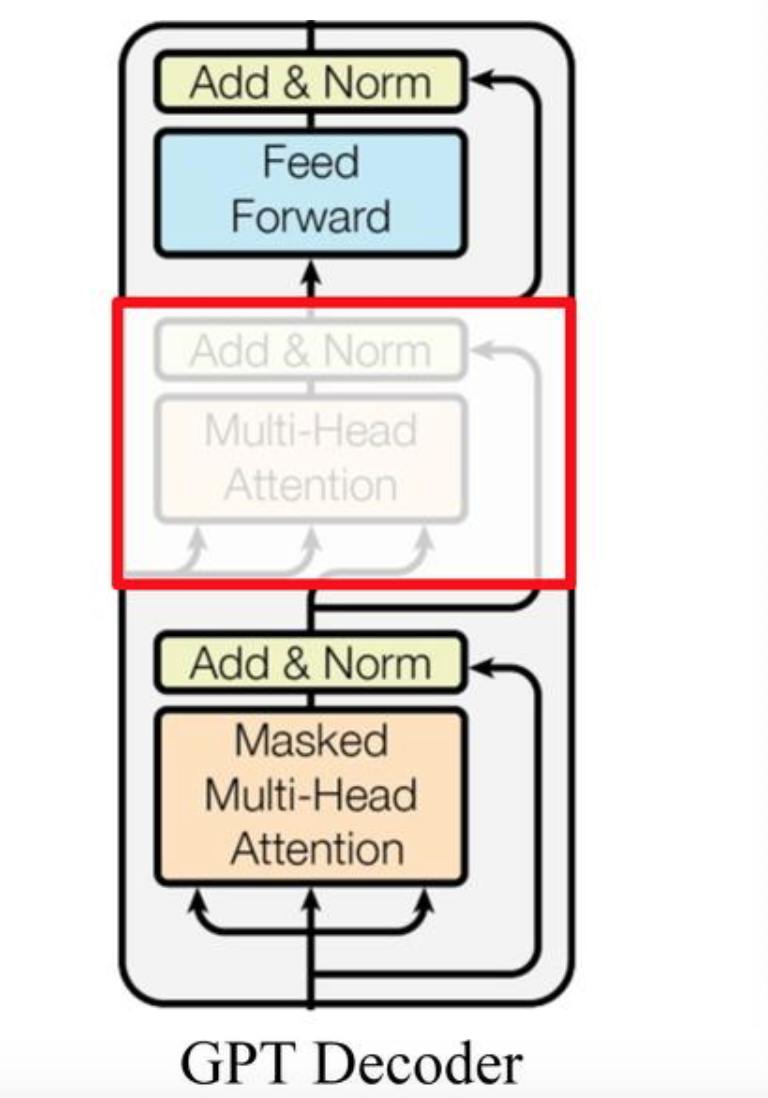
带掩码的自注意力机制?
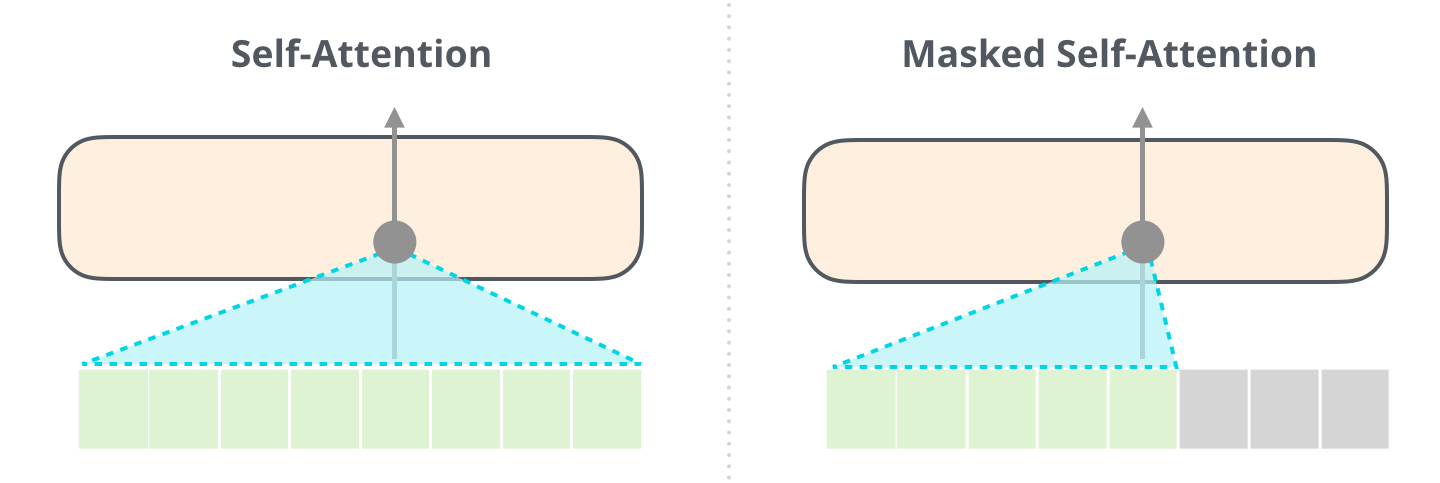
实际推理中怎么做到的?
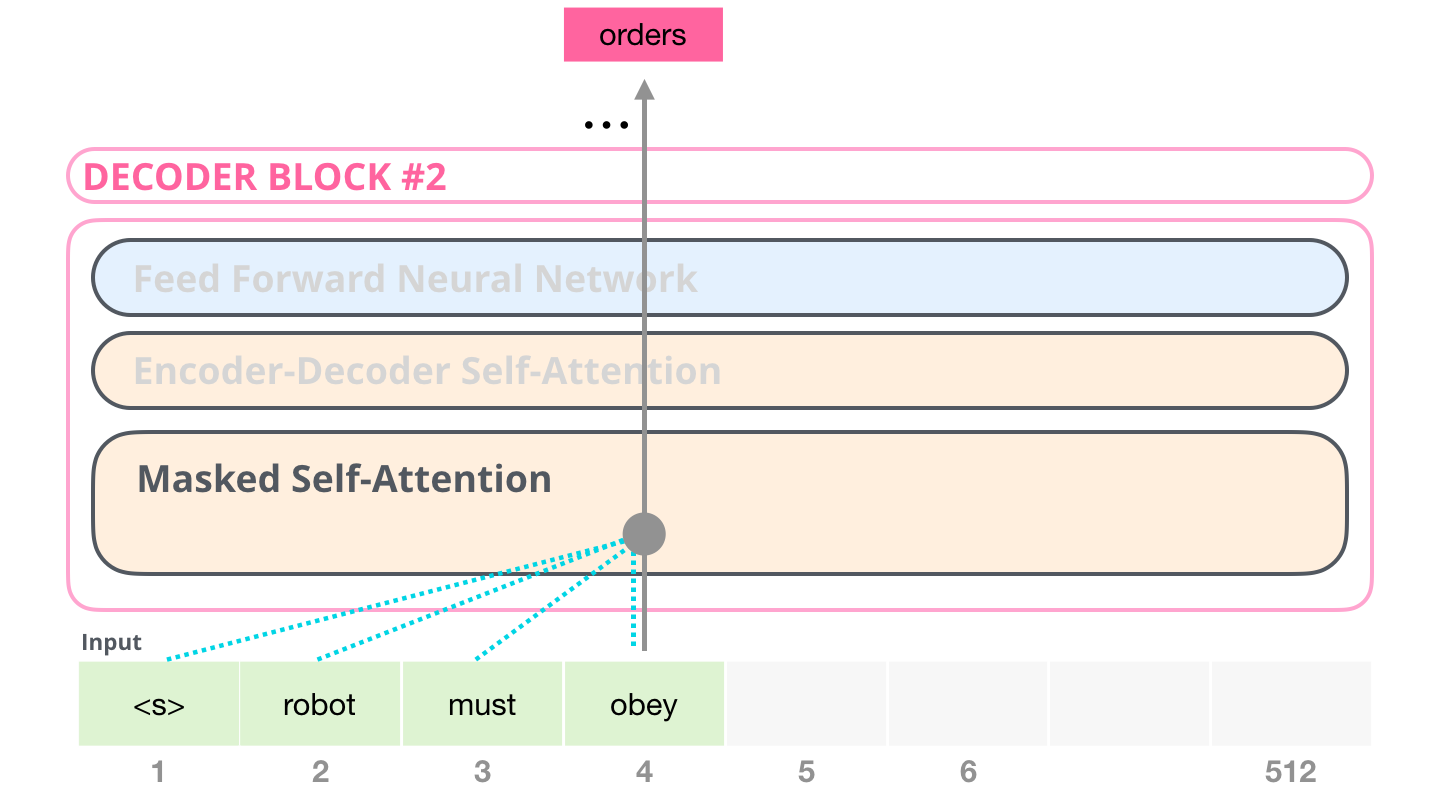
模拟一次完整的推理过程
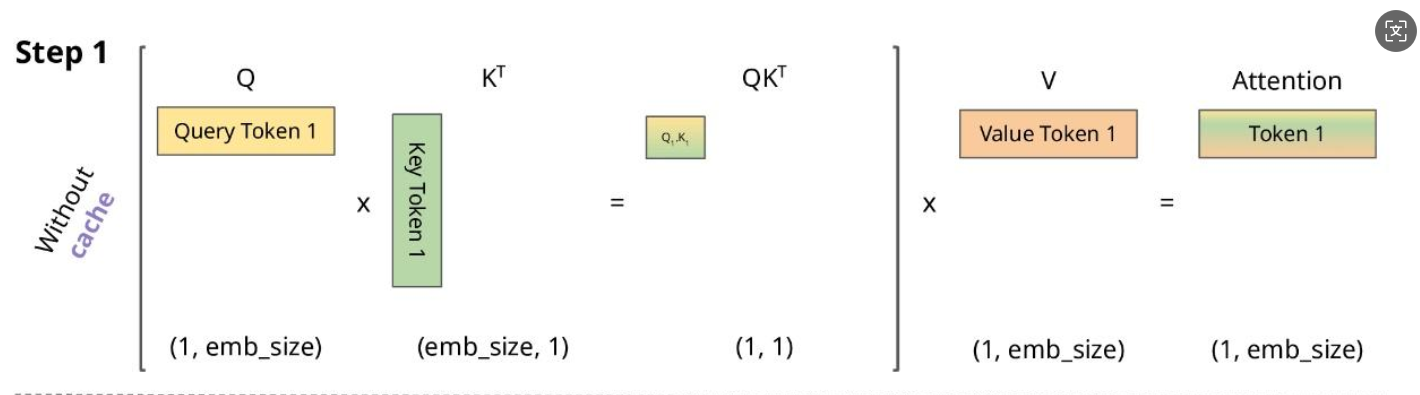
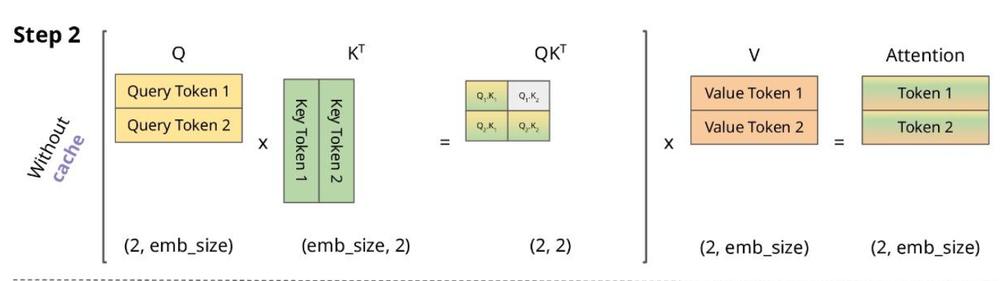
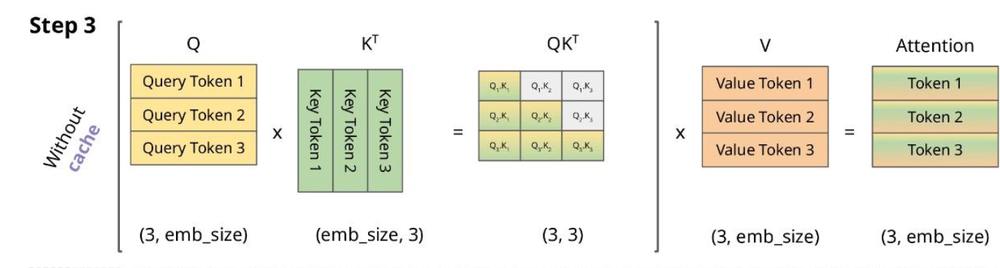
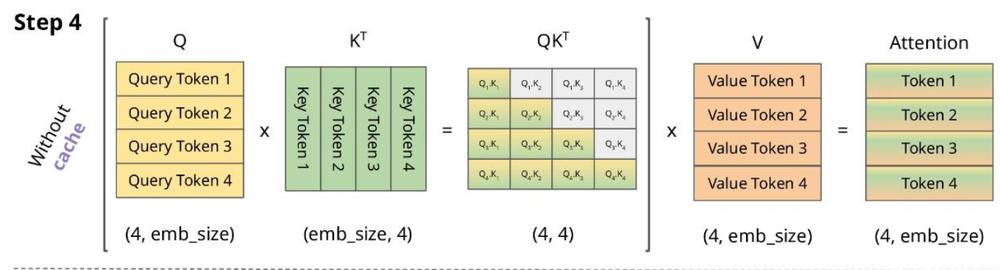
有什么问题?
2.1.2 kv-cache
自注意力部分是整个推理过程中计算量最大的部分,上述推理过程需要反复计算这些自注意力,造成了巨大的算力浪费?
能否解决这个问题?
工程上常用的思路是空间换时间,典型例子:字典,倒排索引
怎样空间换时间?
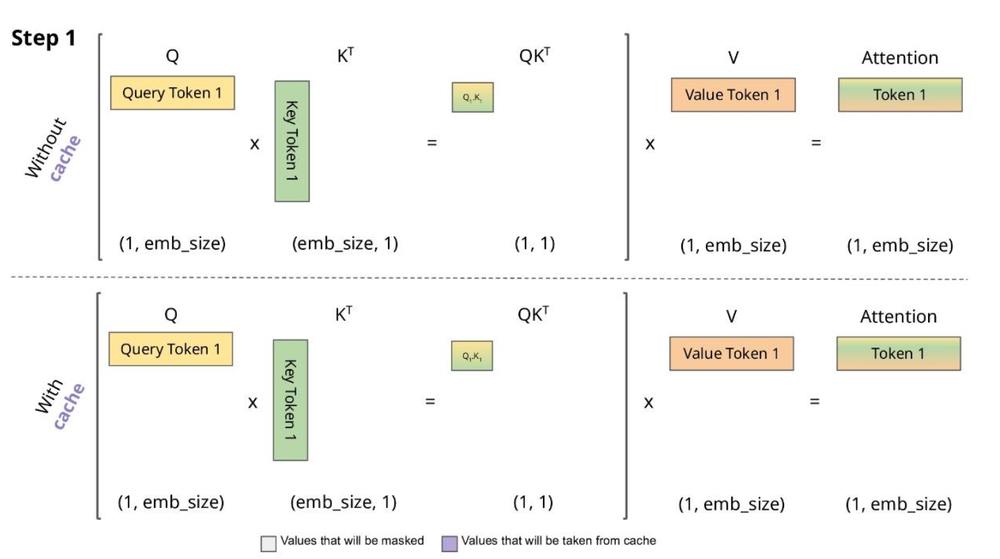
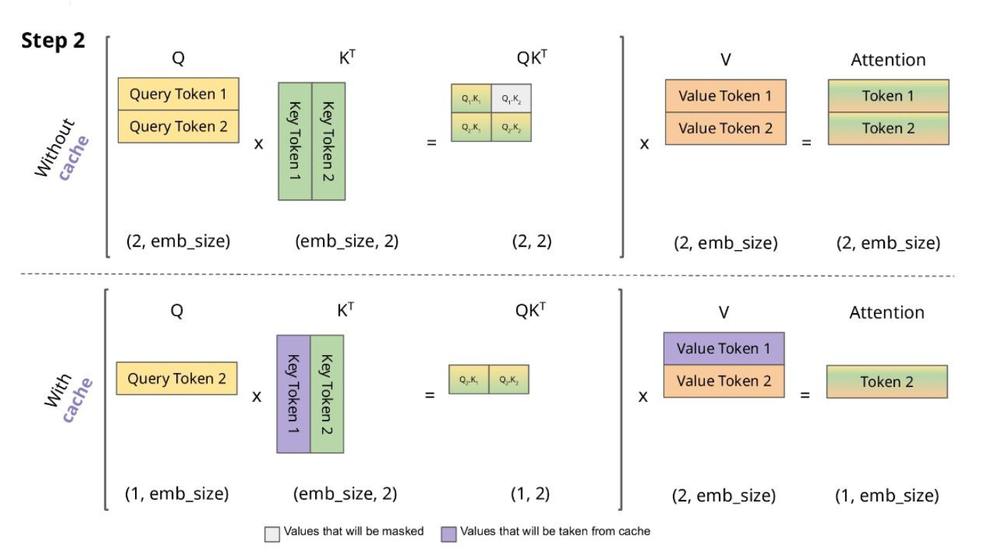
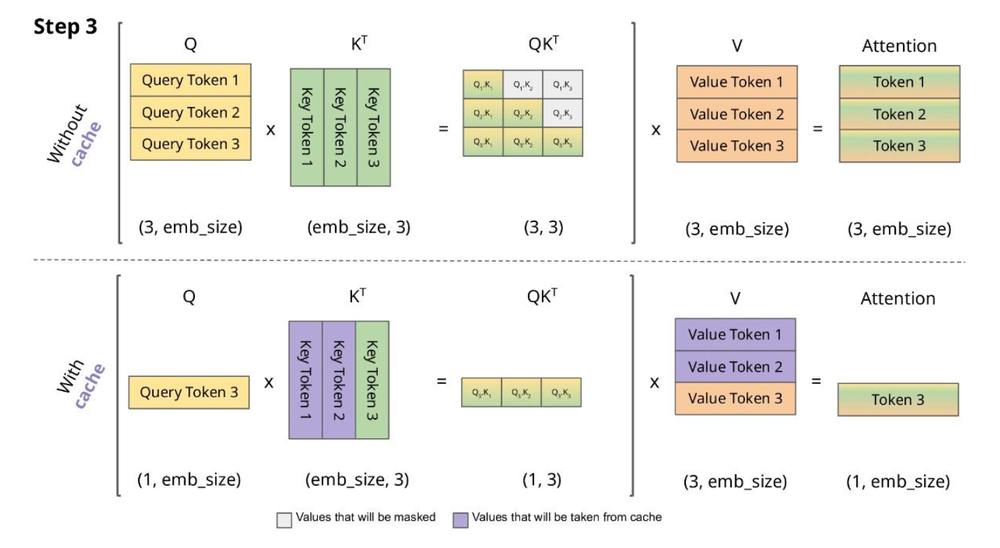
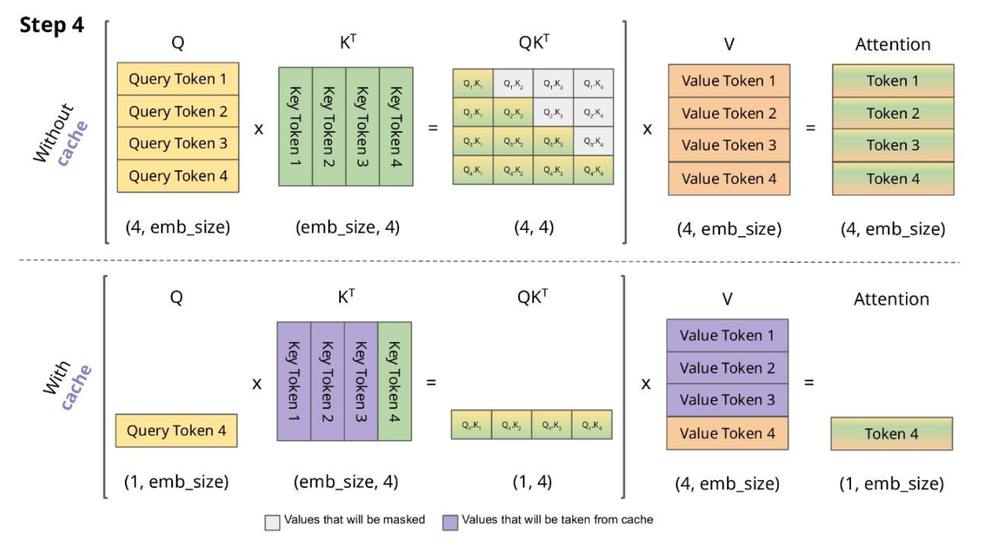
为什么是kv-cache,而不是qkv-cache?
有了kv-cache,还有一些问题尚未解决:
- 必须要为key,value分配显存空间,分配多大?
- 如果预留的显存不够怎么办?
- 如果预留的显存太多了怎么办?
- 业务数据是流式的,推理动作是批量的,如果现在只拿到部分数据,不足一个批次,要开始推理吗?
- 如果开始推理,不足的数据就要填充0,浪费资源
- 如果不开始,不知道具体什么时间节点才能凑足一个批次,浪费时间
2.1.3 传统的KV Cache管理方式
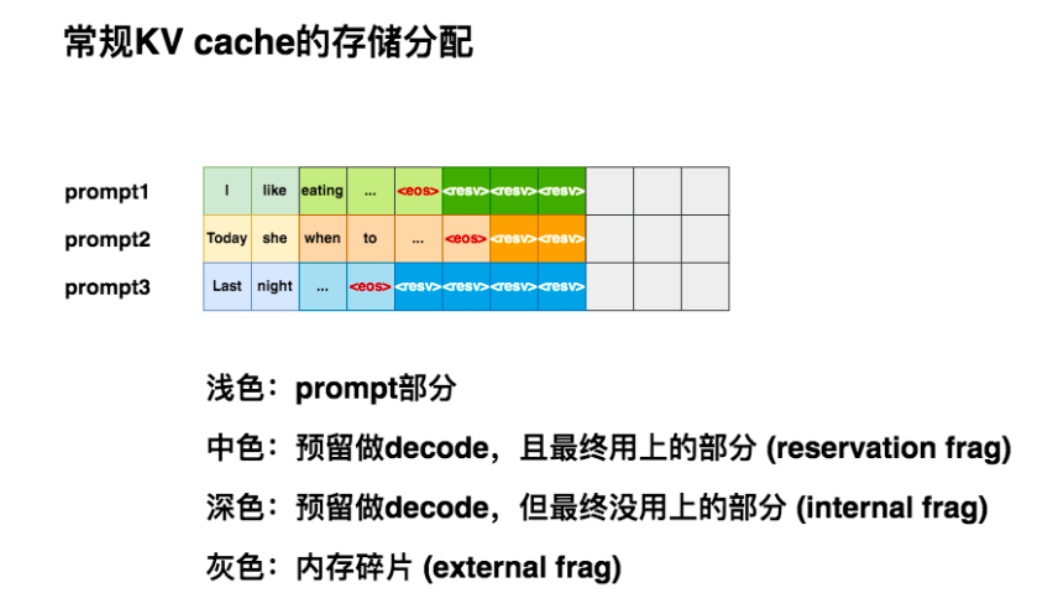
传统KV Cache是直接分配一段物理显存,这段物理显存随着prompt变长和输出序列变长,会不断增长,更糟糕的是,由于输出序列长度无法预测,无法为KV Cache量身分配大小,导致大量显存浪费。
2.1.4 vllm的改进-PageAttention
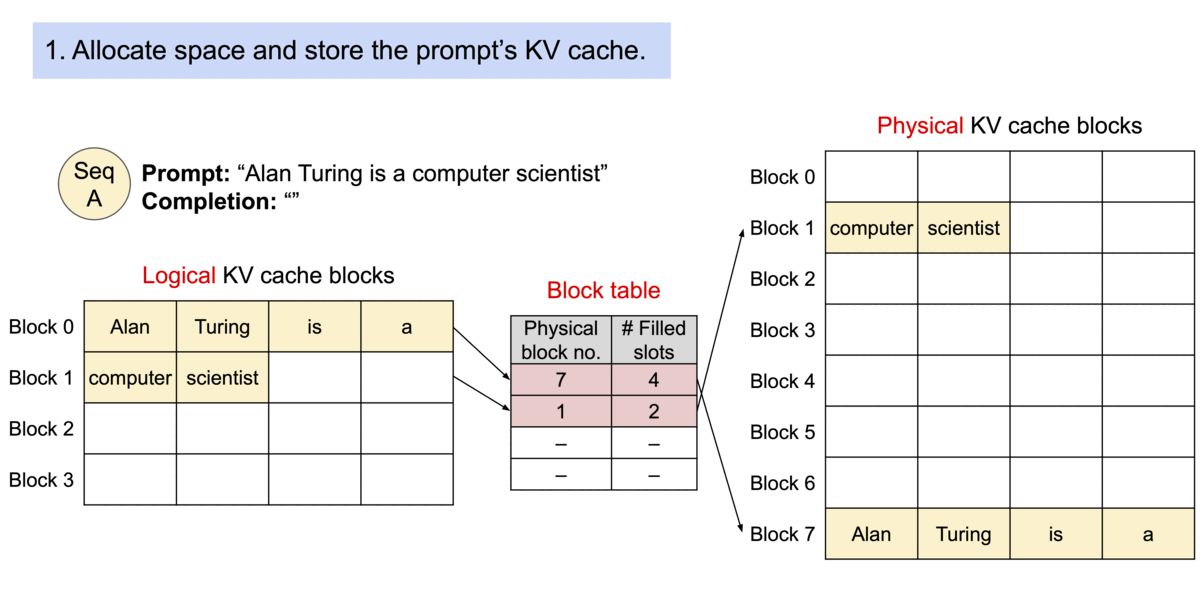
在显存上分配一块固定大小的连续空间(vllm中默认为16),类似于内存页
多个进程运行时,可以每个进程分配自己的虚拟内存,虚拟内存通过块表(block table)关联到内存页
只有进程内存不足时,才会请求增加,每次增加一个内存页,最坏的结果就是最后一个内存页没写满.
这种方式显存的利用率能达到96%
2.2 批量任务优化
批量推理时,PageAttention因为提高的显存的使用率,所以可以增加推理任务并行的数量。
vllm不再要求所有并行任务处于同一阶段,当其他推理任务进行时,只要资源充足,可以随时开始新推理任务,减少了任务批次间的等待。
如果超出并行量,最后的请求会被抢占(preemption),退出所有占用资源,等待运行中的任务完成
2.3 加载多个LoRA
vllm能够同时加载多个LoRA,随时可以指定使用其中的任意一个,这个特性在实际生产中非常方便。
2.3.1 方便对比测试
可以同时加载对比测试的N个LoRA,无缝切换使用任意一个,随时对比在不同输入下的表现。
2.3.2 节约服务器资源
如果有多个低频使用的LoRA,可以加载到少数几台服务器上,节省部署服务的硬件资源
2.3.3 方便负载均衡
如果多个LoRA分开部署,每个1LoRA需要做自己的服务器组,组内资源共享,但组间无法共享;
如果多个LoRA统一部署,可以共享所有资源。
3 vllm部署过程
3.1 选择部署方式
windows对vllm的支持不太好,可以选用wsl2,docker,linux系统三者之一,这里选用wsl2
wsl2是Windows Subsystem for Linux 2的简称,是微软在Windows 10/11操作系统中提供的一种功能,用于在Windows系统上运行Linux环境,与主机Windows系统共用同一套硬件资源
3.2 安装wsl2
3.2.1 启动wsl功能
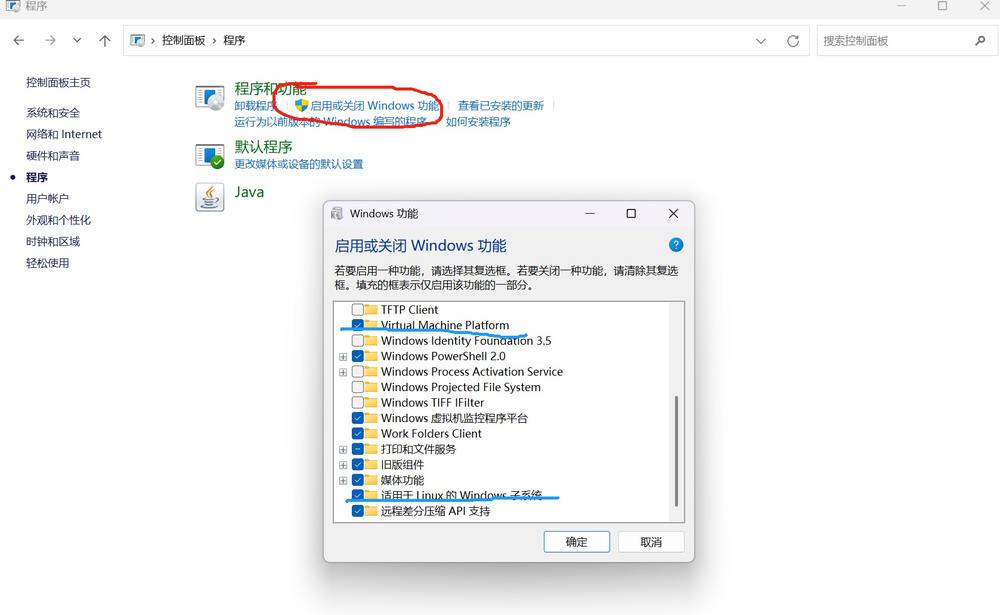
控制面板-程序-启动或关闭windows功能
启用 Virtual Machine Platform 和 适用于Linux的Windows子系统 两个选项,确定
完成后重启
3.2.2 安装wsl
在命令行里输入 wsl --install
几分钟后,会要求设置用户名、密码,设置完后可以正常启用
3.2.3 基本功能
查看版本 wsl -l -v
切换版本 wsl.exe --set-version Ubuntu-22.04 2
启动wsl环境: wsl
windows下所有数据在虚拟环境中都可见,挂载到/mnt目录下,例如:原 C:\Program Files 现在路径是 /mnt/c/Program Files
3.3 安装vllm
先正常搭建一个ubuntu下的gpu环境
conda create --name llamaFactory311 python==3.11
conda activate llamaFactory311
pip install uv
uv pip install vllm==0.9.0 --torch-backend=auto
pip install "transformers<4.52.0"
3.4 启动vllm
用这个命令启动vllm的api server, 换上你自己的基座模型和LoRA的路径,支持同时加载多个LoRA
CUDA_VISIBLE_DEVICES=0 API_PORT=8000 vllm serve /mnt/d/docker-volume/llamafactory/models/Qwen2.5-3B-Instruct-GPTQ-Int4 \
    --enable-lora \
    --lora-modules cot=/mnt/d/docker-volume/llamafactory/saves/train_2025-03-20-20-41-50/checkpoint-1250/ cat=/mnt/d/docker-volume/llamafactory/saves/train_2025-05-24-17-56-24/checkpoint-120/ spo=/mnt/d/docker-volume/llamafactory/saves/train_2025-05-24-20-00-00/checkpoint-375/

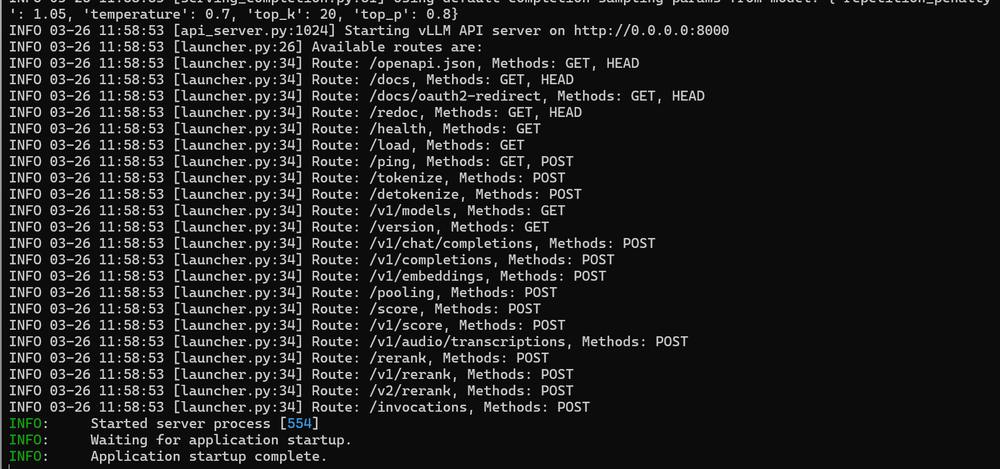
当出现下面的信息,代表vllm的api server已经启动完毕
这段代码用来访问vllm的api server,使用model参数指定具体加载哪个LoRA,如果model="",就会直接使用基座模型推理
import os
from openai import OpenAI
from transformers.utils.versions import require_version
import time

require_version("openai>=1.5.0", "To fix: pip install openai>=1.5.0")

def callServer(input,modelName):
    port = 8000
    client = OpenAI(
        api_key="0",
        base_url="http://localhost:{}/v1".format(os.environ.get("API_PORT", port)),
    )
    messages = []
    messages.append({"role": "user", "content": input})
    result = client.chat.completions.create(messages=messages, model=modelName,max_tokens=20000)
    return result.choices[0].message.content


if __name__ == "__main__":
    #测试思维链
    input1 = "对于「初三女生在搀扶跌倒老奶奶后反被冤枉,但仍选择资助她千元」的新闻事件,你有什么看法?"
    modelName1="cot"
    #测试分类
    input2 = """你是一位电商评论文本的分类专家,在【分类体系】规定的类别中,【输入文本】最可能分到哪个类别?只允许输出类别名称,不允许输出其他字符。
                【分类体系】
                 ["电脑","水果","平板","衣服","酒店","洗浴","书籍","蒙牛","电器","手机"]
                 【输入文本】
                 很不错的一家5星级酒店。房间也很干净,就是电视太小,而且离床比较远,看不太清楚。服务人员态度也很好。下次一定会再住。"""
    modelName2="cat"
    #测试SPO
    input3 = """你是一位电商评论文本的分类专家,在【输入文本】中检测所有的SPO三元组,并且以【指定格式】输出。只允许输出【指定格式】规定的答案,不允许输出任何其他字符。
                【指定格式】
                [{'predicate': '编剧', 'object_type': '人物', 'subject_type': '影视作品', 'object': '神尾叶子', 'subject': '花样男子'}, {'predicate': '出版社', 'object_type': '出版社', 'subject_type': '书籍', 'object': '集英社', 'subject': '花样男子'}]
                【输入文本】
                 王炳煌(1924-1951),福建省南安县水头镇山前村人。"""
    modelName3="spo"

    a = time.time()
    result = callServer(input1,modelName1)
    b = time.time()
    print("输出长度:"+str(len(result))+"字  耗时:"+str(round(b-a,2))+"秒  输出速度:"+str(round(len(result)/(b-a),2))+"字/秒")
    print(result)
bert_P_Tuning 与 dataCleaning 代码
61 个文件📁 bert_P_Tuning/
📁 data/
- 📄 dev.txt 98.7KB 下载
- 📄 train.txt 9.6KB 下载
- 📄 verbalizer.txt 174B 下载
📁 data2/
- 📄 dev2.txt 51.4KB 下载
- 📄 dev3.txt 43.5KB 下载
- 📄 dev4.txt 22.1KB 下载
- 📄 train2.txt 57.5KB 下载
- 📄 train3.txt 33.9KB 下载
- 📄 train4.txt 21.8KB 下载
📁 dataCleaning/
- 📄 __init__.py 0B 下载
- 📄 checkPrompt.txt 593B 下载
- 📄 cleanData.py 2.5KB 下载
- 📄 geneData.txt 44.2KB 下载
- 📄 geneDataRandom.txt 44.2KB 下载
- 📄 generateData.py 2.6KB 下载
- 📄 generatePrompt.txt 1020B 下载
- 📄 testClean.py 2.1KB 下载
- 📄 total.txt 108.2KB 下载
- 📄 tt.py 7.8KB 下载
- 📄 valid0.txt 3.2KB 下载
📁 data_handle/
- 📄 __init__.py 0B 下载
- 📄 data_loader.py 1.7KB 下载
- 📄 data_preprocess.py 6.1KB 下载
📁 test/
- 📄 __init__.py 0B 下载
- 📄 dotIn3DSpace.py 862B 下载
- 📄 tt.py 1.5KB 下载
📁 utils/
- 📄 __init__.py 0B 下载
- 📄 common_utils.py 4.0KB 下载
- 📄 metirc_utils.py 4.6KB 下载
- 📄 verbalizer.py 7.6KB 下载
- 📄 __init__.py 0B 下载
- 📄 inference.py 3.2KB 下载
- 📄 ptune_config.py 859B 下载
- 📄 train.py 7.6KB 下载
📁 data/
📁 电商分类语料/
- 📄 dev.txt 98.7KB 下载
- 📄 dev2.txt 51.4KB 下载
- 📄 dev3.txt 43.5KB 下载
- 📄 dev4.txt 22.1KB 下载
- 📄 train.txt 9.6KB 下载
- 📄 train2.txt 57.5KB 下载
- 📄 train3.txt 33.9KB 下载
- 📄 train4.txt 21.8KB 下载
📁 dataCleaning/
- 📄 __init__.py 0B 下载
- 📄 a_checkPrompt.txt 1.0KB 下载
- 📄 a_cleanData.py 2.6KB 下载
- 📄 b_cleanDataBatch.py 3.0KB 下载
- 📄 c_generateData.py 2.6KB 下载
- 📄 c_generatePrompt.txt 2.8KB 下载
- 📄 geneData.txt 44.2KB 下载
- 📄 geneDataRandom.txt 44.2KB 下载
- 📄 total.txt 108.2KB 下载
- 📄 valid.txt 10B 下载
- 📄 valid0.txt 3.2KB 下载
- 📄 01_testLlamaFactory.py 2.4KB 下载
- 📄 02_testVllm.py 2.5KB 下载
训练语料
- 📎 dataset_info.json 117B
- 📃 dev.txt 98.7KB
- 📃 dev2.txt 51.4KB
- 📃 dev3.txt 43.5KB
- 📃 dev4.txt 22.1KB
- 📃 train.txt 9.6KB
- 📃 train2.txt 57.5KB
- 📃 train3.txt 33.9KB
- 📃 train4.txt 21.8KB