第 1 节 / 共 5 节
微调基础与 LoRA 原理
大模型的重大改进
大模型基础
一、梦开始的地方-transformer
1 整体模型
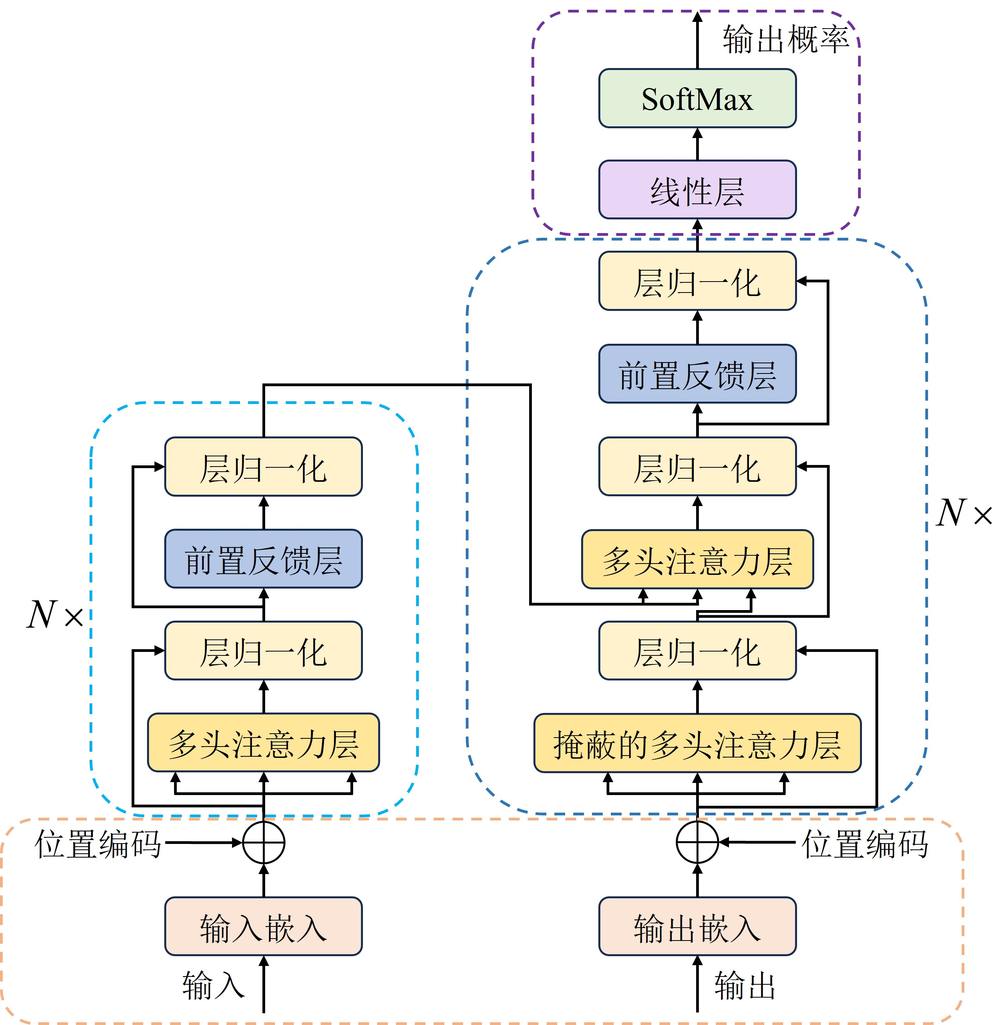
2 自注意力
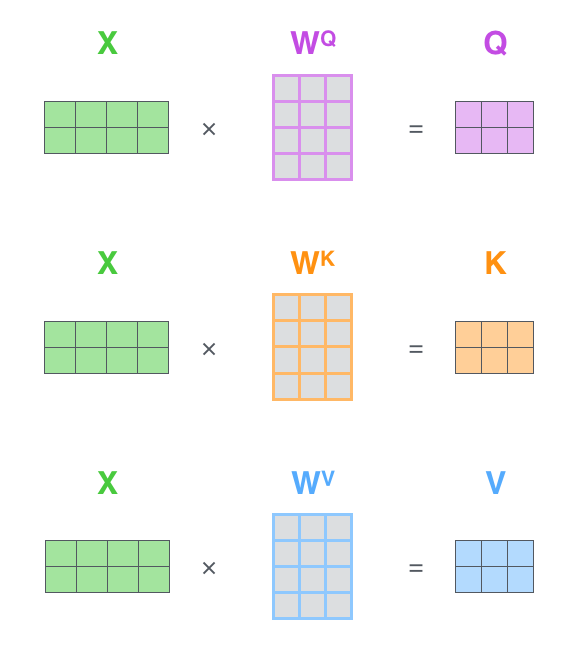
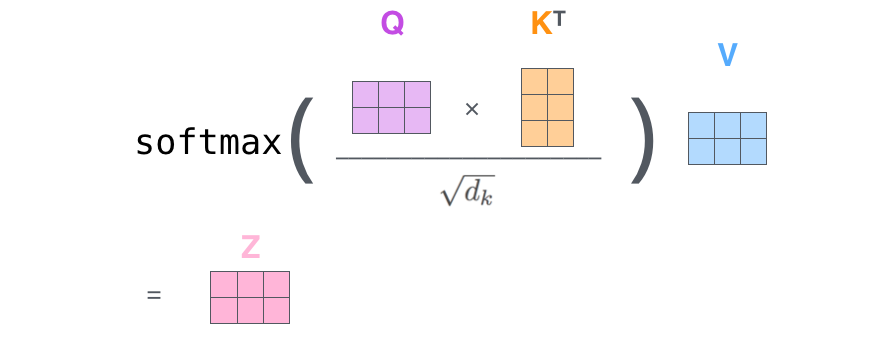
为什么除以\(\sqrt{d_k}\)?
a 缩放点积结果,避免信息损失。当超高维度向量做点积,结果可能会非常大,这样的结果经过softmax后,可能会出现很极端的值,softmax的结果会变得非常接近n-hot向量,损失大量信息。
b 保持数值稳定性。Softmax函数的输入值如果过大,会导致数值计算上的不稳定。例如,当输入值非常大时,指数函数的结果可能会超出浮点数的表示范围,导致溢出。通过缩放点积结果,可以避免这种情况,确保数值计算的稳定性。
c 保持点积方差不变。假设Query和Key向量是独立同分布的随机变量,那么它们的点积结果的方差会随着维度的增加而线性增加。为了保持点积结果的方差不变,需要除以dk。
3 多头注意力
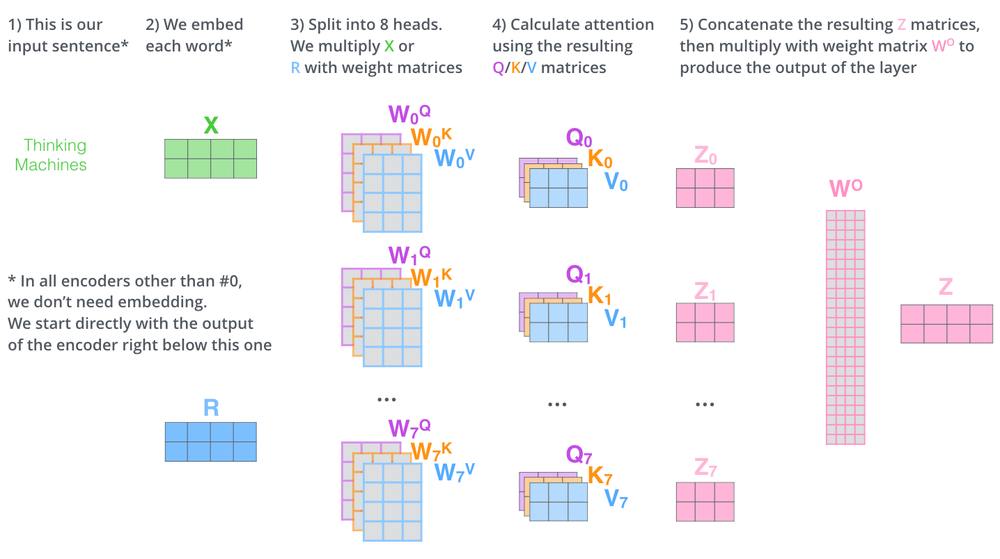
下面的例子仅仅是三维数据,从不同角度观察就会有重大差异,如果是几百维的数据,经过多个矩阵映射后,从不同的角度观察,会产生重大差异
import numpy as np
import matplotlib.pyplot as plt
from mpl_toolkits.mplot3d import Axes3D

# 设置随机种子保证可重复性
np.random.seed(42)

# 生成正样本数据 - 分布在圆周附近
n_pos = 200
theta = np.random.uniform(0, 2*np.pi, n_pos)
radius = 1.0
x_pos = radius * np.cos(theta) + np.random.normal(0, 0.1, n_pos)
y_pos = radius * np.sin(theta) + np.random.normal(0, 0.1, n_pos)
z_pos = np.random.normal(1.0, 0.1, n_pos)  # 在z轴上与负样本分离

# 生成负样本数据 - 分布在圆心附近
n_neg = 100
x_neg = np.random.normal(0, 0.2, n_neg)
y_neg = np.random.normal(0, 0.2, n_neg)
z_neg = np.random.normal(-1.0, 0.1, n_neg)  # 在z轴上与正样本分离

# 创建3D图形
fig = plt.figure(figsize=(10, 8))
ax = fig.add_subplot(111, projection='3d')

# 绘制正负样本点
ax.scatter(x_pos, y_pos, z_pos, c='b', marker='o', label='正样本', alpha=0.6)
ax.scatter(x_neg, y_neg, z_neg, c='r', marker='^', label='负样本', alpha=0.6)

# 设置图形属性
ax.set_xlabel('X轴')
ax.set_ylabel('Y轴')
ax.set_zlabel('Z轴')
ax.set_title('3D散点图:正负样本分布')
ax.legend()

# 调整视角
ax.view_init(elev=20, azim=45)

plt.tight_layout()
plt.show()
4 LN层
LayerNorm是针对单个样本的所有特征维度进行归一化。
对于一个输入向量 x=(x1,x2,...,xH)x=(x1,x2,...,xH)(H是隐藏层的维度),LayerNorm的计算步骤如下:
- 计算均值和方差:计算这个样本所有维度上的均值和方差。
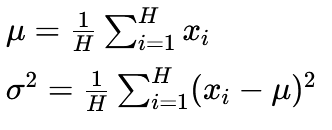
- 归一化:用计算出的均值和方差对输入进行归一化,使其均值为0,方差为1。
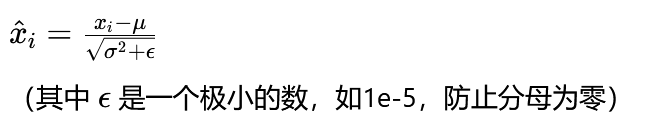
缩放和偏移:引入两个可学习的参数(缩放因子 γγ 和偏移项 ββ),对归一化后的值进行线性变换。
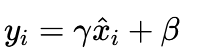
这一步至关重要,因为它赋予了模型恢复表征能力的自由度。如果规范化操作丢失了某些重要信息(比如激活函数的非线性区域),模型可以通过学习γ和β来恢复它。
在Transformer架构中,LayerNorm被用在两个关键位置:
- 每个编码器/解码器子层的后面(即残差连接之后),例如:
SublayerOutput = LayerNorm(x + Sublayer(x))。 - 在最终输出层之前。
其优势体现在:
- 对Batch Size不敏感:Transformer模型常常需要处理变长序列,Batch内的序列长度可能差异很大。BatchNorm在这种场景下效果不佳,而LayerNorm在每个样本上独立计算,与Batch Size无关,更加稳定。
- 适用于变长序*:无论是长句子还是短句子,LayerNorm都在其自身的特征维度上操作,处理起来非常自然。
- 稳定训练:Transformer模型通常很深,没有LayerNorm,训练非常困难。LayerNorm确保了数据流经多层后分布依然相对稳定。
- 与残差连接协同工作:LayerNorm被放在残差连接之后,可以规范化“原始输入”和“层变换输出”的叠加结果,使得数据在深度网络中能够更顺畅地流动。
5 位置编码
位置编码采用了一组很奇怪的公式:
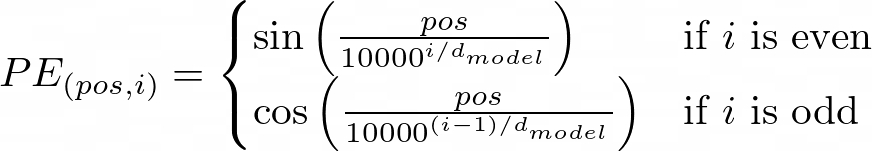
为什么要采用这么奇怪的公式?
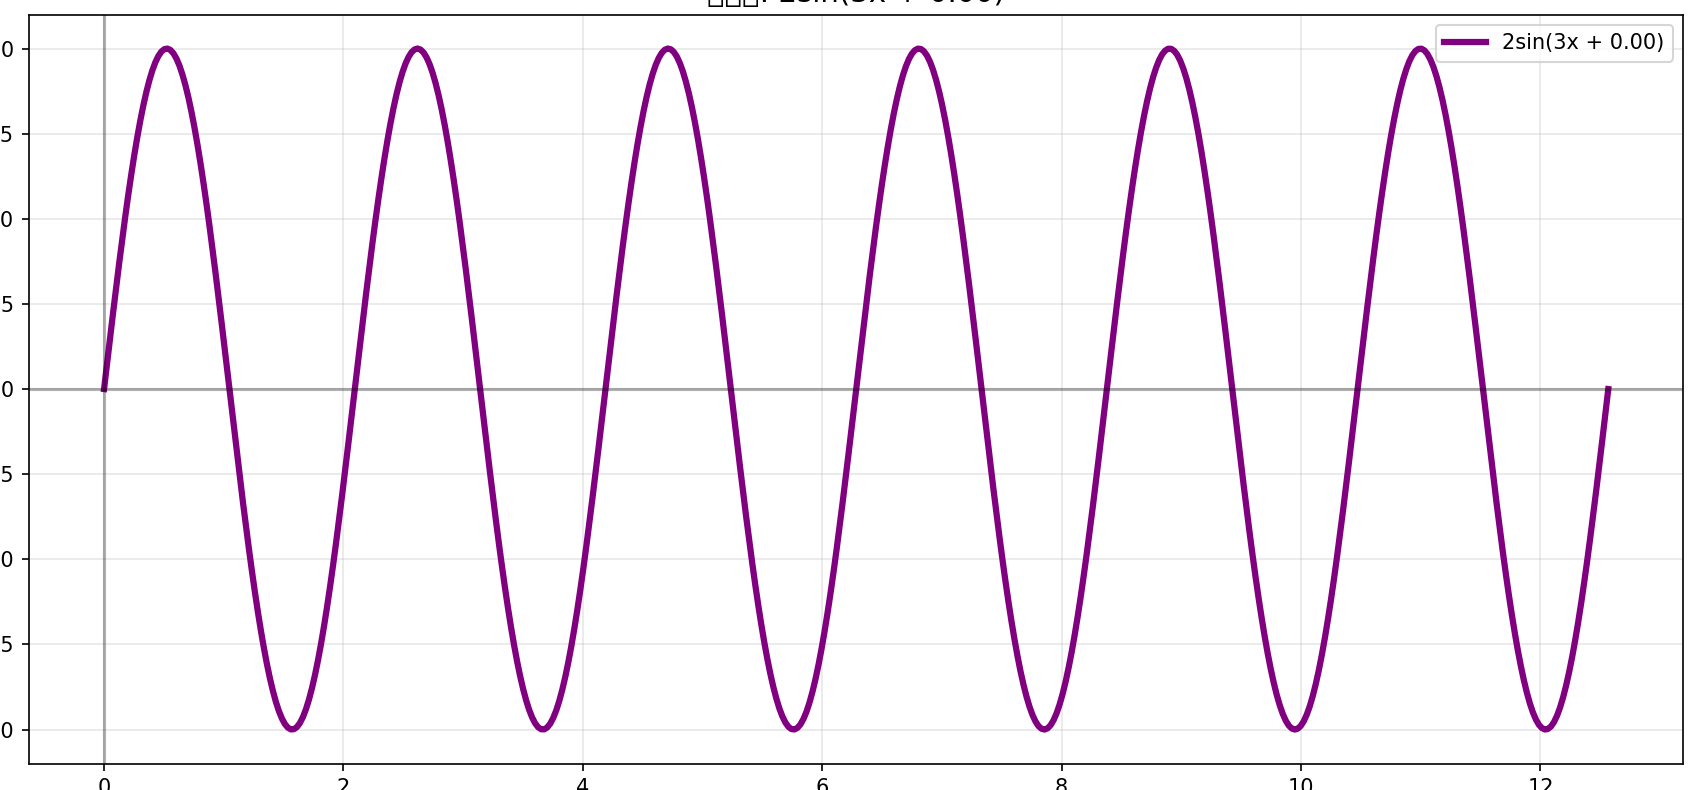
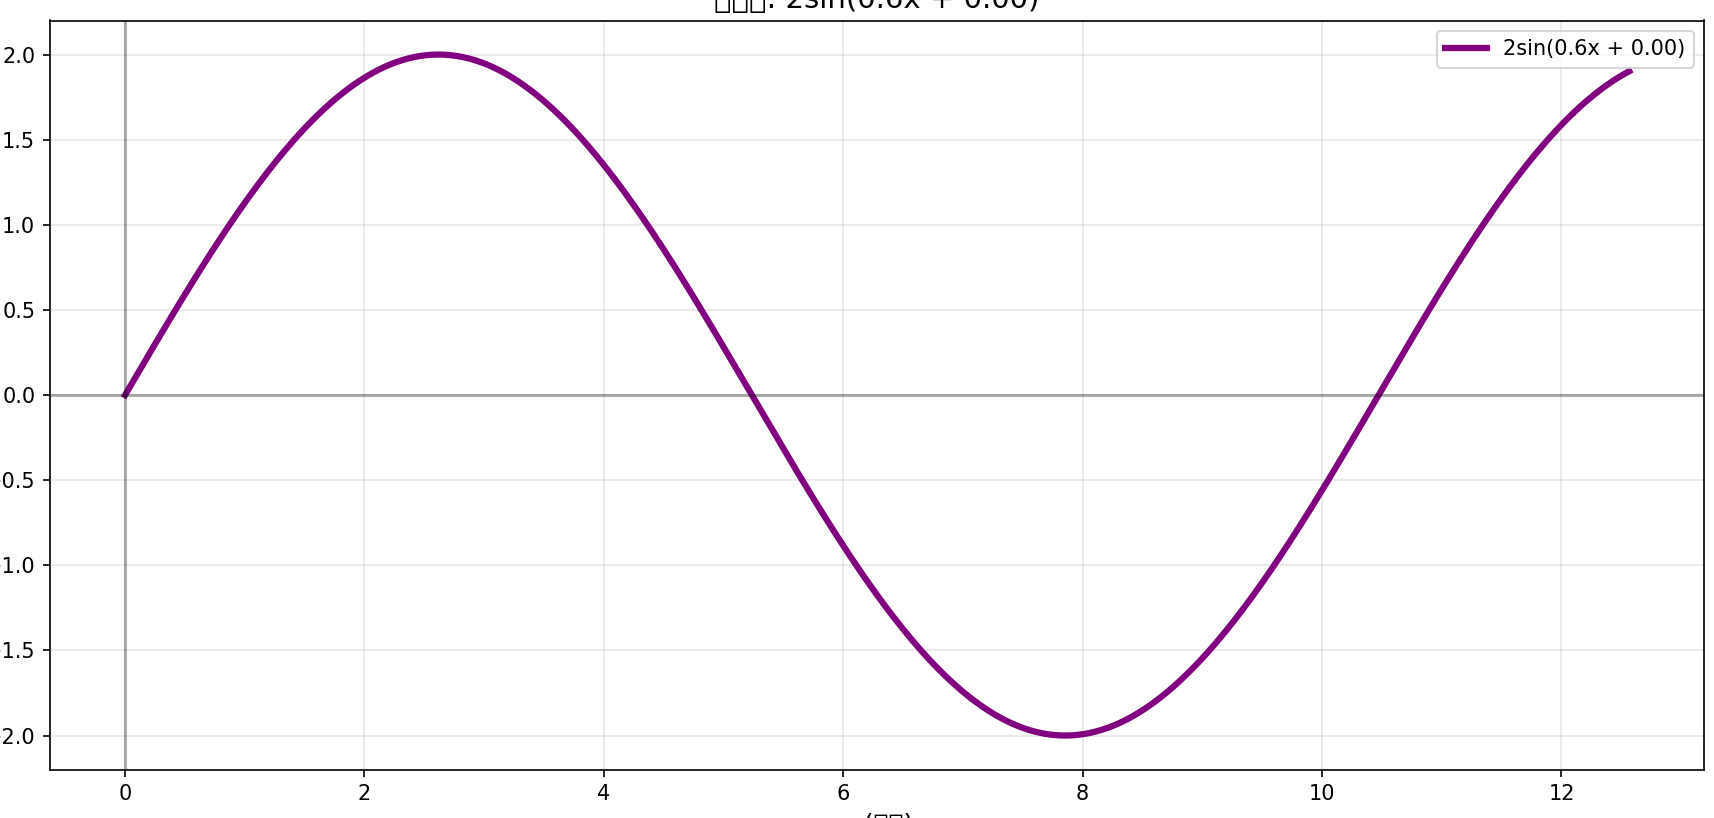
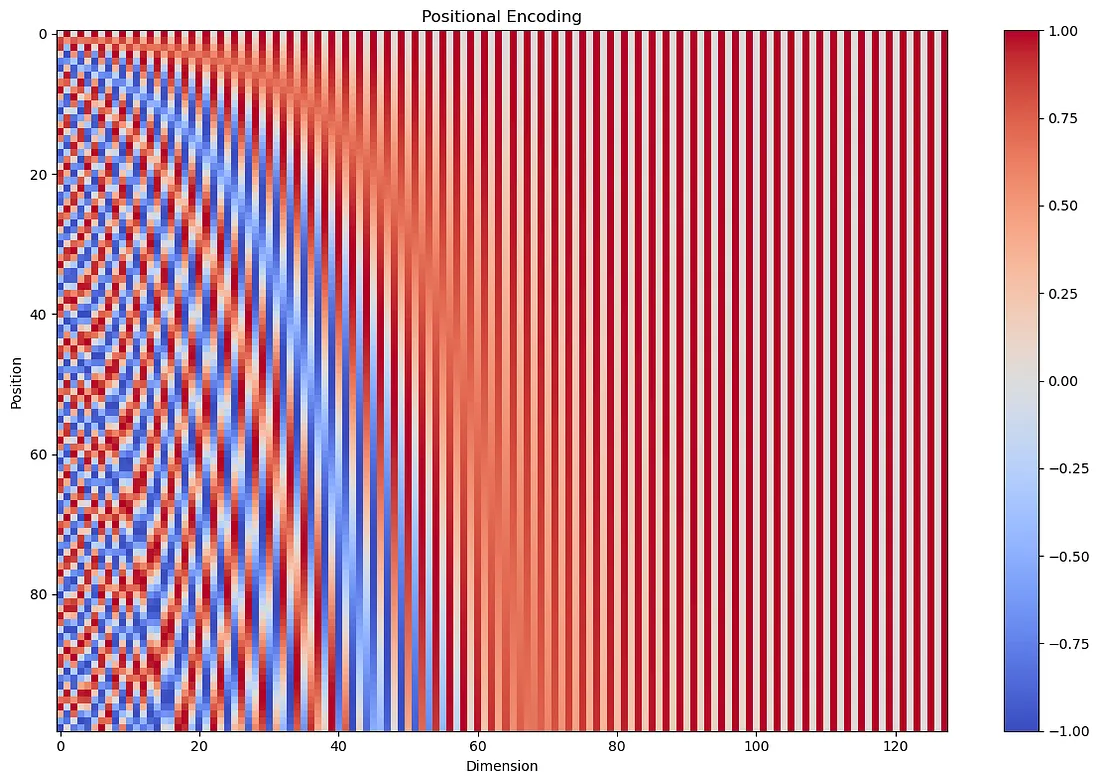
这样做位置编码的实际表现
三、BERT的改进
1 预训练任务
1.1 完形填空MLM
输入序列:
首先,将一段文本(比如一个或两个句子)输入到BERT中。
例如: "今天天气很好,我们一起去公园玩。"
随机掩码:
随机选择输入序列中15%的单词(Token)进行遮盖。遮盖有三种方式,按一定概率随机选择:
- 80%的概率
:将单词替换为特殊的
[MASK]
标记。
-
例如:
"今天天气很[MASK],我们一起去公园玩。" -
10%的概率
:将单词替换为一个随机的其他单词。
-
例如:
"今天天气很**棒**,我们一起去公园玩。"(假设随机把“好”换成了“棒”) -
10%的概率
:保持单词不变。
- 例如:
"今天天气很好,我们一起去公园玩。"(“好”没有被改变)
优势
- 双向上下文理解:这是MLM最革命性的地方。传统的语言模型(如GPT)是单向的(从左到右或从右到左),只能看到目标词之前的信息。而BERT的MLM任务允许模型同时看到目标词左右两边的全部信息,从而获得更深刻、更全面的语言理解能力。
- 深层语义学习:为了准确预测被遮盖的词,模型必须学习单词之间的语法关系、语义关联、常见搭配等语言学知识。例如,要预测
“我早上喝了一杯[MASK]”,模型需要知道“咖啡”、“牛奶”、“水”等词比“汽车”、“石头”更合理。 - 为下游任务打下基础:MLM任务本质上是一个“理解”任务,这与很多下游任务(如文本分类、情感分析、问答系统)的要求高度一致,即需要模型理解整个句子的含义。因此,通过MLM预训练出的BERT模型,其编码器已经具备了强大的语言表征能力,只需稍作微调就能在各种任务上取得优异效果。
1.2 句对任务
下一句预测(Next Sentence Prediction, NSP)任务的目标是让模型理解两个句子之间的关系,特别是判断第二个句子是否是第一个句子的自然延续。这旨在训练模型捕捉句子级别的语义连贯性,而不仅仅是词汇级别的信息。
在预训练时,BERT的输入是由两个句子A和B拼接而成的。
- 正例(IsNext)
: 从语料库(如维基百科)中选取连续的两个句子。句子B确实是句子A的下一句。
-
例如:
- 句子A:
“月球是地球唯一的天然卫星。” - 句子B:
“它围绕着地球进行公转。”
- 句子A:
-
负例(NotNext)
: 从语料库中随机抽取一个句子作为句子B,它和句子A在原文中
不连续
。
- 例如:
- 句子A:
“月球是地球唯一的天然卫星。” - 句子B:
“咖啡是一种用烘焙过的咖啡豆制成的饮料。”(一个随机抽取的无关句子)
- 句子A:
在训练数据中,正例和负例各占50%。
BERT使用特定的标记来构建输入:
[CLS]标记放在整个序列的开头。- 句子A和句子B之间用
[SEP]标记分隔。 - 最终输入形式:
[CLS] 句子A [SEP] 句子B [SEP]
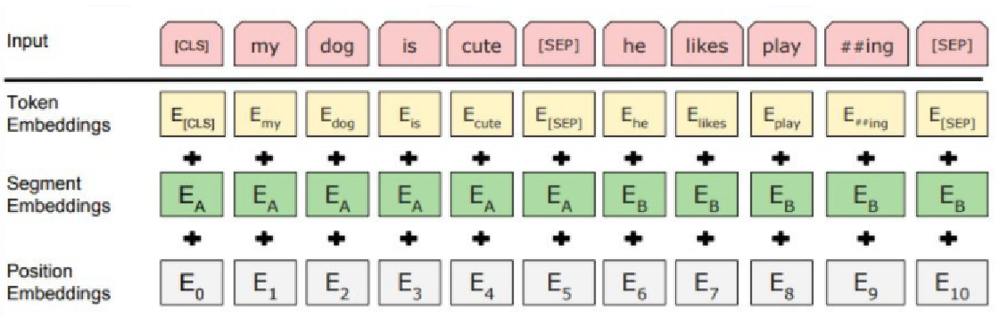
2 embedding层
3 下游任务微调
微调是BERT模型从“通用语言理解模型”转变为“特定任务专家”的关键步骤。其核心思想是:在预训练好的BERT模型基础上,针对特定的下游任务,用有标签的任务数据对模型的所有参数进行进一步的训练。
BERT的灵活性体现在它可以被微调以适应各种类型的NLP任务。
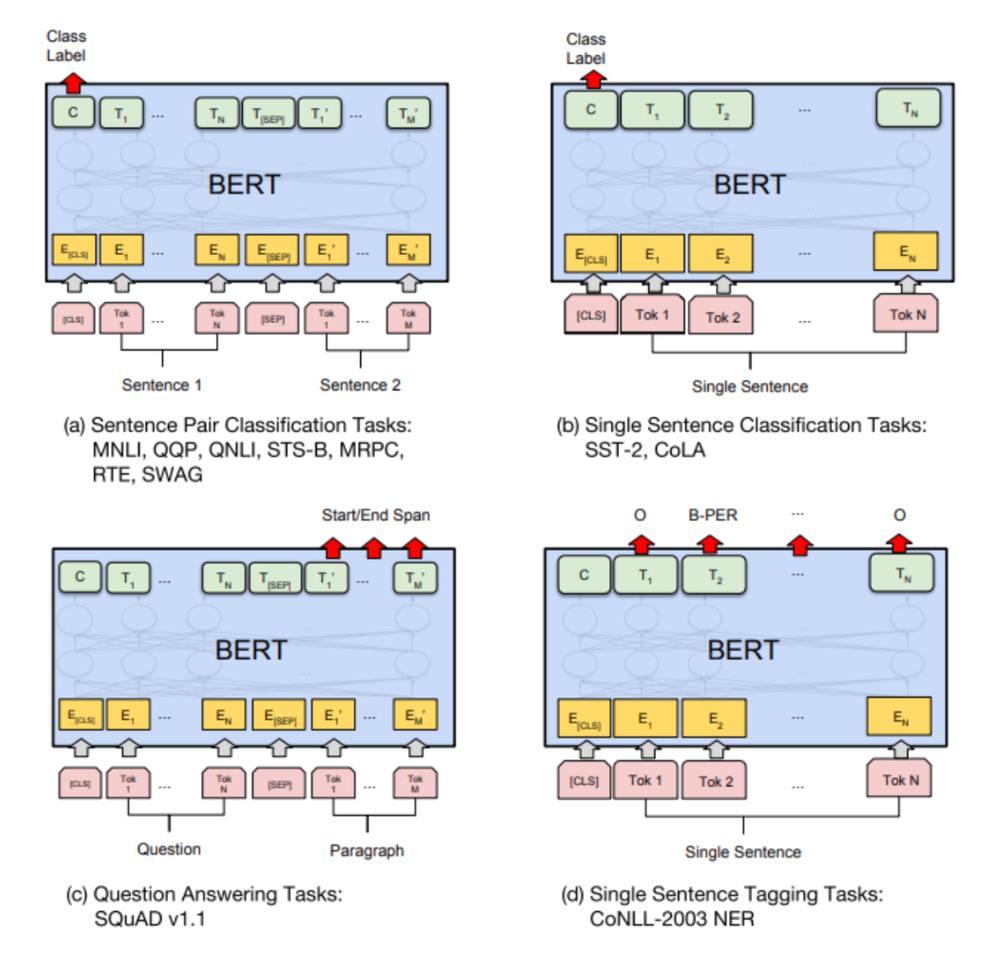
| 任务类型 | 示例 | 输入处理与输出层 |
|---|---|---|
| 句子对分类 | 自然语言推理(NLI)、语义相似度 | 输入:句子A [SEP] 句子B。使用 [CLS] 标记的输出向量进行三分类(蕴含/中立/矛盾)或二分类(相似/不相似)。 |
| 单句分类 | 情感分析、垃圾邮件检测 | 输入:单个句子。使用 [CLS] 标记的输出向量进行情感分类(正面/负面)等。sentenceTransformer |
| 问答 | SQuAD | 输入:问题 [SEP] 包含答案的文本段落。输出层需要两个向量,分别预测答案在段落中的开始位置和结束位置。 |
| 序列标注 | 命名实体识别、词性标注 | 输入:单个句子。将句子中每个词元对应的最终输出向量都送入一个分类器,预测其标签(如人名、地名等)。 |
四、主流大模型各分支的发展差异
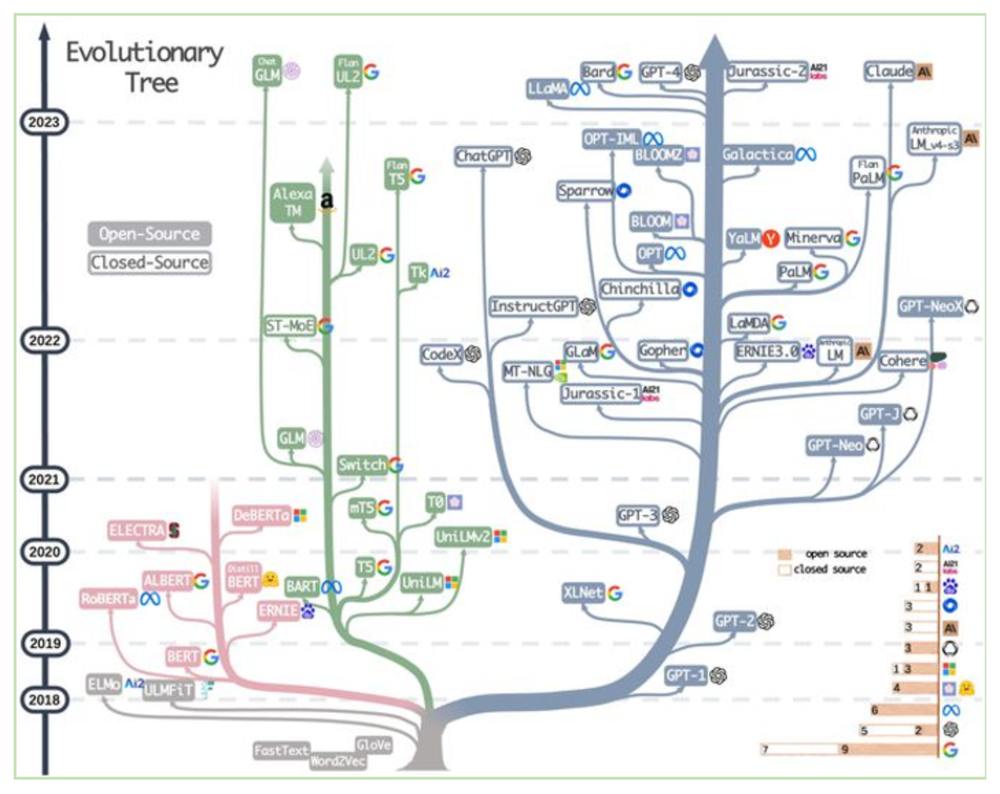
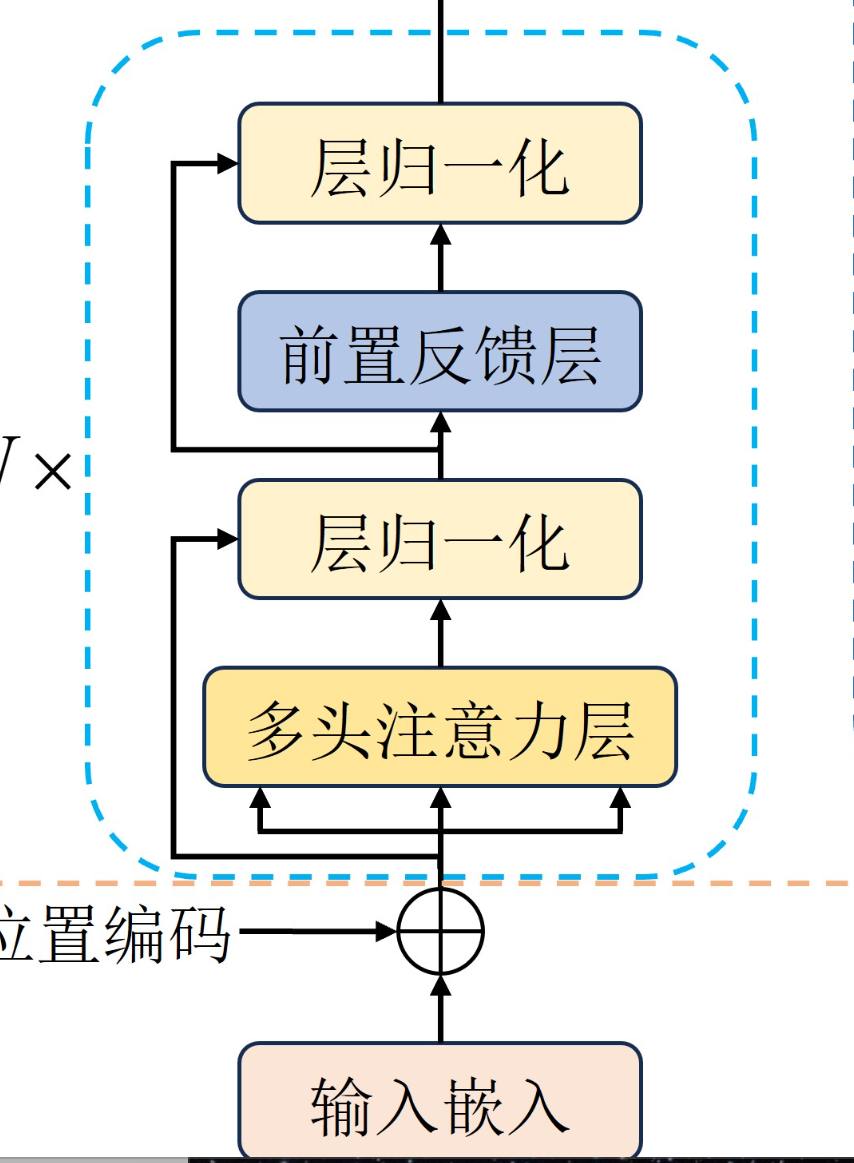
encoder-only
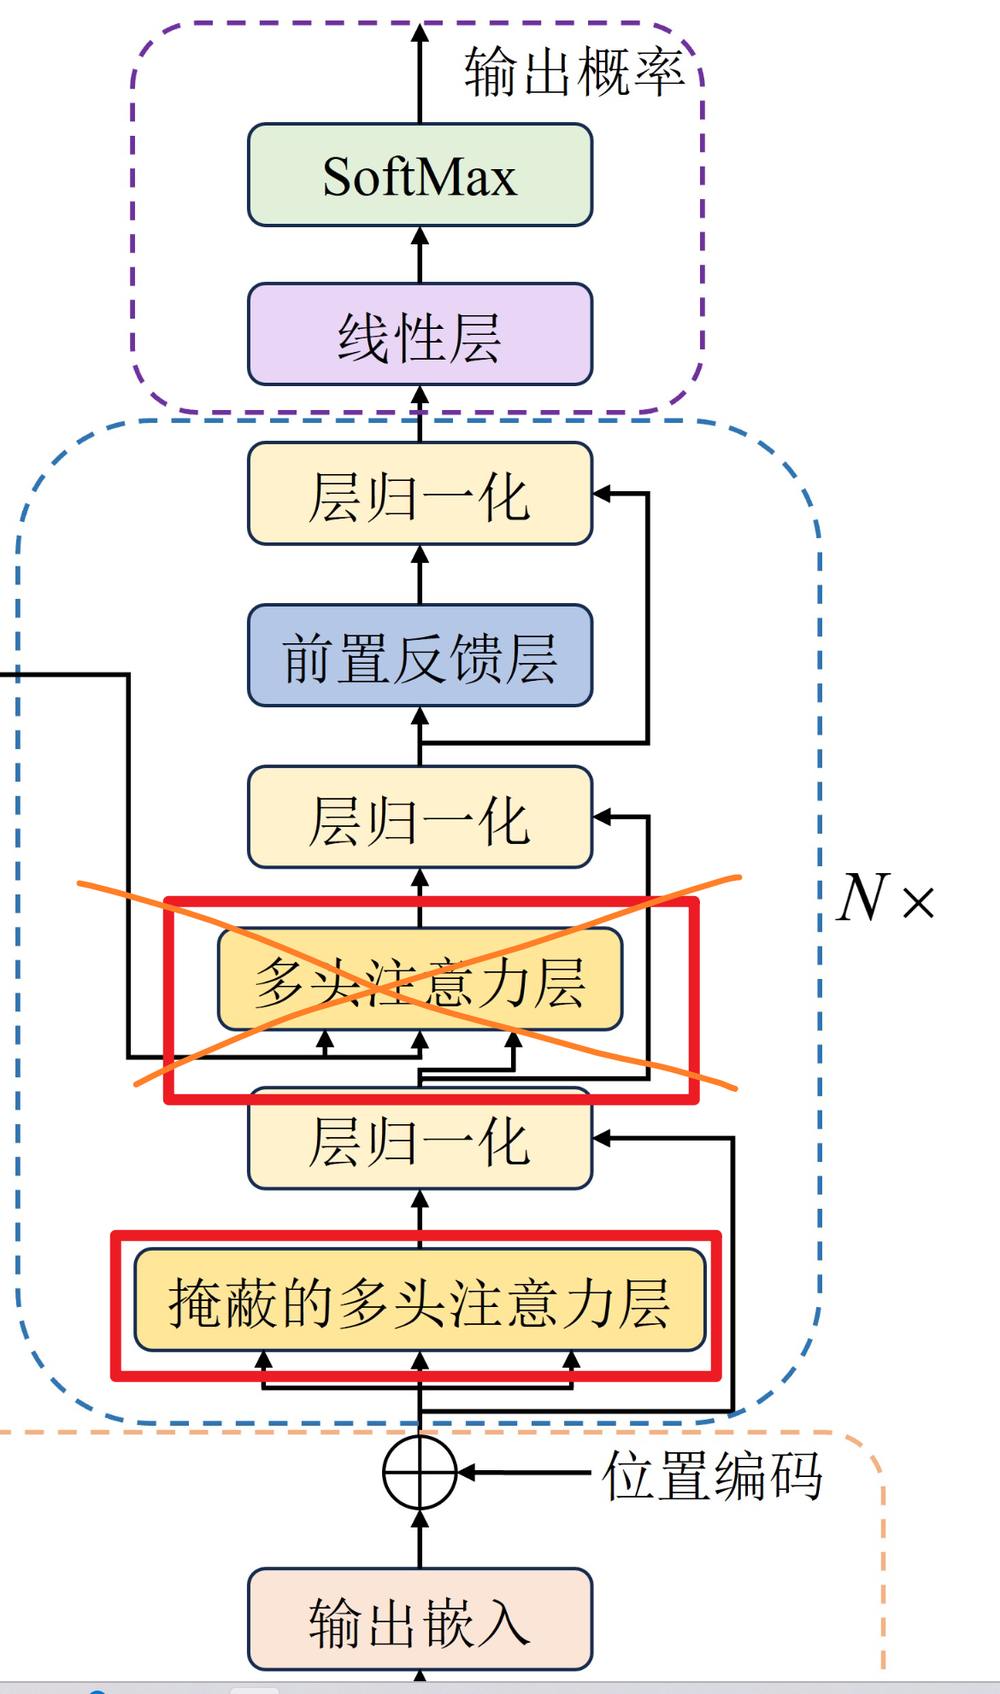
decoder-only
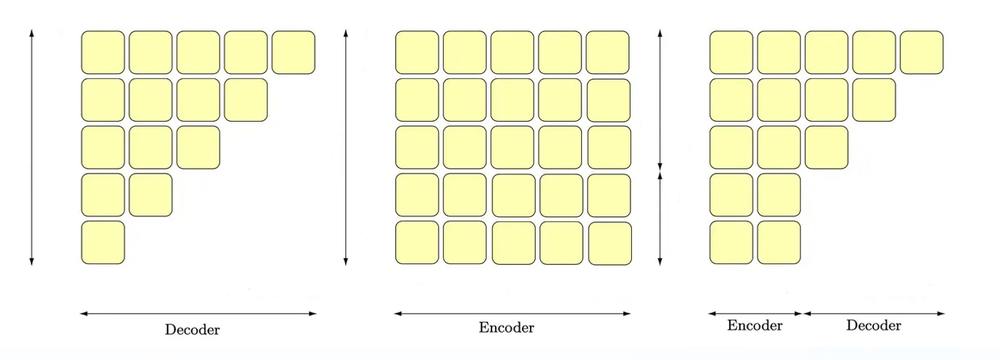
自编码模型是在知道模型上下文的情况下推测某个token的语义
自回归模型是在只知道上文的情况下推测下一个token的语义
序列到序列模型是在知道序列1的全文和序列2上文的情况下推测序列2下一个token的语义
这相当于求解下面的三个线性方程组:
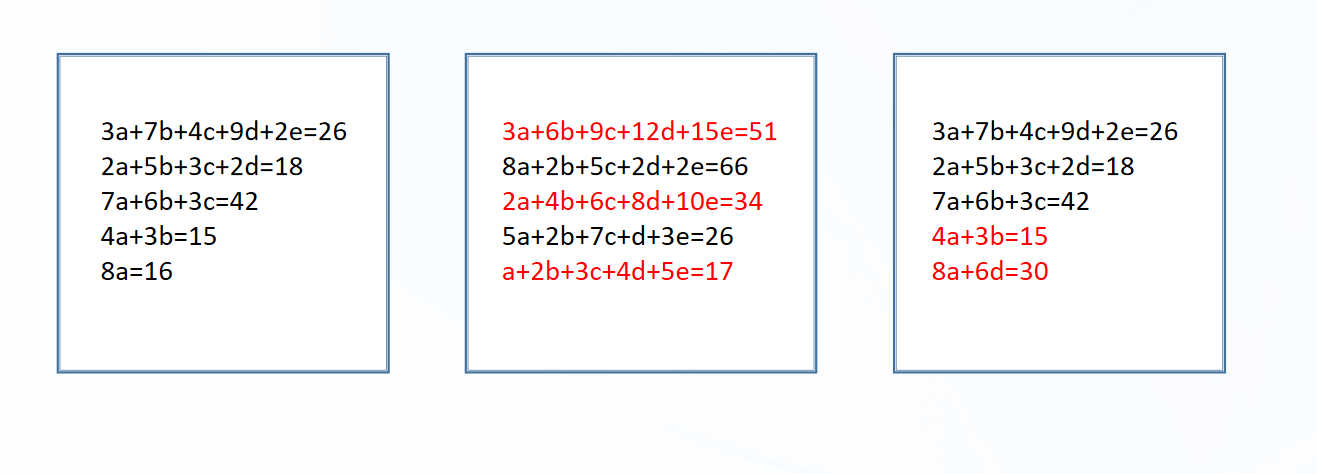
当模型比较小时,自编码模型因为能同时知道上下文信息,训练更为成熟,所以率先发展起来。
随着模型越来越大,自编码模型方程组中的共线性问题会越来越严重,表意能力受到较大的削弱,自回归模型则基本不受影响。
五、大模型发展过程中的重大改进
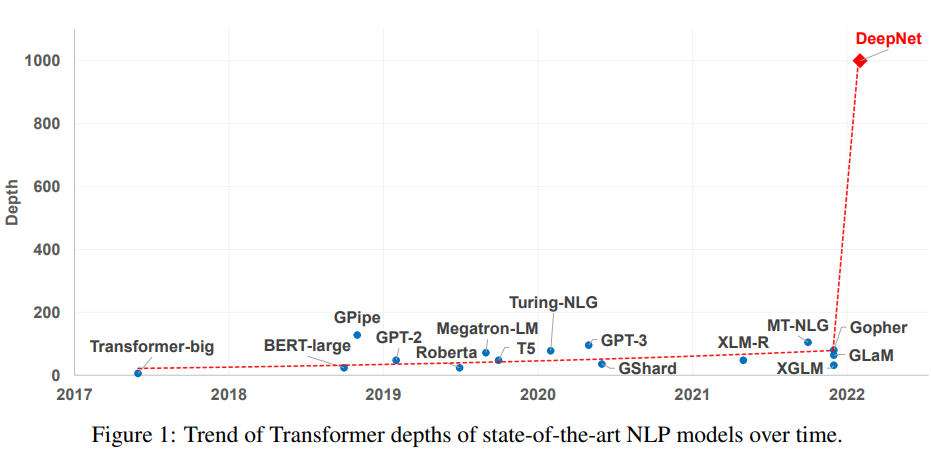
1 更深
1.1 post_layer_norm
post_layer_norm实质上是在复杂计算后,为了防止数据变得杂乱,对结果数据做了一次对齐,用这种方法,可以保证搭建20层左右的transforme结果。
1.2 pre_layer_norm
有没有可能数据在进行复杂计算之前,数据就已经很杂乱了,如果能将这一步骤提前,可以使得搭建层数进一步增长到100层以上。
1.3 deep_norm
使用layer_norm进行数据对齐,不能保证复杂计算层的训练一定是成功的,如果复杂计算层训练失败,那么无论怎样对齐,模型训练都会失败。
有没有可能某一个复杂计算层即使失败了,也不影响模型整体计算?
可以参照何明凯大神的残差网络的思路:https://arxiv.org/abs/1512.03385
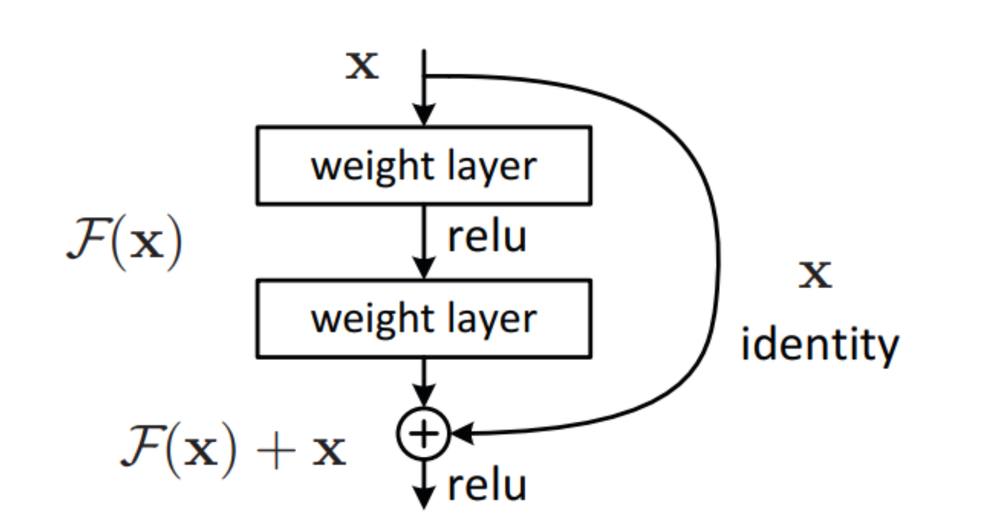
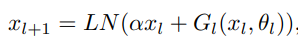
三者差异:post-norm(20层左右),pre-norm(100+层),deep-norm(1000层)
2 更长
transform结果的运算核心是自注意力机制,它的计算复杂度是n的平方,所以长度增加10倍,算力增加100倍,这是不可持续的。
2.1 绝对位置编码
绝对位置编码通过为序列中的每个位置生成固定维度的向量,该向量与输入数据无关,仅由位置决定。例如,对于长度为seq_len的序列,每个位置pos的编码由以下公式生成:
编码(pos,i)=sin(pos10000i/d)编码(p**os,i)=sin(10000i/dpos)
编码(pos,i)=cos(pos10000i/d)编码(p**os,i)=cos(10000i/dpos)
这种编码方式没有外推性,只能靠堆算力,所以长度增长无法持续
2.2 相对位置编码
旋转位置编码
- 能较好地表达相对位置
- 计算成本低
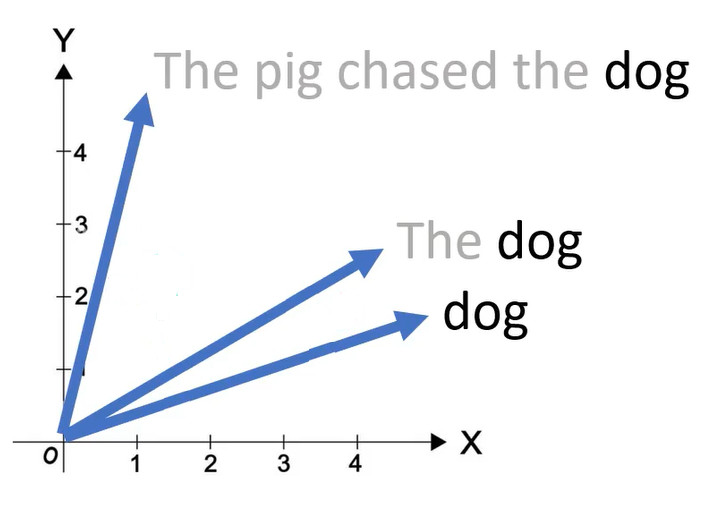
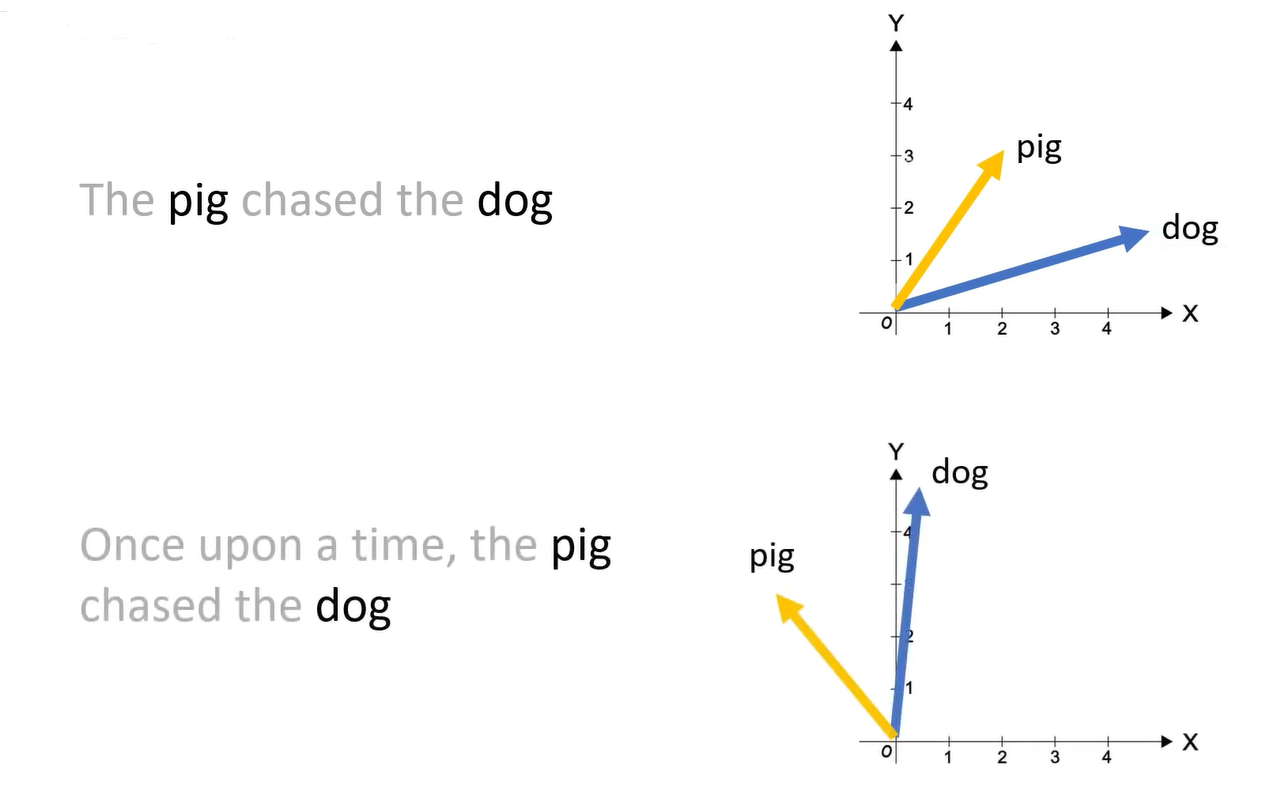
这种旋转的数学表达形式为:
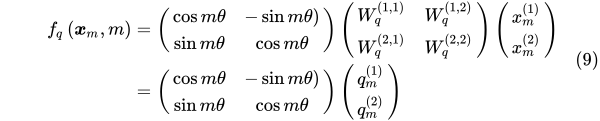
最终实际的计算量很小
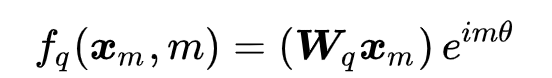
推导详情参照这篇文章
3 更快
3.1 RMSNorm
一般的LN层
RMSNorm
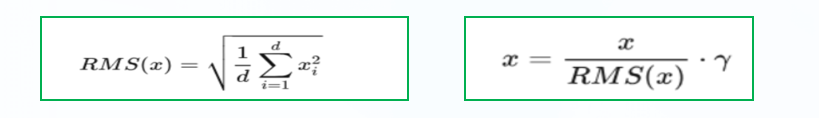
RMS Norm的主要区别在于去掉了减去均值的部分
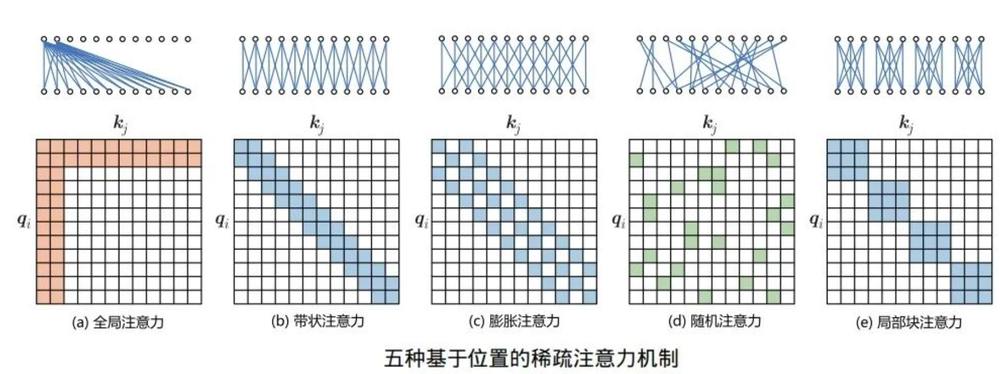
3.2 稀疏注意力
-
全局注意力(Global Attention):引入少量全局节点,用于建模长距离依赖。
-
带状注意力(Band Attention):利用数据的局部性,仅让 Query 与相邻若干节点交互。
-
膨胀注意力(Dilated Attention):类似于 CNN 中的空洞卷积,通过设置间隔扩大感受野。
-
随机注意力(Random Attention):通过随机采样实现非局部信息交互。
-
局部块注意力(Block Local Attention):将序列划分为多个不重叠块,信息交互限制在块内
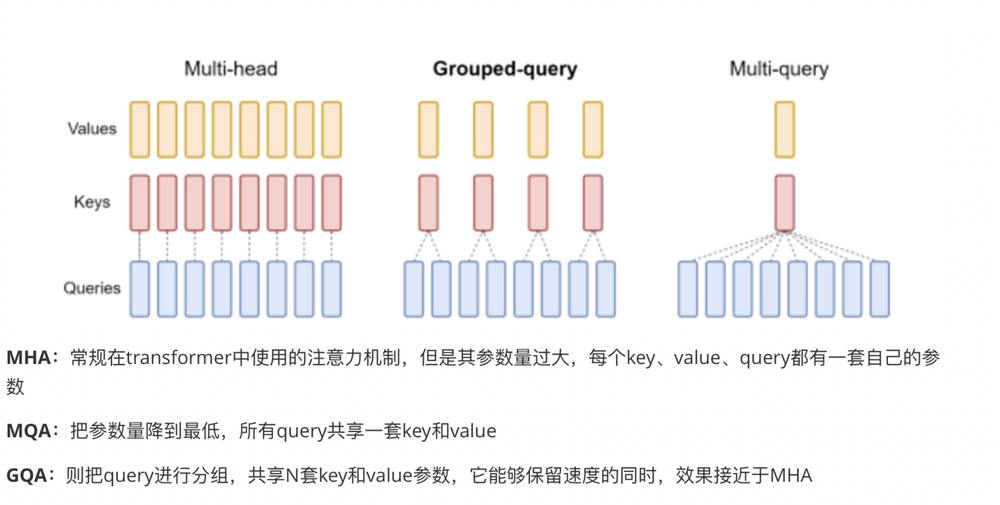
3.3 分组注意力
3.4 多头潜在注意力
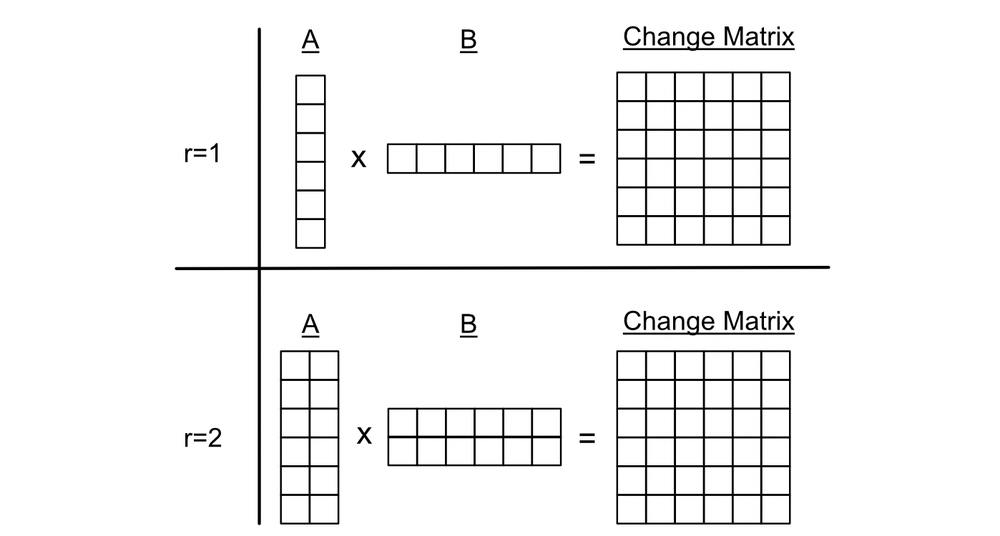
模型处理大量文本的时候,直接计算多头注意力占用大量显存,能否减少内存占用量?可以考虑多头潜在注意力(MLA)
MLA用低秩因子分解的方式,大幅降低了计算量,从MXN 降低到MXr+rXN
3.5 FP8混合精度
3.5.1 FP8混合精度的优势
随着模型变得极大(如大型语言模型拥有千亿参数),即使FP16混合精度也面临巨大挑战:
- 内存瓶颈:模型的权重、激活值、优化器状态和梯度需要消耗巨量GPU显存。FP16相比FP32只能将内存占用减半。
- 算力瓶颈:数据传输(例如从显存到计算单元)成为新的瓶颈,更低的精度意味着传输数据量更小。
- 功耗瓶颈:低精度计算能耗更低。
FP8(8位浮点数)应运而生。它将每个数值的存储空间从FP16的16位进一步压缩到8位,带来了直接的好处:
- 内存占用减半:相比FP16,FP8的权重、激活值占用的内存再减少50%。
- 传输带宽翻倍:在相同的内存带宽下,可以传输两倍于FP16的数据。
- 计算速度提升:新一代硬件(如NVIDIA H100 GPU)开始原生支持FP8计算,其计算吞吐量是FP16的两倍。
3.5.2 使用方式
直接使用FP8训练会非常困难,因为8位的数值表示范围和解精度比FP16更小,更容易出现数值不稳定。因此,FP8训练不是简单地把所有数据变成8位,而是一套更精细的系统工程。
其核心是 “混合” 和 “动态缩放”。
两种FP8格式:E5M2 和 E4M3
为了解决FP8表示范围和解精度之间的矛盾,业界提出了两种主流的FP8格式:
- E5M2:5位指数 + 2位尾数。优势是表示范围大,不易溢出,适合存储梯度等可能数值范围较大的数据。
- E4M3:4位指数 + 3位尾数。优势是精度稍高(因为尾数多了一位),但表示范围较小,适合存储权重和激活值。
在典型的FP8训练流水线中,可能会混合使用这两种格式,例如用E4M3表示前向传播的权重和激活,用E5M2表示反向传播的梯度。
分层动态缩放
这是FP8训练的灵魂。由于FP8的“尺子”刻度非常稀疏,我们必须确保要测量的“物体”(权重、激活、梯度)能够被精确地放在这把尺子上。
- 缩放因子:为一个张量(比如一层网络的输出激活值)计算一个缩放因子。这个因子是一个简单的浮点数,用于将该张量的数据范围“映射”到FP8能够有效表示的范围之内。
- 动态性:缩放因子不是固定的,而是在每个训练步骤中动态计算的。因为激活值和梯度的分布会随着模型权重的更新而不断变化。算法会跟踪张量的历史绝对值最大值(或使用其他统计量)来实时调整缩放因子。
- 粒度:缩放可以以非常细的粒度进行,例如每个张量甚至每个通道都有自己独立的缩放因子。这比FP16时代通常使用单个全局缩放因子要精细得多,能更好地保持数值精度。
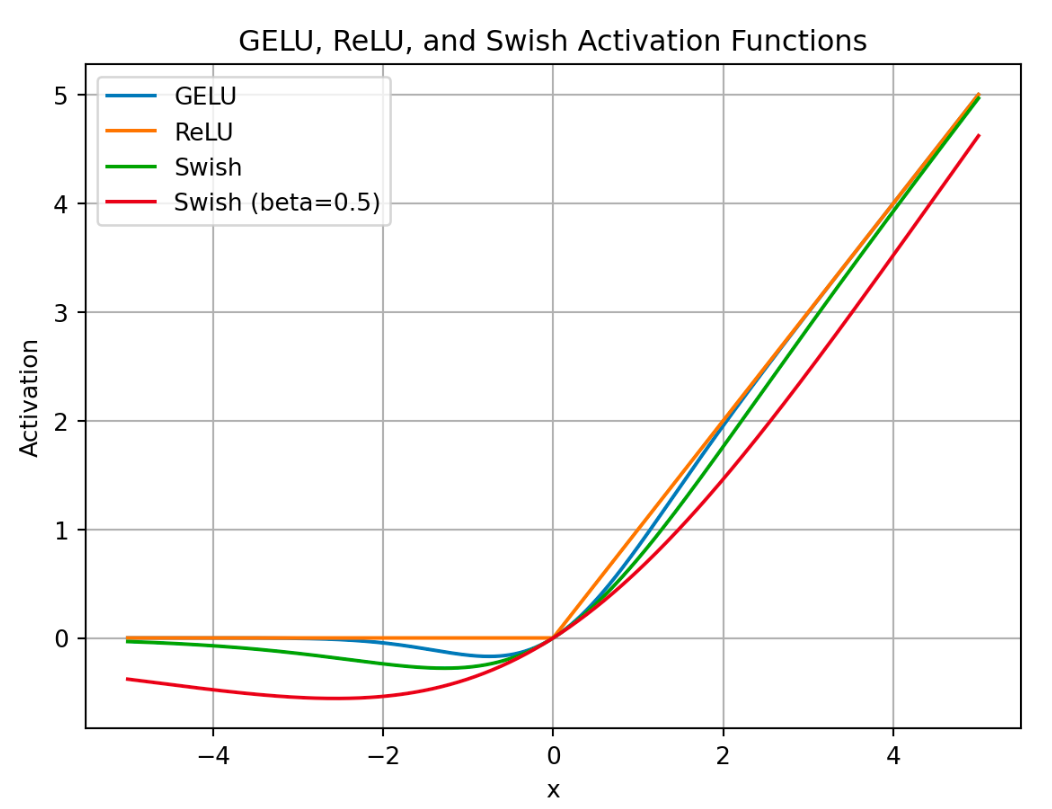
4 激活函数
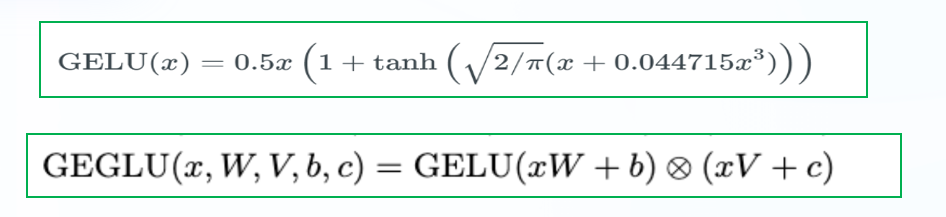
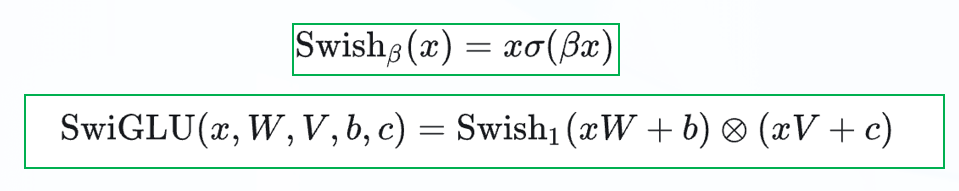
5 最新进展
5.1 混合专家模型
5.1.1 核心思路
- 传统模型(稠密模型):相当于找一个无所不知的“通才”。你需要教会这个人关于历史、地理、语言、美食、预算等所有方面的知识。让他处理每个问题,虽然全面,但可能不够精深,而且培养这样一个“通才”成本极高(需要巨大模型参数)。
- 混合专家模型:相当于组建一个“专家委员会”。这个委员会里有:
- 地理专家:精通各国地理位置和气候。
- 美食专家:深谙世界各地美食。
- 预算专家:擅长精打细算。
- 语言专家:通晓多国语言。
- ……
5.1.2 核心组件
一个标准的MoE层包含两个关键部分:
- 专家:这些是小型神经网络,通常是前馈网络。一个MoE层中包含多个这样的专家(例如8个、64个,甚至更多)。每个专家都有其擅长的特定领域或数据类型。
- 门控网络:也称为路由器。它的作用是分析输入数据,并决定将数据发送给哪些专家。它会为每个专家计算一个权重分数,然后选择权重最高的前k个专家(通常k=1或2)。
5.1.3 工作流程
- 输入:一个数据向量被送入MoE层。
- 路由:门控网络接收这个输入,并计算每个专家对于该输入的“适用度”分数。
- 选择专家:门控网络选择分数最高的k个专家。例如,k=2,则选择top-2专家。
- 专家计算:输入数据被分别发送给这k个被选中的专家。每个专家独立地进行计算,产生自己的输出。
- 加权组合:将k个专家的输出结果,按照他们从门控网络得到的分数进行加权求和,得到最终的MoE层输出。
虽然模型的总参数量非常大(因为有很多专家),但每个输入实际激活的参数量(称为激活参数)只是被选中的k个专家的参数,加上门控网络。这实现了“用更少的计算,撬动更大的模型能力”。
5.1.4 MoE的优势
- 极高的计算效率:这是最突出的优点。模型总参数可以达到千亿甚至万亿规模,但每个token的计算成本只相当于一个百亿规模的稠密模型。这意味着用更少的计算资源,获得了大模型才具备的强大能力。
- 模型容量巨大:MoE可以轻松地通过增加专家数量来扩展模型的总知识容量,而不会显著增加计算时间。
- 隐性专业化:在训练过程中,专家会自发地形成专业化分工。有些专家可能擅长处理数学逻辑,有些擅长文学创作,有些擅长代码生成。门控网络学会了如何将问题分配给合适的专家。
5.1.5 MoE的挑战
MoE并非完美,它也带来了一些新的挑战:
- 训练不稳定:门控网络和专家是共同训练的。容易出现“赢家通吃”的局面,即少数几个专家被频繁选择,而其他专家得不到训练,成为“僵尸专家”。需要复杂的负载均衡技术来确保所有专家都能被充分训练。
- 高昂的显存占用:尽管计算量小,但所有专家的参数都需要加载到GPU显存中。因此,MoE模型对显存的需求非常高。这更像是一种“用显存换计算”的权衡。
- 通信成本:在分布式训练中,不同的专家可能分布在不同的GPU上。需要高效的数据路由和同步机制,这可能会引入通信瓶颈。
5.2 快慢双模式
首次将认知科学中的“双系统理论”工程化,构建混合推理架构:
- 快思考模式(非推理模式):处理日常对话、信息提取等简单任务时,仅激活20%参数,实现毫秒级响应,算力消耗降低40%。
- 慢思考模式(推理模式):面对数学证明、代码生成等复杂任务时,启动深度推理模块,支持多步骤分析,动态控制思考预算(最高38K token)。
在使用 ollama run qwen3 时,默认启用了 think 模式。如果你希望关闭这一模式,不同版本的 Ollama 有不同的设置方式。
旧版本(如 0.6.6),可以在输入提示后添加 /no_think 来关闭该模式:
hi /no_think
新版本(如 0.9.2),使用 /set 命令进行模式切换:
/set nothink
设置完成后,接下来的提示将不再使用 think 模式。
启用 think 模式:
/set think
qwen3.5之前通过 API,无论是新版本还是旧版本, 都是在提示语后加 /no_think
注意:qwen3.5之后的思考模型和之前的不一样,API调用关闭思考的方法也有差异
5.3 原生多模态模型
以前很多模型其实是把图像“转译”成文本再处理,但 Qwen3.5 是直接把图像、文本甚至视频一起训练的。这就让qwen系列模型在图像视频的理解和推理上有很大的优势
5.4 线性注意力
transformer最成功的就是引入了自注意力机制,让模型可以在一段文本的任意token之间建立语义关联,但这种计算是平方级别的,严重限制了模型对长文本的处理能力。线性注意力是一种优化Transformer自注意力机制的技术,其核心思想是将自注意力中的Softmax函数移除,通过数学等价变换重写为循环神经网络的递推形式,从而将计算复杂度从序列长度的平方级降低至线性级。2020年的论文《Transformer是循环神经网络》最早确立了这一研究方向,随后的改进主要集中在加门控机制或引入Delta Rule。2025年12月,南洋理工大学、复旦大学的研究团队提出了无误差线性注意力(EFLA),从连续时间动力学角度实现了精确计算 。阿里巴巴、月之暗面等公司在其模型中采用了线性注意力与全注意力混合的架构,
线性注意力使用数学技巧对公式进行了重组。它去掉了原本用于处理负数和平滑的softmax函数,改用核函数代替。
- 计算顺序: 先计算 \(K^{T}\) 与 \(V\) 的乘积(这一步结果很小,不随序列长度膨胀),最后再左乘 \(Q\)。
- 为什么快: 改变运算顺序后,系统不需要生成和存储 N*N的中间大矩阵,计算量退化为与序列长度 \(N\) 相关的单次操作,整体复杂度直接降为 \(O(N)\)。
5.5 压缩稀疏注意力(CAS)和重度压缩注意力(HCA)
压缩稀疏注意力(CSA,Compressed Sparse Attention)是一种为了处理超长文本而设计的AI运算优化技术。
传统AI在阅读超长文章时,会把每个Token与之前出现过的所有Token一一对比,导致计算量和内存消耗呈平方级爆炸。CSA 则采用了类似人类**“做笔记 + 快速查阅”**的思路:
它的工作分为三个步骤:
- 压缩(Compression): 将长文中相邻的几个Token压缩合并成 1 个“摘要”或“路标”。这样先把历史记录的总体积大幅缩小。
- 粗筛(Sparse): 就像在书中快速扫目录,系统用一套算法在压缩后的摘要中挑选出最相关的少数几个(Top-K)“关键段落”,忽略无关内容。
- 精读(Attention): 只把挑选出来的关键片段拿出来,让模型进行完整的计算和理解。
重度压缩注意力(HCA)是大语言模型处理超长文本的核心技术。它的原理就像人类阅读长文时**“快速浏览大意”**:将离当前阅读位置较远、不需要关注具体细节的大段文字,按高比例(如每128个Token压缩成1个摘要)打包成精简的信息块,从而大幅节省计算量和内存。
5.6 流形约束超连接(mHC)
传统的神经网络使用“残差连接”(类似单行道)让数据稳定流动。为了让模型表现更好,科学家引入了“超连接”(HC,类似多车道高架桥),使信息可以在各层之间自由穿梭和重新排列。但这种“太自由”的连接会导致信息混乱,使得信号在深层网络中发生爆炸或消失,导致模型训练崩溃。为了解决超连接的“失控”,mHC 提出了“流形约束”。
在数学上,mHC 将这些复杂的连接方式全部约束在一个被称为双随机矩阵(或 Birkhoff 多面体)的特定范围(流形)内。
这个约束范围有一个极其优良的物理特性——它的每一行和每一列的数字加起来都等于 \(1\)。这意味着,无论经过多少层的叠加运算,输入的信息总量和平均值永远保持不变。
通过这一巧妙的数学限制,mHC 达成了两个目标:
- 保留了优势:超连接让各层信息自由交流的灵活性依然存在。
- 解决了崩溃:数据的信号被严格圈定在安全的轨道内,彻底根治了深层网络训练的不稳定问题,且几乎不增加额外的硬件负担。
课件:LoRA 微调
- 📕 LoRA微调.pdf 711.5KB
📄 LoRA微调.pdf · 文字提取版
以下为 PDF 文字提取版(排版有简化,原文见附件)。
第 1 页
LoRA 微调 2.1 什么是 LoRA 微调 LoRA 微调的全程是 Low-Rank Adaptation ,这种方法通过引入低秩矩阵分解,可以通过仅训练少量 参数实现大模型的适配。 2.2 全参数微调的缺陷 全参数微调有几个重大的缺陷 2.2.1 训练成本高 全参数微调,需要更新千亿甚至万亿级别的参数,会消耗大量计算资源,为了调整海量参数时不跑 偏,还需要准备相当规模的数据集,费时费力。 2.2.2 训练时间长 全参数微调训练时间会比较长,有些场合需要快速迭代,跟不上业务的节奏 2.2.3 灾难性遗忘 全参数微调需要根据新任务,调整和重构预训练模型的所有参数,有可能导致原有的知识表征被破 坏,导致新任务上表现虽好,但是旧任务上的表现急剧下降,这就是大模型的灾难性遗忘。 2.3 LoRA 微调怎样避免这些问题? 需要训练一个巨大的参数矩阵 ,为了避免灾难性遗忘,训练的时候,我们不能调整原始矩 阵,而是要调整一个同样大小的矩阵 ,使得推理时可以用 代替原来的 。 此时训练的参数量仍未 M*N ,如何改善? 机器学习里的 PCA 使用过一个思路:矩阵分解。很多算法都使用类似的方法降低计算量(潜在语义 分析 LSA ,推荐系统里的协同过滤) 不是真正地训练一个巨大的矩阵 ,而是训练两个小型矩阵 和 ,使得 ,只要这两个结果足够近似,在工程上就是可行的。 如果 r 远小于 M 、 N ,就可以极大地压缩参数量。
第 2 页
假设 M=300000 , N=500000 ,那么 的总参数量为 M*N=1500 亿。 如果取 r=16 ,那么 的参数量为 M*r=480 万, 同理 的参数量为 r*N=800 万, 总参数量为 1280 万,仅为 总参数量的 0.000085 ,即不到万分之一。 2.4 实际做法 每个 transformer 都添加低秩旁路 矩阵 A 高斯初始化 矩阵 B 初始化为全 0 矩阵
注意力变体代码(MHA / SqRtDK / DualMode)
3 个文件- 📄 d_multi_head.py 1.3KB 下载
- 📄 e_sqrtdk.py 1.8KB 下载
- 📄 g_dual_mode.py 311B 下载