第 3 节 / 共 5 节
DeepSpeed 并行与 LlamaFactory 量化实操
DeepSpeed 讲义
一、为什么要考虑并行计算?
1 大模型体量与应用
大模型在现有算法领域的作用不言而喻。
不同参数规模的大模型都有其使用领域,越大的参数规模一般而言代表着越强的能力。
| 参数规模 | 核心特点与能力 | 典型应用场景 | 部署要求与示例模型 |
|---|---|---|---|
| ~1B (亿级) | 极致轻量,速度快,成本极低。 具备基础语言能力,但逻辑推理和知识储备很弱,适合执行模式固定、低复杂度的任务。 | 1. 移动端/边缘AI:手机离线翻译、智能输入法、简单的个人语音助手。 2. 特定任务精调:短信/邮件关键词提取与分类、非常基础的客服问答对。 3. 硬件实验:在树莓派、嵌入式设备上验证AI应用可行性。 | 部署要求低:可在手机、笔记本电脑上流畅运行。 示例:Phi-2 (2.7B), Gemma-2B, TinyLlama-1.1B |
| ~3B-7B | 轻量与能力的良好平衡点。 具备不错的语言理解和生成能力,能处理更复杂的指令,是当前开源社区最活跃的规模之一。 | 1. 端侧高级应用:离线版的个人写作助手、代码补全工具(如本地版Copilot)。 2. 企业专用工具:通过精调成为企业知识库问答、文档摘要的专用模型。 3. 内容生成入门:社交媒体文案生成、简单的博客文章起草。 | 部署要求中低:需要单张消费级GPU(如RTX 3090/4090)即可高效运行。 示例:Llama 3-8B, Qwen1.5-7B, ChatGLM3-6B |
| ~14B-32B | 能力强劲的“多面手”。 在推理、代码、数学等方面表现出色,是许多高性能开源模型选择的规模,能处理大多数复杂任务。 | 1. 企业级核心引擎:作为企业智能客服大脑、自动化报告生成器、软件开发生命周期辅助。 2. 高质量内容创作:撰写技术文档、市场分析报告、剧本大纲等。 3. 高级研究与开发:进行复杂的Agent(智能体)实验和多步骤任务规划。 | 部署要求中等:需要单张或双张高性能数据中心GPU(如A100/H100)。 示例:Qwen1.5-32B, Yi-34B, Llama 2-34B |
| ~70B | 接近顶尖闭源模型的能力。 在各项基准测试中表现优异,逻辑推理和知识整合能力极强,是私有化部署的“天花板”级选择。 | 1. 替代闭源API:希望完全掌控数据隐私,同时需要接近GPT-4级别能力的企业首选。 2. 复杂问题解决:深度数据分析和洞察发现、复杂的战略规划模拟。 3. 科研与创新:用于科学发现、高级代码生成、以及作为更强大AI系统的基石模型。 | 部署要求高:需要多张(如4-8张)高性能GPU进行推理,成本较高。 示例:Llama 3-70B, Qwen-72B, Mixtral 8x7B (MoE模型,总参数量大但激活参数少,效率高) |
| ~150B+ (千亿级) | 业界顶尖,通向AGI的探索。 具备强大的涌现能力和深度推理能力,性能卓越,但训练和推理成本极其昂贵。 | 1. 国家级/巨头级AI基础设施:作为公共服务平台(如ChatGPT、文心一言、Claude)的核心。 2. 前沿探索与突破:解决开放性科学难题、进行颠覆性创新、处理超复杂多模态任务。 3. 统一底座:作为通用底座,通过提示工程或轻量微调支撑几乎所有类型的下游应用。 | 部署要求极高:需要大规模GPU集群(成百上千张卡),仅大型科技公司或研究机构能够承担。 示例:GPT-4, Claude 3 |
2 显存占用问题
但是训练和部署大模型是非常昂贵的。我们主要关注训练,只有先训练才能考虑部署的问题。
训练部分先不考虑快慢,先说能不能训练,仅以显存而言,训练大模型需要大量显存。
LLaMA-Factory官网GitHub - hiyouga/LLaMA-Factory: Unified Efficient Fine-Tuning of 100+ LLMs & VLMs (ACL 2024)提供了显存估算表格
* estimated
| Method | Bits | 7B | 14B | 30B | 70B | xB |
|---|---|---|---|---|---|---|
Full (bf16 or fp16) |
32 | 120GB | 240GB | 600GB | 1200GB | 18xGB |
Full (pure_bf16) |
16 | 60GB | 120GB | 300GB | 600GB | 8xGB |
| Freeze/LoRA/GaLore/APOLLO/BAdam/OFT | 16 | 16GB | 32GB | 64GB | 160GB | 2xGB |
| QLoRA / QOFT | 8 | 10GB | 20GB | 40GB | 80GB | xGB |
| QLoRA / QOFT | 4 | 6GB | 12GB | 24GB | 48GB | x/2GB |
| QLoRA / QOFT | 2 | 4GB | 8GB | 16GB | 24GB | x/4GB |
3 解决方案
1 扩大显存
- 更大的显卡(有物理上限,有经济上限)
- 更多的显卡并行计算(有等待成本,有通信成本)
2 缩小模型
- 量化 (怎么保证效果不严重下降?)
- 裁剪 (怎么保证被裁减的那部分不重要?)
- 蒸馏 (怎么保证学生模型能够学到关键信息?)
二、并行化策略
1 数据并行
1.1 梯度下降
梯度下降 是一种用于寻找函数最小值的迭代优化算法。在机器学习和深度学习中,它的核心任务是通过调整模型的参数,来最小化一个称为“损失函数”的成本函数。
什么是梯度?对于一个多元函数 f(θ)(例如,θ 是模型的参数),其梯度是一个向量,记作 ∇f(θ)。梯度向量的方向** 指明了函数值变化最快的方向。 在每一步迭代中,我们计算损失函数在当前参数值处的梯度,然后将参数向梯度的方向移动一小步。通过反复执行这个过程,我们期望损失函数的值会逐渐减小,最终接近一个最小值点。
梯度下降的参数更新公式非常简洁:
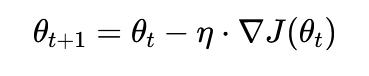
- θt:代表在第 t 次迭代时模型的参数(可以是一个值,也可以是一个向量,包含所有权重和偏置)。
- θt+1:代表更新后的参数。
- J(θt):是损失函数,它衡量模型在当前参数 θt 下的表现有多差。我们的目标是最小化 J。
- ∇J(θt:是损失函数 JJ 在点 θt 处的梯度。它告诉我们 J 在 θt 点处各个方向上的变化率。
- η:学习率,它控制着我们每次沿着梯度反方向迈出的步长。如果学习率 太小,算法需要很多次迭代才能收敛(到达最低点),训练速度会非常慢。如果学习率 太大,我们迈的步子太大,可能会直接“跨过”最低点,导致算法在最小值附近震荡,甚至可能无法收敛(损失函数值反而越来越大)。
到底计算完多少条数据后更新梯度呢?
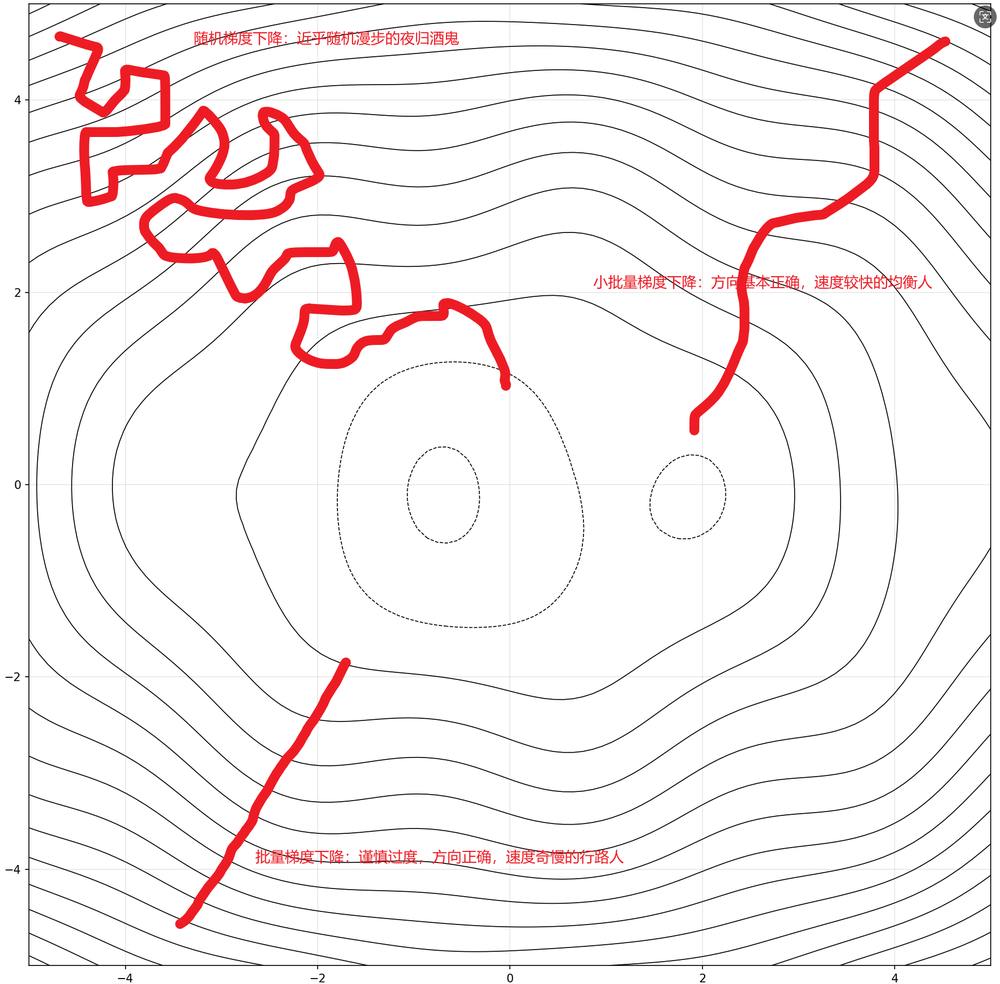
1.1 随机梯度下降
每次随机选择一个训练样本来计算梯度,并立即更新参数。
放弃梯度的绝对精确性,换取计算速度的巨大提升。虽然单个样本的梯度方向可能是“错误”的、嘈杂的,但平均来看,它仍然会指向全局最小值的方向。
想象你在山上想下山(找到山谷的最低点),随便踩一脚,感觉一下脚下的坡度,就朝着那个方向走一步。虽然某一步可能走歪,但一直走下去,最终也能到达山底。
1.2 批量梯度下降
在每一步更新参数时,它都会使用整个训练数据集来计算损失函数的梯度。
由于使用了全部数据,它计算的梯度方向非常准确,会直接朝向损失函数的最小值。
但是速度非常慢。如果数据集有数百万个样本,每更新一次参数就要计算数百万次,计算成本和内存开销巨大。
1.3 小批量梯度下降
在每一步更新参数时,它随机选择一小批样本(例如 32, 64, 128 个)来计算梯度。
它结合了批量梯度下降(梯度相对稳定)和随机梯度下降(速度快)的优点,是现代深度学习框架的默认选择。通常,人们口语中说的“随机梯度下降”指的就是这种小批量版本。
1.4 多个样本的梯度合并
小批量梯度下降的损失怎样计算?
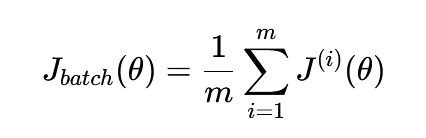
梯度怎样计算?
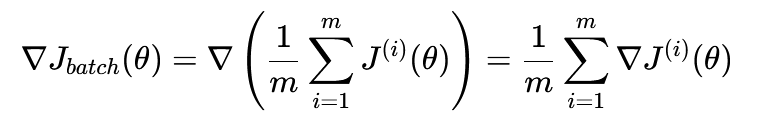
如果这些样本的计算不是发生在同一个设备上,应该怎样处理?
1.5 数据并行
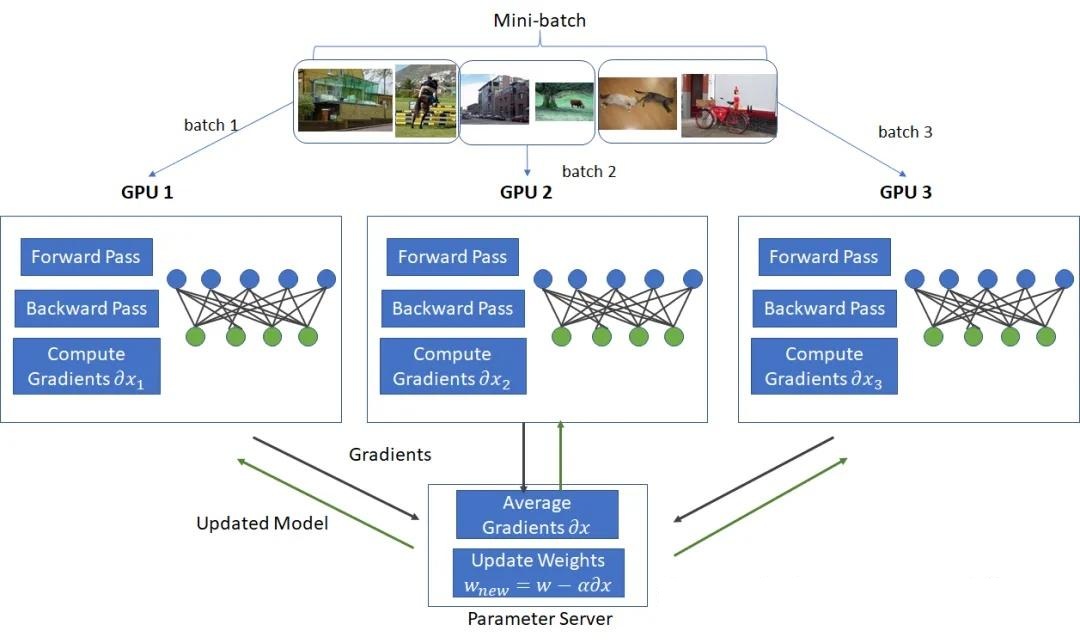
第1步:模型复制与数据分发
- 模型复制:将同一份模型的参数(权重和偏置)完全复制到多个工作节点(通常是GPU)上。每个GPU上的模型副本是完全相同的。
- 数据分发:数据加载器将一个大的全局批次(Global Batch)均匀地分割成N个小批次(N是GPU的数量),并将每个小批次分配给一个GPU。
例如:假设全局批次大小是 192,你有 3 个 GPU。那么每个GPU将处理 256 / 4 = 64 个样本。
第2步:独立前向传播
- 每个GPU使用自己分配到的数据小批次,独立地进行前向传播,计算损失函数。
第3步:独立反向传播
- 每个GPU根据第2步计算出的损失,独立地进行反向传播,计算得到相对于本GPU上模型参数的梯度。
- 此时,每个GPU都拥有一份梯度,但这些梯度是基于不同数据子集计算出来的,因此各不相同。
第4步:梯度同步(这是最关键的步骤!)
这是数据并行的“灵魂”。我们需要将所有GPU计算出的梯度聚合起来,得到一个能代表整个全局批次(256个样本)的“平均梯度”。
-
推送梯度:所有工作GPU将计算出的梯度发送给参数服务器。
-
聚合梯度:参数服务器收集到所有梯度后,对它们进行平均(Averaging)。
-
更新参数:参数服务器使用平均后的梯度来更新主模型参数。
-
拉取参数:参数服务器将更新后的新参数广播给所有工作GPU。
-
参数同步:所有工作GPU用新参数替换自己原有的参数,确保所有模型副本保持一致。
第5步:重复迭代
- 完成一次同步更新后,所有GPU上的模型参数保持一致。然后开始处理下一个全局批次,重复步骤1-4,直到模型收敛。
2 模型并行
数据并行有一个大前提,就是模型比较小,一张卡就能装下,但是现在的大模型体量越来越大,很多情况下单张卡不可能装下,这时需要模型并行。
模型并行是将模型的不同部分分配给不同的处理器进行计算,怎么分配?有两种思路:
第一种是将模型按层在深度方向上进行切分。比如一个包含24个Transformer层的模型,可以切分成4个分片,每个分片包含6个连续的层,并分别放到4个不同的GPU上.
第二种是当模型体量更加庞大,哪怕只是其中一层,单张卡也装不下,这时需要考虑张量并行,将模型单个层内部的巨大权重矩阵进行切分,分布到多个GPU上。
2.1 流水线并行
流水线并行是一种将模型划分为多个阶段,并在不同的处理器上并行处理这些阶段的方法。
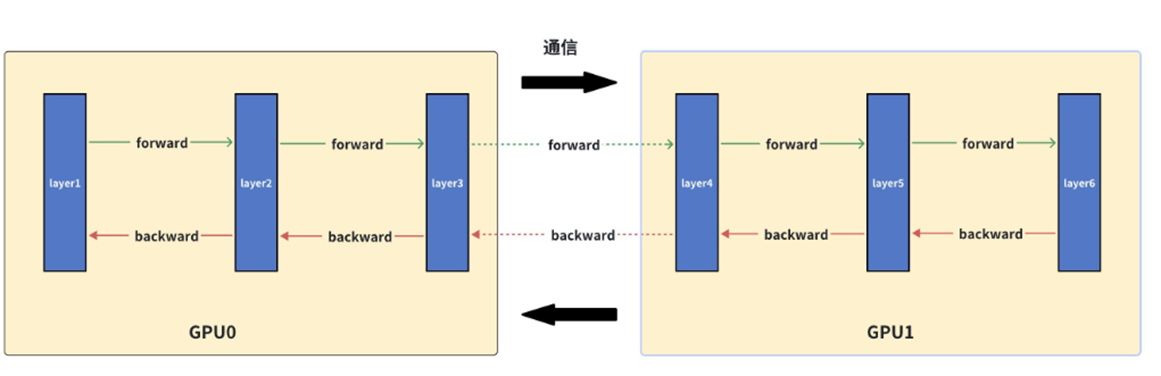
假如网络有6层,将模型分成两组,分别放在GPU0与GPU1上。前向传播的时候,每个batch的数据会从第一层开始依次进行前向计算,当第三层传递到第四层时候,会有GPU0与GPU1之间的通信开销。同理进行反向传播的时候,则从第六层开始依次进行后向计算,第四层到第三层的反向传播,会有GPU间的通信开销。
同一节点上的不同GPU通信开销时间较少,在多机多卡训练的时候,可能会涉及到不同节点间GPU通信,通信开销会非常大。
该方案最大的缺陷是GPU的利用率太低,当一个GPU进行计算的时候,其他层的GPU都是闲置的。
通过将模型的不同层或计算阶段分配给不同的处理器,并允许它们并行运行,可以显著提高训练效率。谷歌提出了GPipe 流水线并行,下图所示:
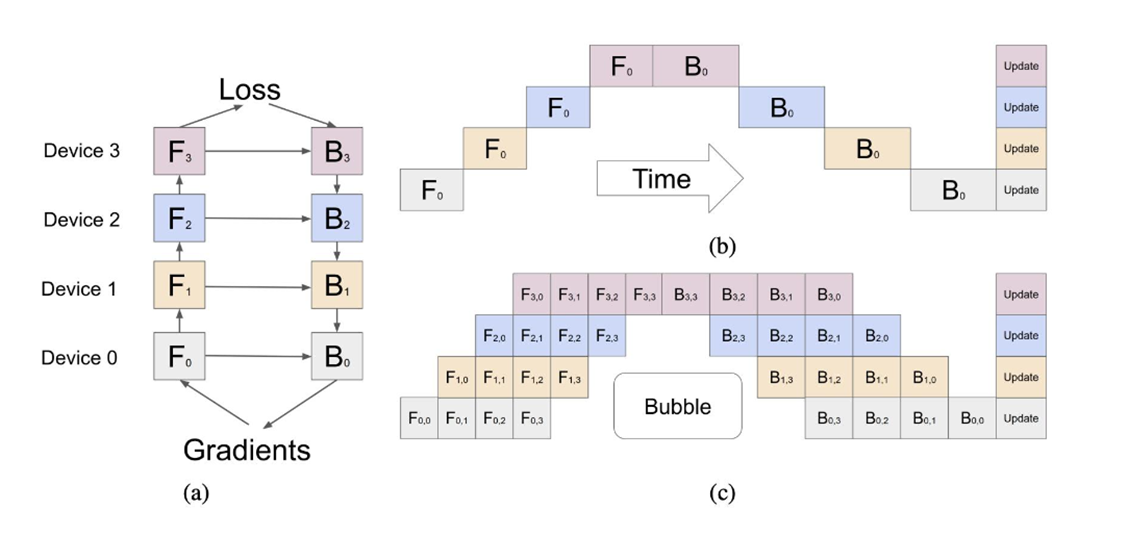
图(a),模型的网络分成四组,分别装载到 Device0到Dvice3四个GPU上。
图b表示朴素模型拆分并行方式运行情况,在每个时间节点上,只有一台设备在进行计算,GPU利用率最高只有四分之一。
图©是GPipe优化方案,引用了一个chunks的超参数,将每一个mini-batch数据划分到chunks个micro-batchs上。 图©表示 chunks=4的情况下,每个时段的GPU运行情况。第t0时间段,device0计算第一个micro-batchs数据在第一组网络上的前向计算,用F(0,0)表示,在t1时间段,基于F(0,0)运算结果,在device1上进行F(1,0)的计算,此时在device0上我们将第二个micro-batchs数据上传进行第一组模型网络前向计算用F(1,0)表示,此时四个GPU有两个在工作的。依次类推,在第三个时间段有三个GPU在工作,第四个时间段有四个GPU在工作。在进行反向传播的时候,则依次从device3至device0进行计算。
通过GPipe 优化流水线并行的实现,减少了处理器之间的通信开销,从而进一步提高了训练速度。
2.2 张量并行
所有的一切都是源于线性代数里的矩阵乘法
2.1.1 向量点积
u和v是两个2维向量,该怎样计算他们的点积?
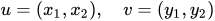
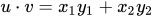
2.1.2 矩阵点积
把问题扩大到矩阵,怎样计算两个矩阵的乘法?
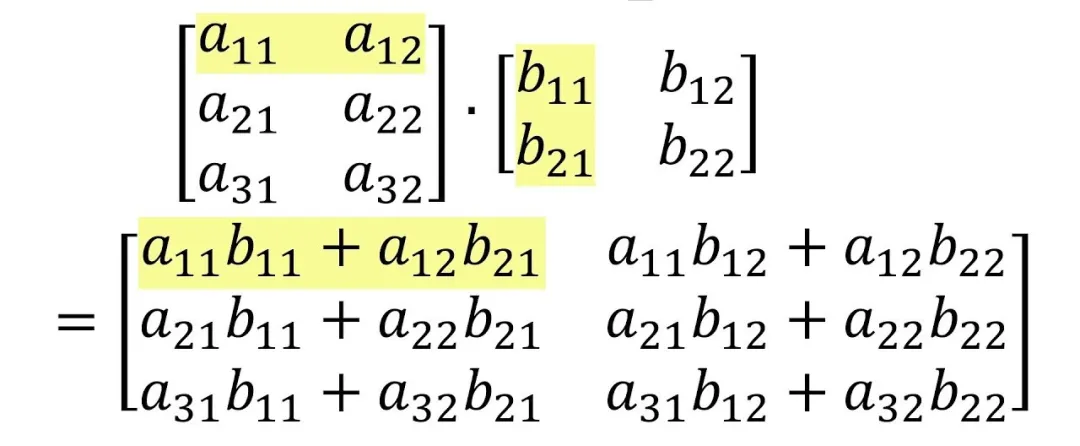
2.1.3 分块矩阵乘法
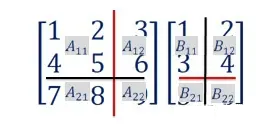
在矩阵的世界里,我们可以用水平线和垂直线划分矩阵。
分块矩阵的乘法结果怎么样?
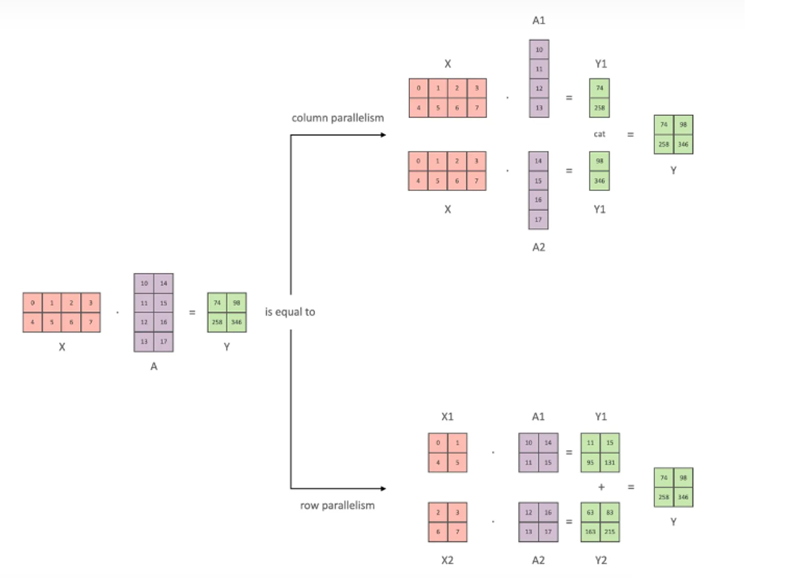
矩阵乘法有个奇特的性质:两个矩阵分块之后再做乘法,和两个矩阵直接做乘法,结果是完全一样的,这就暗示了一个思路:如果大模型中的矩阵太大装不下,可以分块以后再做计算。
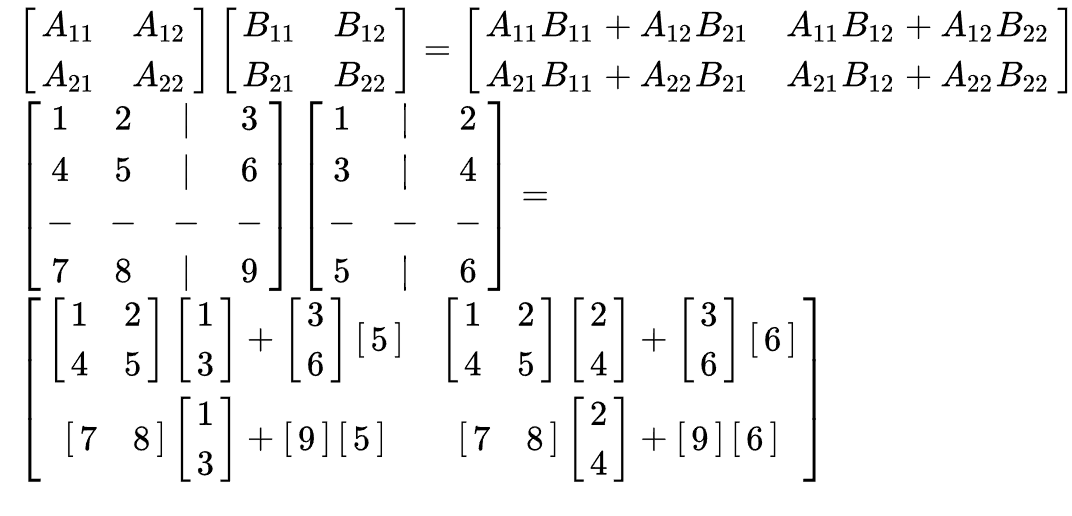
2.1.4 横向切分和纵向切分
张量并行的核心思想是,每个GPU仅处理矩阵的一部分,当算子需要整个矩阵的时候再进行矩阵聚合。无论是横向切分还是竖向切分,我们都可以将切分后的矩阵放到不同GPU上进行计算,最后将计算的结果再合并。
2.1.5 综合运用
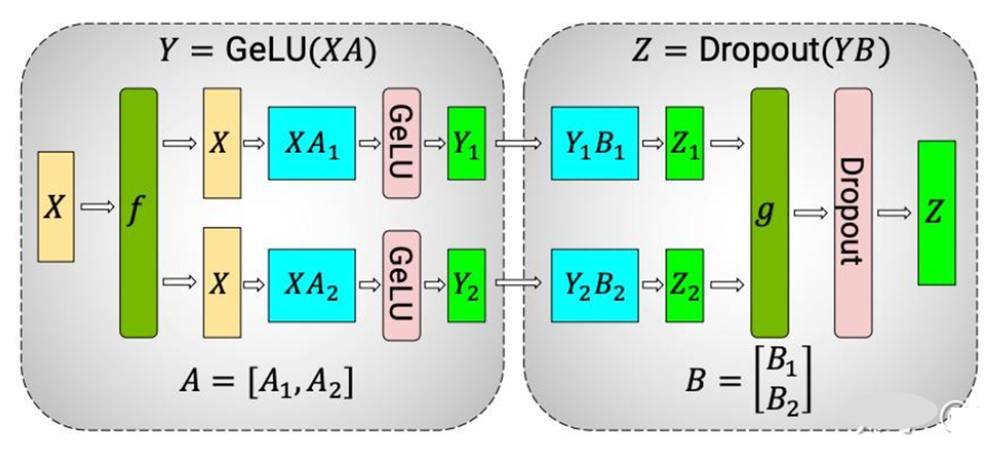
MLP层数学表达如下:Y = GeLU(XA) ,Z = Dropout(YB)
针对MLP层并行化如下图,权重A矩阵竖向着切,B矩阵横向切分,最后进行合并:
三、deepspeed
1 简介
DeepSpeed 是由微软开发的开源库,专为大规模模型训练设计。通过创新的算法和技术,DeepSpeed能够降低训练超大规模模型的复杂性和资源需求,让大模型的训练变得更快、更高效。它通过多种技术手段来加速训练,包括模型并行化、梯度累积、动态精度缩放、本地模式混合精度等。并且提供了一些辅助工具,如分布式训练管理、内存优化和模型压缩等,以帮助开发者更好地管理和优化大规模深度学习训练任务。此外,deepspeed基于pytorch构建,只需要简单修改即可迁移。DeepSpeed已经在许多大规模深度学习项目中得到了应用,包括语言模型、图像分类、目标检测等等。
2 训练时显存里面存什么?
2.1 常驻显存的参数组
训练大模型时,至少有三组数据必须常驻显存:
- 模型参数 (16位)
- 当前梯度(16位)
- 优化器状态(float32)
还有一组激活值(float32),负责在前向传播过程中,需要保存每一层的输出结果,因为在反向传播计算梯度时会用到它们。这部分占用量取决于模型结构、批次大小和序列长度。激活值的显存占用是动态的,与批次大小直接相关。批次越大,激活值占用显存越多。有一些技术可以缓解,如激活重计算(或梯度检查点),它通过牺牲计算时间(重新进行一次前向传播)来节省显存。
优化器状态根据具体使用的优化器类型,有较大的差别。
分析一下平时用的最多的adamw优化器。
2.2 adamw原理
adam之前优化器领域有两个重大改进:
- 动量。想象一个小球从山上滚下来。它不仅受当前坡度(当前梯度)的影响,还会保留之前滚动的惯性(历史梯度的加权平均),这种惯性有两个优点:一是加快收敛,在正确的方向上会越滚越快;二是减少震荡,可以帮助跳过一些局部最优点。
- 自适应学习率。想象你在崎岖不平的地形上行走。你会根据脚下地面的陡峭程度来调整步幅。在陡峭的方向(梯度大)走小步,在平缓的方向(梯度小)走大步,这种方式可以为每个参数自动调整合适的步长。
Adam 结合了两种重大改进,成为了优化器领域的“全能选手”。它为每个参数维护两个“状态”:
- 一阶动量:带有动量的梯度方向
- 二阶动量:自适应学习率的尺度
Adam 的更新步骤简化为:
-
计算梯度:像平常一样,计算当前批次数据的梯度。
-
更新一阶动量:将当前梯度和历史梯度进行加权平均,得到一个更平滑、更稳定的梯度方向。
-
更新二阶动量:将当前梯度的平方和历史平方进行加权平均,这代表了每个参数方向的梯度幅度大小。
-
偏差校正:由于初始值通常为0,在训练初期需要进行校正,避免估计偏差过大。
-
更新参数:
新参数 = 旧参数 - 学习率 * (一阶动量 / (sqrt(二阶动量) + 极小值))
这个公式的精妙之处在于:
一阶动量决定了方向(带有惯性)。学习率 / sqrt(二阶动量)决定了步长(梯度大的方向步长小,梯度小的方向步长大)
adamw为了避免自适应学习率机制扭曲权重衰减的效果,又把权重衰减与损失函数的梯度计算做了一次解耦:
新参数 = 旧参数 - 学习率 * (一阶动量 / (sqrt(二阶动量) + 极小值) + 衰减系数 * 旧参数)
Adam + L2的逻辑:告诉优化器“请在下山(优化损失)的同时,顺便帮我往原点(0)拉一下参数”。结果优化器用自适应步长来处理这个“拉”的力,导致力度不均。
AdamW的逻辑:优化器说“你专心下山(用自适应学习率优化损失),‘往原点拉’这个活儿单独处理,和自适应步长没关系,保证对每个参数都用同样标准的力气(衰减系数)”。
2.4 adamw优化器状态
根据上面的回顾,adamw优化器里至少有下面三组参数是必须存储的:
- 一阶动量(float32)
- 二阶动量(float32)
- 全精度参数(float32)
3 显存优化(ZeRO)
DeepSpeed采用了一种称为ZeRO(Zero Redundancy Optimizer)的内存优化技术。零冗余优化器(Zero Redundancy Optimizer,缩写为Zero)是一种用于大规模分布式深度学习的新型内存优化技术。ZeRO在GPU集群上以最佳系统吞吐量的三到五倍的速度训练具有1000亿个参数的深度学习模型。ZeRO作为DeepSpeed的一部分,用于提高显存效率和计算效率。
ZeRO可以克服数据并行和模型并行的局限性,同时实现两者的优点。通过在数据并行进程之间划分模型状态参数、梯度和优化器状态来消除数据并行进程中的内存冗余,而不是复制它们。在训练期间使用动态通信调度来在分布式设备之间共享必要的状态,以保持数据并行的计算粒度和通信量。
ZeRO技术优化重点是优化Model States 显存占用。在整个训练过程中, States只是会在对应算子计算时候才会被用到,optimizer states只在最终做update时才用到。数据并行中,gradients只在最后做AllReduce和updates时才用到。参数W只在做forward和backward的那一刻才用到,ZeRO技术针对以上做了以下优化,禁用所有类型的分片,仅使用 DDP (Distributed Data Parallel) ,对应下图的Baseline情况:
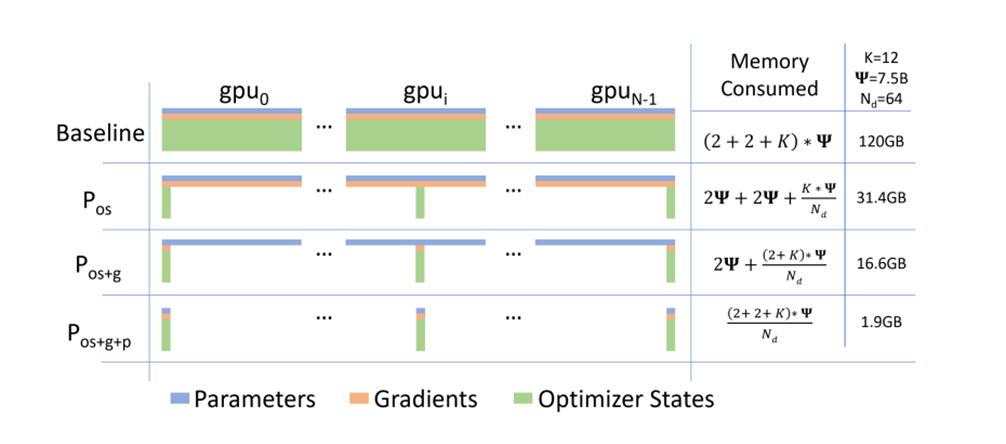
ZeRO1: 把优化器状态(optimizer states) 分片到每个数据并行的工作进程(每个GPU)下,对应图中Pos
ZeRO 2: 把优化器状态(optimizer states) + 梯度(gradients) 分片到每个数据并行的工作进程(每个GPU)下,对应图中Pos + Pg的情况;
ZeRO 3: 把优化器状态(optimizer states) + 梯度(gradients) + 模型参数(parameters) 分片到每个数据并行的工作进程(每个GPU)下,图中Pos + Pg +Pp的情况。
4 显存扩展 (offload)
ZeRO-Offload能够同时利用 CPU 和 GPU 内存来训练大型模型。核心是将优化器状态和梯度卸到CPU内存中。用户在使用带有单张英伟达 V100 GPU 的机器时,可以在不耗尽显存的情况下,运行多达 130 亿个参数的模型,模型规模扩展至现有方法的10倍,保持有竞争力的吞吐量。此功能使数十亿参数的模型训练,更加大众化。
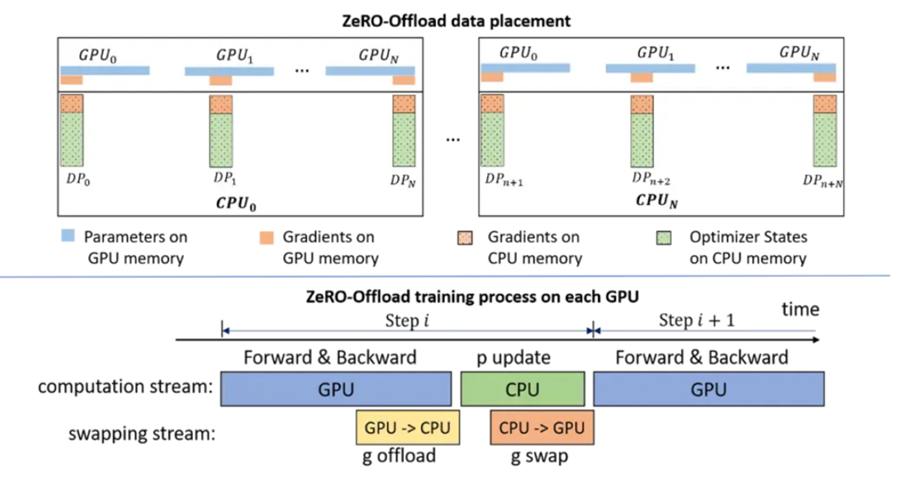
Optimizer Offload: 在Stage2的基础上,把梯度和优化器状态下沉到CPU内存或硬盘上
Param Offload: 在Stage3的基础上,把模型参数下沉到CPU内存或硬盘上
5 整体演示
🎞 此处为课程演示视频/音频,网页版未收录,请查看源资料。6 动手实践
6.1 实验环境
python3.11
CUDA12.1
absl-py==2.1.0
accelerate==1.7.0
aiofiles==24.1.0
aiohappyeyeballs==2.6.1
aiohttp==3.13.2
aiosignal==1.4.0
anaconda-anon-usage==0.4.4
annotated-doc==0.0.3
annotated-types==0.7.0
antlr4-python3-runtime==4.9.3
anyio==4.11.0
archspec==0.2.3
argon2-cffi==23.1.0
argon2-cffi-bindings==21.2.0
arrow==1.3.0
asttokens==2.4.1
async-lru==2.0.4
attrs==23.2.0
audioread==3.1.0
av==16.0.1
Babel==2.15.0
beautifulsoup4==4.12.3
bleach==6.1.0
boltons==23.0.0
Brotli==1.0.9
certifi==2024.2.2
cffi==1.16.0
charset-normalizer==2.0.4
click==8.3.0
comm==0.2.2
conda==24.3.0
conda-content-trust==0.2.0
conda-libmamba-solver==24.1.0
conda-package-handling==2.2.0
conda_package_streaming==0.9.0
contourpy==1.3.3
cryptography==42.0.5
cycler==0.12.1
datasets==3.6.0
debugpy==1.8.1
decorator==5.1.1
deepspeed==0.16.9
defusedxml==0.7.1
dill==0.3.8
distro==1.8.0
docstring_parser==0.17.0
einops==0.8.1
executing==2.0.1
fastapi==0.121.1
fastjsonschema==2.19.1
ffmpy==0.6.4
filelock==3.13.1
fire==0.7.1
fonttools==4.60.1
fqdn==1.5.1
frozenlist==1.8.0
fsspec==2025.3.0
gmpy2==2.1.2
gradio==5.31.0
gradio_client==1.10.1
groovy==0.1.2
grpcio==1.63.0
h11==0.14.0
hf-xet==1.2.0
hjson==3.1.0
httpcore==1.0.5
httpx==0.27.0
huggingface-hub==0.36.0
idna==3.4
ipykernel==6.29.4
ipython==8.24.0
isoduration==20.11.0
jedi==0.19.1
jieba==0.42.1
Jinja2==3.1.2
joblib==1.5.2
json5==0.9.25
jsonpatch==1.33
jsonpointer==2.1
jsonschema==4.22.0
jsonschema-specifications==2023.12.1
jupyter_client==8.6.1
jupyter_core==5.7.2
jupyter-events==0.10.0
jupyter-lsp==2.2.5
jupyter_server==2.14.0
jupyter_server_terminals==0.5.3
jupyterlab==4.2.0
jupyterlab-language-pack-zh-CN==4.2.post0
jupyterlab_pygments==0.3.0
jupyterlab_server==2.27.1
kiwisolver==1.4.9
lazy_loader==0.4
libmambapy==1.5.8
librosa==0.11.0
llamafactory==0.9.3
llvmlite==0.45.1
Markdown==3.6
markdown-it-py==4.0.0
MarkupSafe==2.1.3
matplotlib==3.10.7
matplotlib-inline==0.1.7
mdurl==0.1.2
menuinst==2.0.2
mistune==3.0.2
mkl-fft==1.3.8
mkl-random==1.2.4
mkl-service==2.4.0
mpmath==1.3.0
msgpack==1.1.2
multidict==6.7.0
multiprocess==0.70.16
nbclient==0.10.0
nbconvert==7.16.4
nbformat==5.10.4
nest-asyncio==1.6.0
networkx==3.1
ninja==1.13.0
nltk==3.9.2
notebook_shim==0.2.4
numba==0.62.1
numpy==1.26.3
nvidia-ml-py==13.580.82
omegaconf==2.3.0
orjson==3.11.4
overrides==7.7.0
packaging==23.2
pandas==2.3.3
pandocfilters==1.5.1
parso==0.8.4
peft==0.15.2
pexpect==4.9.0
Pillow==10.0.1
pip==23.3.1
platformdirs==3.10.0
pluggy==1.0.0
pooch==1.8.2
prometheus_client==0.20.0
prompt-toolkit==3.0.43
propcache==0.4.1
protobuf==5.26.1
psutil==5.9.8
ptyprocess==0.7.0
pure-eval==0.2.2
py-cpuinfo==9.0.0
pyarrow==22.0.0
pycosat==0.6.6
pycparser==2.21
pydantic==2.10.6
pydantic_core==2.27.2
pydub==0.25.1
Pygments==2.18.0
pyparsing==3.2.5
PySocks==1.7.1
python-dateutil==2.9.0.post0
python-json-logger==2.0.7
python-multipart==0.0.20
pytz==2025.2
PyYAML==6.0.1
pyzmq==26.0.3
referencing==0.35.1
regex==2025.11.3
requests==2.32.5
rfc3339-validator==0.1.4
rfc3986-validator==0.1.1
rich==14.2.0
rouge-chinese==1.0.3
rpds-py==0.18.1
ruamel.yaml==0.17.21
ruff==0.14.4
safehttpx==0.1.7
safetensors==0.6.2
scikit-learn==1.7.2
scipy==1.16.3
semantic-version==2.10.0
Send2Trash==1.8.3
sentencepiece==0.2.1
setuptools==68.2.2
shellingham==1.5.4
shtab==1.7.2
six==1.16.0
sniffio==1.3.1
soundfile==0.13.1
soupsieve==2.5
soxr==1.0.0
sse-starlette==3.0.3
stack-data==0.6.3
starlette==0.49.3
sympy==1.13.1
tensorboard==2.16.2
tensorboard-data-server==0.7.2
termcolor==3.2.0
terminado==0.18.1
threadpoolctl==3.6.0
tiktoken==0.12.0
tinycss2==1.3.0
tokenizers==0.21.1
tomlkit==0.13.3
torch==2.5.1
torchaudio==2.5.1
torchvision==0.20.1
tornado==6.4
tqdm==4.67.1
traitlets==5.14.3
transformers==4.52.4
triton==3.1.0
trl==0.9.6
truststore==0.8.0
typer==0.20.0
types-python-dateutil==2.9.0.20240316
typing_extensions==4.15.0
typing-inspection==0.4.2
tyro==0.8.14
tzdata==2025.2
uri-template==1.3.0
urllib3==2.1.0
uvicorn==0.38.0
wcwidth==0.2.13
webcolors==1.13
webencodings==0.5.1
websocket-client==1.8.0
websockets==15.0.1
Werkzeug==3.0.3
wheel==0.41.2
xxhash==3.6.0
yarl==1.22.0
zstandard==0.19.0
6.2 实验任务
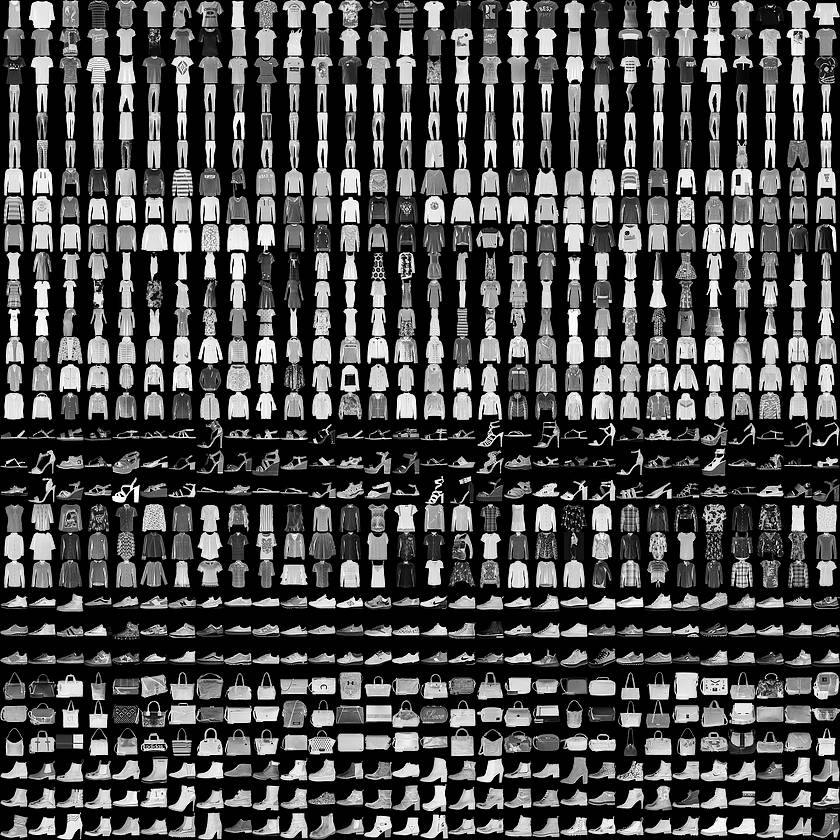
Fashion-MNIST是由 Zalando 研究团队发布的70,000 张 28×28 灰度图像数据集,含10 类时尚单品,划分为6 万训练集 +1 万测试集,旨在替代经典 MNIST 作为深度学习图像分类的基准。
10 个类别标签(索引 0-9)
- T-shirt/top(T 恤/上衣)
- Trouser(裤子)
- Pullover(套头衫)
- Dress(连衣裙)
- Coat(外套)
- Sandal(凉鞋)
- Shirt(衬衫)
- Sneaker(运动鞋)
- Bag(包)
- Ankle boot(短靴)
6.3 实验代码
deepspeed配置文件
{
    "train_batch_size": 128,
    "gradient_accumulation_steps": 1,
    "optimizer": {
        "type": "Adam",
        "params": {
            "lr": 0.00015
        }
    },
    "zero_optimization": {
        "stage": 2
    }
}
训练代码
import torch
import numpy as np
import argparse
import torch
import torchvision
import deepspeed

# 命令行参数:deepspeed ds_train.py --epoch 5 --deepspeed --deepspeed_config ds_config.json
parser = argparse.ArgumentParser()
parser.add_argument("--local_rank", type=int, default=1, help="local rank passed from distributed launcher")
parser.add_argument("--epoch", type=int, default=1, help="epoch")
parser = deepspeed.add_config_arguments(parser)
cmd_args = parser.parse_args()  # deepspeed命令行参数

class FashionModel(torch.nn.Module):
    def __init__(self):
        super().__init__()
        self.seq = torch.nn.Sequential(
            torch.nn.Linear(in_features=784, out_features=300),
            torch.nn.ReLU(),
            torch.nn.Linear(in_features=300, out_features=10)
        )

    def forward(self, batch_x):
        return self.seq(batch_x)

def img_transform(img):
    img = np.asarray(img) / 255
    return torch.tensor(img, dtype=torch.float32).flatten()


dataset = torchvision.datasets.FashionMNIST(root='./dataset', download=True, transform=img_transform)  # 数据集
dataloader = torch.utils.data.DataLoader(dataset, batch_size=32, num_workers=2, shuffle=True)  # 数据加载器,batch_size应该等于train_batch_size/gpu数量

model = FashionModel()  # 自定义的模型
model, _, _, _ = deepspeed.initialize(args=cmd_args, model=model, model_parameters=model.parameters())  # deepspeed分布式模型
loss_fn = torch.nn.CrossEntropyLoss()

for epoch in range(cmd_args.epoch):
    for x, y in dataloader:
        x = x.cuda()
        y = y.cuda()
        output = model(x)
        loss = loss_fn(output, y)
        model.backward(loss)  # 走deepspeed风格的backward
        model.step()
    print("epoch {} done...".format(epoch))
    model.save_checkpoint('./checkpoints')
6.4 操作步骤
进入deepspeed文件夹
执行指令:
deepspeed train.py --epoch 1000 --deepspeed --deepspeed_config ds.json
观察多张显卡的状态
watch -n 1 nvidia-smi
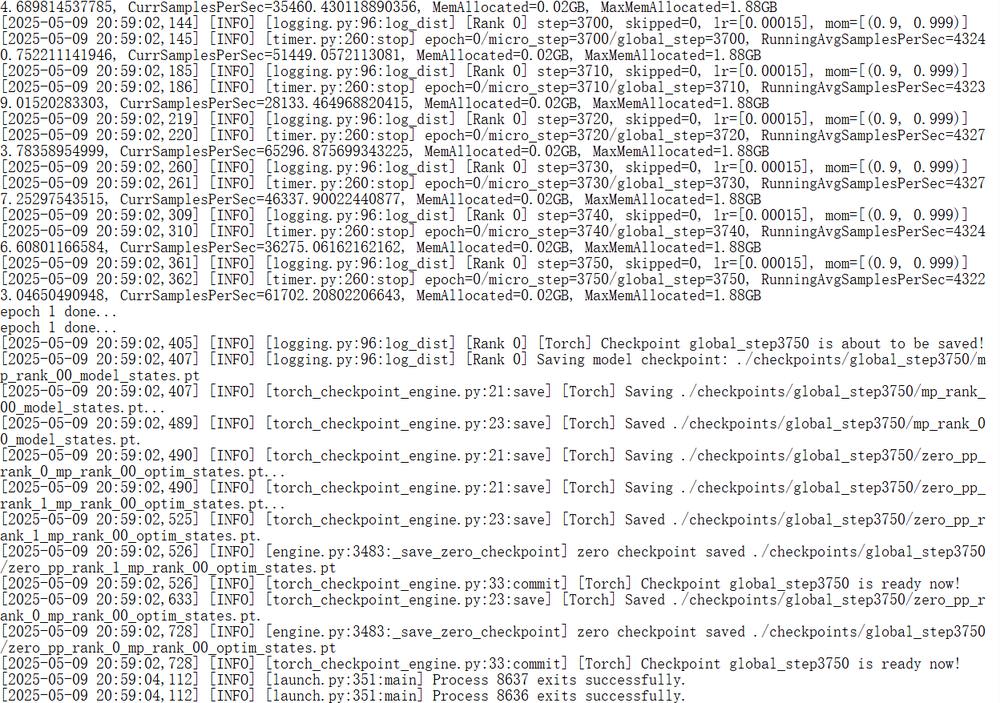
6.5 试验结果
7 参考资料
并行与量化实操
一、LLaMA-Factory的使用方式
使用LLaMA-Factory有两种主要方式:webui和命令行
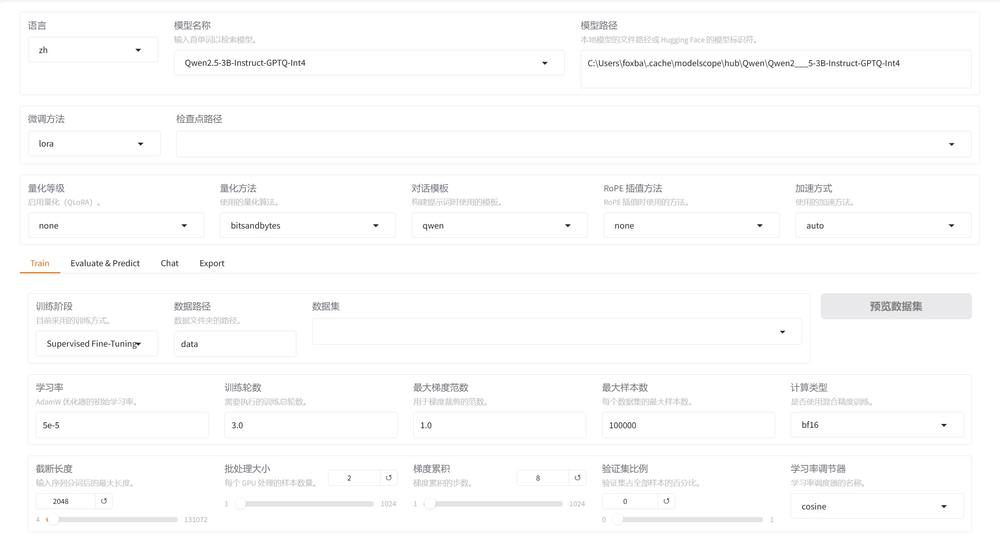
1 webui
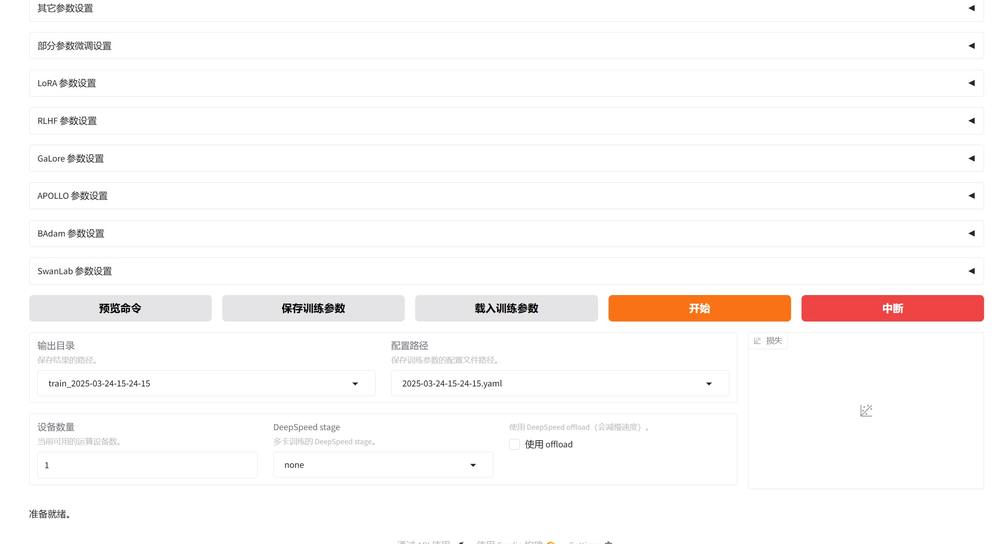
这种方式一般用于熟悉工具,试验性训练
在Anaconda Prompt中输入以下命令
conda activate llamafactory-3.11
llamafactory-cli webui
本地操作系统,启动后在浏览器上输入 http://localhost:7860,进入webui页面
2 命令行
命令行是大规模训练的主要方式,原生的命令行是这样的:
llamafactory-cli train \
--stage sft \
--do_train True \
--model_name_or_path /workspace/deepseekDistllation/models/Qwen/Qwen2.5-3B-Instruct-GPTQ-Int4 \
--preprocessing_num_workers 16 \
--finetuning_type lora \
--template qwen \
--flash_attn auto \
--dataset_dir /workspace/deepseekDistllation/data/chatData \
--dataset chat-train \
--cutoff_len 6000 \
--learning_rate 0.0001 \
--num_train_epochs 1.0 \
--max_samples 100000 \
--per_device_train_batch_size 2 \
--gradient_accumulation_steps 2 \
--lr_scheduler_type cosine \
--max_grad_norm 1.0 \
--logging_steps 5 \
--save_steps 100 \
--warmup_steps 10 \
--packing False \
--report_to none \
--output_dir /workspace/deepseekDistllation/models/lora/Qwen2.5-3B-instruct-GPTQ-Int4/train_2025-04-22-07-55-05 \
--bf16 True \
--plot_loss True \
--trust_remote_code True \
--ddp_timeout 180000000 \
--include_num_input_tokens_seen True \
--optim adamw_torch \
--quantization_bit 4 \
--quantization_method bitsandbytes \
--double_quantization True \
--lora_rank 16 \
--lora_alpha 16 \
--lora_dropout 0 \
--lora_target all
3 带配置文件的命令行
上面使用命令行的方式太麻烦,实际工作中一般使用这种方式:
llamafactory-cli train lfconfig.yaml
配合上对应的配置文件
bf16: true
cutoff_len: 6000
dataset: chat-train
dataset_dir: C:\tools\eclipse-python\workspace\learnDistillation\data\chatData
ddp_timeout: 180000000
do_train: true
double_quantization: true
finetuning_type: lora
flash_attn: auto
gradient_accumulation_steps: 4
include_num_input_tokens_seen: true
learning_rate: 5.0e-05
logging_steps: 5
lora_alpha: 16
lora_dropout: 0
lora_rank: 8
lora_target: all
lr_scheduler_type: cosine
max_grad_norm: 1.0
max_samples: 100000
model_name_or_path: C:\Users\foxba\.cache\modelscope\hub\Qwen\Qwen2___5-3B-Instruct-GPTQ-Int4
num_train_epochs: 1.0
optim: adamw_torch
output_dir: saves\Qwen2.5-3B-Instruct-GPTQ-Int4\lora\train_2025-03-20-20-41-50
packing: false
per_device_train_batch_size: 2
plot_loss: true
preprocessing_num_workers: 16
quantization_bit: 4
quantization_method: bitsandbytes
report_to: none
save_steps: 100
stage: sft
template: qwen
trust_remote_code: true
warmup_steps: 10
也可以整理成这样比较规范的形式:
### model
model_name_or_path: /gemini/code/Qwen2-1.5B
trust_remote_code: true  # 必须开启

### method
stage: sft
do_train: true
finetuning_type: full
deepspeed: /gemini/code/full/ds_z3_config.json

### dataset
dataset_dir: /gemini/code/dataset
dataset: qwen_dataset
template: qwen
cutoff_len: 1024
overwrite_cache: true
preprocessing_num_workers: 16

### output
output_dir: saves/full
logging_steps: 10
save_steps: 100
plot_loss: true
overwrite_output_dir: true

### train
per_device_train_batch_size: 1
gradient_accumulation_steps: 16
learning_rate: 1.0e-5
num_train_epochs: 1.0
lr_scheduler_type: cosine
warmup_ratio: 0.1
bf16: true
ddp_timeout: 180000000

### eval
val_size: 0.1
per_device_eval_batch_size: 1
eval_strategy: steps
eval_steps: 500
二、deepspeed的配置文件
1 训练基础配置
| 参数名 | 重要性 | 说明与可选值 | 配置建议 |
|---|---|---|---|
train_batch_size |
★★★★★ | 全局有效批次大小。Deepspeed 会自动根据 gradient_accumulation_steps 和 GPU 数量计算每个 GPU 的微批次大小。 |
设置你希望在整个训练过程中使用的总 batch size。 |
train_micro_batch_size_per_gpu |
★★★★☆ | 每个 GPU 一次前向/后向计算处理的样本数(微批次大小)。 | 直接指定此值可更精确控制。注意:必须满足 train_batch_size = micro_batch_size * gradient_accumulation * GPU数量。 |
gradient_accumulation_steps |
★★★★☆ | 梯度累积步数。每累积这么多步的梯度,才进行一次权重更新。 | 用于在 GPU 显存不足时模拟更大的批次大小。通常与 train_micro_batch_size_per_gpu 配合使用。 |
gradient_clipping |
★★★☆☆ | 梯度裁剪。防止梯度爆炸。 | 通常设置为 1.0。如果训练不稳定(loss 出现 NaN),可以启用并调整该值。 |
2 优化器
| 参数名 | 重要性 | 说明与可选值 | 配置建议 |
|---|---|---|---|
optimizer |
★★★★★ | 配置训练使用的优化器。 | 必须与你在代码中使用的优化器类型匹配(如 Adam、AdamW)。这是启用 ZeRO 优化的基础。 |
scheduler |
★★★★☆ | 配置学习率调度器。 | 必须与你在代码中使用的调度器匹配(如 WarmupLR、CosineAnnealingLR)。Deepspeed 接管后能更高效地调度。 |
3 ZeRO优化配置
| 参数名 | 重要性 | 说明与可选值 | 配置建议 |
|---|---|---|---|
zero_optimization |
★★★★★ | ZeRO 优化的总开关和核心配置。 | 这是 DeepSpeed 最核心的功能,用于大幅减少模型状态的显存占用。 |
zero_optimization.stage |
★★★★★ | ZeRO 优化阶段。 | - 0:禁用 ZeRO。 - 1:优化器状态分片。 - 2:梯度 + 优化器状态分片。 - 3:参数、梯度、优化器状态全分片。 阶段越高,显存节省越多,但通信开销可能增加。Stage 2 是最常用的折中方案。 |
zero_optimization.offload_optimizer |
★★★★☆ | 将优化器状态和计算卸载到 CPU。 | 可以进一步节省 GPU 显存。在 GPU 显存非常紧张时使用,但会降低训练速度。 |
zero_optimization.offload_param |
★★★★☆ | 将模型参数卸载到 CPU。 | 与 offload_optimizer 结合(通常在 Stage 3 下)可以节省大量显存,用于训练极大模型,但速度下降明显。 |
zero_optimization.allgather_bucket_size |
★★☆☆☆ | AllGather 通信操作的桶大小。 | 高级参数。调整通信效率,通常使用默认值即可。 |
zero_optimization.reduce_bucket_size |
★★☆☆☆ | Reduce-Scatter 通信操作的桶大小。 | 高级参数。调整通信效率,通常使用默认值即可。 |
4 激活检查点
| 参数名 | 重要性 | 说明与可选值 | 配置建议 |
|---|---|---|---|
activation_checkpointing |
★★★★☆ | 激活检查点(梯度检查点)配置。 | 通过牺牲计算时间(重新计算前向传播)来节省存储中间激活结果的显存。对于大模型几乎是必选项。 |
activation_checkpointing.partition_activations |
★★★☆☆ | 是否对激活进行分片。 | 在 ZeRO Stage 3 下建议启用(true),可以进一步节省显存。 |
activation_checkpointing.contiguous_memory_optimization |
★★☆☆☆ | 连续内存优化。 | 默认为 false。启用后可能节省更多显存,但可能不稳定。 |
5 混合精度训练
| 参数名 | 重要性 | 说明与可选值 | 配置建议 |
|---|---|---|---|
fp16 |
★★★★☆ | 启用 FP16 混合精度训练。 | 可大幅减少显存占用并提升训练速度。是现代深度学习训练的标配。 |
fp16.enabled |
★★★★☆ | 是否启用 FP16。 | 设为 true 来启用。 |
fp16.loss_scale |
★★★☆☆ | 损失缩放。解决 FP16 下梯度下溢问题。 | - 0:动态损失缩放。 - 一个数值(如 128, 1024):静态损失缩放。 通常使用动态损失缩放(0)更省心。 |
bf16 |
★★★★☆ | 启用 BF16 混合精度训练。 | BF16 比 FP16 具有更宽的动态范围,训练更稳定,但精度略低。在 Ampere 架构及以后的 GPU(如 A100, 3090, 4090)上支持良好。fp16 和 bf16 通常只启用一个,优先尝试 bf16(如果硬件支持)。 |
bf16.enabled |
★★★★☆ | 是否启用 BF16。 | 设为 true 来启用。 |
6 典型配置文件
{
  // 全局训练批次大小(自动计算为:micro_batch * gpu_num * gradient_accumulation)
  "train_batch_size": "auto",

  // 单GPU的微批次大小(根据显存自动调整)
  "train_micro_batch_size_per_gpu": "auto",

  // 梯度累积步数(自动匹配micro_batch配置)
  "gradient_accumulation_steps": "auto",

  // 梯度裁剪阈值(自动、禁用或设置默认1.0)
  "gradient_clipping": "auto",

  // 允许未经官方测试的优化器(需谨慎开启)
  "zero_allow_untested_optimizer": true,

  // FP16混合精度配置
  "fp16": {
    "enabled": "auto",        // 自动根据硬件兼容性启用
    "loss_scale": 0,          // 动态损失缩放(0表示自动调整)
    "loss_scale_window": 1000,// 缩放调整窗口大小(1000次迭代)
    "initial_scale_power": 16,// 初始缩放比例2^16
    "hysteresis": 2,          // 缩放容差(防止频繁调整)
    "min_loss_scale": 1       // 最小缩放比例
  },

  // BF16混合精度配置(与FP16二选一)
  "bf16": {
    "enabled": "auto"         // 在支持BF16的GPU上自动启用
  },

  // ZeRO优化策略(Stage3完整配置)
  "zero_optimization": {
    "stage": 3,               // 最高优化等级(参数/梯度/优化器状态分片)

    // 优化器状态卸载到CPU
    "offload_optimizer": {
      "device": "cpu",        // 卸载到CPU内存
      "pin_memory": true      // 使用锁页内存加速传输
    },

    // 模型参数卸载到CPU
    "offload_param": {
      "device": "cpu",        // 参数存储到CPU内存
      "pin_memory": true      // 使用DMA加速数据传输
    },

    "overlap_comm": false,    // 禁用通信计算重叠(提升稳定性)
    "contiguous_gradients": true, // 保持梯度内存连续(优化显存)

    // 参数分组配置
    "sub_group_size": 1e9,    // 单参数组最大尺寸(默认1B防止分组)

    // 通信缓冲区自动调整
    "reduce_bucket_size": "auto",      // AllReduce缓冲区大小
    "stage3_prefetch_bucket_size": "auto", // 参数预取缓冲区

    // 参数持久化阈值
    "stage3_param_persistence_threshold": "auto", // 参数驻留GPU的阈值

    "stage3_max_live_parameters": 1e9, // 最大驻留参数数量
    "stage3_max_reuse_distance": 1e9, // 参数重用距离阈值

    // 模型保存时收集16位权重
    "stage3_gather_16bit_weights_on_model_save": true
  }
}
三、使用deepspeed进行全参数训练
1 训练语料
本次训练使用问答对,整理成alpaka格式。
[
  {
    "instruction": "请提取以下内容中的摘要信息",
    "input": "保持身体健康的五个方法:\n\n1. 每天至少饮用8杯水,促进新陈代谢\n2. 每周进行150分钟中等强度运动,如快走或游泳\n3. 保证7-9小时高质量睡眠,避免熬夜\n4. 饮食中增加蔬菜水果比例,减少油炸食品\n5. 定期体检,监测血压、血糖等指标",
    "output": "多喝水、规律运动、充足睡眠、均衡饮食、定期体检"
  },
  {
    "instruction": "请提取以下内容中的摘要信息",
    "input": "提高学习效率的三个技巧:\n\n1. 使用番茄工作法,每25分钟专注后休息5分钟\n2. 建立思维导图整理知识框架\n3. 睡前复习重点内容加强记忆",
    "output": "番茄工作法、思维导图、睡前复习"
  },
  {
    "instruction": "请提取以下内容中的摘要信息",
    "input": "旅行必备物品清单:\n1. 护照/身份证原件及复印件\n2. 便携充电宝和转换插头\n3. 常用药品(退烧药、创可贴)\n4. 轻便折叠雨伞\n5. 分装洗漱用品",
    "output": "证件、充电设备、药品、雨具、洗漱包"
  },
  {
    "instruction": "请提取以下内容中的摘要信息",
    "input": "职场沟通四大原则:\n① 明确沟通目标\n② 使用金字塔表达结构\n③ 注意非语言信号(眼神/姿态)\n④ 及时确认信息理解度",
    "output": "目标明确、结构化表达、非语言交流、信息确认"
  },
  ]
别忘了配置dataset_info.json
"qwen_dataset": {
    "file_name": "qwen_dataset.json"
  },
2 deepspeed配置文件
{
  "train_batch_size": "auto",
  "train_micro_batch_size_per_gpu": "auto",
  "gradient_accumulation_steps": "auto",
  "gradient_clipping": "auto",
  "zero_allow_untested_optimizer": true,
  "fp16": {
    "enabled": "auto",
    "loss_scale": 0,
    "loss_scale_window": 1000,
    "initial_scale_power": 16,
    "hysteresis": 2,
    "min_loss_scale": 1
  },
  "bf16": {
    "enabled": "auto"
  },
  "zero_optimization": {
    "stage": 3,
    "overlap_comm": true,
    "contiguous_gradients": true,
    "sub_group_size": 1e9,
    "reduce_bucket_size": "auto",
    "stage3_prefetch_bucket_size": "auto",
    "stage3_param_persistence_threshold": "auto",
    "stage3_max_live_parameters": 1e9,
    "stage3_max_reuse_distance": 1e9,
    "stage3_gather_16bit_weights_on_model_save": true
  }
}
3 LLaMA-Factory配置文件
### model
model_name_or_path: /gemini/code/Qwen2-1.5B
trust_remote_code: true  # 必须开启

### method
stage: sft
do_train: true
finetuning_type: full
deepspeed: /gemini/code/full/ds_z3_config.json

### dataset
dataset_dir: /gemini/code/dataset
dataset: qwen_dataset
template: qwen
cutoff_len: 1024
overwrite_cache: true
preprocessing_num_workers: 16

### output
output_dir: saves/full
logging_steps: 10
save_steps: 100
plot_loss: true
overwrite_output_dir: true

### train
per_device_train_batch_size: 1
gradient_accumulation_steps: 16
learning_rate: 1.0e-5
num_train_epochs: 5.0
lr_scheduler_type: cosine
warmup_ratio: 0.1
bf16: true
ddp_timeout: 180000000

### eval
val_size: 0.1
per_device_eval_batch_size: 1
eval_strategy: steps
eval_steps: 500
4 启动命令
FORCE_TORCHRUN=1 llamafactory-cli train full-sft.yaml
强制使用torchrun进行分布式训练初始化(适用于多GPU/TPU环境)
环境变量说明:
FORCE_TORCHRUN=1 : 强制使用PyTorch的torchrun命令来启动分布式训练(当自动检测失败或需要显式控制分布式训练时使用,需确保已正确安装torch>=1.8.0)
执行LLaMA Factory训练流程
命令结构:
llamafactory-cli : 主程序入口(基于Python Fire的CLI工具)
train : 子命令,指定执行训练任务
full-sft.yaml : 训练配置文件路径(包含模型/数据/训练参数)
5 实验和观察
启动训练后,等待程序加载模型、加载和转化语料格式,并开始训练。
在另一个命令行窗口启动命令观察显卡状态
linux:watch -n 1 nvidia-smi
windows:nvidia-smi -l 1
四、使用LLaMA-Factory进行模型训练、合并和量化
1 全精度LoRA微调
1.1 LLaMA-Factory配置文件
### model
model_name_or_path: C:\Users\foxba\.cache\modelscope\hub\models\Qwen\Qwen2___5-1___5B-Instruct

### method
stage: sft
do_train: true
finetuning_type: lora
lora_target: all
lora_rank: 16
lora_alpha: 16
lora_dropout: 0.05

### dataset
dataset_dir: ..\dataset
dataset: qwen_dataset
template: qwen
cutoff_len: 1024
overwrite_cache: true
preprocessing_num_workers: 16

### output
output_dir: lora
logging_steps: 100
save_steps: 100
plot_loss: true
overwrite_output_dir: true

### train
per_device_train_batch_size: 1
gradient_accumulation_steps: 16
learning_rate: 1.0e-4
num_train_epochs: 1.0
lr_scheduler_type: cosine
warmup_ratio: 0.1
bf16: true
ddp_timeout: 180000000

### eval
val_size: 0.1
per_device_eval_batch_size: 1
eval_strategy: steps
eval_steps: 500
1.2 启动命令
llamafactory-cli train lora-sft.yaml
2 基座与LoRA合并
2.1 LLaMA-Factory配置文件
### Note: DO NOT use quantized model or quantization_bit when merging lora adapters

### model
model_name_or_path: C:\Users\foxba\.cache\modelscope\hub\models\Qwen\Qwen2___5-1___5B-Instruct
adapter_name_or_path: lora
template: qwen
finetuning_type: lora

### export
export_dir: merged
export_size: 2
export_device: cpu
export_legacy_format: false
2.2 启动命令
llamafactory-cli export merge.yaml
3 使用GPTQ合并量化后的模型
3.1 LLaMA-Factory配置文件
### model
model_name_or_path: merged
trust_remote_code: true

### dataset
dataset: ..\dataset\qwen_dataset.json
template: qwen
cutoff_len: 1024
max_samples: 1000
overwrite_cache: true
preprocessing_num_workers: 16

### output
export_dir: gptq
3.2 启动命令
llamafactory-cli export gptq.yaml
五、使用LLaMA-Factory进行QLoRA训练
1 进行QLoRA微调
1.1 LLaMA-Factory配置文件
### model
model_name_or_path: C:\Users\foxba\.cache\modelscope\hub\models\Qwen\Qwen2___5-1___5B-Instruct-GPTQ-Int4

### method
stage: sft
do_train: true
finetuning_type: lora
lora_target: all
quantization_bit: 4
quantization_method: bitsandbytes  # choices: [bitsandbytes (4/8), hqq (2/3/4/5/6/8), eetq (8)]
lora_rank: 16
lora_alpha: 16
lora_dropout: 0.05

### dataset
dataset_dir: ..\dataset
dataset: qwen_dataset
template: qwen
cutoff_len: 1024
overwrite_cache: true
preprocessing_num_workers: 16

### output
output_dir: qlora
logging_steps: 100
save_steps: 100
plot_loss: true
overwrite_output_dir: true

### train
per_device_train_batch_size: 1
gradient_accumulation_steps: 16
learning_rate: 1.0e-4
num_train_epochs: 1.0
lr_scheduler_type: cosine
warmup_ratio: 0.1
bf16: true
ddp_timeout: 180000000

### eval
val_size: 0.1
per_device_eval_batch_size: 1
eval_strategy: steps
eval_steps: 500
1.2 启动命令
llamafactory-cli train qlora-sft.yaml
DeepSpeed 训练代码
3 个文件📁 deepspeed/
- ⚙️ ds.json 240B 下载
- 📄 train.py 1.8KB 下载
- 📄 requirements.txt 4.0KB 下载
LlamaFactory 训练配置(yaml)
10 个文件📁 full fine-tuning/
- ⚙️ ds_z3_config.json 787B 下载
- 📄 full-sft.yaml 765B 下载
📁 lora/
- 📄 gptq.yaml 261B 下载
- 📄 gptq1.yaml 276B 下载
- 📄 lora-sft.yaml 767B 下载
- 📄 merge.yaml 346B 下载
📁 qlora/
- 📄 qlora-sft.yaml 894B 下载
- 📄 requirements.txt 4.0KB 下载
联合任务代码
16 个文件📁 data/
📁 电商分类语料/
- 📄 dev.txt 98.7KB 下载
- 📄 dev2.txt 51.4KB 下载
- 📄 dev3.txt 43.5KB 下载
- 📄 dev4.txt 22.1KB 下载
- 📄 train.txt 9.6KB 下载
- 📄 train2.txt 57.5KB 下载
- 📄 train3.txt 33.9KB 下载
- 📄 train4.txt 21.8KB 下载
- 📄 01_testLlamaFactory.py 2.4KB 下载
- 📄 02_testVllm.py 2.5KB 下载