第 4 节 / 共 5 节
模型量化与部署
量化讲义
一、为什么要做量化?
量化就是将大语言模型的权重从高精度数据类型(FP32)转化为低精度(INT4)数据类型的过程。模型量化的根本目标是:在尽可能保持模型性能的前提下,显著降低模型对计算资源(显存、算力)和能耗的需求
1 减小显存占用
这是最直接、最重要的原因。现代大模型动辄拥有数十亿甚至上万亿参数。如果每个参数都用全精度(FP32,32位,4字节)存储,一个100亿参数的模型就需要大约 40GB 的存储空间。这已经超过了大多数消费级显卡的显存容量,更不用说在手机、嵌入式设备上运行了。
量化能够大幅度压缩显存占用,同样的Llama-13B模型,在使用不同精度的数据表示,占用显存的量有非常大的差异:
| 数据精度 | 占用显存 |
|---|---|
| FP32 | 52G |
| FP16 | 26G |
| INT8 | 13G |
| INT4 | 6.5G |
2 提升推理速度
这是用户体验和许多实时应用的关键。
大模型的推理延迟可能很高,无法满足实时交互(如语音助手、实时翻译)或高并发场景的需求。
量化能够加快推理,主要体现在:
- 更快的并行计算:低精度格式比高精度格式占用更少的比特,同样硬件资源下,可以并行处理更多数据,从而提升吞吐量。同样是A100显卡,在不同精度下,会有很大的算力差异
| 数据精度 | 算力 |
|---|---|
| FP32 | 156 TFLOPS |
| FP16 | 312 TFLOPS |
| INT8 | 624 TFLOPS |
- 减少数据交换开销:计算过程中Tesnsor Cores和显存之间存在频繁的数据交换,低精度数据可以减少这种数据交换的开销。
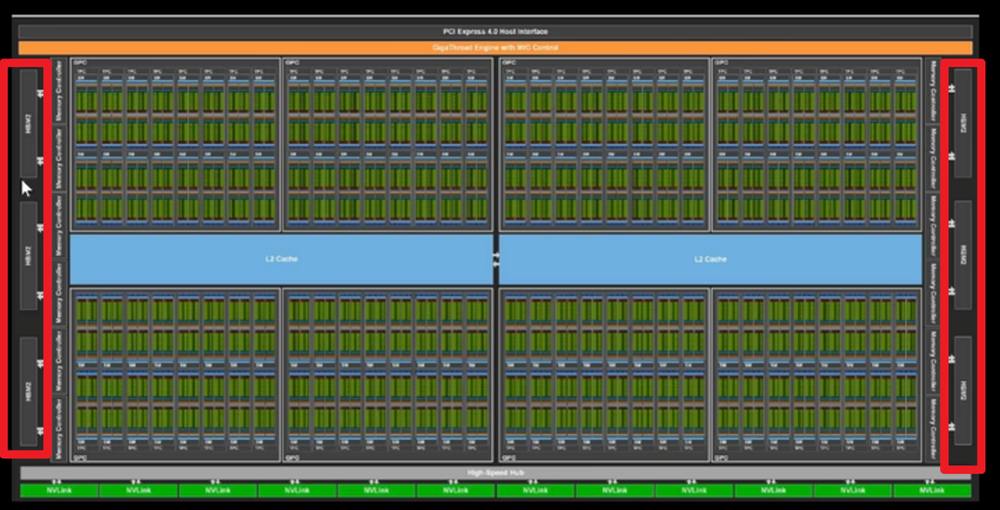
- 硬件加速:专业处理器(GPU,TPU,NPU)等针对低精度数据做了设计优化,能够在单次操作中执行更多的数学计算,例如:Nvidia TensorTR和Intel Neural Compressor支持更高效的INT4,INT8推理;Tensor Cores针对FP16和INT8运算进行了优化,能够更好地支持INT8和FP16矩阵运算。
2. 降低功耗和能耗
这对于电池供电的设备和大型数据中心至关重要。
浮点运算(尤其是FP32/FP16)比整数运算(INT8/INT4)需要更复杂的硬件电路,消耗更多的能量。移动设备上的持续高功耗会迅速耗尽电量;数据中心的巨大算力消耗着天文数字级的电力。
量化后的模型主要使用低精度的整数运算,这些运算:
- 硬件友好:在相同的芯片面积上可以集成更多的整数计算单元。
- 能效更高:完成一次整数运算所需的能量远低于一次浮点运算。
二、参数的精度
1 理论与工程的差异
理论上数据可以是无限的
- 无限的长度(直线)
- 无限的精度(科幻小说)
- 绝对的圆
- 真空中的球形鸡
- ......
但在工程中不能这样做,工程中的数据必须是能够实际表达、生产和使用,所以必须规定两个基本量:数据的边界和精度。
2 计算机中表达数值的方式
计算机由数以亿计的微型开关(晶体管)构成,这些开关只有两种状态:开 或 关,用 1 或 0 表示。这一个“位”是信息的最小单位。
- 位:1 或 0
- 字节:由 8 个位组成,是计算机处理数据的基本单位。
所以,计算机表现数字的本质,就是用一串 0 和 1 的组合 来对应我们熟悉的十进制数字。
2.1 正整数(无符号整数)的表示
这是最简单的情况,直接使用二进制计数法。
- 规则:从右向左,每一位代表 2 的 n 次方(n从0开始)。
- 示例:一个字节(8位)可以表示 0 到 255 的数字。
| 十进制 | 二进制(8位) |
|---|---|
| 0 | 0000 0000 |
| 1 | 0000 0001 |
| 2 | 0000 0010 |
| 3 | 0000 0011 |
| 10 | 0000 1010 |
| 255 | 1111 1111 |
局限:它无法表示负数。
2.2 负整数(有符号整数)的表示
为了表示负数,计算机科学家们想出了几种方法,最常用的是 补码。
- 原码:最高位作为符号位(0正1负),其余位表示数值。
- 例如
+1是0000 0001,-1是1000 0001。 - 问题:存在
+0(0000 0000) 和-0(1000 0000),导致运算复杂。 - 反码:正数的反码是其本身,负数的反码是将其原码的符号位不变,其余位取反。
- 例如
-1的反码是1111 1110。 - 问题:同样存在
+0和-0的问题。 - 补码(现代计算机标准):
1. 正数的补码就是其本身。
2. 负数的补码 = 其原码符号位不变,其余位取反,然后整体 + 1。
3. 示例:求-1的补码(8位下)+1的原码:0000 0001- 取反(得到反码):
1111 1110 - +1:
1111 1111→ 这就是-1在计算机中的最终形式。
补码的优势:
- 没有 +0 和 -0 的歧义:
0000 0000是 0,1000 0000被用来表示 -128。 - 减法可以变加法:A - B 可以计算为 A + (-B的补码)。这极大简化了CPU中算术逻辑单元的设计
2.3 小数(浮点数)的表示
小数(如 3.14, -0.001, 6.02e23)是用 浮点数 表示的,类似于科学计数法。
目前通用标准是 IEEE 754,它主要将数字分为三部分(以32位单精度浮点数为例):
[符号位 S] [指数位 E] [尾数位 M]
- 符号位:1位,0代表正,1代表负。
- 指数位:8位,表示的是 2的指数。为了能表示负指数(如 0.5 = 2⁻¹),这里采用了一个 偏移量(127)。所以实际指数 = E - 127。
- 尾数位:23位,表示有效数字。它隐含了一个开头的“1.”(规范化表示)。
示例:表示 0.15625
- 转换为二进制科学计数法:
- 0.15625 (十进制) = 0.00101 (二进制) = 1.01 × 2⁻³ - 确定三个部分:
- 符号位 S:正数,所以S = 0
- 指数位 E:指数是 -3。E = (-3) + 127 = 124。124的二进制是0111 1100。
- 尾数位 M:有效数字是1.01,我们去掉开头的1.,只保留.01,然后在后面补0,得到 23 位的0100 0000 0000 0000 0000 000。 - 组合起来:
-0 | 0111 1100 | 0100 0000 0000 0000 0000 000
所以,十进制数 0.15625 在计算机内部就被存储为这一串 0 和 1 的序列。
3 大模型中常用的精度表示
| 精度格式 | 上下边界(近似) | 位宽与数据意义 | S-E-M | 关键特征与用途 | PyTorch 数据类型 | 优点 | 缺点 |
|---|---|---|---|---|---|---|---|
| FP32(全精度) | ~ ±3.4e38 | 32 | 1-8-23 | 标准训练精度。提供最高的精度和动态范围,是模型训练(尤其是前向/反向传播)的基准。 | torch.float32 |
- 精度最高,训练稳定 - 动态范围广,不易溢出 | 内存占用最大(4字节/参数) - 计算速度最慢,功耗最高 |
| FP16(半精度) | ~ ±65504 | 16 | 1-5-10 | FP16 多用于推理。 | torch.float16 |
内存占用减半(2字节/参数) - 计算速度显著快于 FP32 | 指数位少,表达范围有限;尾数位少,精度损失大,易出现梯度下溢 |
| BF16(脑浮点) | ~±3.4e38 | 16 | 1-8-7 | BF16 因与 FP32 有相同的指数位,成为现代大模型训练的首选半精度格式。 | torch.bfloat16 |
内存占用减半(2字节/参数) - 计算速度显著快于 FP32;动态范围与 FP32 相同,训练更稳定 | 尾数位少,精度不如 FP16 |
| INT8 | -128 到127 | 8 | 1-0-7 | 模型量化推理。将 FP32 模型映射到 INT8 空间,极大减少模型体积和提升推理速度。 | torch.int8 |
内存占用仅为 FP32 的 1/4(1字节/参数) - 整数计算速度快,功耗低 - 非常适合边缘设备部署 | 精度有损失,需校准/量化感知训练(QAT) 来维持性能 - 不直接用于训练,主要用于推理 |
| FP8 | ~ ±57344 ~ ±240 |
8 | 1-5-2 1-4-3 |
下一代混合精度训练与高性能推理。专为AI设计的格式,在保持数值稳定性的同时,进一步降低内存占用和加速计算。 | torch.float8_e5m2 torch.float8_e4m3fn |
- 内存占用仅为FP16的1/2(1字节/参数) - 专有硬件支持,计算效率极高 - E5M2范围大,E4M3精度高,可分别用于梯度和权重 | -相对较新的技术,软件生态仍在完善中 - 需要特定硬件(如H100)才能发挥最大优势 |
| INT4 | -8 到 7 | 4 | 1-0-3 | 极致压缩与推理。在资源极度受限的场景下(如手机端)运行超大模型。 | 通常通过第三方库实现(如 bitsandbytes 的 torch.nn.Linear4bit) |
- 内存占用仅为 FP32 的 1/8(0.5字节/参数) - 可以运行以前无法在本地部署的模型 | 精度损失更大,需要更复杂的量化策略(如 GPTQ, AWQ) - 性能下降风险高,对硬件和软件栈要求高 |
| NF4(NFloat4) | 归一化到 [-1, 1] 的特定分位数 | 4 | 非标准浮点或整数格式。其数值表示是基于经验分布优化的,每个4-bit值对应一个预定义的、最优的浮点数值。 | 高效的4比特量化与微调。QLoRA技术的核心。通过理论优化,用4比特尽可能无损地表示权重分布。- 内存占用极小(约0.5字节/参数) - 相比INT4,对模型性能的损失更小 - 实现了在消费级GPU上微调超大模型(QLoRA) | 通过 bitsandbytes 库(如 torch.nn.Linear4bit) |
- 内存占用极小(约0.5字节/参数) - 相比INT4,对模型性能的损失更小 - 实现了在消费级GPU上微调超大模型(QLoRA)- 精度损失依然存在,不适合作为原始训练格式 - 需要复杂的量化过程和解量化计算 | 精度损失依然存在,不适合作为原始训练格式 - 需要复杂的量化过程和解量化计算 |
三、模型量化的基础理论
1 最简单的量化
如果要把下面的高精度值(两位小数)转化为低精度值(INT8),应该怎么做?
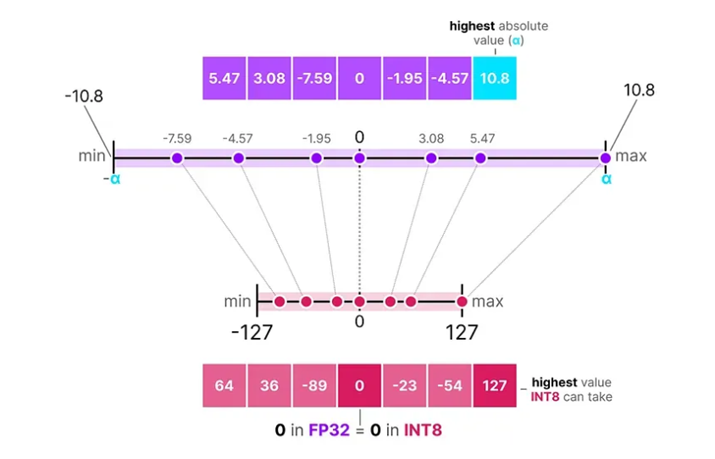
首先要找到缩放比例:scale = 10.8/127=0.085
对每个具体的值进行缩放: -7.59/scale = -89.2527778
取整:-89
2 对称量化与非对称量化
上面是一个最简化的例子,它的左右是对称的,不是所有的数据结构都这样良好。很多时候需要做非对称量化
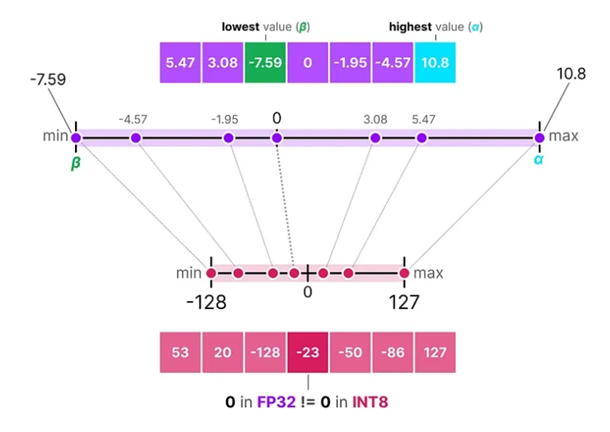
首先要找到缩放比例:scale=(10.8--7.59)/(127--128) = 0.0721176
其次要找到0点对应的值:zero point = -128--7.59/scale = -23
对每个值进行缩放和平移:-4.57/scale--23 = -40.3687
取整:-40
3 量化与反量化
3.1 什么是反量化,为什么要做反量化?
量化模型在存储时,权重是以低比特整数(如 INT4)的形式存在的,并且伴随着一些额外的量化参数(缩放因子 scale 和 零点 zero point)。然而,在进行实际的计算(如矩阵乘法)时,这些低比特权重通常需要被转换回(或者在计算过程中被当作)浮点数(如 FP16 或 BF16)。这个过程就是反量化。
所以量化过程的quant_config仍需保存下来,这些信息在推理(inference)阶段不可或缺。
3.2 反量化还能加快推理吗?
这是一个非常好的问题,它触及了量化加速推理的核心机制,并且指出了一个看似矛盾的地方。——如果在计算的每一步都进行显式的、完整的反量化(将 INT4/INT8 完全变回 FP16/FP32),那么计算本身的加速效果可能会被抵消。
量化+反量化体系能够显著地加快推理速度,有以下两个原因:
3.2.1 节省显存带宽 (Memory Bandwidth)
对于大型语言模型(LLMs)来说,推理速度的主要瓶颈往往不是纯粹的计算单元(ALU/CUDA Cores)速度,而是将模型权重从显存(DRAM 或 HBM)加载到计算单元(如 GPU 的 SMs 或 Tensor Cores)的速度。量化(例如到 INT4)可以将权重的大小缩小 4 倍(相比 FP16)。这意味着:
- 从内存加载相同数量的“信息”(代表权重的数值)所需的时间大大减少。
- 更多(甚至全部)的模型权重可以放入速度更快的缓存(L1/L2 Cache 或 GPU 的 SRAM)中,进一步减少了对慢速主内存的访问。
这个内存带宽的节省是量化加速的最主要来源,即使计算本身仍然在某种形式的浮点精度下进行(或者需要处理量化参数)。
3.2.2 并非完全反量化
现代推理框架(如 AutoAWQ、TensorRT-LLM, vLLM 等)和硬件(如 NVIDIA GPU 的 Tensor Cores)并不是简单地执行“完全反量化 -> 浮点计算”的流程。
它们使用高度优化的量化计算内核 (Quantized Kernels)。这些内核被设计为:
- 直接读取低比特权重 (INT4/INT8) 和它们的量化参数 (scales/zeros)。
- 在计算过程中“即时”或“融合”地处理量化参数。这意味着反量化的步骤(乘以 scale,加上 zero point)可能与矩阵乘法等核心计算操作融合在同一个硬件指令或紧密耦合的计算流中。
-
通常使用更高精度的累加器 (Accumulators)。 例如,即使输入权重是 INT4/INT8,激活值是 FP16,矩阵乘法的中间累加结果也可能使用 FP32 来保持精度,最后再将结果转换回所需的输出精度(如 FP16)。
-
这种方式避免了显式地将整个权重矩阵反量化为 FP16/FP32 中间结果存储在内存中,从而节省了时间和内存。 计算是在“模拟”浮点运算,但输入数据的读取和处理利用了低比特的优势。
3.3 怎样反量化?
量化值为:-40
真实值=(-40-zero point)*scale = -4.5434088 ≠ -4.57
4 线性量化与非线性量化
也叫均匀量化与非均匀量化
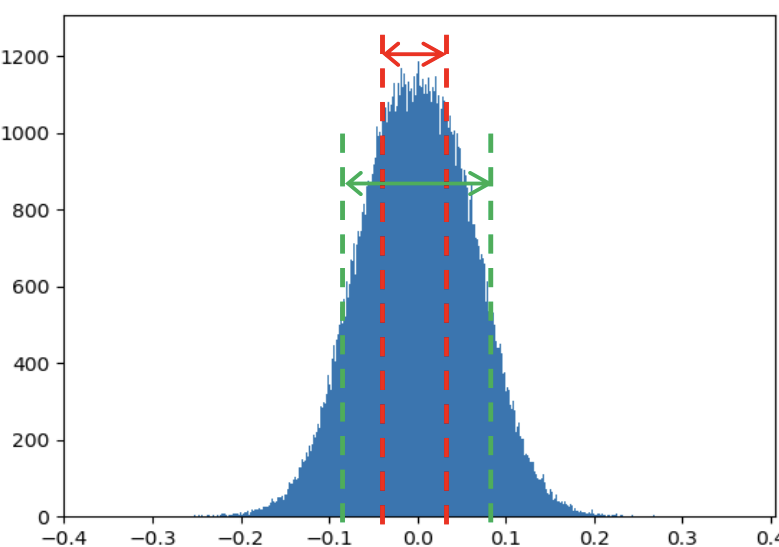
上面考虑的都是数据在值域上分布比较均匀的情况,实际中的数据很多都不是这样的。
模型经过充分训练后,参数值的分布
一个语料库里统计各单词的词频,按照从高到底排序
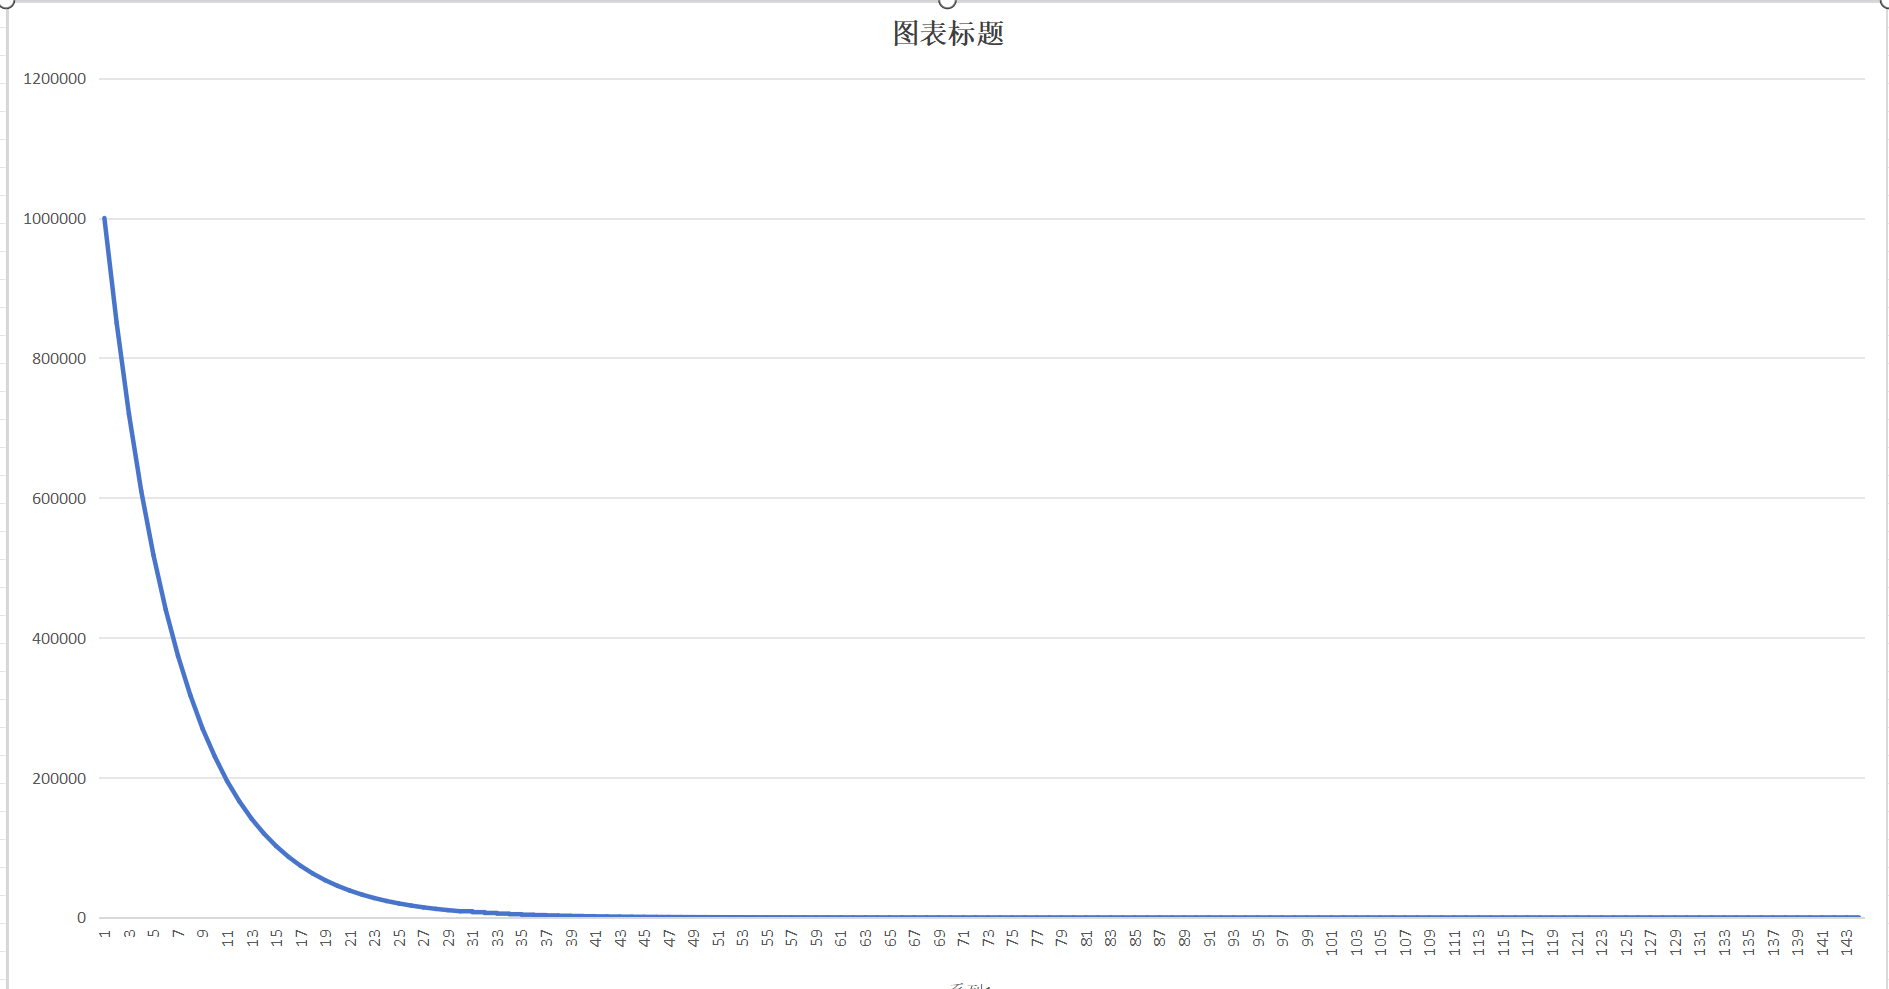
这些数据若采用线性映射,数据密集区会变得难以区分,数据稀疏区会形成对值域的浪费,怎样解决?
可以从地图上找找灵感,这是中国的分县地图
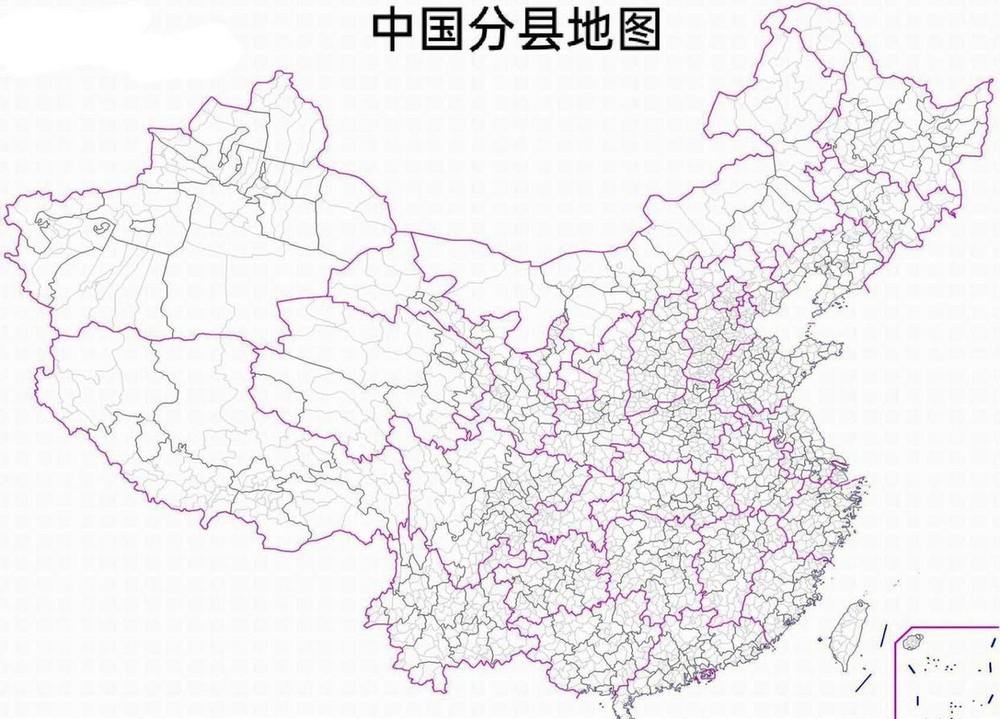
解决方案就是非线性量化
5 统一精度量化与混合量化
看一下各种精度的优缺点:高精度效果好但是成本高;低精度成本低但是效果差。
但是很多时候工程上会既要又要,怎样同时实现成本低和效果好?
模型裁剪分为非结构化裁剪和结构化裁剪,其中的结构化裁剪指的是把模型的某些模块整体性地裁剪掉,因为多个并行模块中,各模块对于某一类结果的贡献不同,有些贡献太小的模块就可以被裁掉。
比如transformer里多头注意力的各个头
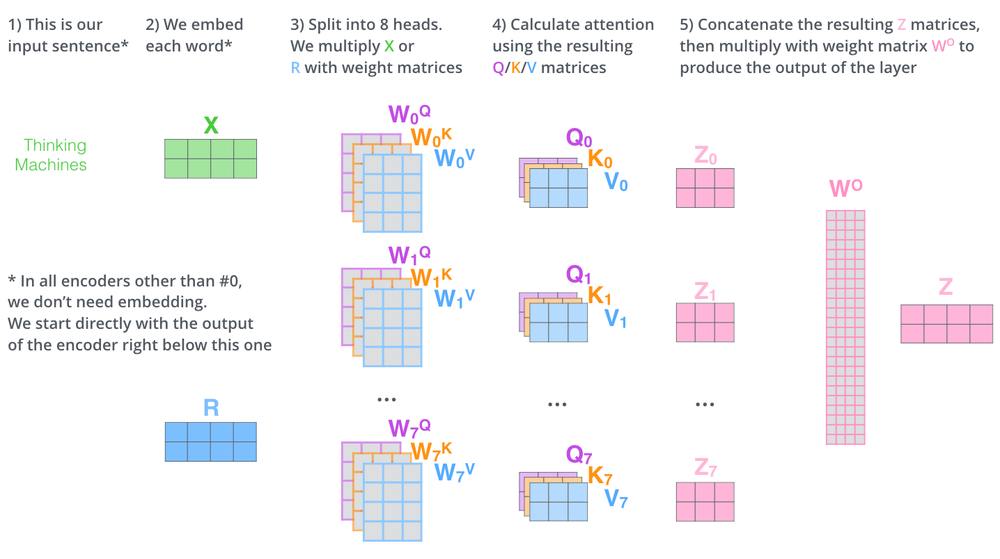
比如计算机视觉中的不同channel或者filter
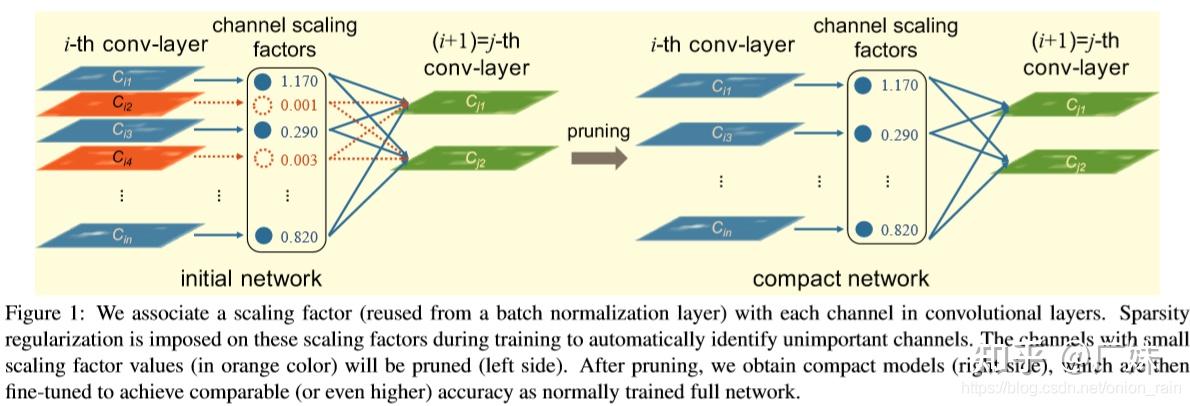
各个分支对最终结果的贡献度是不同的,这个特性可以被应用到模型裁剪上,能不能被应用到量化上?
俗话说:好钢用在刀刃上。
可以考虑把高贡献度的模块用较高精度表示,低贡献度模块用较低精度表示。
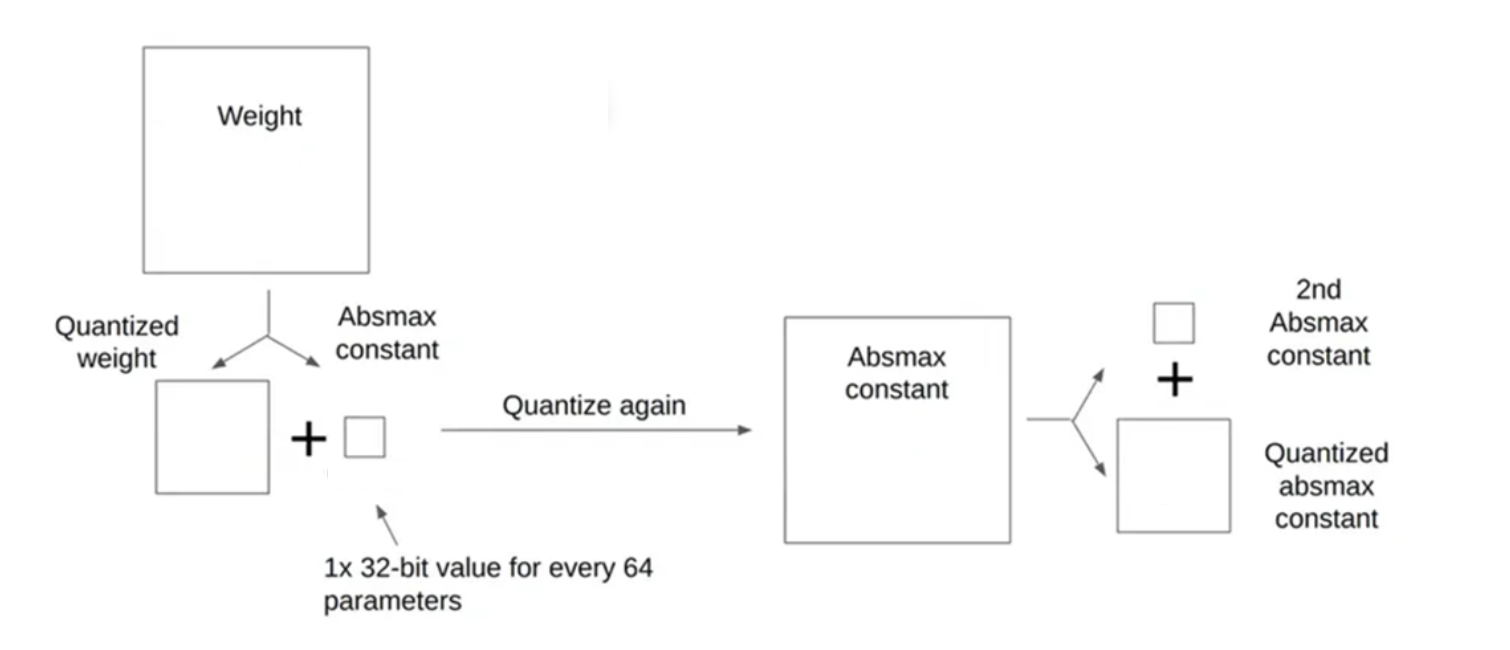
6 双重量化
刚才的量化过程,完成了将权重参数从高精度到低精度的转化,还有哪里可以改进?
别忘了还有zero point和scale,前面的量化,这两组值是全精度,他们也可以被量化
7 量化的时间点
按照量化的时间点,可以分为训练后量化和量化感知训练
7.1 训练后量化(Post-Training Quantization, PTQ)
训练后量化是在一个已经训练好的全精度(FP32/FP16)模型上直接进行量化,无需或仅需极少的再训练。
核心思想:先训练好一个高性能的模型,然后通过分析训练好的权重和激活值的分布,来确定量化的尺度(Scale)和零点(Zero-point),从而将模型转换为低精度格式。
这种量化方法无需重新训练,计算成本极低,几分钟到几小时即可完成。不需要原始训练数据(静态PTQ需要少量校准数据)。但是有较高的风险会造成精度下降,尤其是模型较小或量化到极低精度(比如INT4)时
7.2 量化感知训练(Quantization-Aware Training, QAT)
这种方法将量化过程嵌入到模型的训练阶段。在训练的前向传播中,模拟量化的效果,让模型在训练时就能“感知”到量化会带来的误差,并据此调整权重,使得最终训练出的模型在真正被量化后精度损失最小。
核心思想:在训练的前向传播中,加入“伪量化”(Fake Quantization)操作,即先量化再反量化,引入数值误差。反向传播时,使用直通估计器(Straight-Through Estimator, STE)来近似梯度,使模型权重能够适应这种误差。
这种量化方法成本很高,需要完整的或部分的重新训练,计算成本和时间成本都非常高,对于百亿、千亿参数的大模型来说尤其如此。需要修改训练代码,插入伪量化节点,调试复杂。但是效果在所有方法中是最好的,没有之一。尤其是适用于低精度(INT8,INT4)量化。
四、两种最成熟的量化技术
1 GPTQ(Gradient-based Post-training Quantization)
GPTQ是一种对LLM进行量化的方法,它只对权重进行量化,但可以将权重量化到4 bits,同时量化后的模型能保证很好的精度,在这种量化过程中,需要少量验证样本。
1.1 损失补偿的直观理解
量化最困难的是:怎样保证整个网络的输出尽可能不变?
可以从一种模型裁剪算法OBS(Optimal Brain Surgeon)中找到解决方案。
想象一个复杂的蜘蛛网(代表训练好的神经网络)。每一根丝线代表一个权重,它们相互连接,形成一个整体。现在,你想剪断其中一根丝线(量化一个权重),但希望整个蜘蛛网的形状(网络的输出)尽可能保持不变。
- 朴素的方法(一阶方法):你只看到剪断的那根丝线松了。你可能会随便拉紧旁边的几根线来补偿。结果可能是局部看起来好了,但整个网的形状却扭曲了。这就像只考虑梯度(一阶导数),它只告诉你误差变大的方向,但不知道如何“均匀”地补偿。
- OBS的方法(二阶方法):你是一个聪明的蜘蛛,你懂得整个网的结构力学。你知道每一根丝线的张力和它们之间的相互影响。在剪断一根丝线前,你就能精确地计算出需要如何调整所有其他丝线的张力,才能使整个网的变形最小。
在这个类比中:
- 剪断一根丝线:相当于将一个权重 wq 量化到 w^q。
- 网的变形:相当于网络输出的误差 ΔE。
- 蜘蛛网的结构力学:就是由海森矩阵(Hessian Matrix) 所描述的权重之间的相互作用关系。
1.2 海森矩阵
海森矩阵是一个多元函数的“二阶导数”矩阵。它描述了函数在各个点上,沿着不同方向弯曲的“曲率”。
一维情况(一元函数 f(x)):
- 一阶导数
f'(x):表示函数在x点的斜率或变化速度(梯度)。它告诉我们函数是上升还是下降。 - 二阶导数
f''(x):表示一阶导数的变化率,也就是斜率的变化速度。它告诉我们函数的弯曲程度(曲率)。 f''(x) > 0:函数向上弯曲(像碗状,局部最小值)。f''(x) < 0:函数向下弯曲(像拱形,局部最大值)。f''(x) = 0:无法判断,可能是拐点。
多维情况(多元函数 f(x₁, x₂, ..., xₙ)):
- 这时我们有一个点
(x₁, x₂, ..., xₙ),函数有多个输入变量。 - 梯度(Gradient):这是一个向量,包含了函数对每个变量的一阶偏导数。它指向函数增长最快的方向。
- 梯度 =
[∂f/∂x₁, ∂f/∂x₂, ..., ∂f/∂xₙ] - 海森矩阵(Hessian):这是一个 n x n的矩阵,包含了函数的所有可能的二阶偏导数。它描述了梯度在不同方向上是如何变化的,即函数在各个方向上的曲率。
1.3 逐个量化与分行量化
OBS原始算法:把权重直接展开,计算对应的海森矩阵,然后按照各个权重影响力从小到大的顺序进行量化,先量化对误差影响最小的那个权重,然后更新所有未量化的权重来补偿这个量化误差,再继续量化下一个。这种方法非常精确,但是计算非常复杂。
时间复杂度:$\(O\left({\left(d_{\mathrm{row}} \cdot d_{\mathrm{col}}\right)}^3\right)\)$

这种算法直接用在大模型上计算规模是极其恐怖的。
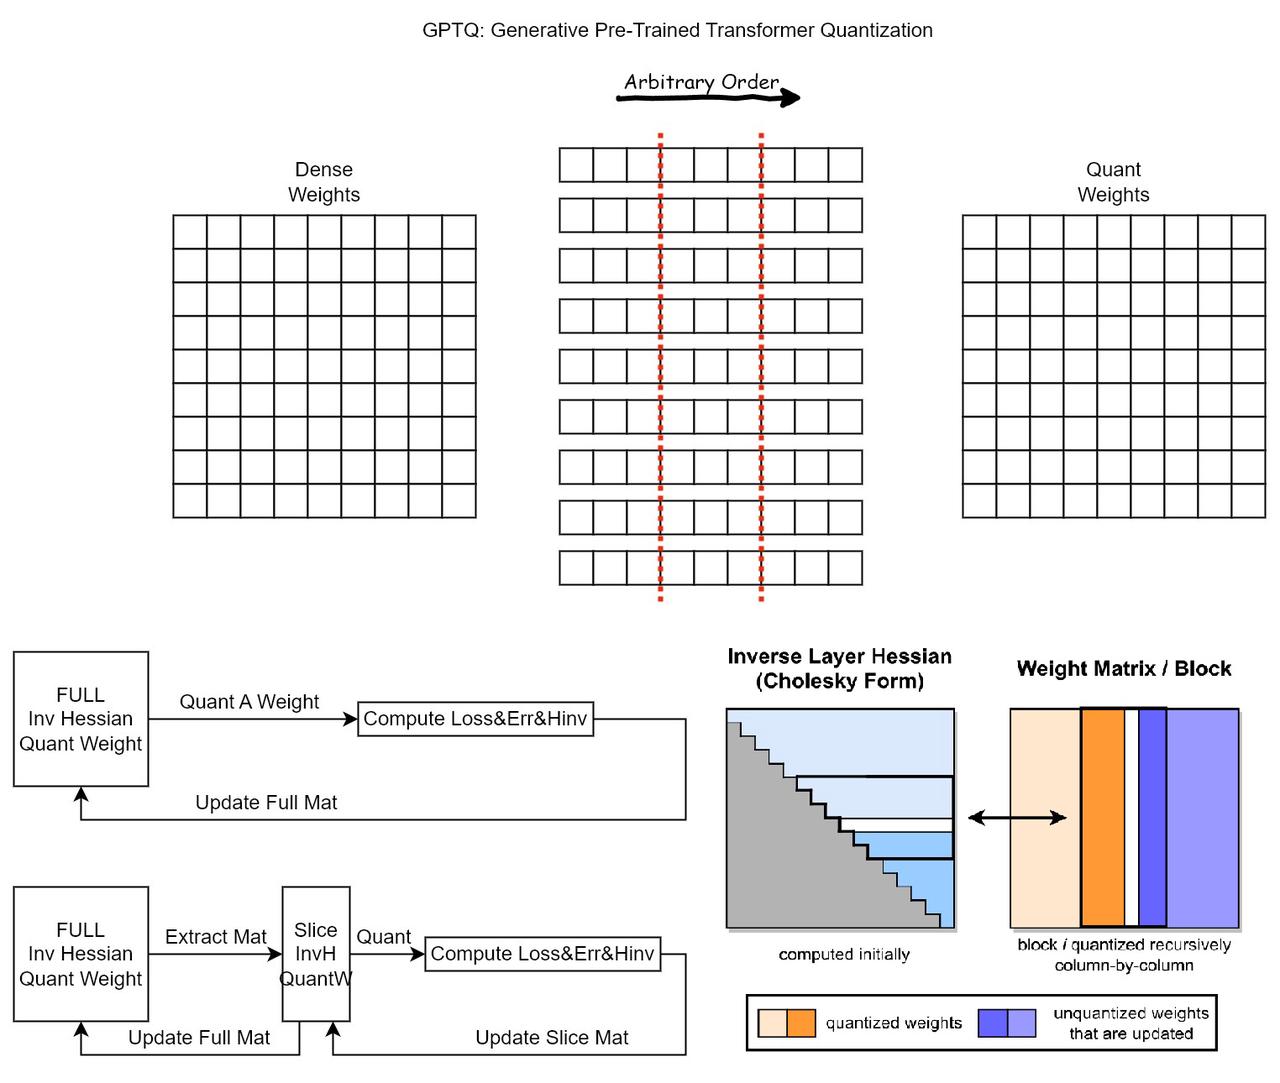
但是可以考虑将繁琐的逐个计算,拆解为分行计算,使用贪心算法,每次找量化误差最小的方向进行量化。$\(O\left(d_{\text {row }} * d_{\text {col }}^3\right)\)$

1.4 贪心算法与随机挑选
实际中发现,在大规模计算中,贪心算法并不比随机挑选有很大优势,所以干脆抛弃贪心算法。随机挑一个计算顺序并固定下来。
使用相同顺序,各行并行计算,分批BatchUpdate,分组量化。时间复杂度:$\(O\left(\max \left\{d_{\text {row }} \cdot d_{\mathrm{col}}^2, d_{\mathrm{col}}^3\right\}\right)\)$
- 相同顺序:在量化的过程中,以贪心算法来每次以最小的误差量化权重的方法表现良好,但相比固定顺序并没有明显提升,尤其是在大模型上可能固定顺序更好。所以我们使用固定顺序进行量化。
- 并行计算:因为量化权重在行间没有影响,所以我们可以并行量化多行来加速计算。
- 分批更新:如果我们每次量化一个参数就进行一次权重更新的话,更多的时间都被花到访存,不能充分利用GPU的算力,所以我们可以分批进行更新,批内完成后再更新全局的矩阵。
- 数值稳定:对海森矩阵的逆$\(\text{Cholesky Reformulation}\)$来增强数值稳定性。
- 分组量化:相对于采用相同的Scale,Zero对整个矩阵进行量化,选择一个小点的Groupsize在组内计算特定的量化参数可以应对全局的异常值,取得更好的量化效果。
1.5 分层量化
整个大模型的量化是非常复杂的系统化工程,可以用采用“分而治之”的策略,将每一层网络的权重单独量化。
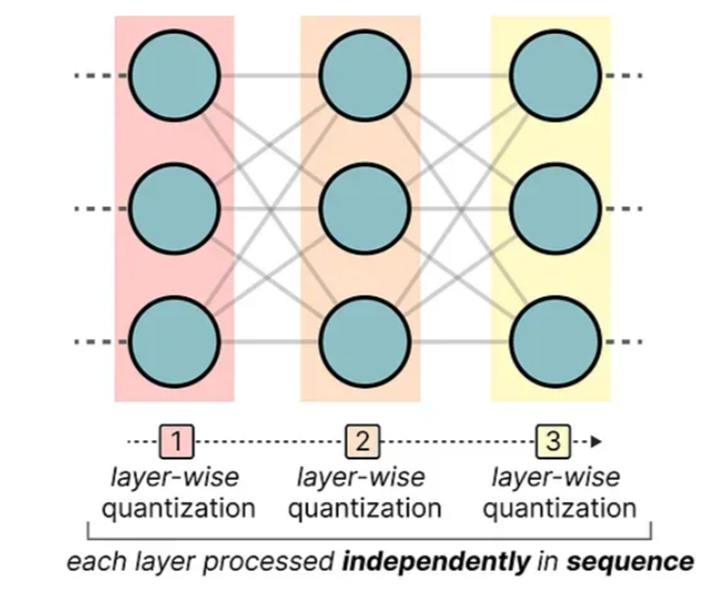
在这个逐层量化的过程中,首先将模型层的权重转换为 Hessian 矩阵的逆矩阵。Hessian告诉我们模型输出对每个权重变化的敏感程度。
2 QLoRA
量化感知训练效果非常好,但是如果是做预训练成本极高,而且伪量化节点的调试非常复杂,但这不代表它不实用。有没有训练或者微调方法成本很低,训练参数很少呢?
LoRA!
可以考虑把这两者结合起来,做成一个成本低、效果好的方案
QLoRA(Quantized Low-Rank Adaptation)是LoRA的进一步扩展,结合了深度量化技术。它将预训练模型量化为低精度格式(如4位),并在训练过程中使用高精度格式(如bf16)进行反量化。这样可以在保持模型精度的同时,进一步减少存储需求和计算复杂度。
QLoRA在LoRA的基础上,增加了三项核心技术:4位标准浮点数量化,双重量化和分页优化器。
2.1 4位标准浮点数量化(NF4)
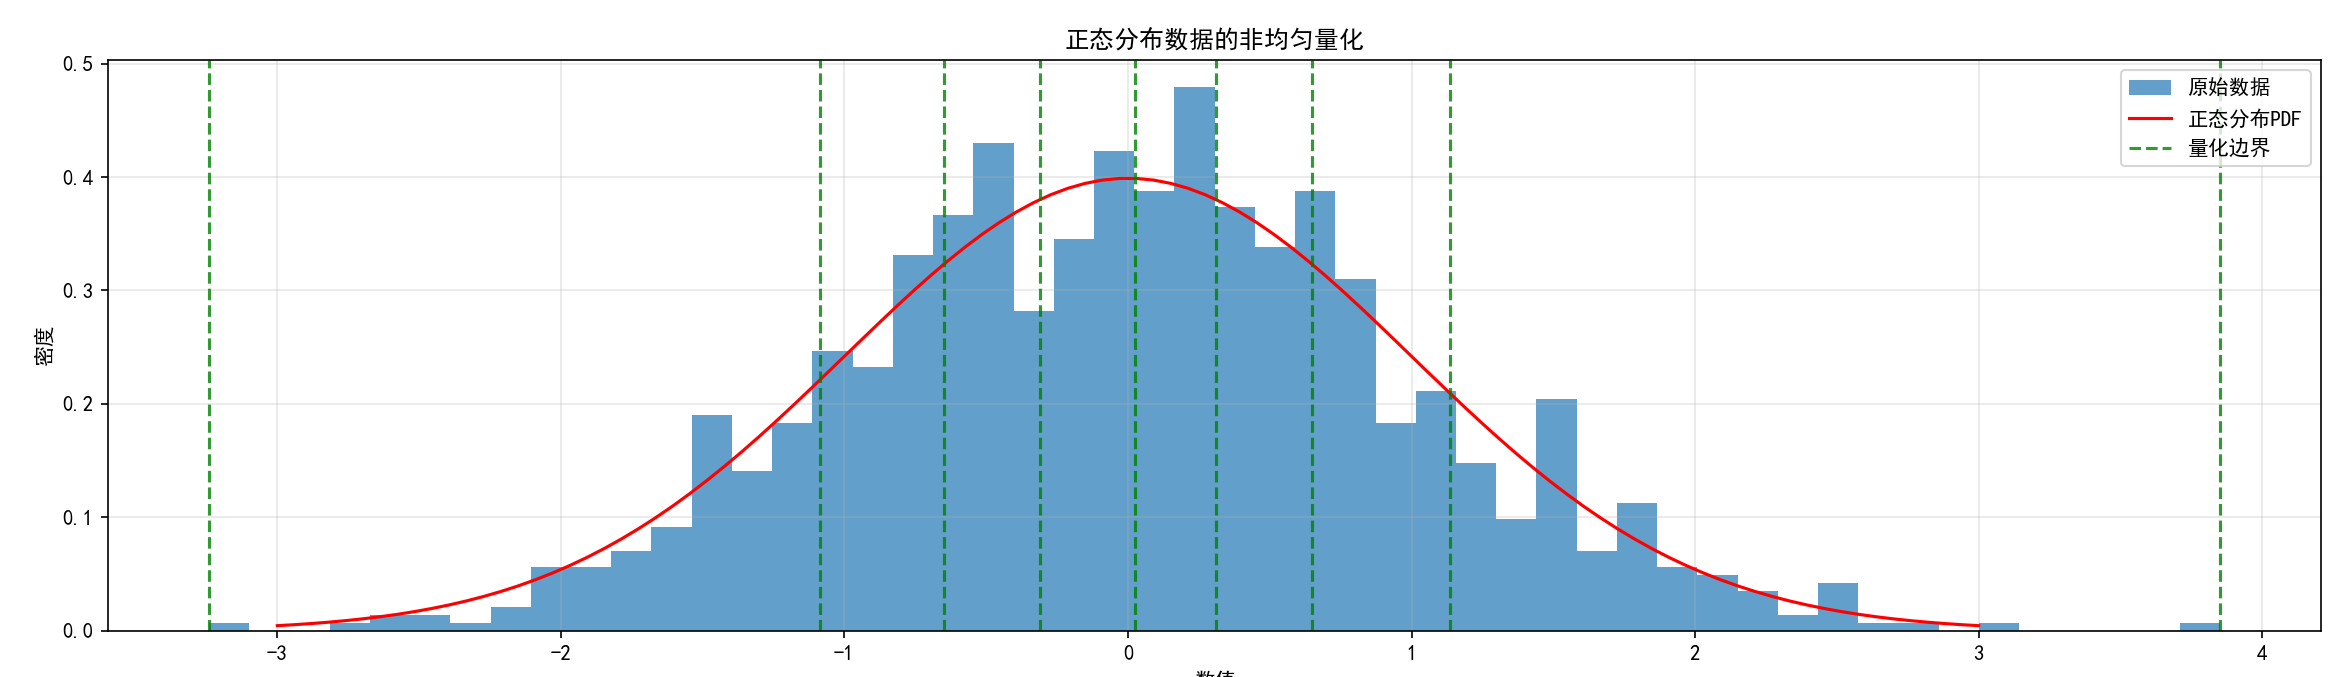
4-bit NormalFloat (NF4) 的数据类型,它是一种量化方法,用于在减少数据表示的位数的同时,尽量保留数据的分布特性。对于神经网路,一般参数值都是符合正态分布的(0附近的参数很多,远离0的参数很少),使用上面的均匀分布是不太合适的。
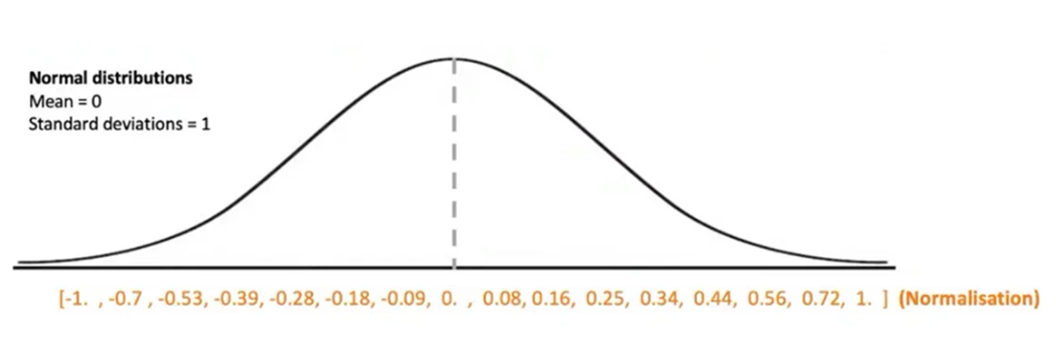
NF4将正态分布,按照其累计概率密度,分为16个区域,因为4bit 量化后的的整数有16个,可以看到,越靠近0就越密集,越远离0就越稀疏。对于每个区间,可以求出起始点和终止点对应的X值。
2.2 双重量化
见第四章第6节
2.3 分页优化器
分页优化器的概念用于管理大型语言模型 (LLM) 训练期间的内存使用情况。在训练具有数十亿个参数的大型模型时,GPU 内存不足是一个常见问题。分页优化器用于解决模型训练期间发生的这些内存峰值。
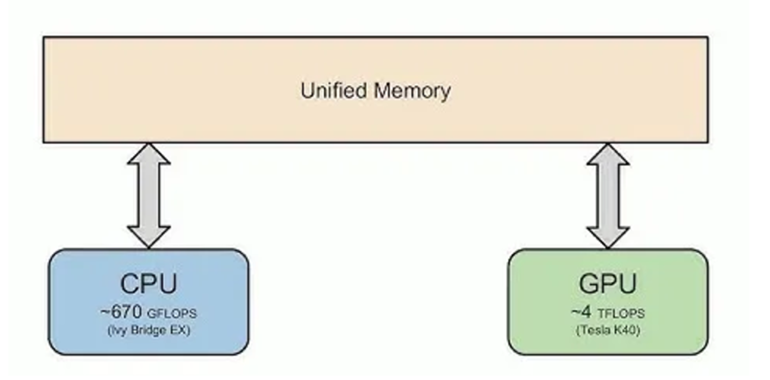
NVIDIA 统一内存可实现 CPU 和 GPU 之间的自动页面到页面传输,以便在GPU显存不够的情况下仍能正常处理。具体来说,在GPU内存不足时,自动将其移出到CPU的RAM中,并在优化器更新步骤需要时取回到GPU显存中。
五、历史分水岭QLoRA和vllm
1 之前的大模型微调解决方案:
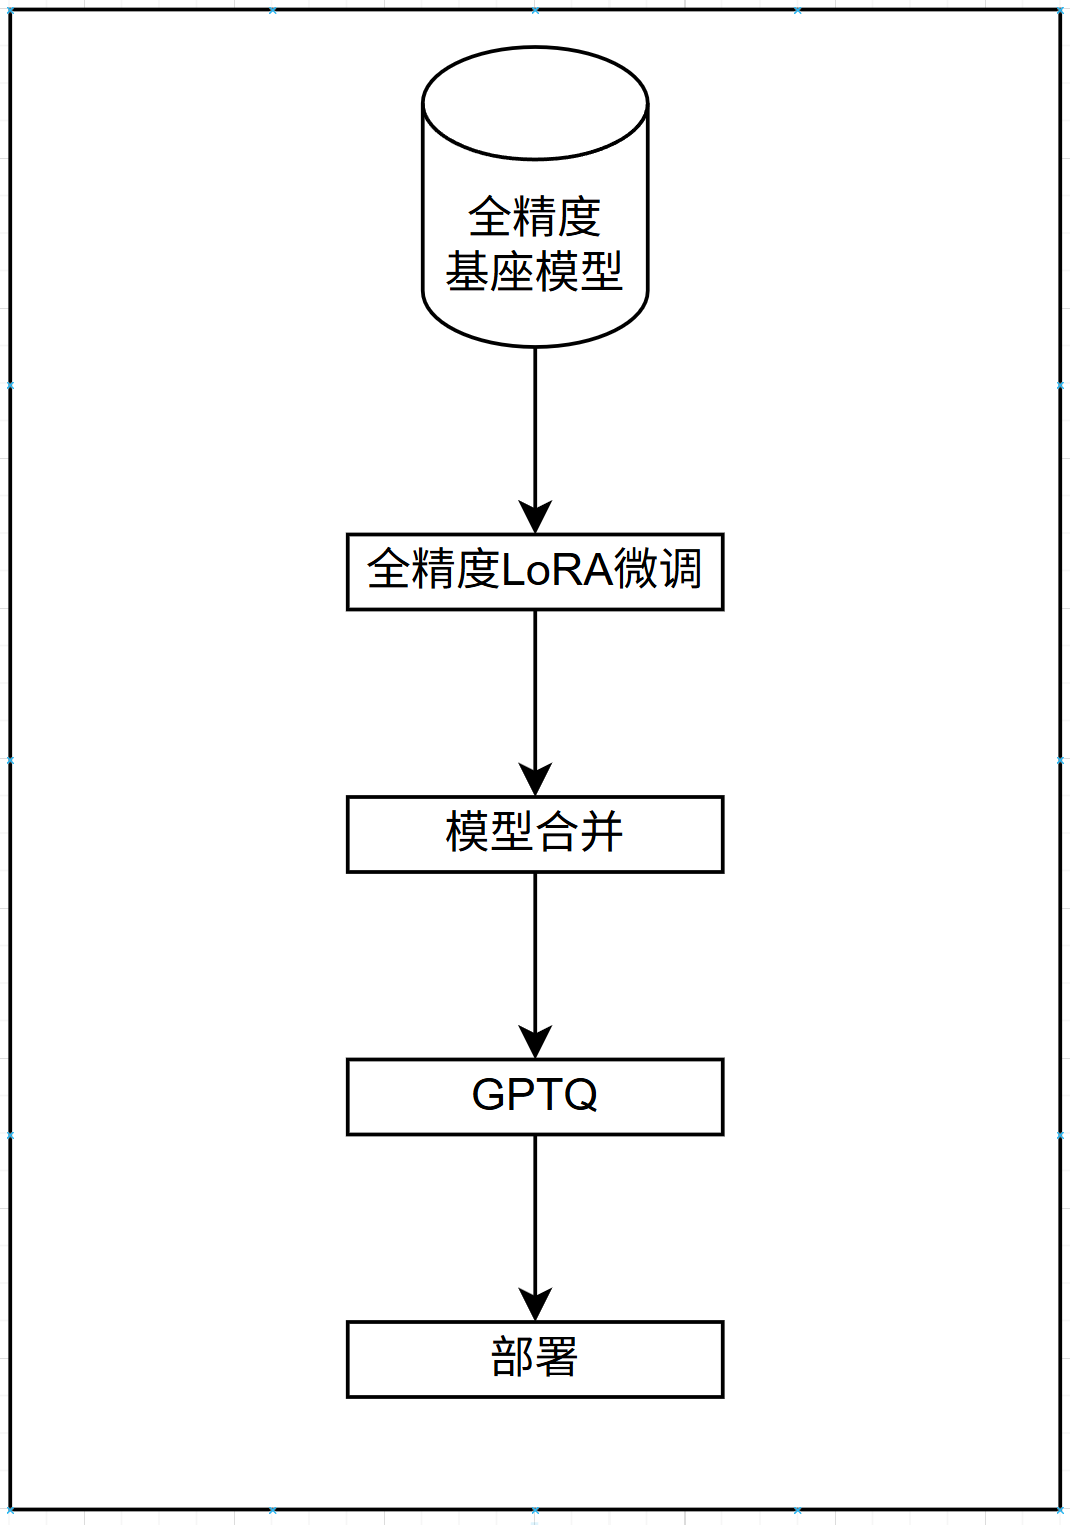
2 之后的微调解决方案
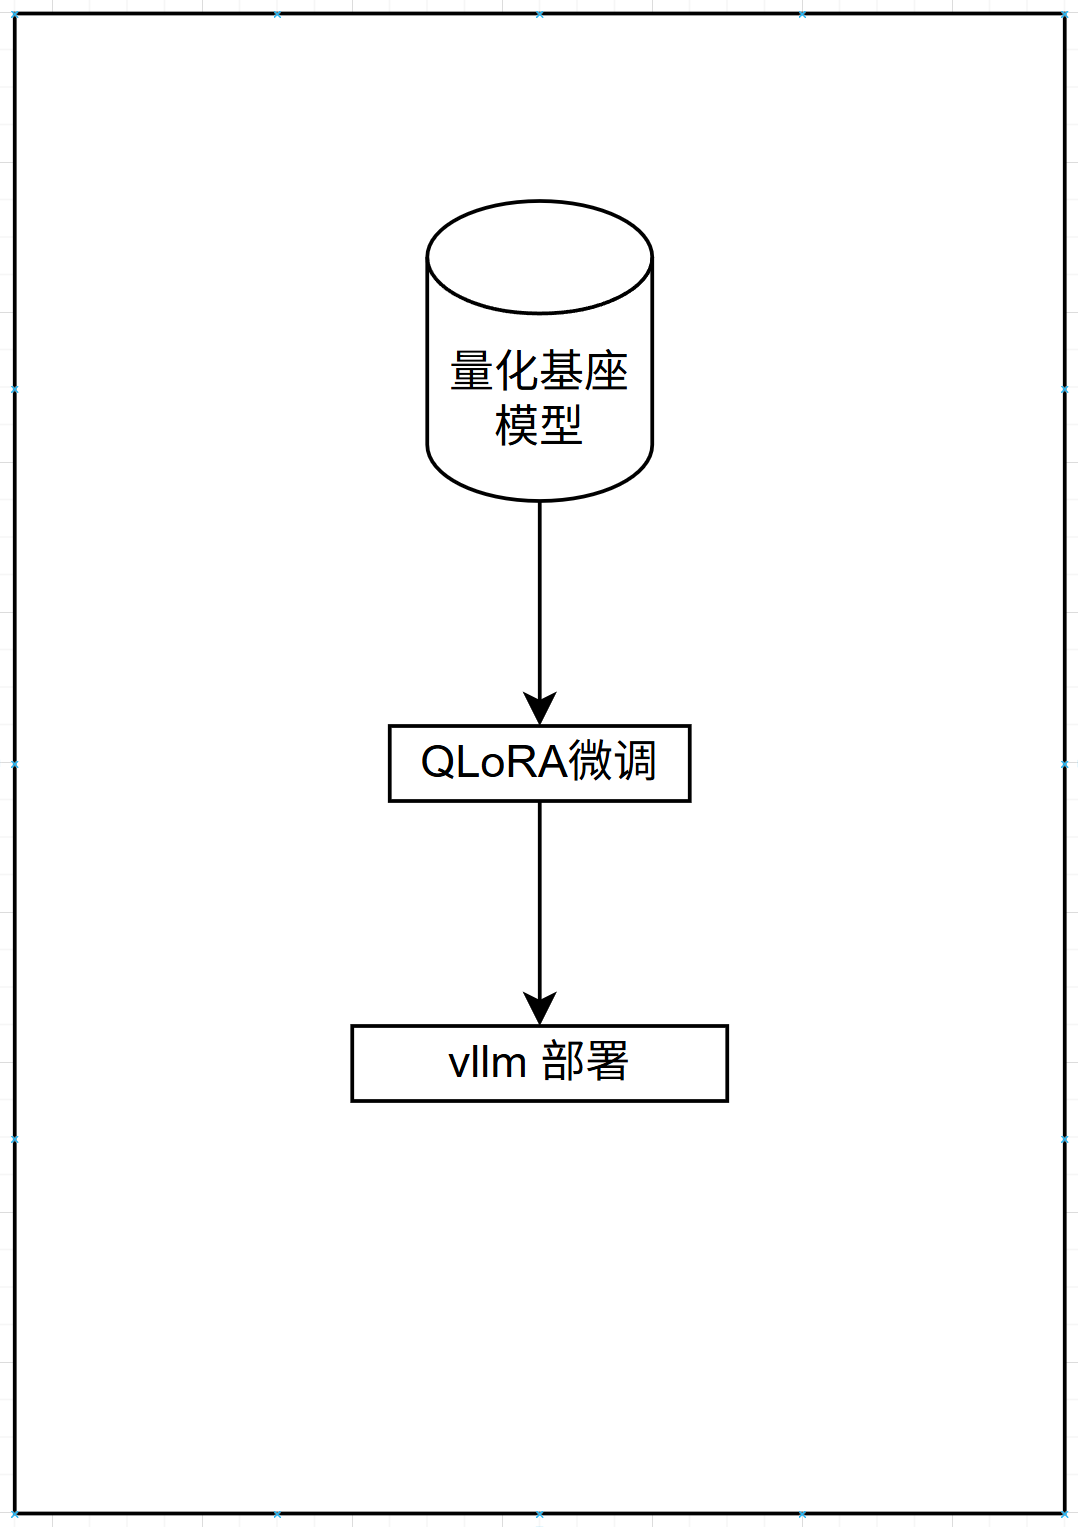
量化环境依赖
1 个文件- 📄 requirements.txt 4.0KB 下载