第 8 节 / 共 8 节
加餐:RAG 串讲回顾
🎯 RAG 全流程回顾与评估(RAGAS)。
📖 笔记
RAG 回顾和加强
RAG回顾和加强
LangChain
LangChain的几个核心组件?
#1.model模型
LLM
Chat
Embedding(类似于bge-m3,text-embedding-v3)

#2.Prompt提示词模板
PromptTemplate

#3.indexes 检索
初始化加载器对象(不同的加载类)
    OCR:光学字符识别。识别图片中的文本(扫描件)。
    PaddleOCR
    DeepSeekOCR
    GeminiOCR
    textIn
    多模态模型
知识库加载 loader.load()/lazy_load()
知识库切割
    切割策略非常多。大小都是自定义。
    为什么选择父子快切割,父块大小为什么是512,子块为什么是128?
    重叠大小:经验值,建议给。
向量化(bge-m3模型)

#4.Memory 记忆
短期记忆:内存(会话)
长期记忆:外存(数据库,文件等)
面试题:如果检索的上下文内容过长/超过模型的上下文,怎么办?
会话压缩(让大模型总结一下)

#5.Chain 链
把多个任务串起来执行。
|:管道符。这种语法称之为:LCEL(LangChain Expression Language)

#6.Agent智能体
在LangChain中,也支持Agent。就是React模式的智能体。
Milvus
数据库:存取数据。
所有的数据库,基本上都是有数据存(insert/update)和取(select/delete)的功能。
Milvus是一个向量数据库。也支持这些操作。
upsert=insert+update,写入。
search:检索(查询)。
delete:删除。
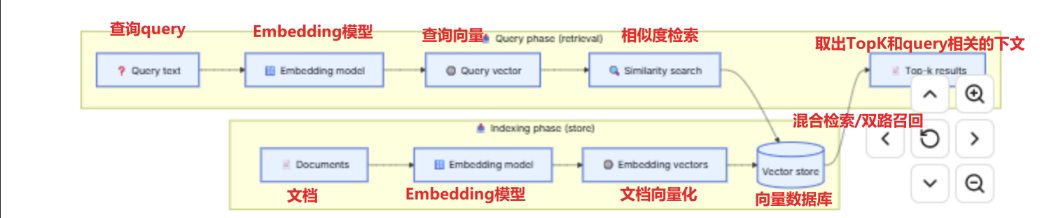
但是,项目中主要是使用混合检索的能力。
client.hybrid_search(2个向量):
#1.稀疏向量:关键字检索

#2.稠密向量:语义检索
在混合检索过程中,如何取召回的内容?
它得指定排序算法:
#1.WeightedRanker
加权评分(加权排名器):适合明确知道权重的情况(稀疏向量权重、稠密向量权重)

#2.RRFRanker
互易等级融合(平权排名器):适合不知道权重的情况(同等对待所有向量权重)
RAG架构
通用RAG架构
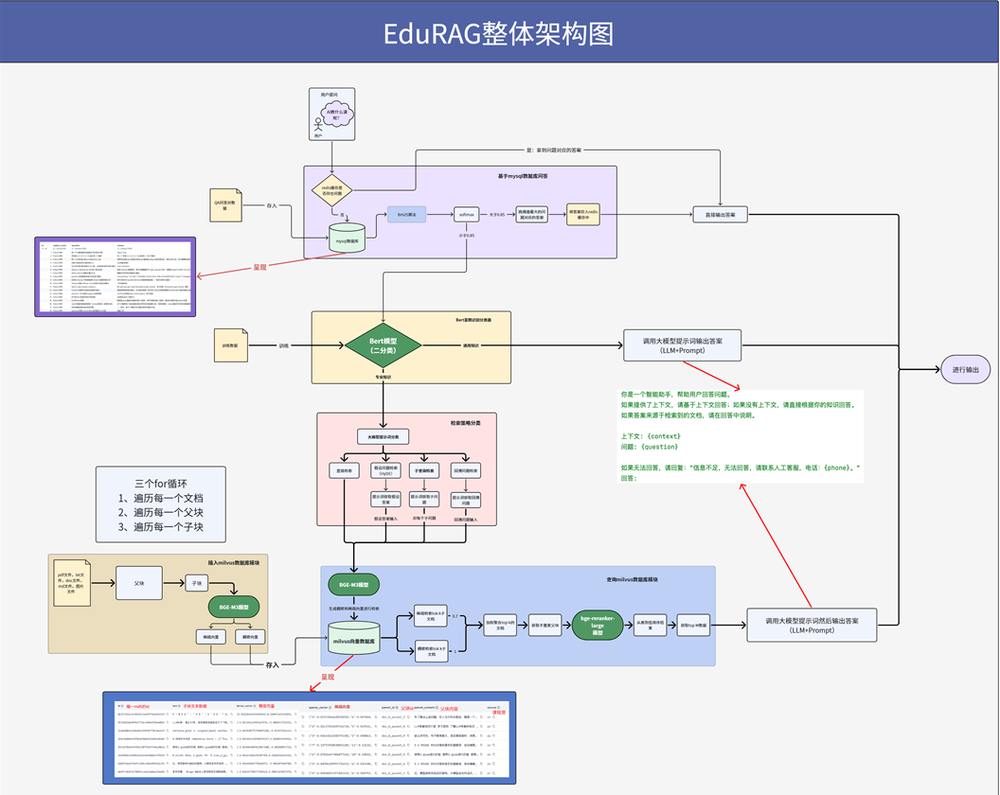
项目中的RAG架构
核心代码
mysql_qa:sql_main.py模块
其中的核心方法是:bm25_search.search
rag_qa:rag_main.py模块
其中的核心方法是:grag_system.generate_answer(),其中,在generate_answer中的核心方法是:self.retrieve_and_merge()