第 3 节 / 共 8 节
提示词工程进阶
大模型基础(提示词工程篇)
大模型基础
今日内容介绍
-
LLM主要架构类别
-
提示词工程原则
- 提示技术介绍
【了解】LLM主要结构类别
大语言模型架构基石
LLM本身基于Transformer架构。自2017年,《Attention Is All You Need》发表起,原始的transformer模型为不同领域的模型提供了灵感和启发。
Transformer 的核心创新是“自注意力 + 并行化”,让模型能高效捕捉全局依赖关系,并具备大规模扩展能力,因此成为大语言模型的基石。基于原始的Transformer框架,衍生出了一系列模型,一些模型仅仅使用encoder或decoder,有些模型同时使用encoder+decoder。
自编码模型
AutoEncoder Model,AE模型,代表作BERT,其特点为:Encoder-Only, 基本原理:是在输入中随机MASK掉一部分单词,根据上下文预测这个词。AE模型通常用于内容理解任务,比如自然语言理解(NLU)中的分类任务:情感分析、提取式问答。
代表模型 BERT
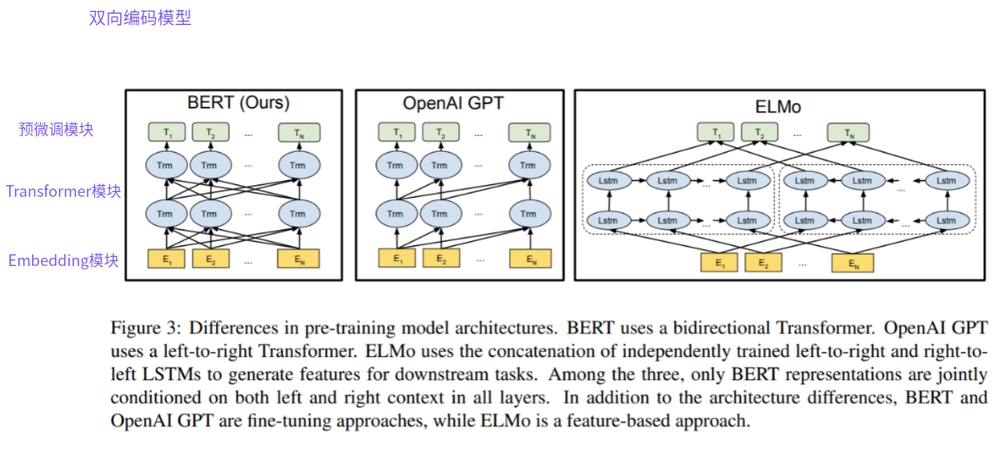
BERT是2018年10月由Google AI研究院提出的一种预训练模型。BERT的全称是Bidirectional Encoder Representation from Transformers。
BERT的架构
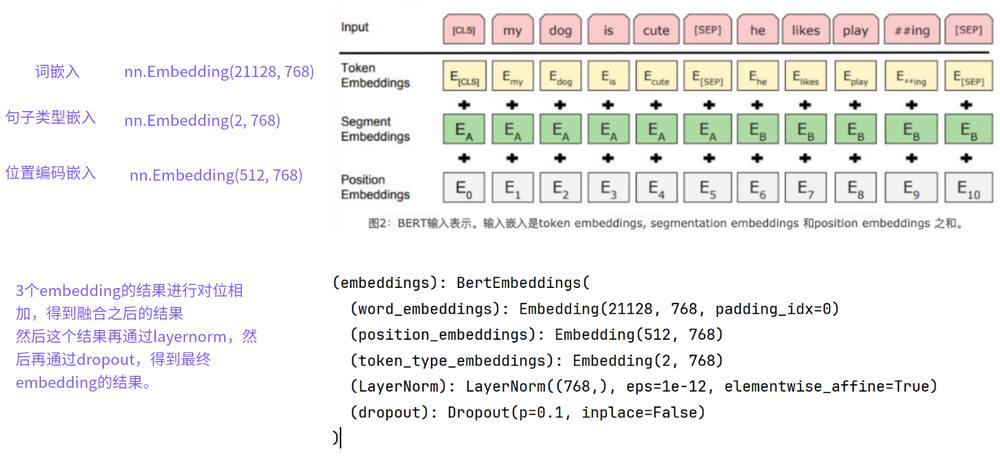
Embedding模块
双向Transformer模块
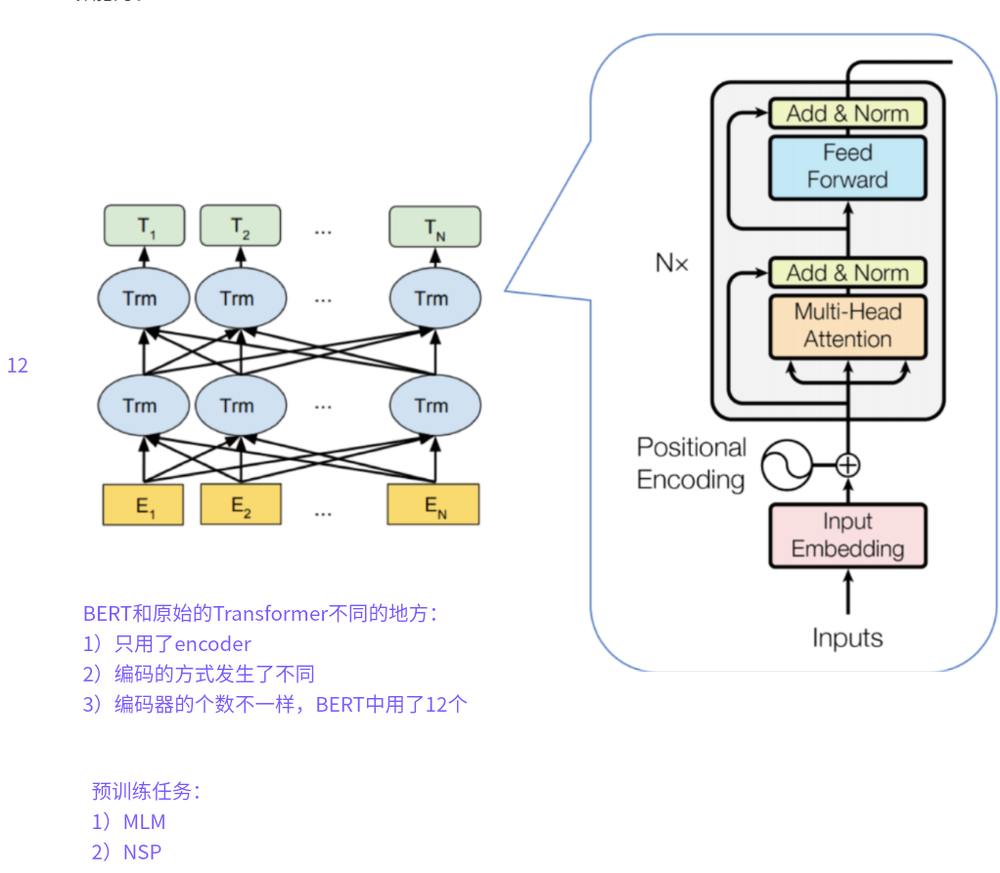
MLM(Masked Language Model):随机遮盖输入的部分词,让模型预测这些词。
NSP(Next Sentence Prediction):判断句子 B 是否是句子 A 的下一句。
预微调模块
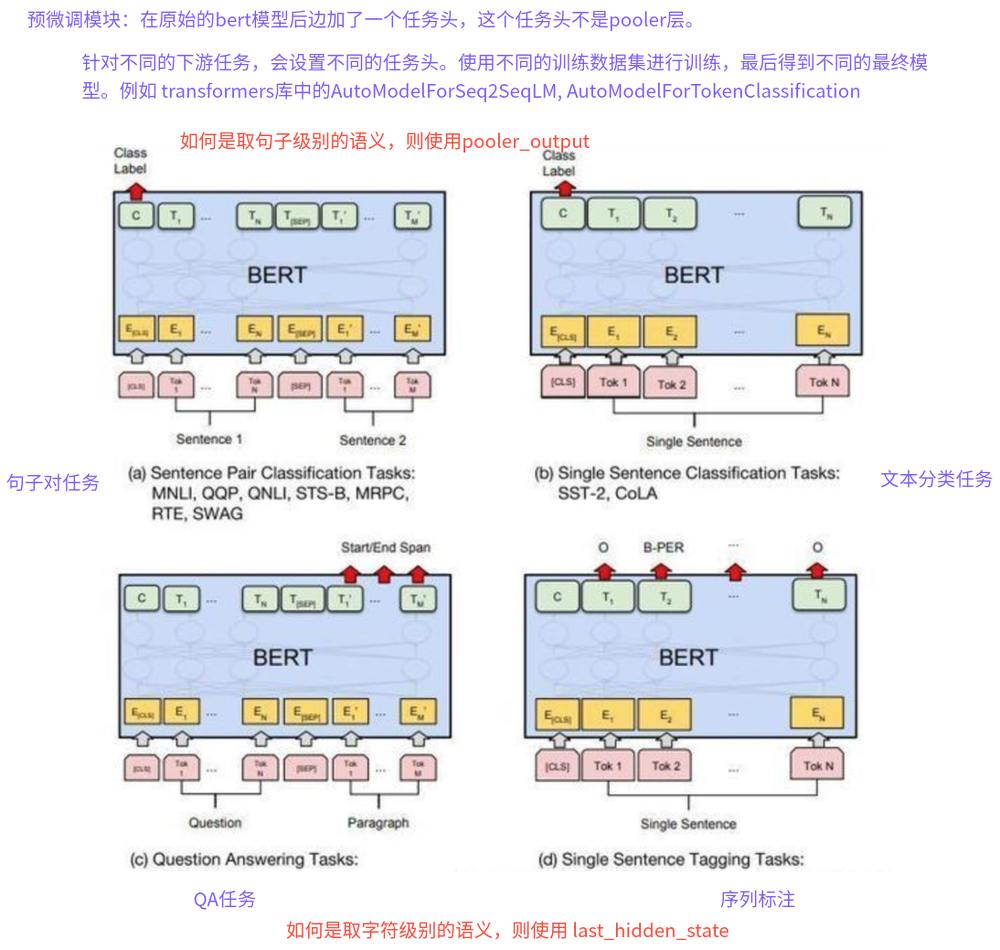
BERT模型的特点
模型的一些关键参数为:
| 参数 | 取值 |
|---|---|
| transformer 层数 | 12 |
| 特征维度 | 768 |
| transformer head 数 | 12 |
| 总参数量 | 1.02 亿 |
AE模型总结
优点:BERT使用双向transformer,在语言理解相关的任务中表现很好。
缺点:
- 输入噪声:BERT在预训练过程中使用【mask】符号对输入进行处理,这些符号在下游的finetunning任务中永远不会出现,这会导致预训练-微调差异。而AR模型不会依赖于任何被mask的输入,因此不会遇到这类问题。
- 更适合用于语言嵌入表达, 语言理解方面的任务, 不适合用于生成式的任务
自回归模型
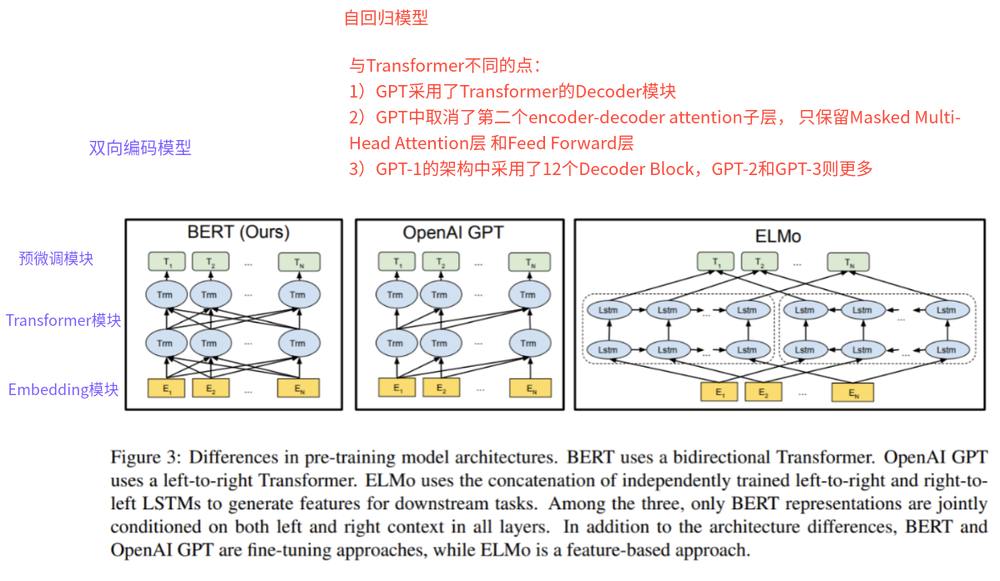
AutoRegressive Model,AR模型,代表作GPT,其特点为:Decoder-Only,基本原理:从左往右学习的模型,只能利用上文或者下文的信息,比如:AR模型从一系列time steps中学习,并将上一步的结果作为回归模型的输入,以预测下一个time step的值。AR模型通常用于生成式任务,在长文本的生成能力很强,比如自然语言生成(NLG)领域的任务:摘要、翻译或抽象问答。
代表模型 GPT
2018年6月, OpenAI公司发表了论文“Improving Language Understanding by Generative Pre-training”《用生成式预训练提高模型的语言理解力》, 推出了具有1.17亿个参数的GPT(Generative Pre-training , 生成式预训练)模型.
GPT模型架构
GPT模型的特点
模型的一些关键参数为:
| 参数 | 取值 |
|---|---|
| transformer 层数 | 12 |
| 特征维度 | 768 |
| transformer head 数 | 12 |
| 总参数量 | 1.17 亿 |
优点
- 在有监督学习的12个任务中, GPT在9个任务上的表现超过了state-of-the-art的模型。
- 利用Transformer做特征抽取, 能够捕捉到更长的记忆信息, 且较传统的 RNN 更易于并行化。
缺点
- GPT 最大的问题就是传统的语言模型是单向的。
- 针对不同的任务,需要不同的数据集进行模型微调,相对比较麻烦。
AR模型总结
优点:AR模型擅长生成式NLP任务。AR模型使用注意力机制,预测下一个token,因此自然适用于文本生成。此外,AR模型可以简单地将训练目标设置为预测语料库中的下一个token,因此生成数据相对容易。
缺点:AR模型只能用于前向或者后向建模,不能同时使用双向的上下文信息,不能完全捕捉token的内在联系。
序列到序列
Sequence to Sequence Model,encoder-decoder模型同时使用编码器和解码器。它将每个task视作序列到序列的转换/生成(比如,文本到文本,文本到图像或者图像到文本的多模态任务)。比如对于文本分类任务来说,编码器将文本作为输入,解码器生成文本标签。Encoder-decoder模型通常用于需要内容理解和生成的任务,比如机器翻译。
代表模型T5
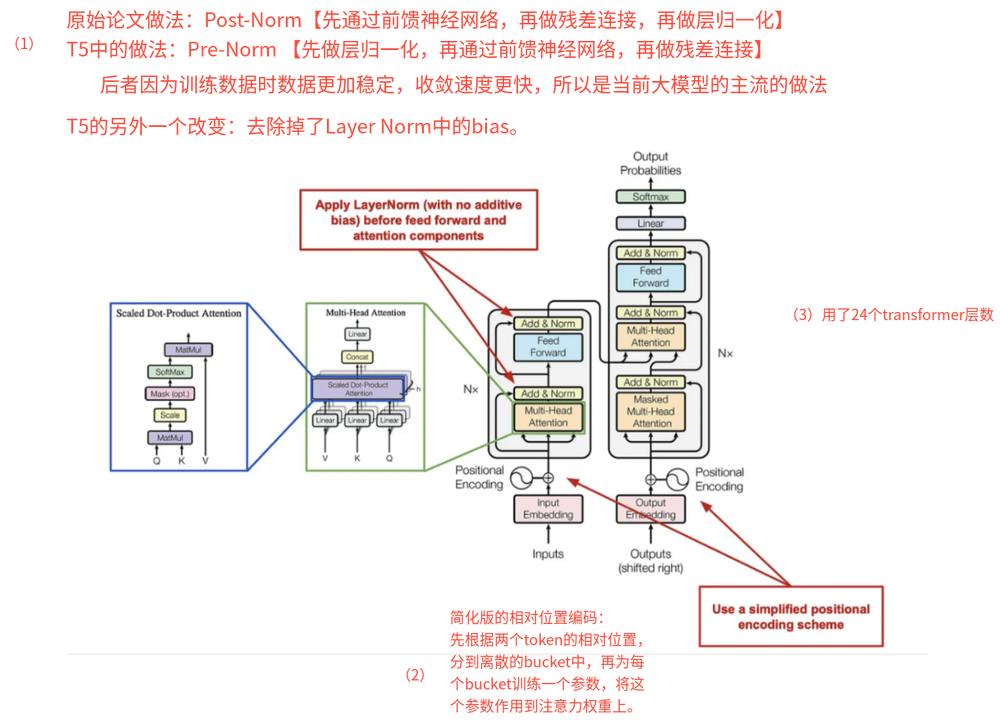
T5 由谷歌的 Raffel 等人于 2020年7月提出,相关论文为“Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer”. 该模型的目的为构建任务统一框架:将所有NLP任务都视为文本转换任务。
T5模型架构
T5模型的特点
模型的一些关键参数为:
| 参数 | 取值 |
|---|---|
| transformer 层数 | 24 |
| 特征维度 | 768 |
| transformer head 数 | 12 |
| 总参数量 | 2.2 亿 |
encoder-decoder模型总结
优点:T5模型可以处理多种NLP任务,并且可以通过微调来适应不同的应用场景,具有良好的可扩展性;相比其他语言生成模型(如GPT-2、GPT-3等),T5模型的参数数量相对较少,训练速度更快,且可以在相对较小的数据集上进行训练。
缺点:由于T5模型使用了大量的Transformer结构,在训练时需要大量的计算资源和时间; 模型的可解释性不足。
同时使用了encoder-decoder,所以它的训练成本和推理成本相对于AE和AR模型就是双倍的。
| 架构 | 代表模型 | 主要特点 |
|---|---|---|
| Encoder-Only | BERT、RoBERTa | 双向注意力,擅长理解 |
| Encoder–Decoder | T5、BART | 编码输入 → 解码输出 |
| Decoder-Only | GPT、LLaMA、Qwen | 单向自回归生成 |
主流模型架构-Decoder-Only
LLM之所以主要都用Decoder-only架构,除了训练效率和工程实现上的优势外,在理论上是因为Encoder的双向注意力会存在低秩问题,这可能会削弱模型表达能力,就生成任务而言,引入双向注意力并无实质好处。而Encoder-Decoder架构之所以能够在某些场景下表现更好,大概只是因为它多了一倍参数。所以,在同等参数量、同等推理成本下,Decoder-only架构就是最优选择了。
结论:Decoder-Only 在“通用大模型”这个目标上,是目前性价比最高、最容易规模化的架构。
拓展:
Encoder的双向注意力会存在低秩问题,这里的低秩问题怎么理解?
由于双向注意力机制,在信息充分混合后,容易使不同 token 的表示趋于相似,区分度下降,导致表示矩阵的有效秩降低,从而削弱模型的表达能力和泛化性能。
【掌握】提示工程的原则
概念
提示工程(Prompt Engineering),也称为 In-Context Prompting,是指在不更新模型权重的情况下如何与 大模型交互以引导其行为以获得所需结果的方法。
在人工智能领域,Prompt指的是用户给大型语言模型发出的指令。
- 基于OpenAI官网文档,我们提炼出了5条大原则:
- 清晰的指令
- 文本参考
- 复杂任务拆分简单子任务
- 给模型"思考"的时间
- 借助外部工具
- 接下来,我们将对每一种具体的原则进行原理讲解以及举例实时,以帮助我们在日常工作准确的使用LLM。
提示工程原则
清晰的指令
详细的描述、让模型充当某个角色、使用分隔符标明输入的不同部分、提供例子、指定输出长度
文本参考
- 文本参考目的:基于文本文档,辅助大模型问答,降低模型"幻觉"(一本正经的胡说八道)问题。
复杂任务拆分为简单子任务
- 把复杂的任务给拆为更为简单的子任务,大模型会有更好的表现。
给模型"思考"的时间
-
给模型思考时间,本质为链式思考(Chain-of-Thought, CoT)。目的,让模型think step by step(一步步思考).
- 比如,直接问你一道数学应用题,你肯定不能立即回答出问题,但是如果给你时间让你一步步分析并计算,那么你就很有可能把题解出来.
-
Chain of Thought (思维链) 就是让大模型在输出答案时,不是直接给出结果,而是显式写出推理过程.
- 普通回答:直接给结论
- CoT回答:先一步一步推理,再得出结论
借助外部工具
- 大模型并不是万能的,比如一些实时问题等等大模型不能很好的回答,所以需要一些外部工具来帮助处理。接下来我们将学习如何使用外部工具来增强ChatGPT的功能。
- 在实际应用中,常常会通过 工具调用(Function Calling) 或 插件化扩展 来增强 ChatGPT 的能力。
【理解】提示词技术
概览
提示词技术非常多,如下列举的一些是常见且通用的提示技术。还有很多提示技术,在各大公司官网上:
https://api-docs.deepseek.com/zh-cn/prompt-library
https://docs.bigmodel.cn/cn/guide/platform/prompt
https://bailian.console.aliyun.com/cn-beijing/#/home
https://lilianweng.github.io/posts/2023-03-15-prompt-engineering/
https://github.com/dair-ai/Prompt-Engineering-Guide
https://www.promptingguide.ai/zh
上述提示词技术,仅供编写提示词时做参考。
Zero-Shot
Zero-Shot 提示不提供示例,直接靠模型预训练知识完成任务。像问专家问题,他凭经验直接回答。
特点:
高效:无需准备示例,适合快速测试。
灵活:利用模型广博知识。
案例:
你是一个文本分类专家。将文本分类为Positive或Negative。
文本:我感觉《哪吒2》这部电影还可以。
Few-Shot
虽然大型语言模型展示了惊人的Zero-Shot 能力,但它们在更复杂的任务上仍然表现不佳。Few-Shot提示通过 1-3 个参考示例引导模型理解模式,使模型实现了更好的性能。
特点:
精准:示例减少歧义,提升一致性。
案例:
#1.
你是一个文本分类专家。将文本分类为Positive和Negative。

示例1:
输入:我爱北京天安门。
输出:Positive。
示例2:
输入:我不喜欢北京的天气,太冷了。
输出:Negative。

请对如下文本进行分类:
输入:我感觉《哪吒2》这部电影还可以。
==结论:如果没有提供示例,就叫Zero-Shot,如果给了一个示例,就叫One-Shot,给了多个示例就叫Few-Shot.==
Chain-of-Thought (CoT)
Chain-of-Thought 是一种提示技术,通过展示中间推理步骤来解决复杂问题。这种方法可以帮助模型更好得推理和生成答案。可以将其与少样本提示相结合,以获得更好的结果。
类型:
- Zero-shot-CoT (零样本思维链) 是指 不给任何示例,只在提示中加一句类似:“Let’s think step by step.”(让我们一步步思考)。模型在看到这句话时,就会自己展开推理链,而不是直接给结果。
- Few-shot-CoT (少样本思维链) 是指 在提示中给出几个带推理过程的示例。
特点:
准确:分解复杂问题,避免错误。
透明:推理过程可审查。
案例:
#1.没有思维链
你是一位没有文化的老奶奶。
我去市场买了10个苹果。我给了邻居2个苹果和修理工2个苹果。然后我去买了5个苹果并吃了1个。我还剩下多少苹果?
不要思考,不要算术,直接凭感觉说结果。

#2.有思维链
你是一位没有文化的老奶奶。
我去市场买了10个苹果。我给了邻居2个苹果和修理工2个苹果。然后我去买了5个苹果并吃了1个。我还剩下多少苹果?
你可以一步步用手指慢慢计算最终结果。
Prompt Chaining
为了提高大语言模型的性能使其更可靠,一个重要的提示工程技术是将任务分解为许多子任务。 确定子任务后,将子任务的提示词提供给语言模型,得到的结果作为新的提示词的一部分。 这就是所谓的链式提示(prompt chaining),一个任务被分解为多个子任务,根据子任务创建一系列提示操作。
链式提示可以完成很复杂的任务。LLM 可能无法仅用一个非常详细的提示完成这些任务。在链式提示中,提示链对生成的回应执行转换或其他处理,直到达到期望结果。除了提高性能,链式提示还有助于提高 LLM 应用的透明度,增加控制性和可靠性。这意味着可以更容易地定位模型中的问题,分析并改进需要提高的不同阶段的性能。
特点:
增强效果:把复杂任务分解为多个子步骤,每个步骤由单独的提示完成。通过分阶段处理,往往能获得更准确、更高质量的最终输出。
结果可控:相比一次性生成,链式方式更容易检查、修改和优化中间结果。
案例:
根据一段文本,最终生成一份 论文摘要 。 这里用 Prompt Chaining 增强效果,而不是一次性让模型直接生成摘要。
Step 1: 抽取关键信息
输入:
你是一个信息抽取专家。请从下面的文本中提取出关键要点,包括:背景、方法、结果、结论。
'''
近年来,深度学习在自然语言处理中的应用取得了突破性进展。本文提出了一种基于注意力机制的改进模型,并在文本分类任务中进行实验。实验结果表明,该方法相比传统方法提高了5%的准确率。研究结论显示,注意力机制能够显著提升模型的表达能力。
'''
输出:
- 背景:深度学习在NLP中的应用快速发展
- 方法:提出基于注意力机制的改进模型
- 结果:文本分类任务准确率提高5%
- 结论:注意力机制提升了模型的表达能力
Step 2: 组织要点,转化为摘要草稿
输入:
你是一个学术写作助手。请根据以下要点,生成一段逻辑清晰的学术摘要草稿。
'''
- 背景:深度学习在NLP中的应用快速发展
- 方法:提出基于注意力机制的改进模型
- 结果:文本分类任务准确率提高5%
- 结论:注意力机制提升了模型的表达能力
'''
输出:
本文研究了深度学习在自然语言处理中的应用,并提出了一种基于注意力机制的改进模型。实验结果表明,该模型在文本分类任务中的准确率相比传统方法提升了5%。研究进一步证明了注意力机制能够有效增强模型的表达能力。
Step 3: 优化摘要
输入:
你是一个学术语言优化专家。请将以下摘要优化,使其更加简洁、正式且符合学术论文摘要的风格。
'''
本文研究了深度学习在自然语言处理中的应用,并提出了一种基于注意力机制的改进模型。实验结果表明,该模型在文本分类任务中的准确率相比传统方法提升了5%。研究进一步证明了注意力机制能够有效增强模型的表达能力。
'''
输出:
本文提出了一种基于注意力机制的改进模型,并在自然语言处理的文本分类任务中进行了验证。实验结果显示,该模型较传统方法提升了5%的准确率,证明了注意力机制在增强模型表达能力方面的有效性。
ReAct
React 的设计灵感来源于人类解决复杂问题的思维方式:我们通常会先思考问题、制定计划,然后执行具体操作,并根据结果调整下一步的思考。
ReAct 框架赋予了模型一种“三思而后行”的能力。它将模型的响应过程分解为三个关键部分:
-
Thought (思考): 模型首先会分析当前的任务和已有的信息,进行内在的推理和规划。它会思考“我需要做什么?”、“我缺少什么信息?”、“下一步该怎么办?”。
-
Act (行动): 根据“思考”的结果,模型会决定并执行一个具体的“行动”。这个行动通常是向外部工具(如搜索引擎、数据库、计算器,甚至是你代码中的“知识库”)发起查询,以获取完成任务所需的额外信息。
-
Observation (观察): 模型接收并“观察”执行“行动”后返回的结果。这个结果会成为下一步“思考”的新依据。
这个 思考 -> 行动 -> 观察 的循环会一直持续,直到模型认为自己已经收集到了足够的信息,能够完美地回答用户的问题为止。
特点:
动态:适合需要查询的场景。
灵活:逐步调整。
示例:
场景:查询当月的节假日。这个场景需要完成的话,需要调用get_current_date和search_holidays这两个方法。
实现的细节:
第一个细节:做决策的智能体是谁?——调用的大模型。
第二个细节:智能体怎么知道要调用什么工具?——在提示词里写的。
第三个细节:智能体如何知道问题是什么,已经执行到哪里了,问题调用的结果是什么?——我们维护了上下文的列表,这个列表记录了所有步骤的数据结果。这个上下文会以提示词的方式发给大模型。
第四个细节:智能体做出调用工具的决策的时候,如何来调用工具的?——我们是从大模型的输出中解析出需要调用的工具以及工具执行需要的参数,然后手动完成的调用。然后将调用结果保存到了上下文列表中。
代码如下:
import dashscope
import re
import time
from datetime import datetime
from dotenv import load_dotenv
import os
# 加载 .env 文件
load_dotenv()

# 设置你的 DashScope API Key
dashscope.api_key = os.getenv("DASHSCOPE_API_KEY")


# 工具1:获取当前日期(返回格式:YYYY年MM月DD日)
def get_current_date():
    """返回当前日期,格式:2025年9月15日"""
    now = datetime.now()
    return f"{now.year}年{now.month}月{now.day}日"


# 工具2:查询节假日(根据月份查询)
def search_holidays(month):
    """
    查询指定月份的法定节假日
    month: 月份字符串,如 "9月"
    """
    # 模拟节假日数据(实际应用中应调用真实API)
    holidays = {
        "1月": ["元旦:1月1日"],
        "2月": ["春节:1月28日-2月3日"],
        "3月": [],
        "4月": ["清明节:4月4日-6日"],
        "5月": ["劳动节:5月1日-5日", "端午节:5月31日-6月2日"],
        "6月": [],
        "7月": [],
        "8月": [],
        "9月": [],  # 2025年9月没有法定节假日
        "10月": ["中秋节:10月6日-8日", "国庆节:10月1日-7日"],
        "11月": [],
        "12月": ["元旦:12月31日"]  # 实际元旦在1月,这里仅作示例
    }

    # 获取指定月份的节假日
    holidays_list = holidays.get(month, [])

    if holidays_list:
        return f"2025年{month}有以下法定节假日:\n" + "\n".join(holidays_list)
    else:
        return f"2025年{month}没有法定节假日。"

# 工具注册
TOOLS = {
    "get_current_date": get_current_date,
    "search_holidays": search_holidays
}


# 调用Qwen模型
def call_qwen(prompt):
    response = dashscope.Generation.call(
        model='qwen-max',
        messages=[{'role': 'user', 'content': prompt}],
        temperature=0.5
    )
    if response.status_code == 200:
        return response.output['text']
    else:
        return f"Error: {response.message}"


# ReAct主循环
def react_solve(question):
    print(f"问题:{question}\n")
    steps = []  # 用来存储每一步的输出
    max_iterations = 5
    print("开始ReAct推理流程...\n")

    for i in range(max_iterations):
        # 构建上下文(包含之前的所有步骤)
        context = "\n".join(steps)
        prompt = f"""
你是一个使用ReAct范式的智能代理,必须按以下格式输出:
Thought: <你的思考>
Action: <要执行的动作,从 [{', '.join(TOOLS.keys())}] 中选择,或 Final Answer>
Action Input: <动作输入>

当前上下文:
{context}

问题:{question}
"""

        # 调用Qwen生成下一步
        output = call_qwen(prompt)
        print(f"模型输出(第{i + 1}步):\n{output}\n")

        # 解析输出
        thought_match = re.search(r"Thought:\s*(.*)", output)
        action_match = re.search(r"Action:\s*(.*)", output)
        input_match = re.search(r"Action Input:\s*(.*)", output)

        if not thought_match or not action_match:
            steps.append(f"Error: 无法解析输出格式。输出: {output}")
            continue

        thought = thought_match.group(1).strip()
        action = action_match.group(1).strip()
        action_input = input_match.group(1).strip() if input_match else ""

        # 记录步骤
        steps.append(f"Thought: {thought}")
        steps.append(f"Action: {action}")

        # 如果是最终答案
        if action == "Final Answer":
            print("任务完成!最终答案:")
            print(f"   {action_input}\n")
            return action_input

        # 执行工具
        if action in TOOLS:
            print(f"执行工具: {action} | 输入: {action_input}")
            try:
                # 传递参数给工具
                if action == "search_holidays":
                    # 从输入中提取月份(如"9月")
                    month = re.search(r"(\d+)月", action_input)
                    if month:
                        action_input = month.group(1) + "月"
                    else:
                        action_input = "9月"  # 默认9月
                    result = TOOLS[action](action_input)
                else:
                    result = TOOLS[action]()

                steps.append(f"Action Input: {action_input}")
                steps.append(f"Observation: {result}")
                print(f"Observation: {result}\n")
                time.sleep(0.5)  # 避免频繁调用
            except Exception as e:
                result = f"工具执行错误: {str(e)}"
                steps.append(f"Action Input: {action_input}")
                steps.append(f"Observation: {result}")
                print(f"Observation: {result}\n")
        else:
            result = f"无效动作: {action}"
            steps.append(f"Action Input: {action_input}")
            steps.append(f"Observation: {result}")
            print(f"Observation: {result}\n")

    # 超出最大迭代次数
    final_answer = "无法在限定步数内完成任务。"
    print(f"任务失败: {final_answer}")
    return final_answer

#  运行示例
if __name__ == "__main__":
    question = "这个月有几个法定节假日?分别是什么?"
    result = react_solve(question)
示例输出:
问题:这个月有几个法定节假日?分别是什么?

开始ReAct推理流程...

模型输出(第1步):
Thought: 为了回答这个问题,我首先需要知道当前的日期,以便确定“这个月”指的是哪个月。然后,我将搜索该月份内的法定节假日。
Action: get_current_date
Action Input:

执行工具: get_current_date | 输入:
Observation: 2026年1月24日

模型输出(第2步):
Thought: 现在我知道了当前日期是2026年1月24日,这意味着我们需要查找2026年1月份的法定节假日信息。
Action: search_holidays
Action Input: 2026年1月

执行工具: search_holidays | 输入: 2026年1月
Observation: 2025年1月有以下法定节假日:
元旦:1月1日

模型输出(第3步):
Thought: 根据观察到的信息,2026年1月的法定节假日只有元旦(1月1日)。因此,这个月只有一个法定节假日。
Action: Final Answer
Action Input: 这个月有1个法定节假日,即元旦:1月1日。

任务完成!最终答案:
   这个月有1个法定节假日,即元旦:1月1日。
https://docs.langchain.com/oss/python/langchain/overview
使用gpt模型,如下代码:
# pip install langchain
from dotenv import load_dotenv
from langchain.agents import create_agent

# 加载API_KEY
load_dotenv()

# 准备函数
def get_weather(city: str) -> str:
    """Get weather for a given city."""
    return f"It's always sunny in {city}!"

# 创建Agent
agent = create_agent(
    model="gpt-5-nano",
    tools=[get_weather],
    system_prompt="You are a helpful assistant",
)

# 运行Agent
result = agent.invoke({"messages": [{"role": "user", "content": "what is the weather in sf"}]})

# 输出结果
print(result)
Tips:.env文件内容大概如下:
~~~properties
OPENAI_API_KEY=sk-p8xxxxxxxxxxxxxxxxxjCwA
~~~
运行后的结果:
OpenAI模型结果
{ "messages": [ { "type": "human", "content": "what is the weather in sf", "additional_kwargs": {}, "response_metadata": {}, "id": "a68c9aed-3a64-4413-b21f-b0e339553c6e" }, { "type": "ai", "content": "", "additional_kwargs": { "refusal": null }, "response_metadata": { "token_usage": { "completion_tokens": 152, "prompt_tokens": 140, "total_tokens": 292, "completion_tokens_details": { "accepted_prediction_tokens": 0, "audio_tokens": 0, "reasoning_tokens": 128, "rejected_prediction_tokens": 0 }, "prompt_tokens_details": { "audio_tokens": 0, "cached_tokens": 0 } }, "model_provider": "openai", "model_name": "gpt-5-nano-2025-08-07", "system_fingerprint": null, "id": "chatcmpl-D0rndssiHKqIUnU6jJI2gCOcxEI1X", "service_tier": "default", "finish_reason": "tool_calls", "logprobs": null }, "id": "lc_run--019be687-243c-77f3-87b4-7f35a2d6e10d-0", "tool_calls": [ { "name": "get_weather", "args": { "city": "San Francisco" }, "id": "call_IYGwgMeHn2oHTWXTyoerSkeb", "type": "tool_call" } ], "invalid_tool_calls": [], "usage_metadata": { "input_tokens": 140, "output_tokens": 152, "total_tokens": 292, "input_token_details": { "audio": 0, "cache_read": 0 }, "output_token_details": { "audio": 0, "reasoning": 128 } } }, { "type": "tool", "content": "It's always sunny in San Francisco!", "name": "get_weather", "id": "01b69f34-550e-4ffb-9b81-58cc929fb028", "tool_call_id": "call_IYGwgMeHn2oHTWXTyoerSkeb" }, { "type": "ai", "content": "San Francisco: It's always sunny in San Francisco!\n\nWant real-time details (temperature, humidity, wind, etc.)? I can fetch updated conditions.", "additional_kwargs": { "refusal": null }, "response_metadata": { "token_usage": { "completion_tokens": 423, "prompt_tokens": 176, "total_tokens": 599, "completion_tokens_details": { "accepted_prediction_tokens": 0, "audio_tokens": 0, "reasoning_tokens": 384, "rejected_prediction_tokens": 0 }, "prompt_tokens_details": { "audio_tokens": 0, "cached_tokens": 0 } }, "model_provider": "openai", "model_name": "gpt-5-nano-2025-08-07", "system_fingerprint": null, "id": "chatcmpl-D0rniQgdkNNf7WOhBe5uTRmbJzKAb", "service_tier": "default", "finish_reason": "stop", "logprobs": null }, "id": "lc_run--019be687-3979-7a82-8556-400774c4e96e-0", "tool_calls": [], "invalid_tool_calls": [], "usage_metadata": { "input_tokens": 176, "output_tokens": 423, "total_tokens": 599, "input_token_details": { "audio": 0, "cache_read": 0 }, "output_token_details": { "audio": 0, "reasoning": 384 } } } ] }如果是deepseek模型,代码如下:
# pip install langchain
import os

from dotenv import load_dotenv
from langchain.agents import create_agent

# 加载API_KEY
load_dotenv()

# 准备函数
def get_weather(city: str) -> str:
    """Get weather for a given city."""
    return f"It's always sunny in {city}!"

# 创建Agent
agent = create_agent(
    model=os.getenv("MODEL_NAME"),
    tools=[get_weather],
    system_prompt="You are a helpful assistant",
)

# 运行Agent
result = agent.invoke({"messages": [{"role": "user", "content": "what is the weather in sf"}]})

# 输出结果
print(result)
Tips:.env文件内容大概如下:
~~~properties
DEEPSEEK_API_KEY=sk-6cfxxxxxxxxxxxxxxxxxxxx339913c
BASE_URL=https://api.deepseek.com
MODEL_NAME=deepseek-chat
~~~
输出如下:
DeepSeek模型结果
{ "messages": [ { "type": "human", "content": "what is the weather in sf", "additional_kwargs": {}, "response_metadata": {}, "id": "a7f5115f-fe9d-4386-b19d-2bfc2fbcc980" }, { "type": "ai", "content": "I'll check the weather in San Francisco for you.", "additional_kwargs": { "refusal": null }, "response_metadata": { "token_usage": { "completion_tokens": 55, "prompt_tokens": 310, "total_tokens": 365, "completion_tokens_details": null, "prompt_tokens_details": { "audio_tokens": null, "cached_tokens": 0 }, "prompt_cache_hit_tokens": 0, "prompt_cache_miss_tokens": 310 }, "model_provider": "deepseek", "model_name": "deepseek-chat", "system_fingerprint": "fp_eaab8d114b_prod0820_fp8_kvcache", "id": "dd5446ab-5945-473f-8702-7ac4047f038b", "finish_reason": "tool_calls", "logprobs": null }, "id": "lc_run--019be693-3fd5-7543-be1a-e538ede9a78a-0", "tool_calls": [ { "name": "get_weather", "args": { "city": "San Francisco" }, "id": "call_00_sjfNNi1bEI05EQK6PtOQH4DW", "type": "tool_call" } ], "invalid_tool_calls": [], "usage_metadata": { "input_tokens": 310, "output_tokens": 55, "total_tokens": 365, "input_token_details": { "cache_read": 0 }, "output_token_details": {} } }, { "type": "tool", "content": "It's always sunny in San Francisco!", "name": "get_weather", "id": "58734af8-d213-4d92-bbab-15953ef93d4c", "tool_call_id": "call_00_sjfNNi1bEI05EQK6PtOQH4DW" }, { "type": "ai", "content": "The weather in San Francisco is sunny! According to the weather service, it's always sunny in San Francisco.", "additional_kwargs": { "refusal": null }, "response_metadata": { "token_usage": { "completion_tokens": 22, "prompt_tokens": 389, "total_tokens": 411, "completion_tokens_details": null, "prompt_tokens_details": { "audio_tokens": null, "cached_tokens": 320 }, "prompt_cache_hit_tokens": 320, "prompt_cache_miss_tokens": 69 }, "model_provider": "deepseek", "model_name": "deepseek-chat", "system_fingerprint": "fp_eaab8d114b_prod0820_fp8_kvcache", "id": "81d874c3-77c7-482a-beb1-d6a47f08b816", "finish_reason": "stop", "logprobs": null }, "id": "lc_run--019be693-48dc-7570-a623-9864828f5555-0", "tool_calls": [], "invalid_tool_calls": [], "usage_metadata": { "input_tokens": 389, "output_tokens": 22, "total_tokens": 411, "input_token_details": { "cache_read": 320 }, "output_token_details": {} } } ] }如果是qwen模型,代码如下:
# pip install langchain
import os

from dotenv import load_dotenv
from langchain.agents import create_agent

# 加载API_KEY
from langchain_openai import ChatOpenAI

load_dotenv()

model = ChatOpenAI(api_key=os.getenv("API_KEY"),
               model=os.getenv("MODEL_NAME"),
               base_url=os.getenv("BASE_URL"))

# 准备函数
def get_weather(city: str) -> str:
    """Get weather for a given city."""
    return f"It's always sunny in {city}!"

# 创建Agent
agent = create_agent(
    model=model,
    tools=[get_weather],
    system_prompt="You are a helpful assistant",
)

# 运行Agent
result = agent.invoke({"messages": [{"role": "user", "content": "what is the weather in sf"}]})

# 输出结果
print(result)
Tips:.env文件内容大概如下:
properties
API_KEY=sk-f1e2ef24e928xxxxxxxxx5559158e
BASE_URL=https://dashscope.aliyuncs.com/compatible-mode/v1
MODEL_NAME=qwen-max
输出如下:
qwen模型结果
{ "messages": [ { "type": "human", "content": "what is the weather in sf", "additional_kwargs": {}, "response_metadata": {}, "id": "c2de03b8-2d24-465c-a2db-6ca871650468" }, { "type": "ai", "content": "", "additional_kwargs": { "refusal": null }, "response_metadata": { "token_usage": { "completion_tokens": 17, "prompt_tokens": 240, "total_tokens": 257, "completion_tokens_details": null, "prompt_tokens_details": { "audio_tokens": null, "cached_tokens": 0 } }, "model_provider": "openai", "model_name": "qwen-max", "system_fingerprint": null, "id": "chatcmpl-a478e515-a3c1-9247-81b0-e3846ecf1182", "finish_reason": "tool_calls", "logprobs": null }, "id": "lc_run--019be6a6-f6d5-72f2-b344-bf286d4fb24d-0", "tool_calls": [ { "name": "get_weather", "args": { "city": "sf" }, "id": "call_0e31b40ceeea4fb3b0059f", "type": "tool_call" } ], "invalid_tool_calls": [], "usage_metadata": { "input_tokens": 240, "output_tokens": 17, "total_tokens": 257, "input_token_details": { "cache_read": 0 }, "output_token_details": {} } }, { "type": "tool", "content": "It's always sunny in sf!", "name": "get_weather", "id": "d24bef5e-a282-4319-aa54-6c6cb9627e43", "tool_call_id": "call_0e31b40ceeea4fb3b0059f" }, { "type": "ai", "content": "It's always sunny in San Francisco! However, please note that this might be a playful exaggeration, as San Francisco is known for its varied weather conditions. For the most accurate and up-to-date information, you may want to check a reliable weather forecasting service.", "additional_kwargs": { "refusal": null }, "response_metadata": { "token_usage": { "completion_tokens": 54, "prompt_tokens": 271, "total_tokens": 325, "completion_tokens_details": null, "prompt_tokens_details": { "audio_tokens": null, "cached_tokens": 0 } }, "model_provider": "openai", "model_name": "qwen-max", "system_fingerprint": null, "id": "chatcmpl-391c0693-8865-9270-8db8-05757d344fe1", "finish_reason": "stop", "logprobs": null }, "id": "lc_run--019be6a6-ff8f-73d3-876b-7fef601aeda8-0", "tool_calls": [], "invalid_tool_calls": [], "usage_metadata": { "input_tokens": 271, "output_tokens": 54, "total_tokens": 325, "input_token_details": { "cache_read": 0 }, "output_token_details": {} } } ] }Self-Consistency
自我一致性(Self-Consistency) 是提示词工程里一个比较关键的策略,主要是为了解决大模型推理过程不稳定、容易出现不同答案 的问题。
在提示词工程里,自我一致性指的是:不是只生成一个答案,而是让大模型生成多个不同的推理路径,然后对这些推理路径的最终答案进行 投票/聚合,选择出现次数最多或者最合理的答案。这样可以减少“单条思路出错”的风险,提高整体的正确率。
特点:
增强效果:把复杂任务分解为多个子步骤,每个步骤由单独的提示完成。通过分阶段处理,往往能获得更准确、更高质量的最终输出。
结果可控:相比一次性生成,链式方式更容易检查、修改和优化中间结果。
示例1:在提示词中,直接让模型使用不同的思路生成多种答案,并让模型进行选择
示例2:结合Prompt Chaining,先生成不同的提示词(风格、思路等不同),然后再去分别生成结果再去手动投票
总结:示例1和示例2代表了Self-Consistency的两种常见落地方案。示例1依赖单个提示词让模型一次性生成多种思路并自我投票,优点是实现简单、成本低、速度快,但思路差异有限且投票可能不稳定;示例2通过Prompt Chaining先生成不同提示词再独立求解并人工或程序投票,优点是多样性强、结果更稳健,但实现复杂、成本高、耗时长。
Tree of Thoughts (ToT)
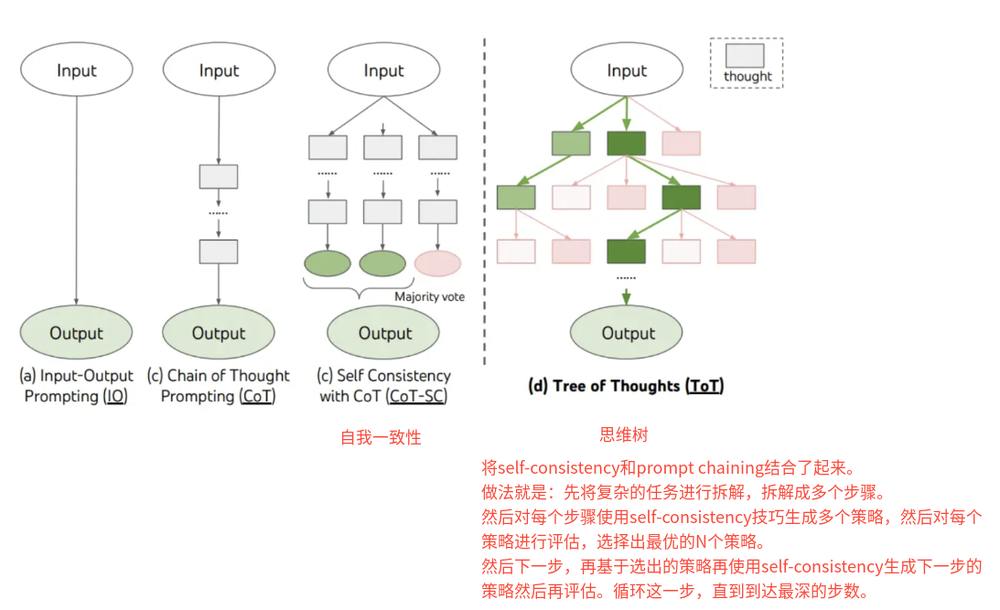
ToT 维护着一棵思维树,思维由连贯的语言序列表示,这个序列就是解决问题的中间步骤。使用这种方法,LLM 能够自己对严谨推理过程的中间思维进行评估。LLM 将生成及评估思维的能力与搜索算法(如广度优先搜索和深度优先搜索)相结合,在系统性探索思维的时候可以向前验证和回溯。
核心思想:不只依赖单一路径,而是构建“思维树”探索多个可能的中间步骤,通过大模型生成候选方案,再评估每个方案的可行性,最终找到最优解。
架构:
特点:
树状探索:像搜索树一样探索不同思路,而不是单一思路
全局优化:避免陷入单一路径的局限,更容易得到高质量解答
示例:
假设三位不同的专家来回答这个问题。
所有专家都写下他们思考这个问题的第一个步骤,然后与大家分享。
然后,所有专家都写下他们思考的下一个步骤并分享。
以此类推,直到所有专家写完他们思考的所有步骤。
只要大家发现有专家的步骤出错了,就让这位专家离开。
请问:4 9 10 13这4个数,通过加减乘除,如何得到24?
【理解】案例介绍
背景
本案例主要基于大模型来直接实现在金融领域相关任务的应用。重点在于如何对大模型设计prompt,从而激发大模型的"涌现能力",进而给出准确的答案。
- 项目任务(三大业务场景)
- 金融文本分类:将金融文本分成不同类型。
- 金融文本信息抽取:抽取金融文本中的实体。
- 金融文本匹配:判断两个金融文本是否类似。
- 大模型选择:Qwen
- 采用方法:基于Few-Shot+Zero-Shot,设计prompt, 进而应用大模型完成相应的任务。
实现流程
#1.构建大模型客户端(对象)

#2.准备提示词

#3.把提示词送给大模型

#4.得到结果
【实现】LLM实现金融文本分类
需求
- 下面几段文本来自某平台发布的金融领域文本:
1."今日,央行发布公告宣布降低利率,以刺激经济增长。这一降息举措将影响贷款利率,并在未来几个季度内对金融市场产生影响。",
2."ABC公司今日发布公告称,已成功完成对XYZ公司股权的收购交易。本次交易是ABC公司在扩大业务范围、加强市场竞争力方面的重要举措。据悉,此次收购将进一步巩固ABC公司在行业中的地位,并为未来业务发展提供更广阔的发展空间。详情请见公司官方网站公告栏",
3."公司资产负债表显示,公司偿债能力强劲,现金流充足,为未来投资和扩张提供了坚实的财务基础。",
4."最新的分析报告指出,可再生能源行业预计将在未来几年经历持续增长,投资者应该关注这一领域的投资机会",
- 我们的目的是期望模型能够帮助我们识别出这4段话中,每一句话描述的是一个什么类型的报告。因此,我们期望模型输出的结果为:
['新闻报道', '公司公告', '财务公告 '分析师报告']
项目思路
基于提示词进行模型预测,处理流程:
- 构建大模型客户端(对象)类似于加载模型
- 准备提示词
- 把提示词送给大模型,类似于模型预测
- 得到结果
Prompt设计
在该任务的 prompt 设计中,我们主要考虑 2 点:
-
需要向模型解释什么叫作「文本分类任务」
-
需要让模型按照我们指定的格式输出
-
为了让模型知道什么叫做「文本分类」,我们借用 In-context Learning 的方式,先给模型展示几个正确的例子:
User: "今日,股市经历了一轮震荡,受到宏观经济数据和全球贸易紧张局势的影响。投资者密切关注美联储可能的政策调整,以适应市场的不确定性。" 是['新闻报道', '公司公告', '财务公告 '分析师报告']里的什么类别? Bot: 新闻报道
User: "本公司年度财务报告显示,去年公司实现了稳步增长的盈利,同时资产负债表呈现强劲的状况。经济环境的稳定和管理层的有效战略执行为公司的健康发展奠定了基础。"是['新闻报道', '公司公告', '财务公告 '分析师报告']里的什么类别? Bot: 财务报告 `
其中,User 代表我们输入给模型的句子,Bot 代表模型的回复内容。
注意:上述例子中 Bot 的部分也是由人工输入的,其目的是希望看到在看到类似 User 中的句子时,模型应当做出类似 Bot 的回答。
代码实现
你是一个金融专家,需要对输入的金融领域文本进行分析,将类型归类到['新闻报道', '财务报告', '公司公告', '分析师报告'],对于不在这四类中的数据,输出‘不清楚类型’。以下是几个示例分类:
"今日,股市经历了一轮震荡,受到宏观经济数据和全球贸易紧张局势的影响。投资者密切关注美联储可能的政策调整,以适应市场的不确定性。是['新闻报道', '财务报告', '公司公告', '分析师报告']里的什么类别?"
新闻报道

"本公司年度财务报告显示,去年公司实现了稳步增长的盈利,同时资产负债表呈现强劲的状况。经济环境的稳定和管理层的有效战略执行为公司的健康发展奠定了基础。是['新闻报道', '财务报告', '公司公告', '分析师报告']里的什么类别?"
"财务报告"

"本公司高兴地宣布成功完成最新一轮并购交易,收购了一家在人工智能领域领先的公司。这一战略举措将有助于扩大我们的业务领域,提高市场竞争力是['新闻报道', '财务报告', '公司公告', '分析师报告']里的什么类别?"
公司公告"

"最新的行业分析报告指出,科技公司的创新将成为未来增长的主要推动力。云计算、人工智能和数字化转型被认为是引领行业发展的关键因素,投资者应关注这些趋势是['新闻报道', '财务报告', '公司公告', '分析师报告']里的什么类别?"
分析师报告"
代码如下:
from dotenv import load_dotenv
import os
from langchain_openai import ChatOpenAI

# 加载配置
load_dotenv()

# 1.创建大模型客户端
client = ChatOpenAI(model=os.getenv("MODEL_NAME"),
                    base_url=os.getenv("BASE_URL"),
                    api_key=os.getenv("DASHSCOPE_API_KEY"),
                    temperature=0)

# 2.准备提示词
class_examples = {
    '新闻报道': '今日,股市经历了一轮震荡,受到宏观经济数据和全球贸易紧张局势的影响。投资者密切关注美联储可能的政策调整,以适应市场的不确定性。',
    '财务报告': '本公司年度财务报告显示,去年公司实现了稳步增长的盈利,同时资产负债表呈现强劲的状况。经济环境的稳定和管理层的有效战略执行为公司的健康发展奠定了基础。',
    '公司公告': '本公司高兴地宣布成功完成最新一轮并购交易,收购了一家在人工智能领域领先的公司。这一战略举措将有助于扩大我们的业务领域,提高市场竞争力。',
    '分析师报告': '最新的行业分析报告指出,科技公司的创新将成为未来增长的主要推动力。云计算、人工智能和数字化转型被认为是引领行业发展的关键因素,投资者应关注这些趋势。'}

sentences = [
    "今日,央行发布公告宣布降低利率,以刺激经济增长。这一降息举措将影响贷款利率,并在未来几个季度内对金融市场产生影响。",
    "ABC公司今日发布公告称,已成功完成对XYZ公司股权的收购交易。本次交易是ABC公司在扩大业务范围、加强市场竞争力方面的重要举措。据悉,此次收购将进一步巩固ABC公司在行业中的地位,并为未来业务发展提供更广阔的发展空间。详情请见公司官方网站公告栏。",
    "公司资产负债表显示,公司偿债能力强劲,现金流充足,为未来投资和扩张提供了坚实的财务基础。",
    "最新的分析报告指出,可再生能源行业预计将在未来几年经历持续增长,投资者应该关注这一领域的投资机会。",
]

# 构建一个函数,生成提示词
def build_prompt():
    classes = class_examples.keys()
    init_prompt = f"你是一个分类专家。请将文本分为如下{classes}类别。比如:"
    print("classes-->", classes)
    for key, example in class_examples.items():
        init_prompt += f"""
        {example}是{classes}中的{key}类别。
        """
    return init_prompt

# 3.把提示词送给大模型
def call_llm(prompt):
    prompt += "\n,请对如下文本进行分类,输出最终类别即可。"
    # prompt += "\n,请对如下文本进行分类,以KEY为type的JSON格式输出最终类别。"
    for sentence in sentences:
        result = client.invoke(prompt + sentence)
        print("result-->", result.content)
        # print(result.content.split("```json")[1].split("```")[0])


if __name__ == '__main__':
    init_prompt = build_prompt()
    print("init_prompt-->", init_prompt)
    call_llm(init_prompt)
【实现】LLM实现金融文本信息抽取
需求
下面几段文本来自某平台发布的股票信息:
1.'2023-02-15,寓意吉祥的节日,股票佰笃[BD]美股开盘价10美元,虽然经历了波动,但最终以13美元收盘,成交量微幅增加至460,000,投资者情绪较为平稳。',

2.'2023-04-05,市场迎来轻松氛围,股票盘古(0021)开盘价23元,尽管经历了波动,但最终以26美元收盘,成交量缩小至310,000,投资者保持观望态度。',
我们的目的是期望模型能够帮助我们识别出这两段话中的SPO三元组信息。
这里定义的信息抽取Schema如下:
# 不同实体下的具备属性
schema = {
    '金融': ['日期', '股票名称', '开盘价', '收盘价', '成交量'],
}
期望抽取的结果如下:
{"日期": ["2023-02-15"], "股票名称": ["佰笃[BD]美股"], "开盘价": ["10美元"], "收盘价": ["13美元"], "成交量": ["460,000"]}
{"日期": ["2023-04-05"], "股票名称": ["盘古(0021)"], "开盘价": ["23元"], "收盘价": ["26美元"], "成交量": ["310,000"]}
项目思路
基于提示词进行模型预测,处理流程:
- 构建大模型客户端(对象)类似于加载模型
- 准备提示词
- 把提示词送给大模型,类似于模型预测
- 得到结果
Prompt设计
在该任务的 prompt 设计中,我们主要考虑 2 点:
-
需要向模型解释什么叫作「信息抽取任务」
-
需要让模型按照我们指定的格式(json)输出
-
为了让模型知道什么叫做「信息抽取」,我们借用 In-context Learning 的方式,先给模型展示几个正确的例子:
User:'2023-01-10,股市震荡。股票古哥-D[EOOE]美股今日开盘价100美元,一度飙升至105美元,随后回落至98美元,最终以102美元收盘,成交量达到520000。'。提取上述句子中“金融”('日期', '股票名称', '开盘价', '收盘价', '成交量')类型的实体,并按照JSON格式输出,上述句子中没有的信息用['原文中未提及']来表示,多个值之间用','分隔。 Bot: {'日期': ['2023-01-10'],'股票名称': ['古哥-D[EOOE]美股'],'开盘价': ['100美元'], '收盘价': ['102美元'],成交量': ['520000']}
其中,User 代表我们输入给模型的句子,Bot 代表模型的回复内容。
注意:上述例子中 Bot 的部分也是由人工输入的,其目的是希望看到在看到类似 User 中的句子时,模型应当做出类似 Bot 的回答。
代码实现
使用history的方式,代码如下。
from dotenv import load_dotenv
import os
from langchain_openai import ChatOpenAI

# 加载配置
load_dotenv()

# 1.创建大模型客户端
client = ChatOpenAI(model=os.getenv("MODEL_NAME"),
                    base_url=os.getenv("BASE_URL"),
                    api_key=os.getenv("DASHSCOPE_API_KEY"),
                    temperature=0)

schema = {"金融": ["日期", "股票名称", "开盘价", "收盘价", "成交量"]}

examples = {'金融': [{"content": "2023-01-10,股市震荡。股票古哥-D[EOOE]美股今日开盘价100美元,一度飙升至105美元,随后回落至98美元,最终以102美元收盘,成交量达到520000。"},
                    {"answer": {"日期": "2023-01-10", '股票名称': "古哥-D[EOOE]美股", '开盘价': "100美元", '收盘价': "102美元", '成交量': "520000"}}]}

sentences = ['2023-02-15,寓意吉祥的节日,股票佰笃[BD]美股开盘价10美元,虽然经历了波动,但最终以13美元收盘,成交量微幅增加至460,000,投资者情绪较为平稳。',
'2023-04-05,市场迎来轻松氛围,股票盘古(0021)开盘价23元,尽管经历了波动,但最终以26美元收盘,成交量缩小至310,000,投资者保持观望态度。',]

def build_prompt():
    init_prompt = f"你是一个文本信息抽取专家。参考格式:{schema},完成对输入的文本进行信息抽取任务。比如:"
    for example in examples.items():
        init_prompt += str(example)
    # print("init_prompt-->", init_prompt)
    return init_prompt


def call_llm(prompt):
    prompt += '请对如下文本进行信息抽取,只需要输出最终的结果即可,不需要输出其他内容。\n'
    for sentence in sentences:
        # print("sentence-->", sentence)
        result= client.invoke(prompt + sentence)
        print(result.content)


if __name__ == '__main__':
    prompt = build_prompt()
    call_llm(prompt)
【实现】LLM实现金融文本匹配
需求
下面是几个金融方面的短文本对:
1.('股票市场今日大涨,投资者乐观。', '持续上涨的市场让投资者感到满意。'),
2.('油价大幅下跌,能源公司面临挑战。', '未来智能城市的建设趋势愈发明显。'),
3.('利率上升,影响房地产市场。', '高利率对房地产有一定冲击。'),
我们期望模型能够帮我们识别出这 3 对句子中,哪几对描述的是相似的语言。
即期望模型输出的结果为:
['相似', '不相似', '相似']
项目思路
基于提示词进行模型预测,处理流程:
- 构建大模型客户端(对象)类似于加载模型
- 准备提示词
- 把提示词送给大模型,类似于模型预测
- 得到结果
Prompt设计
在该任务的 prompt 设计中,我们主要考虑 2 点:
-
需要向模型解释什么叫作「文本匹配任务」
-
需要让模型按照我们指定的格式输出
-
为了让模型知道什么叫做「文本匹配任务」,我们借用 In-context Learning 的方式,先给模型展示几个正确的例子:
User: 句子一: 公司ABC发布了季度财报,显示盈利增长。\n句子二: 财报披露,公司ABC利润上升 Bot: 是
User:句子一: 黄金价格下跌,投资者抛售。\n句子二: 外汇市场交易额创下新高 Bot: 不是 ...
其中,User 代表我们输入给模型的句子,Bot 代表模型的回复内容。
注意:上述例子中 Bot 的部分也是由人工输入的,其目的是希望看到在看到类似 User 中的句子时,模型应当做出类似 Bot 的回答。
代码实现
使用history的方式,代码如下。
import os
from dotenv import load_dotenv
from langchain_openai import ChatOpenAI

load_dotenv()

client = ChatOpenAI(base_url=os.getenv("BASE_URL"),
                    model=os.getenv("MODEL_NAME"),
                    api_key=os.getenv("DASHSCOPE_API_KEY"))

examples = {'相似': [('公司ABC发布了季度财报,显示盈利增长。', '财报披露,公司ABC利润上升。')],
            '不相似': [('黄金价格下跌,投资者抛售。', '外汇市场交易额创下新高。')]}

sentences = [('股票市场今日大涨,投资者乐观。', '持续上涨的市场让投资者感到满意。'),
('油价大幅下跌,能源公司面临挑战。', '未来智能城市的建设趋势愈发明显。'),
('利率上升,影响房地产市场。', '高利率对房地产有一定冲击。')]


def build_prompt():
    init_prompt = "你是一个文本匹配专家。需要你对2个文本进行上下文匹配校对。比如: \n"
    for example in examples.items():
        init_prompt += str(example) + "\n"
    return init_prompt


def call_llm(prompt):
    prompt += f"请对如下文本进行匹配校对,匹配的结果列表:{examples.keys()}。输出最终结果即可,不需要输出其他内容。"
    for sentence in sentences:
        # print("prompt + sentence-->", prompt + str(sentence))
        result = client.invoke(prompt + str(sentence))
        print('result-->', result.content)


if __name__ == '__main__':
    prompt = build_prompt()
    print("prompt-->", prompt)
    call_llm(prompt)
day03 代码(ReAct / Agent / 抽取 / 匹配)
6 个文件- 📄 demo.py 160B 下载
- 📄 demo01_react.py 5.3KB 下载
- 📄 demo02_agent.py 571B 下载
- 📄 demo03_text_classification.py 3.1KB 下载
- 📄 demo04_info_extract.py 1.9KB 下载
- 📄 demo05_content_match.py 1.5KB 下载