第 7 节 / 共 8 节
RAG 开发(五):重排与 Query 改写
下午笔记
EduRAG项目
【了解】今日内容介绍
- 文档读取和切分
- bge-m3和reranker模型
- argparse工具
【理解】文档读取与切分
概述
document_processor.py是EduRAG系统的核心模块之一,用于文档解析。主要负责加载多种格式的文档(如.txt、.pdf等),并对其进行分层切分,生成父块和子块,为后续的向量存储和检索做好准备。
OCR工具
# 质谱AI
GLM,OCR

# 百度
paddle OCR

# DeepSeek公司
deepseek OCR

# Google
Gemini OCR

#textin
付费进行图片识别的工具,类似于OCR,但是比OCR好,很好用。
【理解】bge-m3和reranker模型
BGEM3EmbeddingFunction 是 Milvus 向量数据库生态 中的一个类,用于将文本转换为多模态嵌入向量,它封装了 BAAI(智源研究院)发布的 BGE-M3 模型 的推理能力。
它来自库:milvus-model(原 milvus-sdk 的扩展),用于与 Milvus / Zilliz Cloud 等向量数据库无缝集成。
安装方式
pip install milvus-model
基本使用示例
bge-m3
def dm01():
    # BGE-M3 模型本身就是为混合检索设计的,而这个函数则是它在 Milvus 生态中的最佳实践接口。将它和你之前了解的 RRFRanker     # 或 WeightedRanker 结合,就能搭建一个开箱即用且效果优秀的混合搜索系统。
    # BAAI 官方甚至推荐使用 BGE-M3 进行混合检索 + 重排模型 作为 RAG 的标准流程
    from milvus_model.hybrid import BGEM3EmbeddingFunction
    ef = BGEM3EmbeddingFunction()
    texts = ["什么是人工智能?", "iPhone 价格是多少?"]
    embeddings = ef(texts)

    print(embeddings.keys())  # 输出:dict_keys(['dense', 'sparse'])
返回三种向量:
dense: 稠密向量(用于语义相似度)sparse: 稀疏向量(用于关键词匹配)多向量:项目中没有用
rerank
def dm02():
    # WeightedRanker 和 RRFRanker 是 Milvus 进行混合搜索后,用于合并和重排多路召回结果的两种核心策略。它们的核心区别在     # 于:前者让你主动控制不同模态(如图片、文本)的重要性权重,后者则自动平衡各结果,让排序过程更"民主
    # WeightedRanker 加权分数融合
    from pymilvus import WeightedRanker
    rerank= WeightedRanker(0.8, 0.3)

    # RRFRanker 倒数排名融合
    from pymilvus import RRFRanker
    ranker = RRFRanker(100)
混合检索,也叫双路召回。指的是得到粗排的内容。
#1.稀疏向量
速度快,测试精确召回,差准。

#2.稠密向量
语义层面召回,查全。

混合检索(双路召回)得到粗排的内容。
使用rerank模型进行重排序,得到父文档topK上下文。
【了解】argparse工具
argparse 是 Python 标准库中用于解析命令行参数和选项的模块,使用它可以让脚本更灵活、更易于使用。下面是一个简单的使用说明,帮助你快速上手 argparse。
基本结构
import argparse

# 1. 创建解析器
parser = argparse.ArgumentParser(description='简要描述这个脚本的功能')

# 2. 添加参数
parser.add_argument('input', help='输入文件路径')  # 位置参数
parser.add_argument('--output', help='输出文件路径')  # 可选参数
parser.add_argument('--verbose', action='store_true', help='是否输出详细信息')

# 3. 解析参数
args = parser.parse_args()

# 4. 使用参数
print(f"输入文件: {args.input}")
if args.output:
    print(f"输出文件: {args.output}")
if args.verbose:
    print("详细模式已开启")
常见参数类型
位置参数(必须提供)
parser.add_argument('filename', help='输入文件名')
使用方式:python script.py myfile.txt
可选参数(以 -- 开头)
parser.add_argument('--name', help='用户姓名')
使用方式:python script.py --name Alice
带默认值的参数
parser.add_argument('--count', default=1, type=int, help='重复次数(默认1)')
布尔开关(使用 action='store_true')
parser.add_argument('--verbose', action='store_true', help='启用详细输出')
- 如果命令行中包含
--verbose,args.verbose为True,否则为False。
限制取值范围(choices)
parser.add_argument('--mode', choices=['fast', 'slow'], default='fast', help='运行模式')
专题:BGE-Reranker
BGE-Reranker
作为检索增强生成(RAG)流程中的关键组件,重排序模型负责对初步检索的大量候选文档进行精确排序,从而提高下游任务的质量。BGE-Reranker系列凭借其卓越的多语言处理能力和优异的性能表现,已成为当前最受关注的重排序模型之一。
官网:https://github.com/FlagOpen/FlagEmbedding
1、BGE-Reranker系列概述
1.1 开发背景与团队
BGE-Reranker系列模型由北京智源研究院(Beijing Academy of Artificial Intelligence,BAAI)开发,是继其成功推出BGE(BAAI General Embedding)嵌入模型之后的又一力作。该系列模型专注于解决多语言环境下的文档重排序问题,特别是针对中英文混合场景进行了优化。
BGE-Reranker的开发团队由来自北京智源研究院的NLP研究人员组成,他们致力于推动开源语言模型技术的发展。该项目得到了学术界和产业界的广泛关注和支持。
1.2 版本演进
BGE-Reranker系列模型经历了几个主要版本的演进:
-
BGE-Reranker-v1: 初代版本,初步实现了重排序功能,但性能和语言覆盖范围有限。
-
==采用交叉编码器(cross-encoder)架构,能够直接计算查询和文档之间的相关性得分==
-
基于大规模预训练语言模型,具有强大的语义理解能力
-
支持中英双语处理
-
相比嵌入模型,能够获得更高的排序精度
-
专为重排序任务优化,在各项基准测试中表现优异
-
-
BGE-Reranker-v2: 第二代模型,在v1基础上进行了全面升级,包括:
-
采用更强大的多语言预训练模型作为骨干网络
-
引入更高效的训练策略和数据增强技术
-
提供多种尺寸的模型版本,满足不同场景需求
-
-
BGE-Reranker-v2-M3: 当前最新版本,以"M3"命名表示其专注于多语言(Multilingual)、中等规模(Medium-sized)、现代化(Modern)的特点。该版本在模型架构、训练数据、优化策略等方面均有显著改进。
1.3 核心定位与应用场景
BGE-Reranker-v2-M3是一款轻量级多语言交叉编码器(Cross-Encoder),专为以下场景设计:
- 搜索引擎结果重排序:提高搜索结果的相关性和质量
- RAG(检索增强生成)系统:作为处理检索结果的关键组件
- 推荐系统:优化候选项排序,提升推荐准确性
- 问答系统:精确筛选可能包含答案的文档片段
该模型特别适合资源有限但需要高质量多语言处理能力的场景,在与初步检索(如向量检索)结合使用时效果最佳。
2、bge-reranker-large使用
- 加载模型
from sentence_transformers import CrossEncoder

# 加载模型
reranker = CrossEncoder('./bge-reranker-large', device='cuda:0')

# 输入格式必须是二维列表:[[query, document]]
score = reranker.predict([["人工智能的定义是什么?", "人工智能是使机器具有智能行为的技术"]])

print("相关性得分:", score)
输出结果:相关性得分: [0.9984816]
得分范围一般为 0~1,越接近 1 表示越相关。
- 批量重排序(Batch Rerank)
queries = ["什么是机器学习?"]
documents = [
    "机器学习是一种让计算机从数据中自动学习规律的方法。",
    "深度学习是机器学习的一个分支。",
    "今天的天气很好。"
]

pairs = [[queries[0], doc] for doc in documents]
scores = reranker.predict(pairs)
print(f'scores-->{scores}')

# 输出排序结果
for doc, score in sorted(zip(documents, scores), key=lambda x: x[1], reverse=True):
    print(f"{score:.4f} - {doc}")
输出结果:
scores-->[9.9982554e-01 3.1844237e-01 7.6328361e-05]
0.9998 - 机器学习是一种让计算机从数据中自动学习规律的方法。
0.3184 - 深度学习是机器学习的一个分支。
0.0001 - 今天的天气很好。
3、bge-reranker-large和bge-m3对比
| 模型名称 | 模型类型 | 主要用途 | 输入输出 | 特点 |
|---|---|---|---|---|
| bge-reranker-large | Cross-Encoder(重排序模型) | 重排序 / 精排:判断一对文本(query, passage)的相关性 | 输入一对句子 → 输出一个相关性得分(如 0.87) | 精度高,但速度慢;适合在召回后做 rerank |
| bge-m3 | Dual-Encoder + Sparse Hybrid(多模态混合向量模型) | 语义向量表示 / 向量召回 | 输入文本 → 输出 dense 向量(可选 sparse 向量) | 速度快,可用于 Milvus / Faiss 检索;支持稀疏+稠密混合检索 |
晚上笔记
EduRAG项目
【了解】今日内容介绍
- BERT意图识别
- 策略选择
- RAG问答
- RAG评估和优化
- RAG简历编写
【理解】意图识别
Prompt设计
prompts.py定义了RAGPrompts类,负责管理系统中使用的所有Prompt模板。这些模板用于指导大语言模型完成不同任务,例如生成最终答案、假设答案、子查询或简化问题。通过集中管理Prompt,系统能够确保输入的一致性和输出质量。
意图识别
QueryClassifier 是 EduRAG 系统的核心组件,负责将用户查询分为“通用知识”和“专业咨询”两类,以决定查询路由到知识库还是咨询接口。本模块介绍基于 BERT 的优化实现,替换传统 TF-IDF 模型,利用 5000 条混合数据集(training_dataset_hybrid_5000.json)进行训练,并解决评估中的标签处理问题。
【理解】策略选择
概述
strategy_selector.py定义了StrategySelector类,通过调用大语言模型根据用户查询选择最合适的检索策略。支持的策略包括直接检索、HyDE(假设问题检索)、子查询检索和回溯问题检索,旨在优化检索阶段的输入处理。
四种策略
直接检索(Direct Retrieval)
定义
对用户原始查询不作改写或增强,直接基于原始问题进行向量检索或全文检索。
适用场景
- 用户意图明确
- 查询结构简单
- 目标信息在知识库中直接可匹配
示例
- 查询: “AI 学科学费是多少?”
- 策略: 直接检索
- 查询: “JAVA的课程大纲是什么?”
- 策略: 直接检索
技术特征
- 不依赖 LLM 改写
- 检索效率高
- 召回范围小但精准
假设问题检索(HyDE: Hypothetical Document Embeddings)
定义
与其直接用问题去生成嵌入向量,不如让大模型先根据问题“编造”一个假设答案(hypothetical answer/document),然后再用这个答案去生成向量。
适用场景
- 查询偏抽象或开放式
- 原始问题很难匹配知识片段
- 无直接答案的探索性问题
示例
- 查询: “人工智能在教育领域的应用有哪些?”
- 策略: 假设问题检索
技术特征
- LLM 生成假设性上下文
- 提高语义覆盖面
- 更适合观点性或场景化问题
提示词内容
输入query进行转换
假设你是用户,想了解以下问题,请生成一个简短的假设答案:
问题: {query}
假设答案:
举例说明
- 用户提问:“如何改善睡眠?”
- 传统做法:把这个问题向量化去检索。
- HyDE 做法:先让大模型写一段“如何改善睡眠的建议”,然后把这段假设文档向量化,用它去检索相关文档。
为什么有效
- 用户的问题可能很简略或模糊,但大模型可以根据它生成一个详细、语义丰富的假设文档。
- 假设文档更像是你想找的答案,从而提高召回质量。
- 实测中 HyDE 在多种语义检索任务上比直接使用 query embeddings 效果更好,尤其是问答类检索。
子查询检索(Sub-Question Decomposition)
定义
将一个复杂查询分解为多个子问题,分别进行检索,最后融合各子问题的答案。
适用场景
- 多实体比较
- 多维度分析型问题
- 包含“对比”、“优缺点”等词语
示例
- 查询: “比较 Milvus 和 Zilliz Cloud 的优缺点。”
- 策略: 子查询检索
技术特征
- 拆解后检索精度更高
- 适合表格化或结构化合成
- 可并发处理多个子问题
提示词内容
将以下复杂查询分解为多个简单子查询,每行一个子查询:
查询: {query}
子查询:
回溯问题检索(Question Rewriting / Reframing)**
定义
将复杂或嵌套式查询转换为更基础的问题,以提高检索系统的理解能力和召回能力。
适用场景
- 包含前置知识或推理链的问题
- 提问方式过于口语或上下文依赖
- “是否可以”、“我该怎么做”类的用户意图不明确问题
示例
- 查询: “我有一个包含 100 亿条记录的数据集,想把它存储到 Milvus 中进行查询。可以吗?”
- 策略: 回溯问题检索
- 改写为: “Milvus 支持多大规模的数据集存储和检索?”
技术特征
- LLM 改写复杂问题
- 化繁为简
- 更适合进行技术类文档匹配
提示词内容
将以下复杂查询简化为一个更简单的问题:
查询: {query}
简化问题:
【掌握】RAG问答
rag_system.py定义了RAGSystem类,整合系统的各个模块,完成从查询输入到答案生成的完整流程。它通过查询分类选择处理路径,利用检索策略优化文档检索,并结合上下文生成最终答案。
从查询到回答的流程
- 输入处理:
QueryClassifier分类查询,决定是否需要检索。 - 策略选择:
StrategySelector根据查询选择最佳检索策略。 - 文档检索:根据策略调用
VectorStore的混合检索,获取相关文档。 - 答案生成:使用
RAGPrompts的模板,结合上下文调用大语言模型生成答案。 - 输出:返回最终答案,并记录日志。
【了解】RAG系统评估
评估框架
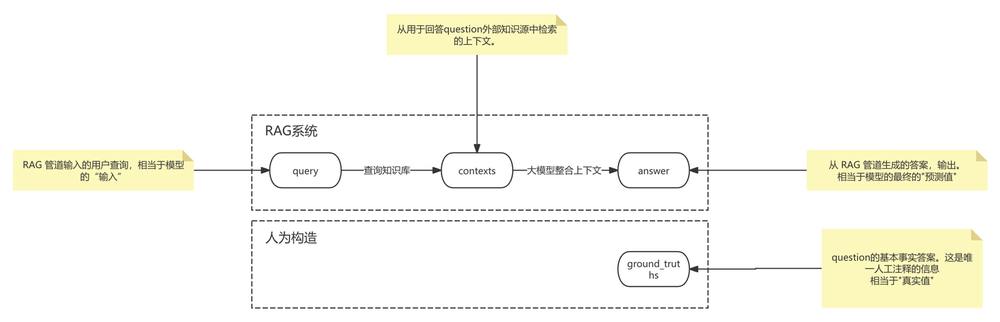
RAGAS (Retrieval Augmented Generation Assessment) 我们一般称为 Automated Evaluation of Retrieval Augmented Generation,即检索增强生成的自动评估。Ragas是一个大模型评测框架,可以评估检索增强生成(RAG)的效果,帮助分析模型的输出,了解模型在给定任务上的表现。
数据说明
最开始的 RAGAs 在评估数据集时,不必依赖人工标注的标准答案,而是通过底层的大语言模型 (LLM) 来进行评估。所以只需要一个带有问题-答案对的评估数据集(QA 对):
- question:作为 RAG 管道输入的用户查询,输入。
- answer:从 RAG 管道生成的答案,输出。
- contexts:从用于回答question外部知识源中检索的上下文。
- ground_truths:question的基本事实答案。这是唯一人工注释的信息。
评估指标
- **评估检索(context)**的指标:提供了上下文相关性(context_relevancy)和上下文召回率(context_recall),这些可以衡量你的检索系统的性能,即检索的段落是否相关。
- **评估生成(answer)**的指标:提供了忠实度(faithfulness),用以衡量生成的信息是否准确无误;以及答案相关性(answer_relevancy),用以衡量答案对问题的切题程度,即模型生成的答案是否恰当。
如下图所示:
上下文相关性
- 作用:指的是检索到的上下文应该只包含回答问题所需的信息,这个指标旨在惩罚包含冗余信息的情况。
- 比率越高,表示检索到的上下文与问题的相关性越强。
上下文召回率
- 作用:衡量检索到的上下文(contexts)与真实答案(ground_truths)的匹配程度。
- 该指标通过问题、标注答案和检索到的上下文计算,分数范围在0到1之间,得分越高表示性能更好。
- 要从真实答案中估计上下文召回率,需要分析真实答案中的每个声明(claim),以确定它是否可以归因于检索到的上下文。理想情况下,真实答案中的所有声明都应可归因于检索到的上下文。
忠实度
- 作用:指答案确实是根据给定的上下文得到的。这对于避免错觉并确保检索到的上下文可以用作生成答案的依据非常重要。
- 如果分数低,它表明 LLM 的回应没有遵循检索到的知识,提供幻觉式答案的可能性增加。
答案相关性
- 作用:生成的答案与查询之间的相关性。分数越高,相关性越好。
【理解】RAG系统优化
FQA和知识库查询
old_main.py 是一个融合 MySQL FAQ 和 RAG 系统的交互式问答程序,专注于快速、精准的答案生成。它通过 MySQL 提供结构化数据的高效查询,通过 RAG 系统处理复杂问题,同时配备日志记录和用户友好的命令行界面,适合教育场景的实时问答需求。
增强型FQA和知识库查询
new_main.py 是对 old_main.py 的优化版本,新增了对话历史管理和流式输出功能,增强了交互性和实时性。系统整合了 MySQL 的 FAQ 精确匹配、RAG 的知识库检索、MySQL 对话历史存储,以及流式答案生成,适用于教育场景下的实时问答需求。
基于FastAPI的知识库接口
app.py 是对 new_main.py 的进一步优化,基于 FastAPI 框架构建了 RESTful API 和 WebSocket 接口,集成了 MySQL FAQ 和 RAG 系统,支持流式输出、对话历史管理和日常问候处理。同时,通过静态文件服务支持前端页面交互,适用于教育场景下的实时问答系统。
【实践】RAG项目简历编写
项目名称:基于RAG的教育领域智能问答系统(EduRAG)
项目时间:2025.04 – 2025.010
技术栈:Python + Milvus + BERT + Sentence-BERT + Qwen2.5-7B + LoRA + RagAS + OCR + FastAPI
项目背景
针对教培行业高频、重复性咨询问题(如课程安排、退费政策、学习规划等),传统FAQ匹配准确率低、知识更新滞后,难以满足用户实时精准答疑需求。为此设计并实现了一套融合结构化数据检索与RAG技术的智能问答系统——EduRAG,显著提升回答准确率与用户体验。
主要职责
- 构建RAG知识库,整理并清洗PDF/Word/PPT等文档资料,累计构建 50万+条数据;
- 文档预处理:实现文本加载、去噪清洗、智能分块(按语义边界)、多模态内容处理
- 搭建 Milvus 向量数据库,设计多集合(3个collections)存储策略,支持课程、政策、服务等不同类型知识的隔离管理与高效检索;
- 基于 BERT 意图识别模块,支持4种意图分类如:(课程咨询、退费政策、学习规划、通用问题),F1-score达 90%;
- 完整RAG流程:根据意图路由至对应检索路径,结合检索结果拼接Prompt,基于 开源Qwen2.5-7B模型生成自然语言回答,支持上下文感知与格式化输出。
项目优化与技术创新
- 多模态文档处理增强
针对PDF/PPT中图片、表格等内容,引入 OCR工具(PaddleOCR)与多模态大模型提取图文信息,提升知识覆盖完整性。 - Query理解与重构优化
设计多策略query改写机制:
- 关键词扩展(同义词/领域词增强)
- 子查询分解(复杂问题拆解)
- 历史会话融合(上下文感知重写)
- 伪答案生成(HyDE策略)
- 通用去噪(去除口语化表达)
显著提升模糊查询的召回率。 - 文档索引与检索优化
- 构建 多级索引机制(支持父块/子块切分策略);
- 实现 稀疏向量 与 稠密向量 混合检索,通过加权融合提升召回准确率;
- 引入 (Rerank)模块,对Top-k结果进行精细化排序,Top-5相关性提升35%。 - 模型微调与生成优化
- 对 Qwen3-7B模型进行LoRA微调,适配教育领域术语与回答风格,显著提升回答专业性与流畅度;
- 设计结构化Prompt模板,控制生成格式,减少幻觉与冗余。 - 系统评估体系建设
- 使用 RagAS 自动评估框架对RAG全流程进行量化评测,关键指标:- 答案相关性(Answer Relevance)≥ 0.89
- 忠实性(Faithfulness)≥ 0.9
- 构建 1000条人工标注测试集,整体准确率(Accuracy)达 90%,具备良好泛化能力。
项目成果
- 系统上线后自动应答率超 80%,人工客服压力降低约50%;
- 回答准确率与用户满意度显著提升,获内部创新项目认可;
- 支持知识库动态更新,具备高可扩展性与私有化部署能力。
专题:RAG 中的 Query 改写
RAG中的Query改写
学习目标
- 理解query改写的意义
- 掌握qeury改写的实现方法
1 前言
在RAG(检索增强生成)流程中,第一步通常是对用户的提问(query)进行改写。这是因为用户提问的方式与他们期望的答案之间可能存在差距。由于每个用户的提问方式可能千差万别,因此对问题进行改写可以帮助系统更好地理解问题并返回更相关的答案,从而提升RAG系统的鲁棒性和扩展性。
用户提出的问题通常存在两类问题:
- 信息不完整:用户的提问没有表达清楚所有的关键信息
- 噪声问题:提问中可能包含了与答案无关的内容。
2 信息不完整
==2.1 历史会话改写==
在对话中,前后文是相互关联的。如果仅凭当前的query进行检索,可能会导致召回精度大幅下降,因为query中往往缺少重要的上下文信息。以下是一个具体的例子:
用户: 华为meta70手机的性能怎么样?
系统: 华为meta70手机搭载了强大的处理器和先进的摄像系统,性能表现非常优秀。
用户: 与上一代相比,它有哪些改进?
系统: 华为meta70相较于meta60在处理器性能、摄像头优化和电池续航方面都有显著提升。
用户: 摄像头方面具体改进了什么?
--改写前: 摄像头方面具体改进了什么?
--改写后: 华为meta70手机的摄像头相比meta60有哪些具体改进?
2.2 关键词扩写
用户在搜索时常常输入的关键词较为简短,并且缺乏足够的上下文信息,这会影响语义检索(向量检索)的效果,导致召回的相关性较低。因此,需要对用户的原始关键词进行扩展和丰富。
用户输入: “机器学习 实践”

改写后的 Query: “机器学习在实际应用中的案例有哪些?哪些工具和方法适用于机器学习实践?”
2.3 伪答案改写【假设问题检索】
伪答案改写通过在原始查询中加入一种假设性答案,来增强查询的语义丰富性,从而提高检索或回应的精准度。伪答案并非真实的答案,而是一个设想的内容,用于帮助系统更好地理解并检索相关信息。
用户输入: “如何提高企业的市场竞争力?”

改写后的 Query: “如何提高企业的市场竞争力?比如通过创新产品、优化营销策略或提升客户服务等手段。”

伪答案目的--> 通过提供假设性的提升方式,丰富查询的语义信息,从而增强系统在应对复杂问题时的检索能力
2.4 缩写词改写
用户在查询时常常使用缩写,而许多相关文档通常会使用完整的术语,因此需要对缩写进行扩展,以便更好地匹配相关内容。
用户输入: “VR 技术在教育中的应用”

改写后的 Query: “虚拟现实(Virtual Reality)技术在教育中的应用有哪些?可以举一些实际的应用案例吗?”
3 噪声问题
3.1 一般去噪改写【回溯问题检索】
通过去除查询中的无关成分(如多余的修饰语、模糊表达或不相关的背景信息),简化并优化查询,使其更加精确和可操作。这种方法有助于提高检索的准确性和效率。
用户输入: “我最近在准备面试,但对于算法的理解还不太够,能推荐一些有效的学习资源吗?”

改写后的 Query: “有哪些有效的学习资源可以帮助提高算法理解?”

分析:去除与问题无关的背景信息 “我最近在准备面试,但对于算法的理解还不太够”。 直接提取核心意图 “帮助提高算法理解”。
3.2 子查询改写【子查询检索】
当查询涉及对比多个实体时,可能会产生相互干扰的情况。对比类查询通常包含多个元素,这些元素如果直接放在一个查询中,可能会导致信息重叠,影响检索的准确性。为了避免干扰,可以将对比类查询拆分成多个独立的查询,每个查询聚焦于其中一个实体,这样可以减少信息混淆,获得更准确的结果。
用户输入: “C++ 和 Go 哪个更适合做系统编程?”
拆分后的查询:“C++ 适合做系统编程的优点有哪些?”;“Go 适合做系统编程的优点有哪些?”
拆分原因: • 直接对比 C++ 和 Go 的优劣,可能使得系统无法有效地提取每种语言的特点。拆分后,系统可以分别检索 C++ 和 Go 在系统编程中的优点,避免信息混乱
4 prompt示例
以下是一个开源rag系统,问题改写的示例,仅供参考:
您是查询扩展方面的专家,能够生成问题的释义。
我无法直接使用用户的问题从知识库中检索相关信息。
您需要通过多种方式扩展或释义用户的问题,例如使用同义词/短语、完整地写出缩写、添加一些额外的描述或解释、改变表达方式、将原始问题翻译成另一种语言(英语/中文)等。
并返回 5 个版本的问题,其中一个来自翻译。
只需列出问题。不需要其他单词。
本节小结
改写后的query质量在很大程度上依赖于提示(prompt)和大模型的能力。通常,查询改写可以提高召回的准确性,但有时仍可能发生改写失败的情况。因此,建议进行多次改写,或者将查询拆分为多个独立的查询,之后将召回结果输入到重排序(reranking)模型进行精确排序,再由大模型生成最终的答案。