第 5 节 / 共 8 节
RAG 开发(三):文档处理与向量检索
EduRAG 笔记(day05)
EduRAG项目
【了解】今日内容介绍
- 向量数据库
- 什么是向量数据库
- 为什么需要向量数据库
- 有哪些向量数据库
- Milvus数据库
- 概述
- 名词
- 操作
【理解】向量数据库
什么是向量数据库
向量数据库是一种专门用于存储、索引和检索高维向量数据的数据库系统。它的核心能力是支持相似性搜索(比如找最相似的向量),而不是传统数据库中的精确匹配查询。
为什么需要向量数据库
在传统数据库中,我们通常查询“年龄=25”或“姓名=张三”这样精确匹配的数据。但在 AI 和机器学习应用中,数据往往以向量形式表示,例如:
- 文本(通过 Embedding 模型转为向量)
- 图片(通过 CNN 转为向量)
- 音频、视频等
这时常见的需求是:找到与某个给定向量最相似的 N 个向量(相似度计算)。传统数据库(如 MySQL、PostgreSQL)不适合做这种大规模、高维度的相似性搜索,因为全量比对的计算复杂度太高。所以才需要向量数据库。
核心功能
| 功能 | 说明 |
|---|---|
| 向量存储 | 存储固定维度的高维浮点数数组 |
| 相似性搜索 | 支持余弦相似度、欧氏距离、内积等距离度量 |
| 近似最近邻(ANN)搜索 | 通过索引技术(如 HNSW、IVF、PQ)加速查询,牺牲少量精度换取速度 |
| 混合搜索 | 结合标量过滤(如“只搜索 2024 年的文档”)和向量搜索 |
| CRUD 操作 | 增删改查、元数据管理、持久化 |
常见向量数据库对比
| 名称 | 特点 | 适用场景 |
|---|---|---|
| **Milvus ** | 功能最丰富,分布式,支持 GPU 加速 | 生产级大规模检索 |
| Faiss | 高效的相似性搜索算法库 | 轻量级 |
| Pinecone | 全托管云服务,简单易用 | 不想运维的团队 |
| Chroma | 轻量级,嵌入式,与 LangChain 集成友好 | 本地开发、小规模应用 |
典型应用场景
- 检索增强生成(RAG):将文档切成片段并向量化存入向量数据库,LLM 回答问题时先检索相关片段再生成答案。
- 推荐系统:用户向量与商品向量做相似性匹配。
- 图像/视频检索:以图搜图、以视频片段检索原视频。
- 语义搜索:将查询转为向量,匹配语义相似的文档。
- 异常检测:寻找与正常行为向量差异大的点。
【理解】Milvus数据库
概述
Milvus 是一款开源的向量数据库(2019年提出),其唯一目标是存储、索引和管理由深度神经网络和其他机器学习(ML)模型生成的大规模嵌入向量。
作为一个专门设计用于处理输入向量查询的数据库,它能够处理万亿级别的向量索引。与现有的关系型数据库主要处理遵循预定义模式的结构化数据不同,Milvus 从底层设计用于处理从非结构化数据转换而来的嵌入向量。
随着互联网的发展和演变,非结构化数据变得越来越常见,包括电子邮件、论文、物联网传感器数据、Facebook 照片、蛋白质结构等等。为了使计算机能够理解和处理非结构化数据,使用嵌入技术将它们转换为向量。Milvus 存储和索引这些向量。Milvus 能够通过计算它们的相似距离来分析两个向量之间的相关性。如果两个嵌入向量非常相似,则意味着原始数据源也很相似。
为什么选择Milvus
- 在处理大规模数据集的向量搜索时具有高性能。
- 开发者优先的社区,提供多语言支持和工具链。
- 云扩展性和高可靠性,即使出现故障也不会受到影响。
- 通过将标量过滤与向量相似度搜索配对,实现混合搜索。
名词
非结构化数据
非结构化数据包括图像、视频、音频和自然语言等信息,这些信息不遵循预定义的模型或组织方式。这种数据类型占据了世界数据的约 80%,可以使用各种人工智能(AI)和机器学习(ML)模型将其转换为向量。
嵌入向量
嵌入向量是对非结构化数据(如电子邮件、物联网传感器数据、Instagram 照片、蛋白质结构等)的特征抽象。数学上,嵌入向量是一个浮点数或二进制数的数组。现代的嵌入技术被用于将非结构化数据转换为嵌入向量。
向量相似度搜索
向量相似度搜索是将向量与数据库进行比较,以找到与查询向量最相似的向量的过程。使用近似最近邻搜索算法加速搜索过程。如果两个嵌入向量非常相似,那么原始数据源也是相似的。
Collection和Field
与传统数据库引擎类似,您也可以在 Milvus 中创建数据库,并为某些用户分配权限来管理它们。
在关系数据库中,表和字段的结构可以与Milvus中的Collection和Field进行对应:
| Milvus | 关系数据库 | 描述 |
|---|---|---|
| Collection | 表 | 集合相当于关系数据库中的表,用于组织数据 |
| Field | 字段 | 字段Schema相当于表中的列 |
| is_primary | 主键 | 在Field Schema中标记为主键对应该列的主键 |
| dtype | 数据类型 | 字段的数据类型,如INT, VARCHAR等 |
| max_length | 最大长度 | 对应VARCHAR类型字段的最大字符数 |
| dim | - | 向量字段的维度没有直接对应,但可以视为特殊数据处理 |
索引和度量
索引是数据的组织单位。在搜索或查询插入的实体之前,必须声明索引类型和相似度度量。如果您未指定索引类型,则 Milvus 将默认使用暴力搜索。
索引类型
大多数由 Milvus 支持的向量索引类型使用近似最近邻搜索(ANNS),包括:
- FLAT:FLAT最适合在小型、百万级数据集上寻求完全准确和精确搜索结果的场景。
这是最简单的索引方式,进行暴力搜索(brute-force),可以保证精确度,但效率低,尤其在数据量大时。适合场景:在小型、百万级数据集上寻求完全精确的搜索结果。
- IVF_FLAT: 是一种基于倒排的索引方法,广泛用于在大规模数据集上实现高效的近似最近邻搜索。它适用于在精度和查询速度之间寻求平衡的场景。
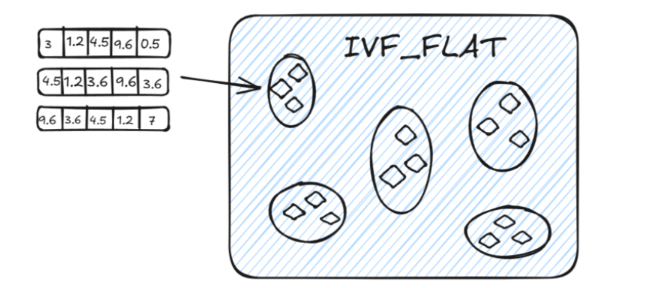
1. 聚类 :IVF_FLAT通过聚类算法(如k-means)将高维空间中的向量划分为多个子空间(簇)。每个簇包含一组相似的向量,并且每个簇会有一个代表向量,通常是簇的中心点。
2. 倒排索引 :为每个簇创建倒排索引。每个向量会被映射到它所属的簇,这样在查询时,系统只需关注与查询向量相似的簇,而不需要搜索整个高维空间,从而显著降低搜索的时间复杂度。
3. 查询处理 :
-
查询时,IVF_FLAT首先将查询向量分配到距离最近的簇中心(即子空间)。
-
然后在该簇内执行精确的线性搜索,从而查找与查询向量相似的向量。
-
为了优化查询,IVF_FLAT使用一个参数
nprobe来控制搜索的簇数。nprobe控制搜索时考虑的簇的数量,从而平衡查询精度和查询速度。 -
增大
nprobe可以搜索更多簇,返回更多候选向量,提高结果的精确度,但查询时间也会增加。减少nprobe可以缩小搜索范围,降低计算时间,查询速度更快,但可能会牺牲一些精度。 -
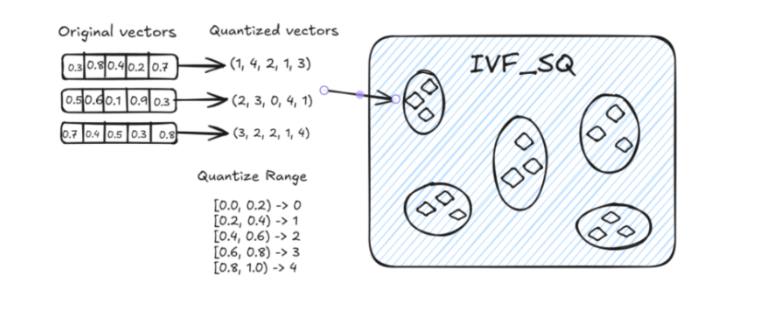
IVF_SQ8:是在 IVF_FLAT 基础上增加了量化步骤的一种索引方法,其核心思想与 IVF_FLAT 类似;IVF_SQ8通过 标量量化 (Scalar Quantization)将每个维度的 4 字节浮点数表示压缩为 1 字节整数表示。
- IVF_PQ:是一种高效的向量索引方式,结合了倒排文件索引和乘积量化(Product Quantization)技术,旨在加速大规模高维数据集的检索。
- 倒排文件索引:IVF_PQ首先将数据集划分为多个簇,每个簇由一个聚类中心表示。查询时,系统首先计算查询向量与这些聚类中心的距离,选择最接近的几个簇进行详细搜索,从而减少计算量。
- 乘积量化:在每个簇内,向量被进一步量化为多个子向量,这些子向量通过独立的量化过程进行编码。这样可以显著降低存储需求,并加快相似度计算。
-
存储与速度:IVF_PQ通过减少存储空间的占用,同时保持较高的查询速度和准确性,适用于处理大规模高维向量数据。
-
HNSW:HNSW是基于图的索引,最适合对搜索效率有高要求的场景。
相似度计算
在 Milvus 中,相似度度量用于衡量向量之间的相似性。选择一个好的距离度量方法可以显著提高分类和聚类的性能。根据输入数据的形式,选择特定的相似度度量方法可以获得最优的性能。
对于浮点嵌入,通常使用以下指标:
- 欧几里得距离(L2)
- 内积(IP)
- 余弦相似度 (COSINE)
Milvus操作
database操作
数据库的操作,基本上就是新增、查看、删除。
新增和查询的代码:
# 1 数据库的操作
def dm01():
    # 创建名称为milvus_demo的数据库
    databases = client.list_databases()
    print("databases-->", databases)
    if "milvus_demo" not in databases:
        client.create_database(db_name="milvus_demo")
    else:
        client.using_database(db_name="milvus_demo")

    # 创建已经存在的数据库会报错
    # client.create_database(db_name="milvus_demo")

    databases = client.list_databases()
    print("databases-->", databases)
删除代码:
# 9.删除数据库
def dm09():
    client.using_database("milvus_demo")
    client.drop_database("milvus_demo")
Collection操作
增加
新增Collection的操作(含新增index)。
# 3.Entity实体数据操作-插入数据
def dm03():
    client.using_database("milvus_demo")
    # todo:1. 创建集合collection
    # 这种方式: collection 只包括两个字段. id 作为主键, vector 作为向量字段,以及自动设置 auto_id、enable_dynamic_field 为 True
    # auto_id 启用此设置可确保主键自动递增。在数据插入期间无需手动提供主键。
    # enable_dynamic_field 启用后,要插入的数据中除 id 和 vector 之外的所有字段都将被视为动态字段。
    # # 这些附加字段作为键值对保存在名为 $meta 的特殊字段中。此功能允许在数据插入期间包含额外的字段。
    client.create_collection(collection_name='demo_v2', dimension=5, metric_type='IP')

    # todo:2. 插入数据(也叫实体)
    data = [
        {"id": 0, "vector": [0.3580376395471989, -0.6023495712049978, 0.18414012509913835, -0.26286205330961354,
                             0.9029438446296592], "color": "pink_8682"},
        {"id": 1, "vector": [0.19886812562848388, 0.06023560599112088, 0.6976963061752597, 0.2614474506242501,
                             0.838729485096104], "color": "red_7025"},
        {"id": 2, "vector": [0.43742130801983836, -0.5597502546264526, 0.6457887650909682, 0.7894058910881185,
                             0.20785793220625592], "color": "orange_6781"},
        {"id": 3, "vector": [0.3172005263489739, 0.9719044792798428, -0.36981146090600725, -0.4860894583077995,
                             0.95791889146345], "color": "pink_9298"},
        {"id": 4, "vector": [0.4452349528804562, -0.8757026943054742, 0.8220779437047674, 0.46406290649483184,
                             0.30337481143159106], "color": "red_4794"},
        {"id": 5, "vector": [0.985825131989184, -0.8144651566660419, 0.6299267002202009, 0.1206906911183383,
                             -0.1446277761879955], "color": "yellow_4222"},
        {"id": 6, "vector": [0.8371977790571115, -0.015764369584852833, -0.31062937026679327, -0.562666951622192,
                             -0.8984947637863987], "color": "red_9392"},
        {"id": 7, "vector": [-0.33445148015177995, -0.2567135004164067, 0.8987539745369246, 0.9402995886420709,
                             0.5378064918413052], "color": "grey_8510"},
        {"id": 8, "vector": [0.39524717779832685, 0.4000257286739164, -0.5890507376891594, -0.8650502298996872,
                             -0.6140360785406336], "color": "white_9381"},
        {"id": 9, "vector": [0.5718280481994695, 0.24070317428066512, -0.3737913482606834, -0.06726932177492717,
                             -0.6980531615588608], "color": "purple_4976"}
    ]
    res = client.insert(collection_name='demo_v2', data=data)
    print("res-->", res)
修改
# 5.Entity实体数据操作-更新数据
def dm05():
    client.using_database("milvus_demo")
    ## todo:4. 更新插入数据
    # 在 Milvus 中,upsert 操作执行数据级操作,根据集合中是否已存在主键来插入或更新实体。具体来说:
    # 如果集合中已存在该实体的主键,则现有实体将被覆盖。
    # 如果集合中不存在主键,则将插入一个新实体。
    data = [
        {"id": 0, "vector": [-0.619954382375778, 0.4479436794798608, -0.17493894838751745, -0.4248030059917294,
                             -0.8648452746018911], "color": "black_9898"},
        {"id": 1, "vector": [0.4762662251462588, -0.6942502138717026, -0.4490002642657902, -0.628696575798281,
                             0.9660395877041965], "color": "red_7319"},
        {"id": 2, "vector": [-0.8864122635045097, 0.9260170474445351, 0.801326976181461, 0.6383943392381306,
                             0.7563037341572827], "color": "white_6465"},
        {"id": 3, "vector": [0.14594326235891586, -0.3775407299900644, -0.3765479013078812, 0.20612075380355122,
                             0.4902678929632145], "color": "orange_7580"},
        {"id": 4, "vector": [0.4548498669607359, -0.887610217681605, 0.5655081329910452, 0.19220509387904117,
                             0.016513983433433577], "color": "red_3314"},
        {"id": 5, "vector": [0.11755001847051827, -0.7295149788999611, 0.2608115847524266, -0.1719167007897875,
                             0.7417611743754855], "color": "black_9955"},
        {"id": 6, "vector": [0.9363032158314308, 0.030699901477745373, 0.8365910312319647, 0.7823840208444011,
                             0.2625222076909237], "color": "yellow_2461"},
        {"id": 7, "vector": [0.0754823906014721, -0.6390658668265143, 0.5610517334334937, -0.8986261118798251,
                             0.9372056764266794], "color": "white_5015"},
        {"id": 8, "vector": [-0.3038434006935904, 0.1279149203380523, 0.503958664270957, -0.2622661156746988,
                             0.7407627307791929], "color": "purple_6414"},
        {"id": 9, "vector": [-0.7125086947677588, -0.8050968321012257, -0.32608864121785786, 0.3255654958645424,
                             0.26227968923834233], "color": "brown_7231"}
    ]

    res = client.upsert(collection_name='demo_v2', data=data)
    print('res-->', res)
查询
# 7.数据查询
def dm07():
    client.using_database("milvus_demo")
    # todo: 1. 单向量搜索
    res = client.search(collection_name='demo_v2',
                        data=[[0.19886812562848388, 0.06023560599112088, 0.6976963061752597, 0.2614474506242501,
                               0.838729485096104]],
                        limit=2,
                        search_params={"metric_type": "IP"},
                        output_fields=["id", 'vector'])  # search_params是在查询时执行距离计算方式,如果定义索引的时候,已经制定了方式可以不写
    print("res1-->", res)
    print("\nres[0]-->", res[0])
    print("\nres[0][0]-->", res[0][0])
删除
# 9.删除集合和数据库
def dm09():
    client.using_database("milvus_demo")
    # client.drop_collection(collection_name="demo_v3")
    client.drop_database("milvus_demo")