第 8 节 / 共 9 节
LangGraph(二):核心组件与流程控制
🎯 Graph / State / Node / Edge / Memory、分支循环并行、人工介入、子图与 LangSmith。
💻 代码
LangGraph 核心代码(a / b / c / e 系列)
78 个文件📁 a_hello/
- 📄 __init__.py 0B 下载
- 📄 hello_01.py 347B 下载
- 📄 hello_02.py 496B 下载
- 📄 hello_03.py 528B 下载
- 📄 hello_04.py 929B 下载
- 📄 hello_05.py 1010B 下载
- 📄 hello_06.py 1.2KB 下载
- 📄 hello_07.py 916B 下载
📁 b_basic_component/
- 📄 __init__.py 0B 下载
- 📄 a_01_graph.py 825B 下载
- 📄 b_01_state.py 803B 下载
- 📄 b_02_state.py 990B 下载
- 📄 c_01_node.py 2.3KB 下载
- 📄 d_edge_01.py 2.4KB 下载
- 📄 e_memory.py 2.3KB 下载
- ⚙️ edge1.png 15.3KB 下载
- 📄 f_operation_by_step.py 1.2KB 下载
- ⚙️ graph.jpg 4.3KB 下载
- ⚙️ node1.jpg 5.6KB 下载
- ⚙️ node2.jpg 6.4KB 下载
- ⚙️ state1.jpg 5.6KB 下载
- ⚙️ state2.jpg 5.6KB 下载
📁 c_flow_control/
- 📄 __init__.py 0B 下载
- 📄 a_branch.py 1.9KB 下载
- 📄 b_loop.py 1.3KB 下载
- ⚙️ branch.jpg 15.5KB 下载
- 📄 c_parallel.py 5.3KB 下载
- 📄 d_human_in_loops.py 2.6KB 下载
- 📄 e_sub_graph.py 7.1KB 下载
- ⚙️ human_in_loop.jpg 13.9KB 下载
- ⚙️ loop.jpg 10.9KB 下载
- ⚙️ parallel.jpg 14.7KB 下载
- ⚙️ 加糖子图.jpg 11.7KB 下载
- ⚙️ 加糖子图1.jpg 11.7KB 下载
- ⚙️ 加糖子图33.jpg 11.7KB 下载
- ⚙️ 复杂流程.jpg 30.0KB 下载
- ⚙️ 总图.jpg 16.7KB 下载
- ⚙️ 烧热水子图.jpg 14.6KB 下载
📁 c_vehicle_model/
- 📄 __init__.py 0B 下载
- 📄 a_gather_infomation.py 6.9KB 下载
- 📄 designer1_1.py 1.1KB 下载
- 📄 designer1_1_result.md 7.1KB 下载
- 📄 designer1_2.py 1.2KB 下载
- 📄 designer1_2_result.md 4.9KB 下载
- 📄 designer1_3.py 1.2KB 下载
- 📄 designer1_3_result.md 47.5KB 下载
- 📄 designer2.py 2.2KB 下载
- 📄 designer2_result.md 15.8KB 下载
- 📄 designer3.py 10.8KB 下载
- 📄 designer3_result.md 26.5KB 下载
- 📄 designer4.py 12.9KB 下载
- 📄 designer4_result.md 29.2KB 下载
- ⚙️ graph.jpg 19.8KB 下载
- 📄 test.md 30.9KB 下载
- 📄 testPrompt.py 4.8KB 下载
- 📄 新建 文本文档.txt 47.5KB 下载
📁 d_building_blocks/
- 📄 __init__.py 0B 下载
- 📄 a_one_time_generation.md 3.5KB 下载
- 📄 a_paper.md 5.2KB 下载
- 📄 a_prompt_chaining.py 2.4KB 下载
- 📄 b_routing.py 2.9KB 下载
- 📄 c_parallelization.py 1.9KB 下载
- 📄 d_novel.md 49.2KB 下载
- 📄 d_orchestrator-workers.py 3.8KB 下载
- 📄 debate.md 43.2KB 下载
- 📄 e_debate_competition.py 2.4KB 下载
- 📄 e_generator_evaluator.py 2.8KB 下载
- 📄 f_agent.py 1.8KB 下载
- ⚙️ graph.jpg 13.8KB 下载
📁 e_test_langsmith/
- 📄 __init__.py 33B 下载
- 📄 a_gather_infomation.py 6.9KB 下载
- 📄 account.txt 31B 下载
- 📄 designer8_observe.py 13.2KB 下载
- ⚙️ graph.jpg 44.7KB 下载
- 📄 test1.py 747B 下载
- 📄 test2.py 2.8KB 下载
- 📄 __init__.py 0B 下载
- 📄 showGraph.py 1.6KB 下载
📎 资料
LangGraph 导图
- 🧠 langGraph.xmind 481.9KB
🧠 langGraph.xmind · 大纲
基于LangGraph的垂直领域智能体实战
课程情况
面向人群
对大模型有初步了解
对智能体编排有初步概念,有意深入研究
课程目标
环境搭建:能够独立配置LangGraph开发环境。
掌握LangGraph的核心概念(图、节点、边、状态、流程控制等)
完成新车型方案设计。
理解和实践六种主流的智能体设计模式。
课程知识与核心交付
了解langGraph的工作方式
掌握langGraph的核心概念(图、节点、边、状态、流程控制等)
理解和掌握六种主流的智能体设计模式
能够使用langGraph完成中等难度的智能体应用
课程详情
整体交付能力
使用langGraph完成新车型方案设计
1. 什么是langGraph
交付能力:了解langGraph工作方式,langGraph和langChain的区别,能够独立配置langGraph环境。
课程内容
用实例说明langGraph的工作方式
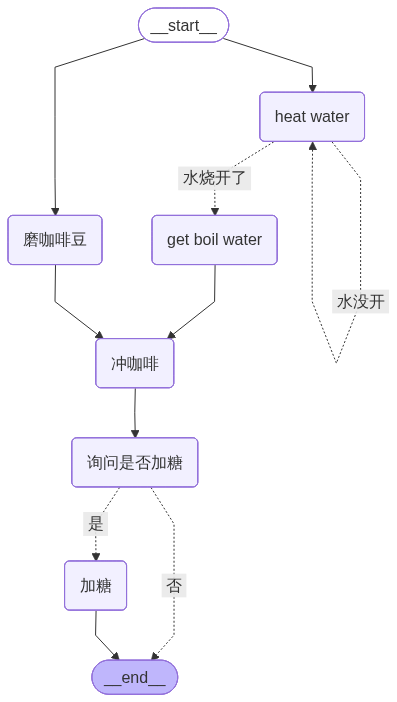
冲咖啡的操作步骤
磨咖啡豆
烧热水(一直加热直到水烧开为止)
冲咖啡(结果合并)
加糖(人工控制)
冲咖啡的作业流程
langGraph和langChain的区别
并行
烧开水和磨咖啡豆
循环
一直加热,直到烧开为止
人工介入
咖啡要不要加糖
langGraph能解决的问题
复杂任务拆解
先查资料,再写文章,最后润色
动态流程调整
根据中间结果确定走哪条路径
分支与并行
一些步骤可以拆分成不同的分支,并行完成后整合结果
多人协作
不同步骤可以用不同模型/API(比如GPT写文案+Stable Diffusion画图)
人工介入
在某些非常关键的位置,必须由人类决定的点,可以人工介入,然后继续走流程
langGraph的安装
虚拟环境
conda create -n langgraph python=3.11
conda activate langgraph
安装pytorch
pip3 install torch torchvision torchaudio --index-url https://mirrors.nju.edu.cn/pytorch/whl/cu126
安装支持包
pip3 install ollama langchain langchain_ollama matplotlib -i https://mirrors.tuna.tsinghua.edu.cn/pypi/web/simple
安装langGraph
pip install langgraph -i https://mirrors.tuna.tsinghua.edu.cn/pypi/web/simple
实操:了解了解langGraph工作方式;了解LangGraph解决的问题;能够独立配置LangGraph环境
2. langGraph的基本组件
交付能力:掌握langGraph的核心组件:图、状态、节点、边、记忆
课程内容
图
图的由来
langGraph中的图
graphBuilder = StateGraph(dict)
用matplotlib画图
状态
本质上是字典 dict
工作中常用TypedDict
节点
节点类型
默认节点
START
END
函数节点
一个普通的函数
输入是状态(state)
工具节点
封装外部工具或API
大模型节点
调用大模型生成结果
条件节点
通过边(Edge)实现分支逻辑, 选择不同处理路径
并行节点
langGraph中用于并行执行多个操作的节点。
聚合节点
合并多个节点的输出
人工干预节点
在关键步骤暂停流程,等待人工输入或审核
使用节点
graphBuilder.add_node("add", add)
边
普通边
一般情况
graphBuilder.add_edge("add", "multiply")
设置起点
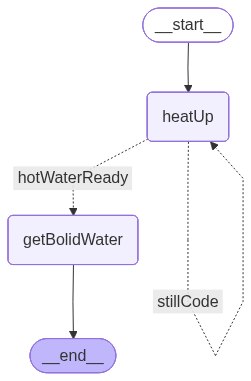
graphBuilder.add_edge(START, "heatUp")
设置终点
graphBuilder.add_edge("getBolidWater",END)
条件边
条件节点
def processWater(state):
if state["tempreture"]== 100:
state["product"] = "coffee"
return "hotWaterReady"
else:
state["product"] = "unburned water"
return "stillCode"
条件边
graphBuilder.add_conditional_edges("heatUp",processWater,{"hotWaterReady":"getBolidWater","stillCode":"heatUp"})
起点
终点
映射表
记忆
实例化记忆
#实例化memory
memory = MemorySaver()
带记忆的编译
graph = graphBuilder.compile(checkpointer=memory)
实操:完成关于langGraph基础概念部分的代码图、状态、节点、边、记忆:
3. langGraph的基本执行流程
交付能力:了解一个LangGraph应用的执行流程。
能够写出基本LangGraph程序。
课程内容
初始化模型和工具
初始化图和节点
定义节点
定义边和出口入口
编译图
执行图
实操:用代码实现LangGraph程序的六个基本步骤
4. langGraph的流程控制
交付能力:能够熟练使用langGraph的流程控制方式:分支、循环、并行、人工介入、子图。
课程内容
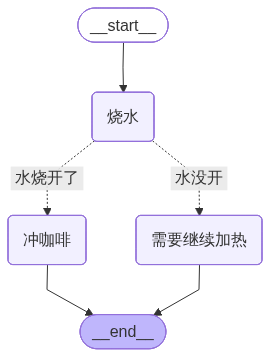
分支
条件节点
def 按条件处理水(state):
print("before processWater:"+str(state))
if state["水温"]== 100:
return "水烧开了"
else:
return "水没开"
条件边
graphBuilder.add_conditional_edges("烧水",按条件处理水,{"水烧开了":"冲咖啡","水没开":"需要继续加热"})
graphBuilder.add_edge("冲咖啡",END)
graphBuilder.add_edge("需要继续加热", END)
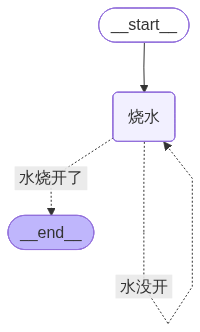
循环
条件节点
#条件节点,如果要使用循环,必须使用条件节点
def 按温度处理水(state):
if state["水温"]== 100:
return "水烧开了"
else:
return "水没开"
条件边
graphBuilder.add_conditional_edges("烧水",按温度处理水,{"水烧开了":END,"水没开":"烧水"})
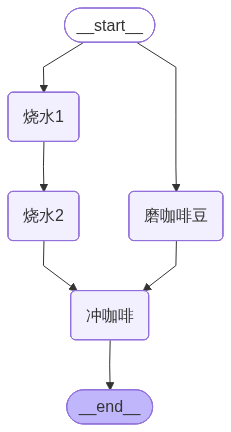
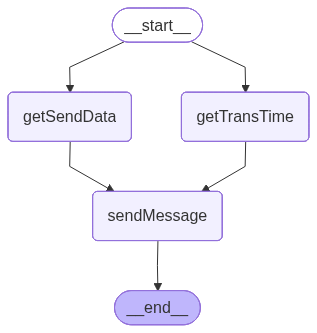
并行
错误的写法
graphBuilder.add_edge("磨咖啡豆", "冲咖啡")
graphBuilder.add_edge("烧水2", "冲咖啡")
正确的写法
# 用这种方式,强制限定必须完成 烧水2 和 磨咖啡豆 这两个动作后才能 冲咖啡 ,这才是我们想要的执行流程
graphBuilder.add_edge(["烧水2","磨咖啡豆"], "冲咖啡")
人工介入
graph必须带有memory
checkpointer = InMemorySaver()
graph = graphBuilder.compile(checkpointer=checkpointer)
首次启动
state = graph.invoke(state, config) # 调用Agent启动工作流
打断
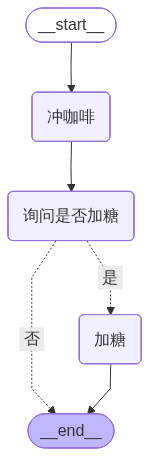
def 询问是否加糖(state):
human_response = interrupt({'':''})
state["是否加糖"] = human_response
return state
再次启动
userDecision = input("先生您好,请问您的咖啡需要加糖吗?(是/否):")
while userDecision not in {"是", "否"}:
userDecision = input("先生您好,请问您的咖啡需要加糖吗?(是/否):")
result = graph.invoke(Command(resume=userDecision), config=config)
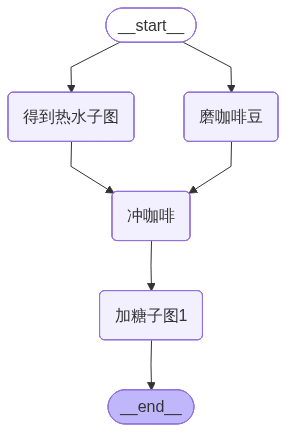
子图
有些图会过于复杂
可以考虑拆解成子图
(未命名)
实现方式
#总图 graphBuilder = StateGraph(State) graphBuilder.add_node("得到热水子图",heatWaterSubGraph) graphBuilder.add_node("磨咖啡豆", 磨咖啡豆) graphBuilder.add_node("冲咖啡", 冲咖啡) graphBuilder.add_node("加糖子图", addSugurSubGraph) graphBuilder.add_edge(START,"得到热水子图") graphBuilder.add_edge(START, "磨咖啡豆") graphBuilder.add_edge(["得到热水子图","磨咖啡豆"],"冲咖啡") graphBuilder.add_edge("冲咖啡","加糖子图") graph = graphBuilder.compile(checkpointer=checkpointer) return heatWaterSubGraph,addSugurSubGraph,graph
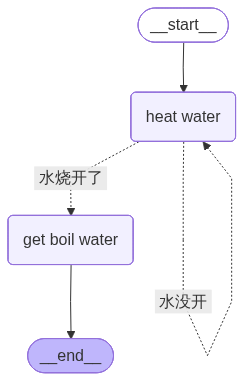
#烧水子图
heatWaterSubGraphBuilder = StateGraph(State)
heatWaterSubGraphBuilder.add_node("heat water", 烧水)
heatWaterSubGraphBuilder.add_node("get boil water", 得到开水)
heatWaterSubGraphBuilder.add_edge(START, "heat water")
heatWaterSubGraphBuilder.add_edge(START, "heat water")
heatWaterSubGraphBuilder.add_conditional_edges("heat water", 按温度处理水,{"水烧开了": "get boil water", "水没开": "heat water"})
heatWaterSubGraph = heatWaterSubGraphBuilder.compile()
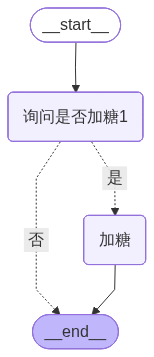
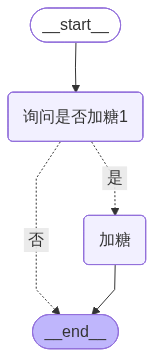
#加糖子图
checkpointer = InMemorySaver()
addSugurSubGraphBuilder = StateGraph(State)
addSugurSubGraphBuilder.add_node("询问是否加糖1", 询问是否加糖)
addSugurSubGraphBuilder.add_node("加糖", 加糖)
addSugurSubGraphBuilder.add_edge(START,"询问是否加糖1")
addSugurSubGraphBuilder.add_conditional_edges("询问是否加糖1", 是否加糖分支, {"是": "加糖", "否": END})
addSugurSubGraph = addSugurSubGraphBuilder.compile(checkpointer=checkpointer)
实操:完成流程控制部分的代码,并测试效果
5. 使用langGraph完成新车型设计方案
交付能力:能够综合运用langGraph的知识,完成一个中等复杂度的项目为企业提供新车型设计方案
课程内容
信息收集
实际项目中的市场趋势来自向量库检索结果
实际项目中的竞品销量数据来自关系数据库
调用大参数量模型
自己实现一个调用类,继承自Runnable
class CustomModel(Runnable): def __init__(self, model_endpoint: str, api_key: str): self.endpoint = model_endpoint self.api_key = api_key def invoke(self, prompt: str, modelName:str="deepseek-ai/DeepSeek-V3",maxTokens:int=3000,tempreture=0.6,config: Optional[Dict] = None) -> Dict: """调用自定义模型API""" import requests headers = {"Authorization": f"Bearer {self.api_key}", "Content-Type": "application/json"} payload = { "model":modelName, "messages": [{"role": "user", "content": prompt}], "temperature":tempreture, "max_tokens": maxTokens } response = requests.post(self.endpoint, json=payload, headers=headers) response.raise_for_status() return response.json()['choices'][0]['message']['content']
细分主题 1
封装成模型
llm = CustomModel(
model_endpoint="https://api.siliconflow.cn/v1/chat/completions",
api_key="*****"
)
调用
result = llm.invoke(prompt)
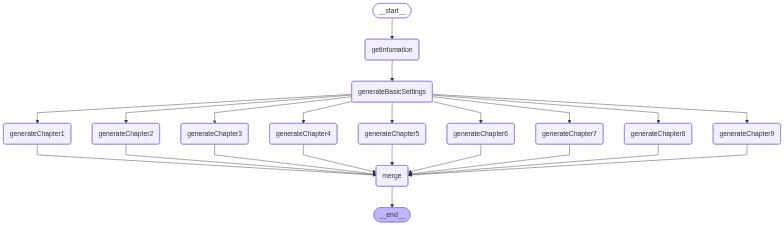
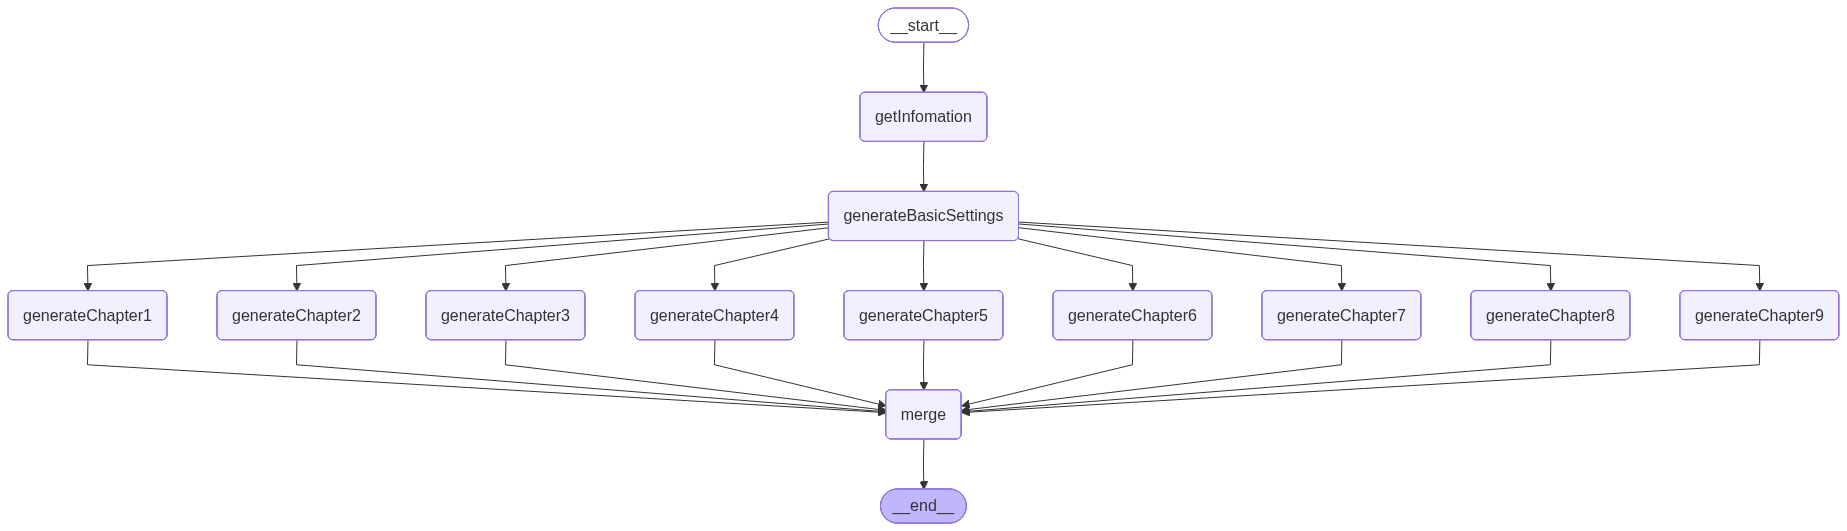
生成新车型的基本设定
prompt = """你是凯瑞汽车旗下维多利亚品牌的车型设计师,维多利亚品牌主要面向年轻的女性客户,根据【竞品资料】和【女性汽车市场发展趋势】,结合你自己的思考,为维多利亚品牌设计一款新车型,规划这个新车型、技术方案和定价策略。300字以内。
【竞品资料】
""" + state["competitorStatus"] + """
【女性汽车市场发展趋势】
""" + state["femaleMarketTrend"]
分别完成各个章节
prompt = """你是凯瑞汽车旗下维多利亚品牌的车型设计师,维多利亚品牌主要面向年轻的女性客户,根据【女性汽车市场发展趋势】和【新车型基本设定】,结合你自己的思考,完成新车型设计方案的第一章“一、设计背景和理念”,说明新车型的设计背景和理念。各级标题使用markdown格式。600字以内。
【女性汽车市场发展趋势】
""" + state["femaleMarketTrend"]+"""
【新车型基本设定】
"""+state["basicSettings"]
合并产出最终结果
def merge(state):
state["design"]=state["chapter1"]+"\n"+ \
state["chapter2"]+"\n"+ \
state["chapter3"] + "\n" + \
state["chapter4"] + "\n" + \
state["chapter5"] + "\n" + \
state["chapter6"] + "\n" + \
state["chapter7"] + "\n" + \
state["chapter8"] + "\n" + \
state["chapter9"]
return state
设置和编译图
def buildGraph():
graphBuilder = StateGraph(State)
graphBuilder.add_node("generateBasicSettings", generateBasicSettings)
graphBuilder.add_node("getInfomation",getInfomation)
graphBuilder.add_node("generateChapter1",generateChapter1)
graphBuilder.add_node("generateChapter2", generateChapter2)
graphBuilder.add_node("generateChapter3", generateChapter3)
graphBuilder.add_node("generateChapter4", generateChapter4)
graphBuilder.add_node("generateChapter5", generateChapter5)
graphBuilder.add_node("generateChapter6", generateChapter6)
graphBuilder.add_node("generateChapter7", generateChapter7)
graphBuilder.add_node("generateChapter8", generateChapter8)
graphBuilder.add_node("generateChapter9", generateChapter9)
graphBuilder.add_node("merge", merge)
graphBuilder.add_edge(START, "getInfomation")
graphBuilder.add_edge("getInfomation", "generateBasicSettings")
graphBuilder.add_edge("generateBasicSettings", "generateChapter1")
graphBuilder.add_edge("generateBasicSettings", "generateChapter2")
graphBuilder.add_edge("generateBasicSettings", "generateChapter3")
graphBuilder.add_edge("generateBasicSettings", "generateChapter4")
graphBuilder.add_edge("generateBasicSettings", "generateChapter5")
graphBuilder.add_edge("generateBasicSettings", "generateChapter6")
graphBuilder.add_edge("generateBasicSettings", "generateChapter7")
graphBuilder.add_edge("generateBasicSettings", "generateChapter8")
graphBuilder.add_edge("generateBasicSettings", "generateChapter9")
graphBuilder.add_edge(["generateChapter1","generateChapter2","generateChapter3","generateChapter4","generateChapter5","generateChapter6","generateChapter7","generateChapter8","generateChapter9"], "merge")
graph = graphBuilder.compile()
return graph
实操:完成新车型设计项目的代码,并验证效果
6. 使用langGraph实现主流的智能体设计模式
交付能力:能够使用主流的设计模式构建智能体
课程内容
重要文章介绍
《Building Effective Agents》
https://www.anthropic.com/engineering/building-effective-agents
构建智能体的思路
工作流
可控性强
一致性好
智能体
泛用性好
自主纠偏
使用框架的场景
六种主流设计模式
提示链
一项工作,分步完成,逐步完善
graphBuilder.add_edge(START, "getOutline")
graphBuilder.add_edge("getOutline", "getDraft")
graphBuilder.add_edge("getDraft", "getPaper")
graphBuilder.add_edge("getPaper",END)
分支
多个领域,选择分支,优化质量
graphBuilder.add_conditional_edges("getFraction",selectFraction,{"Confucian":"getDebateFromConfucian","Legalists":"getDebateFromLegalists","Taoism":"getDebateFromTaoism"})
并行
多个子任务,互不干扰,并行执行
graphBuilder.add_edge(["getSendData","getTransTime"], "sendMessage")
计划-执行
先定计划,分步执行,最终合并
def orchestrate(state):
planner = llm.with_structured_output(Sections)
result = planner.invoke("""你是一位著名小说家,正在创作一部精彩的侦探小说,根据下面的【故事梗概】,将小说分成10个章节,并给出章节的剧情发展。1000字左右。
【故事梗概】
"""+state["storyLine"])
state["sections"] = result.sections
print("sections " + "*" * 80)
for section in state["sections"]:
print(str(section.name+' '+section.description))
return state
def work(state:WorkerState):
prompt = """你是一位著名小说家,正在创作一部精彩的侦探小说,根据下面提供的【章节标题】和【章节概述】,完成其中的一个章节,最前面是章节标题,后面是章节内容。章节标题采用“【第三章】 迷雾重现”的形式,单独一行。章节的序号为"""+str(state["section"].num)+""",本章节长度1500字左右
【章节标题】
"""+state["section"].name+"""
【章节概述】
"""+state["section"].description
result = llm.invoke(prompt)
return {"num":state["section"].num,"name":state["section"].name,"description":state["section"].description,"completedSections":[{"num":state["section"].num,"content":result.content}]}
def synthesizer(state):
completedSections = sorted(state["completedSections"],key=lambda completeSection:completeSection["num"])
novel = "\n\n".join([completeSection["content"] for completeSection in completedSections])
state["novel"] = novel
return state
生成-评估
先生成,后评估,迭代提升
def generate(state):
if state.get("feedback"):
prompt = """根据提供的主题写一篇论证文章。确保文章逻辑严密、有说服力。
主题为"""+state["topic"]+"""
同时你需要考虑如下的修改建议:"""+state["feedback"]
else:
prompt = """根据提供的主题写一篇论证文章。确保文章逻辑严密、有说服力。
主题为""" + state["topic"]
prompt = """你是一位小学生,完全不会写作文,现在需要你写一篇论证文章。
主题为""" + state["topic"]
result = llm.invoke(prompt)
state["count"] += 1
state["article"] = result.content
print("generate " + "*" * 80)
print(state["article"])
return state
def evaluate(state):
prompt = """判断【论证文章】是否很好地论证了【主题】,是否逻辑严密,有说服力。如果合格,指出文章的优点;如果不合格,给出具体的修改意见。
【主题】
"""+state["topic"]+"""
【论证文章】
"""+state["article"]
evaluator = llm.with_structured_output(Feedback)
result = evaluator.invoke(prompt)
state["qualified"] = result.grade
state["feedback"] = result.feedback
print("evaluate " + "*" * 80)
print(state["qualified"])
print(state["feedback"])
return state
智能体
自主使用工具,整合结果
def getTrainSchedule(queryDate,start,end):
"""根据指定的日期、起点城市名称和终点城市名称,查询列车班次"""
print("获取列车时刻表")
result = [["D81","12:24","14:30","北京西站","540"],["K4427","15:38","21:30","北京站","220"]]
resultStr = "您查询的在 "+queryDate+" 这一天从 "+start+" 到 "+end+" 的列车共有 "+str(len(result))+"班:\n"
for res in result:
resultStr+=res[0]+" 次列车:发车时间为: "+res[1]+" 到站时间为: "+res[2]+" 发车站为: "+res[3]+" 票价为: "+res[4]+"\n"
return resultStr
def getAvailableHotel(queryDate,location):
"""根据指定的日期和城市名称,查询可用的旅店"""
print("获取目的地旅馆的情况")
result = [["丽晶酒店", "五星级", "大床房", "1200"], ["丽晶大宾馆", "二星级", "标准间", "300"]]
resultStr = "您查询的 " + queryDate + " 这一天可以预定的酒店有" + str(len(result)) + "家:\n"
for res in result:
resultStr += res[0] + " 等级为 " + res[1] + " 房间是 " + res[2] + " 价格是: " + res[3] + "\n"
return resultStr
prompt = "你是一位可靠的个人AI助理,我要在6月15日从北京到青岛旅游,请帮我安排一下车次和旅店。这次旅行要求快捷舒适。"
result = agent.invoke(
{"messages": [{"role": "user", "content": prompt}]}
)
实操:完成六种设计模式对应的代码,并测试效果