第 3 节 / 共 9 节
智扫通 InsightScan 项目(自研 ReAct 框架)
InsightScan 智扫通项目笔记
项目简介
背景介绍
针对扫地机器人的客服系统,可以完成咨询问答以及报告生成任务 ,主要面向客户,toC使用。
项目架构
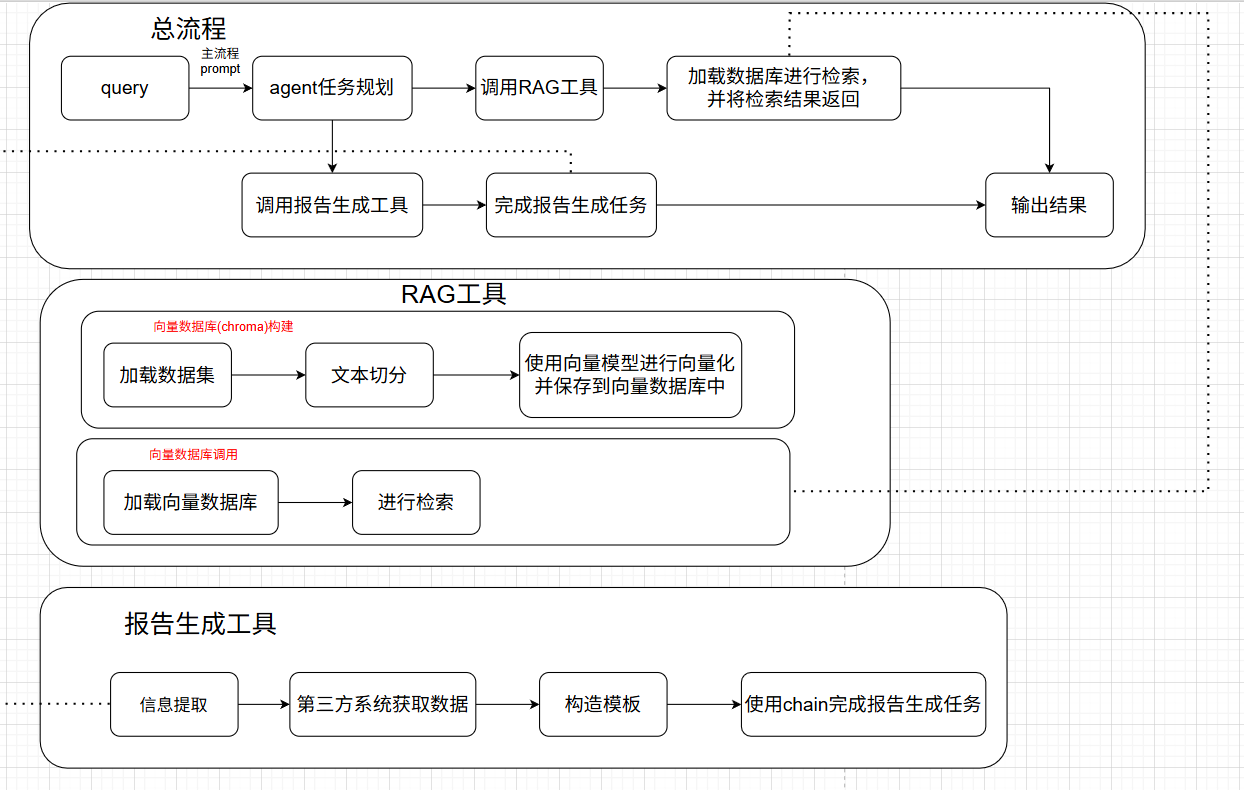
整体架构如下:
代码架构
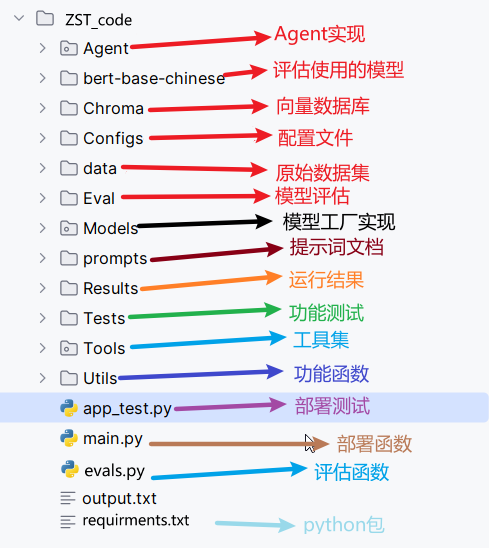
代码架构如下所示:
扩展:
在项目开始之前,需要在服务端(或者本机)使用ollama部署模型如下:
ollama run qwen3:8b
ollama run gemma3:1b
ollama run deepseek-r1:1.5b
ollama run bge-m3:latest
数据集介绍
具体保存位置如下:
ZST_code/data
架构如下:
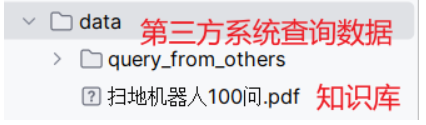
本项目数据来源于扫地机器人的产品手册及相关知识库,方便为用户解答使用问题。
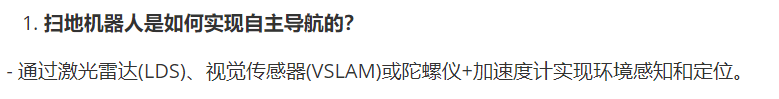
具体问题包括:基础与技术类、产品功能类、智能交互类、维护与保养类、选购指南类、技术发展类、使用技巧类、配件与耗材类、安全与隐私类、特殊场景类等问题。举例如下:
模型选型及实现
Agent模块构建(尽量理解)
Agent简介
Agent组成部分:
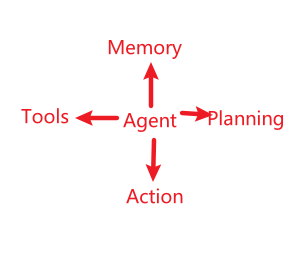
项目中Agent是基于ReAct框架实现的,它主要包括推理(Reasoning)模块以及行动(Acting)模块。
ReAct核心思想:
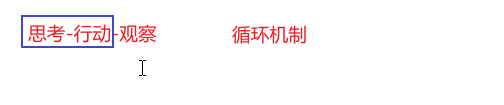
1、推理模块
【CoT】:Agent每一步生成自然语言推理逻辑,解释当前决策的原因
【错误回溯机制】:当行动失败时,Agent能分析原因并调整策略(如:“用户输入与目前所有的工具不匹配,但是提示词工程中要求必须使用工具,因此可能需要使用Rag工具,但用户输入与Rag工具不匹配,我们重新思考一下确认应该使用的工具。”)
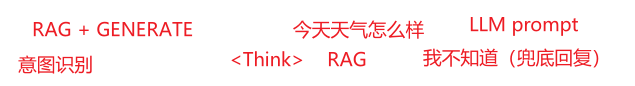
2、行动模块
【工具调用】:调用外部API、第三方数据库以及计算器等方式。
【环境状态感知】:实时接收行动结果,作为下一步决策的输入(如:“获取到北京气温25度,建议用户带薄外套。”)
具体实现
具体代码位置如下:
ZST_code/Agent
1、Action实现
具体代码位置如下:
ZST_code/Agent/Action.py
具体代码如下:
from pydantic import BaseModel,Field
from typing import List,Optional,Dict,Any

class Action(BaseModel):
    # 工具名称
    tool_name: str=Field(descrition="The name of a tool.")
    # 调用参数
    args: Optional[Dict[str,Any]] = Field(description="Input args of a tool,containing names and values")

    def __str__(self):
        # 工具名称以及调用参数组合在一起
        rst = f"Action(tool_name={self.tool_name}"
        # 判断参数是否存在
        if self.args:
            for k,v in self.args.items():
                rst += f",{k}={v}"
        rst += ")"
        return rst
2、ReAct实现
具体代码位置如下:
ZST_code/Agent/ReAct.py
具体代码实现如下:
import re
from typing import List, Optional,Tuple

from langchain_community.chat_message_histories.in_memory import ChatMessageHistory
from langchain_core.language_models.chat_models import BaseChatModel
from langchain.output_parsers import PydanticOutputParser,OutputFixingParser
from langchain.schema.output_parser import StrOutputParser
from langchain.tools.base import BaseTool
from langchain_core.prompts import ChatPromptTemplate,MessagesPlaceholder
from langchain_core.tools import render_text_description
from pydantic import ValidationError
from langchain_core.prompts import HumanMessagePromptTemplate

from Agent.Action import Action
from Utils.PrintHandler import PrintHandler,JsonFileHandler
from Utils.FileReader import ConfigHandler

conf = ConfigHandler()

class ReActAgent:
    @staticmethod
    def extract_json_from_action_rst(text:str) -> str | None:
        """从action结果中提取json"""
        pattern = re.compile(r'```json(.*?)```',flags=re.DOTALL)
        matches = pattern.findall(text)
        if matches:
            json_str = matches[-1]
            return json_str
        return None

    @staticmethod
    def format_observations(response:str,action:Action,observation:str) -> str:
        """将observation格式化"""
        rst = re.sub(r"```json(.*?)```","",response,flags=re.DOTALL)
        rst += '\n' + str(action) + '\n返回的结果是:\n' + observation
        return rst

    def __init__(self,
                 llm:BaseChatModel,
                 tools:List[BaseTool],
                 main_prompt_file_path:str):
        """初始化过程
        input:
            llm:使用的大模型
            tools:工具集
            main_prompt_file_path:主提示词的存储路径
        """
        self.llm = llm
        self.tools = tools
        # 输出格式解析器
        self.output_parser = PydanticOutputParser(pydantic_object=Action)
        try:
            # 带自动修复的输出解析器
            self.robust_parser = OutputFixingParser.from_llm(
                parser=self.output_parser,
                llm=llm
            )
        except Exception as e:
            print(f'不能修复输出,错误:{e}')
            print("请尝试提升提示词质量或者使用一个更加合适的大模型")

        # 主提示词文档路径
        self.main_prompt_file_path = main_prompt_file_path
        # 初始化提示工程
        self.__init_prompts()
        # 初始化agent的链路
        self.__init_chains()
        # 显示详细信息的处理器
        self.verbose_handler = PrintHandler() if conf.logging_flag == 0 else JsonFileHandler()

    def __init_prompts(self):
        with open(self.main_prompt_file_path,'r',encoding='utf-8') as f:
            self.prompt = ChatPromptTemplate.from_messages(
                [MessagesPlaceholder(variable_name='chat_history'),
                 HumanMessagePromptTemplate.from_template((f.read())),]
            ).partial(
                tools=render_text_description(self.tools),
                tool_names=",".join([tool.name for tool in self.tools]),
                format_instructions=self.output_parser.get_format_instructions()
            )

    def __init_chains(self):
        self.main_chains = (self.prompt | self.llm | StrOutputParser)

    def execute(self,
                task:str,
                uuid:int,
                chat_history:ChatMessageHistory,
                verbose=False) -> str:
        """对外接口
        input:
            task:用户任务
            uuid:用户的uid
            chat_history:对话历史
            verbose:是否显示详细信息
        """
        short_term_memory = []
        action,response = self.step_by_step(
            task=task,
            uuid=uuid,
            short_term_memory=short_term_memory,
            chat_history=chat_history,
            verbose=verbose
        )
        answer = self.exec_actions(action)
        self.verbose_handler.on_tool_end(answer)

        short_term_memory.append(self.format_observations(response,action,answer))
        chat_history.add_user_message(task)
        chat_history.add_ai_message(answer)
        return answer

    def step_by_step(self,
                     task:str,
                     uuid:int,
                     short_term_memory=None,
                     chat_history=None,
                     verbose=False) -> Tuple[Action,str]:
        """按步骤执行agent思考过程"""
        inputs = {
            "input":task,
            "uuid":uuid,
            "agent_scratchpad":"\n".join(short_term_memory),
            "chat_history":chat_history.messages if chat_history else chat_history
        }
        response = ""
        for s in self.main_chains.stream(inputs):
            response += s

        action_rst_json = self.extract_json_from_action_rst(response)

        action = self.robust_parser.parse(
            action_rst_json if isinstance(action_rst_json,dict) else response
        )
        return action,response

    def exec_actions(self,action:Action) -> str:
        """执行action
        input:
            action:Action对象
        """
        tool = self.confirm_tool(action.tool_name)
        if tool is None:
            observation = (
                f"错误:没找到待执行的工具或者指令'{action.tool_name}'"
                f"从提供的工具或者指令列表中选择,注意按对顶格式来输出最终内容"
            )
        else:
            try:
                observation = tool.run(action.args)
            except ValidationError as e:
                observation = (
                    f"执行动作的时候参数有非法错误 in exec_actions:{str(e)},args:{action.args}"
                )
        return observation

    def confirm_tool(self,
                     tool_name:str) -> Optional[BaseTool]:
        for tool in self.tools:
            if tool.name == tool_name:
                return tool
        return None
LLM模型选型及构建
代码位置:
ZST_code/Models/Factory.py
具体实现:
from langchain_ollama import ChatOllama,OllamaEmbeddings
import os
import sys
sys.path.append(sys.path.append(os.path.dirname(os.getcwd())))
from Utils.FileReader import ConfigHandler

# 模型配置文件获取
conf = ConfigHandler()
model_conf = conf.read_yaml("Configs/config.yml")

class ChatModelFactory:
    """ChatModel模型工厂定义"""
    def __init__(self) -> None:
        self.base_url = model_conf['server_url']

    def get_model(self):
        llm = ChatOllama(model=model_conf['model_name'],base_url=self.base_url)
        return llm


class EmbeddingModelFactory:
    """向量模型工厂定义"""
    def __init__(self):
        self.base_url = model_conf['server_url']

    def get_model(self):
        embeddings = OllamaEmbeddings(model=model_conf['embedding_name'],base_url=self.base_url)
        return embeddings
# ChatModel实例化
llm = ChatModelFactory().get_model()
# 向量模型实例化
embed_model = EmbeddingModelFactory().get_model()
工具模块构建
具体代码位置如下:
ZST_code/Tools
整体架构如下:
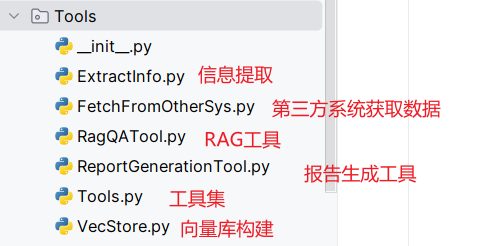
工具集声明
工具集中包括所有我们可以使用的工具声明,具体代码如下:
import warnings
warnings.filterwarnings("ignore")

from langchain.tools import StructuredTool
from .RagQATool import rag_qa
from .ReportGenerationTool import generator

rag_qa_tool = StructuredTool.from_function(
    func=rag_qa,
    name="RagQA",
    description="使用RAG检索知识进行问答"
)

report_generation_tool = StructuredTool.from_function(
    func=generator,
    name="ReportGeneration",
    description="从第三方系统查询信息,完成报告"
)
RAG工具模块构建
1、文档读取模块构建
具体代码如下:
from langchain_community.document_loaders import UnstructuredWordDocumentLoader,PyPDFLoader
import yaml
import pandas as pd

class FileReader:
    """知识库文档读取"""
    def __init__(self):
        pass

    def read_docx(self,file_path):
        """读取word文档"""
        try:
            loader = UnstructuredWordDocumentLoader(file_path)
            doc = loader.load_and_split()
            return doc
        except FileNotFoundError as e:
            print(f'错误:文件{file_path}未找到')
            return None
        except Exception as e:
            print(f'读取文件出错:{e}')
            return None

    def read_md(self,file_path):
        """读取markdown文档"""
        try:
            with open(file_path,'r',encoding='utf-8') as f:
                content = f.read()
                return content
        except FileNotFoundError as e:
            print(f'错误:文件{file_path}未找到')
            return None
        except Exception as e:
            print(f'读取文件出错:{e}')
            return None

    def read_pdf(self,file_path):
        """读取pdf文档"""
        try:
            loader = PyPDFLoader(file_path)
            pages = loader.load_and_split()
            return pages
        except FileNotFoundError as e:
            print(f'错误:文件{file_path}未找到')
            return None
        except Exception as e:
            print(f'读取文件出错:{e}')
            return None

    def read_csvs(self,file_path,sep=','):
        """读取csv文档"""
        try:
            data = pd.read_csv(file_path,sep=sep)
            return data
        except FileNotFoundError as e:
            print(f'错误:文件{file_path}未找到')
            return None
        except Exception as e:
            print(f'读取文件出错:{e}')
            return None


class ConfigHandler:
    """配置文件读取"""
    def __init__(self):
        pass

    def read_yaml(self,file_path="Configs/rag_config.yml",encoding='utf-8'):
        with open(file_path,'r',encoding=encoding) as f:
            return yaml.load(f.read(),Loader=yaml.FullLoader)


reader = FileReader()
config_reader = ConfigHandler()
2、向量数据库模块构建
具体位置如下:
ZST_code/Tools/VecStore.py
也可以直接调用如下代码:
ZST_code/Utils/create_db.py
- 整体架构
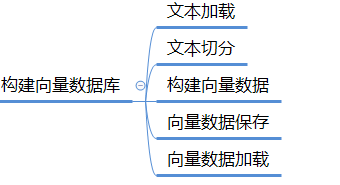
构建向量数据库包括文本加载、切分、数据库构建、保存及加载等步骤。
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain.schema import Document
from langchain_community.vectorstores import Chroma
import os
import sys
sys.path.append('../..')
sys.path.append('.')
sys.path.append('./')
from Utils.FileReader import reader,config_reader
from Models.Factory import embed_model

# RAG配置文件初始化
conf = config_reader.read_yaml("Configs/rag_config.yml")

class VecStore:
    def __init__(self,dir=conf['DATA_PATH'],save_dir=conf['CHROMA_PATH']):
        # 知识库路径
        self.dir = dir
        # 向量数据库保存路径
        self.save_dir = save_dir

    def load_documents(self):
        """知识库加载,可以加载word,markdown,pdf,csv文档"""
        files = os.listdir(self.dir)
        docs = []
        for file in files:
            file_path = os.path.join(self.dir,file)
            if file.endswith('.docx'):
                txts = reader.read_docx(file_path)
            elif file.endswith('.md'):
                txts = reader.read_md(file_path)
            elif file.endswith('.pdf'):
                txts = reader.read_pdf(file_path)
            elif file.endswith('.csv'):
                txts = reader.read_csvs(file_path)
            else:
                txts = []
            docs.extend(txts)
        return docs

    def split_text(self,documents):
        """文档切分,使用固定字符长度进行切分"""
        text_spliter = RecursiveCharacterTextSplitter(
            chunk_size=200,
            chunk_overlap=80,
            length_function=len,
            add_start_index=True
        )
        chunks = text_spliter.split_documents(documents)
        return chunks

    def get_db(self):
        """获取向量数据库"""
        documents = self.load_documents()
        chunks = self.split_text(documents)
        db = Chroma.from_documents(documents=chunks,embedding=embed_model,persist_directory=self.save_dir)
        return db

    def save_to_chroma(self,db):
        """将向量数据库保存"""
        db.persist()
        print(f"Saved chunks to {conf['CHROMA_PATH']}")

    def load_chroma(self):
        """向量数据库加载"""
        db = Chroma(persist_directory=self.save_dir,embedding_function=embed_model)
        return db

if __name__=="__main__":
    """向量数据库构建"""
    vec = VecStore()
    db = vec.get_db()
    vec.save_to_chroma(db)
运行结果如下图所示:

3、RAG工具调用
代码位置如下:
ZST_code/Tools/RagQATool.py
具体代码如下:
from langchain.chains import RetrievalQA
from Models.Factory import llm
from Tools.VecStore import VecStore

vec = VecStore()
db = vec.load_chroma()

def rag_qa(query):
    qa = RetrievalQA.from_chain_type(
        llm=llm,
        # stuff:将检索到的文档都给LLM让他生成答案
        # map_reduce:单独发送给LLM,生成摘要
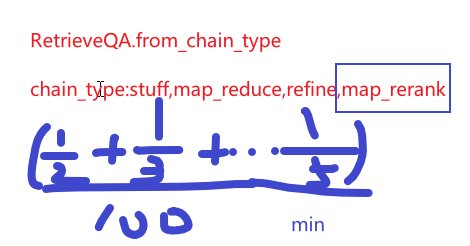
        # refine:迭代处理文档
        # map_rerank:让LLM对每一个文档评分给出一个置信度分数,重排,取置信度最高的文档
        chain_type="stuff",
        retriever=db.as_retriever(search_kwargs={"k":5}),
        return_source_documents=True
    )
    response = qa(query)
    return response['result']
功能测试代码如下:
import sys
sys.path.append('../..')
sys.path.append('.')
sys.path.append('./')
from Tools.RagQATool import rag_qa

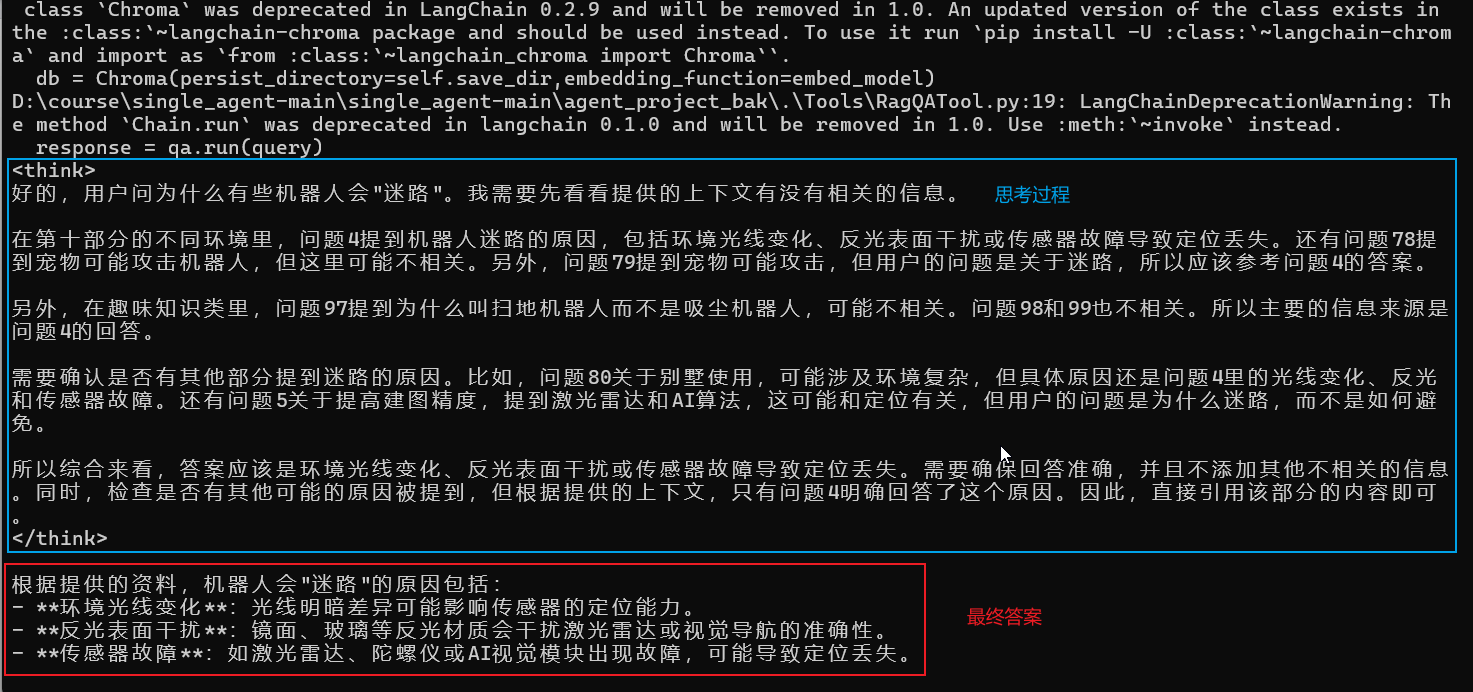
print(rag_qa("为什么有些机器人会'迷路'?"))
运行结果如下图所示:
报告生成工具构建
报告生成需要经过以下几个步骤:从query中进行信息提取-->从第三方系统中获取数据-->将所有信息组合在一起再调用大模型进行报告生成。
1、信息提取
具体代码如下:
from Models.Factory import llm
import json
from tenacity import retry,stop_after_attempt,wait_fixed
import re

# 如果一次调用大模型失败,多尝试几次确保调用成功
@retry(stop=stop_after_attempt(3),wait=wait_fixed(2))
def invoke_llm(prompt):
    return llm.invoke(prompt)

def extract_info(query):
    system_prompt = """
    你是一个优秀的信息提取专家,你的任务是从输入文本中获取时间这个参数值。
    返回JSON格式:{"时间":"2025-01"}.
    如果输入文本中没有相关参数,则返回空。
    举例如下:
    输入文本:使用2025年1月份的
    返回结果:{"时间":"2025-01"}
    输入文本:根据我的扫地机器人的使用情况,生成一份使用报告
    返回结果:{}
    """
    data = {}
    human_prompt = f"输入文本:{query},请返回提取的json。"
    # 提示词组合
    prompt = [
        {
            "role":"system",
            "content":system_prompt
        },
        {
            "role":"user",
            "content":human_prompt
        }
    ]
    # 大模型返回结果
    response = invoke_llm(prompt)
    if response:
        # 获取返回结果内容
        content = response.content
        # 正则提取结果
        match = re.search(r'\{.*\}',content)
        # 正则提取成功的话,获取比较干净的json
        if match:
            cleaned_json = match.group(0)
            data = json.loads(cleaned_json)
        else:
            print("未找到有效的json")
    return data
功能测试代码如下:
import sys
sys.path.append('../..')
sys.path.append('.')
sys.path.append('./')
from Tools.ExtractInfo import extract_info

print(extract_info("根据我的扫地机器人的使用情况,生成一份使用报告,要2025年6月份的"))
运行结果:

2、第三方系统中获取数据
具体代码如下:
import sys
sys.path.append('../..')
sys.path.append('.')
sys.path.append('./')
from Utils.FileReader import FileReader
import pandas as pd
from datetime import datetime

def fetch_data_from_external_systems(uuid=1001,info_dict={}):
    """根据传入的信息,从第三方系统中获取返回值

    Args:
        uuid (int): 用户ID,示例:{"uuid":"1001"}
        info_dict(json):从query中提取的时间,如:{"时间":"2025-01"}

    Returns:
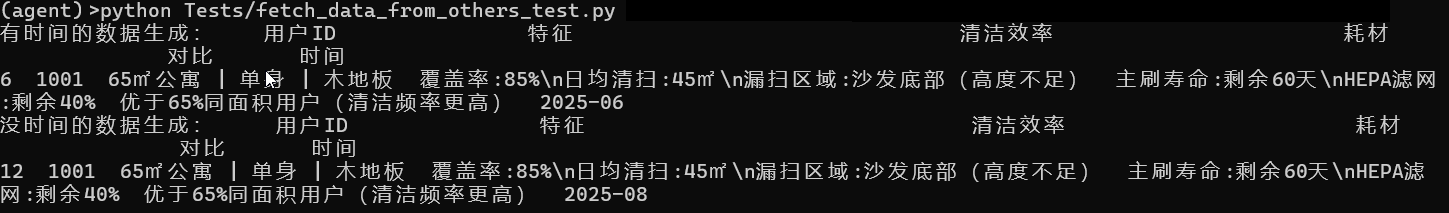
        result: 查询到的信息,list格式,示例:result = [1001,"65㎡公寓 | 单身 | 木地板","覆盖率:85%\n日均清扫:45㎡\n漏扫区域:沙发底部(高度不足)","主刷寿命:剩余60天\nHEPA滤网:剩余40%","优于65%同面积用户(清洁频率更高)","2025-06"]
    """
    result = None
    try:
        reader = FileReader()
        data = reader.read_csvs(r'data\query_from_others\query_data.csv')
        # query 中有时间信息
        if '时间' in info_dict.keys():
            # 获取query中提取的时间
            query_time = info_dict['时间']
            # 根据query中提取的时间和uid获取扫地机器人的使用情况
            result = data[(data['用户ID'] == uuid) & (data['时间'] == query_time)]
            # 如果query中提取的时间在数据库中不存在数据的话,默认使用25年6月份的数据
            if len(result) == 0:
                result = data[(data['用户ID'] == uuid) & (data['时间'] == '2025-06')]
                # print('当前时间没有该用户的扫地机器人使用情况') 实际开发需要
        # query中没有时间的话
        else:
            # 获取当前年月
            current_year_month = datetime.now().strftime("%Y-%m")
            # 获取当前年月对应的数据
            result = data[(data['用户ID'] == uuid) & (data['时间'] == current_year_month)]
            # 如果当前年月没有对应数据的话,默认使用25年8月份
            if len(result) == 0:
                result = data[(data['用户ID'] == uuid) & (data['时间'] == "2025-08")]
                # print('当前时间没有该用户的扫地机器人使用情况') 实际开发需要
    except Exception as e:
        print(f'从第三方系统获取信息出错:{e}')
    return result
功能测试代码如下:
import sys
sys.path.append('../..')
sys.path.append('.')
sys.path.append('./')
from Tools.FetchFromOtherSys import fetch_data_from_external_systems
from Tools.ExtractInfo import extract_info

# query中有时间信息
a = extract_info("根据我的扫地机器人的使用情况,生成一份使用报告,要2025年6月份的")
b = fetch_data_from_external_systems(info_dict=a)
print('有时间的数据生成:',b)

# query中没有时间信息
a1 = extract_info("根据我的扫地机器人的使用情况,生成一份使用报告")
b1 = fetch_data_from_external_systems(info_dict=a1)
print('没时间的数据生成:',b1)
运行结果如下图所示:
3、报告生成
具体代码如下:
from langchain_core.output_parsers import StrOutputParser
from langchain_core.runnables import RunnablePassthrough
from langchain_core.prompts import PromptTemplate
import os
import sys
sys.path.append('../..')
sys.path.append('.')
sys.path.append('./')
sys.path.append(os.path.dirname(os.getcwd()))
from Models.Factory import llm
from .ExtractInfo import extract_info
from .FetchFromOtherSys import fetch_data_from_external_systems
from Utils.FileReader import config_reader

model_conf = config_reader.read_yaml('Configs/config.yml')

def generator(query,uuid=1001,verbose=False):
    try:
        # 报告生成提示词
        prompt = []
        # 读取报告生成提示词
        with open(model_conf['reporter_prompt_path'],'r',encoding='utf-8') as f:
            for line in f:
                prompt.append(line.strip())
        # 使用大模型进行信息提取,提取时间
        report_param = extract_info(query)
        # 如果格式不是字典的 话,报错
        if not isinstance(report_param,dict):
            return f"信息提取返回结果格式不对,请检查,返回信息为:{report_param}"
        # 从第三方系统中获取数据
        information = fetch_data_from_external_systems(uuid,report_param)
        # 获取数据是空的话,返回空
        if information is None:
            return ""
        # 构造模板
        template = PromptTemplate(
            template="".join(prompt),
            input_variable=["INFORMATION"]
        )
        # 模板格式化
        formatted_prompt = template.format(INFORMATION=information)
        # 从格式化的模板中获取最终使用的提示词模板
        final_template = PromptTemplate.from_template(formatted_prompt)
        # 运行链路
        chain = {"query":RunnablePassthrough} | final_template | llm | StrOutputParser()
        # 根据链路获取大模型生成的答案
        answer = chain.invoke(query)
        return answer
    except Exception as e:
        print(e)
        return None
功能测试代码如下:
import sys
sys.path.append('../..')
sys.path.append('.')
sys.path.append('./')
from Tools.ReportGenerationTool import generator

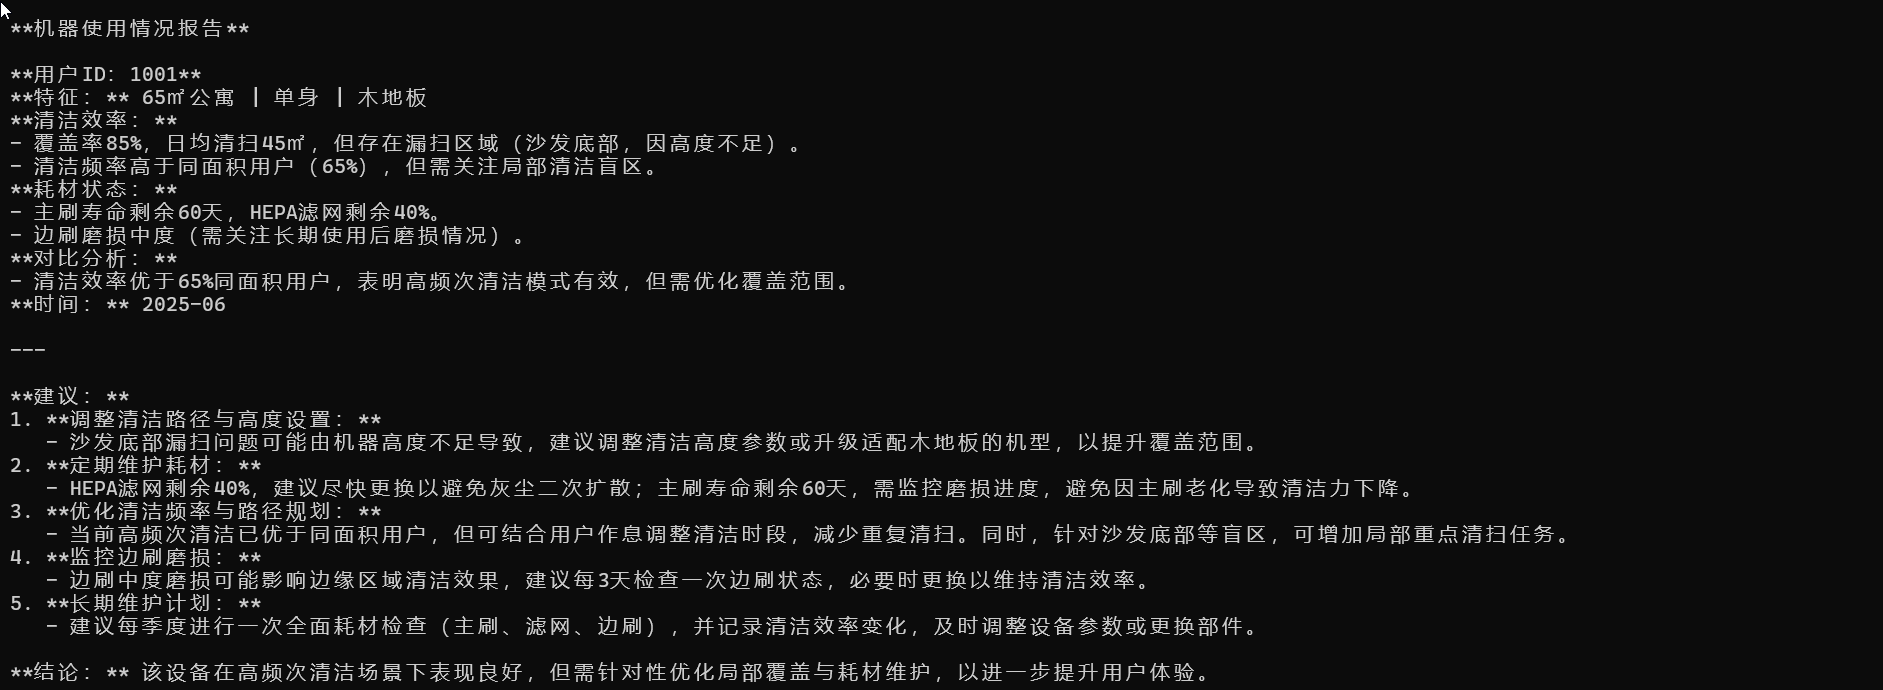
b = generator("根据我的扫地机器人的使用情况,生成一份使用报告,要2025年6月份的")
print(b)
运行结果如下:
提示词模块构建
具体位置如下:
ZST_code/prompts
架构如下:
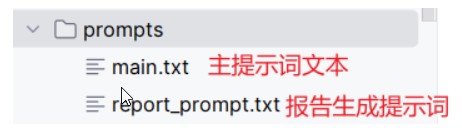
主提示词文本内容如下:
你是强大的AI助手,可以使用工具与指令自动化解决问题。

你的任务是:
{input}

你可以使用以下工具或指令,它们又称为动作或actions:
{tools}

你必须遵循以下约束来完成任务。
1. 每次决策只使用一种工具。
2. 你所调用的指令或者工具在给定的下述工具列表中, {tool_names}。
3. 保证你的回答中不会包含违法或者侵犯性的信息。
4. 如果执行某个工具失败,请尝试改变参数或参数格式再次调用。
5. 你生成的回复必须符合上文中给定的事实信息。不可以编造信息。DO NOT MAKE UP INFORMATION.
6. 保证你生成的动作可以精确执行。
7. 使用中文回答。
8. 不要构造query。用户输入什么,问题就是什么,不要扩充问题。
9. 如果query跟可使用的工具无关,请直接返回“我不知道”。

输出形式如下:
{format_instructions}
请确保你输出的JSON代码块以```json\n\n```包裹。
报告生成提示词文本:
你是专业的报告写手。根据查询回来的信息,写一份机器使用情况报告并给出建议。
信息格式如下:
```
用户ID,特征,清洁效率,耗材,对比,时间
1002,70㎡公寓 | 情侣 | 瓷砖,"覆盖率:88% \n避障失败:2次/周(电线缠绕)","边刷磨损:中度 \n尘盒清理:每3天",拖地功能使用率低于同类30%,2025-01
```
返回结果如上格式。
最终查回来的信息如下:
{INFORMATION}
根据查询回来的信息,使用中文生成一份报告,要求将查询回来的信息组装成一份文本内容,并根据使用情况给出具体建议,不要将查询回来的内容直接输出。
模型评估
具体位置如下:
ZST_code/Eval
整体内容如下:
评估指标简介
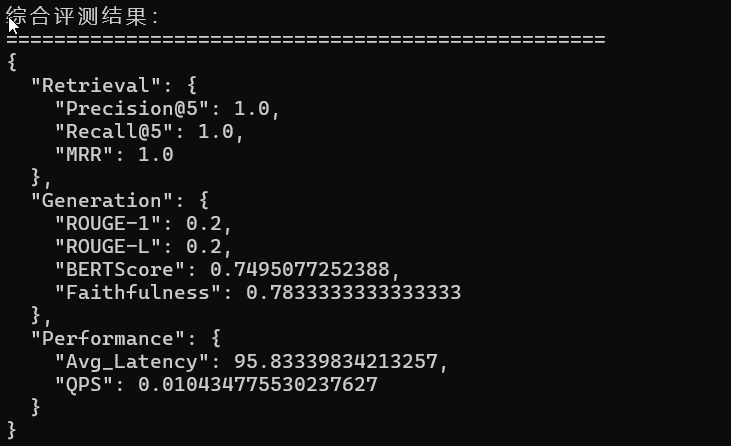
1、检索效果的评估:precision,recall,mrr(平均倒数排名)
MRR计算公式:
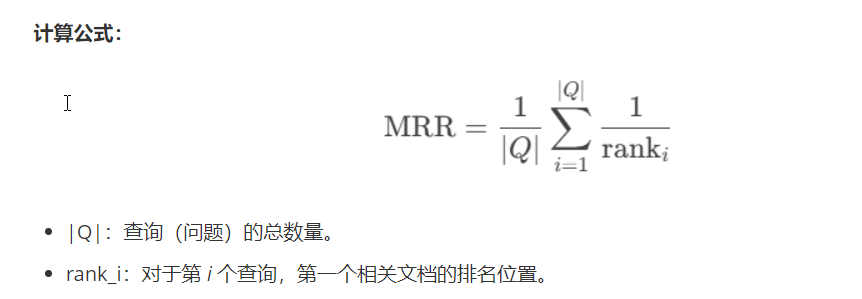
2、生成评估指标:rouge-1,rouge-l,bertscore,faithfulness
3、项目总评估:qps,平均延时(avg_latency)
代码实现
具体代码如下:
import json
import time
import numpy as np
import re
from rouge_score import rouge_scorer
from transformers import AutoModel, AutoTokenizer
import torch
from bert_score import BERTScorer
from bert_score.utils import get_model, lang2model, model2layers
from transformers import pipeline
from sklearn.metrics import precision_score, recall_score
import pandas as pd
import jieba
import sys,os
sys.path.append('../..')
sys.path.append('.')
sys.path.append('./')
from Agent.ReAct import ReActAgent
from Models.Factory import ChatModelFactory
from Tools.Tools import *
from Tools.RagQATool import rag_qa
from langchain_community.chat_message_histories.in_memory import ChatMessageHistory
from tqdm import tqdm
import random
import ast

device = "cuda" if torch.cuda.is_available() else "cpu"
stopwords = []
with open(r'D:\course\single_agent-main\single_agent-main\agent_project_bak\stopwords.txt','r',encoding='utf-8') as f:
    for line in f:
        stopwords.append(line.strip())

# 1. 准备评测数据
eval_data = pd.read_csv(os.path.join(os.getcwd(),'Eval/eval_data.csv'))

# 2.获取agent
llm = ChatModelFactory().get_model()

tools = [
    rag_qa_tool,
    report_generation_tool,
]

agent = ReActAgent(
    llm=llm,
    tools=tools,
    main_prompt_file_path="prompts/main.txt"
)

def launch_agent(query,agent,uuid=1001):
    chat_history = ChatMessageHistory()
    reply = agent.execute(query,uuid,chat_history=chat_history,verbose=True)
    return reply

# 3. 评测指标计算函数
def evaluate_retrieval(true_docs,retrieved_docs):
    """计算评估指标"""
    y_true = [1 if doc in true_docs else 0 for doc in retrieved_docs] # True
    y_pred = [1] * len(retrieved_docs) # all

    precision = precision_score(y_true,y_pred,zero_division=0)
    recall = recall_score(y_true,y_pred)
    mrr = 1 / (true_docs.index(retrieved_docs[0]) + 1) if retrieved_docs[0] in true_docs else 0
    return {
        "Precision@5":precision,
        "Recall@5":recall,
        "MRR":mrr
    }

def load_bert_scorer():
    #加载自定义模型和分词器
    model_path = os.path.join(os.getcwd(),'bert-base-chinese')
    tokenizer = AutoTokenizer.from_pretrained(model_path)
    # 手动加载模型配置
    num_layers = model2layers.get(os.path.basename(model_path),12)
    model_type = lang2model.get('zh','bert-base-chinese')
    model = AutoModel.from_pretrained(model_path)

    return BERTScorer(
        model_type=model_type,
        num_layers=num_layers,
        lang='zh',
        use_fast_tokenizer=True,
        rescale_with_baseline=False,
        device=model.device
    )


def evaluate_generation(precision,reference,context):
    """计算生成指标"""
    # ROUGE
    scorer = rouge_scorer.RougeScorer(['rouge1','rougeL'],use_stemmer=False)
    rouge = scorer.score(reference,precision)

    # BERTScore
    bert_scorer = load_bert_scorer()
    _,_,bert_f1 = bert_scorer.score([precision],[reference])

    # 忠实度(简易版:检测关键实体是否一致)
    random.seed(42)
    key_entities =set([word for word in jieba.lcut(reference) if word not in stopwords])
    precision_entities = set([word for word in jieba.lcut(precision) if word not in stopwords])
    faithful = sum(1 for e in key_entities if e in precision_entities) / max(1,len(key_entities))

    return {
        'ROUGE-1':rouge['rouge1'].fmeasure,
        'ROUGE-L':rouge['rougeL'].fmeasure,
        'BERTScore':bert_f1.mean().item(),
        'Faithfulness':faithful
    }

def preprocess_text(text):
    """统一的文本预处理函数"""
    # 转换为小写
    text = text.lower()
    text = re.sub(r'\n','',text)
    # 移除标点符号
    text = re.sub(r'[- *]+', ',', text).replace(",,|:,",',')
    # 移除多余空格
    text = re.sub(r'\s+', ' ', text)
    return text

# 4. 主评测流程
results = []
latencies = []
eval_data['reference_docs'] = eval_data['reference_docs'].apply(ast.literal_eval)
for i in tqdm(range(len(eval_data))):
    item = eval_data.iloc[i]
    start_time = time.time()
    query = item['query']
    reference = ''.join(item['reference_docs'])
    reference_answer = item['reference_answer']
    response = launch_agent(query,agent,1001)

    if '<think>' in response and '</think>' in response:
        answer = re.sub(r"<think>.*?</think>","",response,flags=re.DOTALL)
    elif '<think>' in response and '</think>\n\n答:' in response:
        answer = re.sub(r"<think>.*?</think>\n\n答:","",response,flags=re.DOTALL)
    else:
        answer = response
    # 执行RAG流程
    retrieved_docs = rag_qa(item['query'])

    # 记录延迟
    latency = time.time() - start_time
    latencies.append(latency)
    # 评估各模块
    retrieval_metrics = evaluate_retrieval(retrieved_docs,retrieved_docs)
    ## 文本预处理
    reference_processed = preprocess_text(reference)
    precision_processed = preprocess_text(answer)
    generation_metrics = evaluate_generation(precision_processed,reference_processed,retrieved_docs)

    results.append({
        **retrieval_metrics,
        **generation_metrics
    })

# 5. 汇总结果
aggregates = {
    "Retrieval":{
        "Precision@5": np.mean([r['Precision@5'] for r in results]),
        "Recall@5": np.mean([r['Recall@5'] for r in results]),
        "MRR": np.mean([r['MRR'] for r in results]),
    },
    "Generation":{
        "ROUGE-1":np.mean([r['ROUGE-1'] for r in results]),
        "ROUGE-L":np.mean([r['ROUGE-L'] for r in results]),
        "BERTScore":np.mean([r['BERTScore'] for r in results]),
        "Faithfulness":np.mean([r['Faithfulness'] for r in results]),
    },
    "Performance":{
        "Avg_Latency":np.mean(latencies),
        "QPS":1 / np.mean(latencies)
    }
}

print('=' * 50 + '\n综合评测结果:\n' + '=' * 50)
print(json.dumps(aggregates,indent=2))
运行结果如下:
日志打印
简介说明
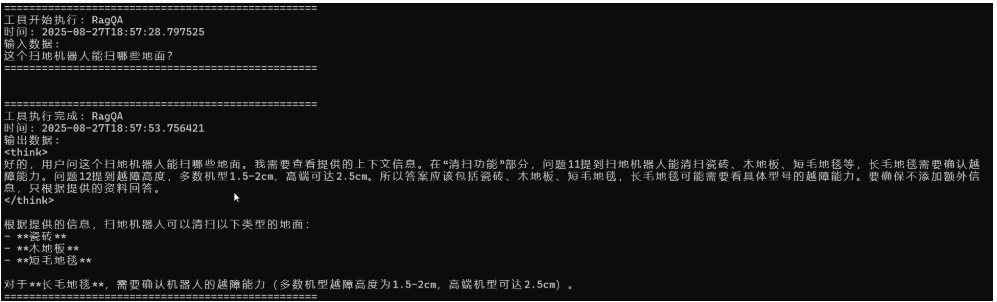
两类:一类本地测试在控制台打印日志;一类在生产环境/测试环境打印日志,保存到json文件中
代码实现
代码位置:
ZST_code/Utils/PrintHandler.py
代码如下:
from abc import ABC,abstractmethod
from typing import Any,Dict,Optional
import json
from datetime import datetime

class VerboseHandler(ABC):
    """抽象基类,用于处理详细输出"""
    @abstractmethod
    def on_tool_start(self,tool_name:str,input_data:Any) -> None:
        pass

    @abstractmethod
    def on_tool_end(self,tool_name:str,output_data:Any,metadata:Optional[Dict]=None)->None:
        pass

    @abstractmethod
    def on_tool_error(self,tool_name:str,error:Exception) -> None:
        pass


class PrintHandler(VerboseHandler):
    """具体的详细输出处理器,将信息打印到控制台"""
    def __init__(self,verbose:bool=True,indent:int=2):
        self.verbose = verbose
        self.indent = indent

    def on_tool_start(self,tool_name:str,input_data:Any) -> None:
        if not self.verbose:
            return
        print(f"\n{'='*50}")
        print(f'工具开始执行:{tool_name}')
        print(f"时间:{datetime.now().isoformat()}")
        print("输入数据:")
        self._print_formatted(input_data)
        print(f"\n{'='*50}")

    def on_tool_end(self,tool_name:str,output_data:Any,metadata:Optional[Dict]=None) ->None:
        if not self.verbose:
            return
        print(f"\n{'=' * 50}")
        print(f'工具执行完成:{tool_name}')
        print(f"时间:{datetime.now().isoformat()}")
        print("输出数据:")
        self._print_formatted(output_data)
        if metadata:
            print("元数据:")
            self._print_formatted(metadata)
        print(f"\n{'=' * 50}")

    def on_tool_error(self,tool_name:str,error:Exception) -> None:
        if not self.verbose:
            return
        print(f"\n{'=' * 50}")
        print(f'工具执行出错:{tool_name}')
        print(f"时间:{datetime.now().isoformat()}")
        print(f"错误信息:{str(error)}")
        print(f"\n{'=' * 50}")

    def _print_formatted(self,data:Any) -> None:
        try:
            if isinstance(data,(dict,list)):
                formatted = json.dumps(data,indent=self.indent,ensure_ascii=False)
                print(formatted)
            else:
                print(str(data))
        except Exception as e:
            print(f"无法格式化输出:{e}")
            print(str(data))


class JsonFileHandler(VerboseHandler):
    """将详细输出保存到JSON文件"""
    def __init__(self,file_path):
        self.file_path = file_path
        self.logs = []

    def on_tool_start(self,tool_name:str,input_data:Any) -> None:
        log_entry = {
            "event":"tool_start",
            "tool_name":tool_name,
            "timestamp":datetime.now().isoformat(),
            "input_data":input_data
        }
        self.logs.append(log_entry)
        self._save_logs()

    def on_tool_end(self,tool_name:str,output_data:Any,metadata:Optional[Dict]=None) ->None:
        log_entry = {
            "event": "tool_end",
            "tool_name": tool_name,
            "timestamp": datetime.now().isoformat(),
            "output_data": output_data,
            "metadata": metadata or {}
        }
        self.logs.append(log_entry)
        self._save_logs()

    def on_tool_error(self,tool_name:str,error:Exception) -> None:
        log_entry = {
            "event": "tool_error",
            "tool_name": tool_name,
            "timestamp": datetime.now().isoformat(),
            "error": str(error)
        }
        self.logs.append(log_entry)
        self._save_logs()

    def _save_logs(self) -> None:
        """将日志保存到文件中"""
        with open(self.file_path,'w',encoding='utf-8') as f:
            json.dump(self.logs,f,indent=2,ensure_ascii=False)
运行结果如下图所示:
模型部署
服务端
代码位置:
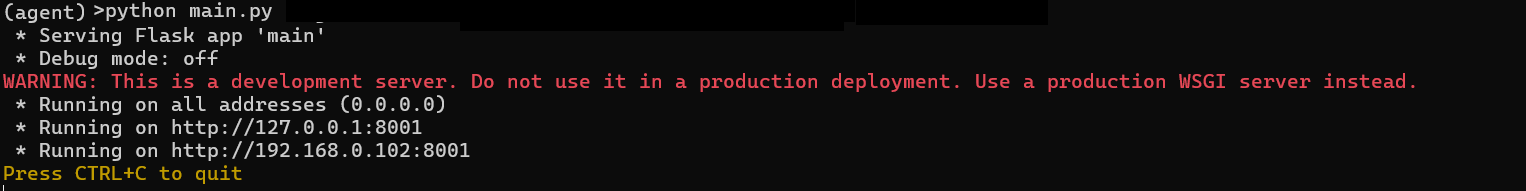
ZST_code/main.py
# 具体代码实现过程
from Agent.ReAct import ReActAgent
from Models.Factory import ChatModelFactory
from Tools.Tools import *
from langchain_community.chat_message_histories.in_memory import ChatMessageHistory
from flask import Flask,request,jsonify
import re

app = Flask(__name__)

def launch_agent(query,agent,uuid=1001):
    chat_history = ChatMessageHistory()
    reply = agent.execute(query,uuid,chat_history=chat_history,verbose=True)
    return reply

@app.route("/predict",methods=["POST"])
def main():
    try:
        data = request.get_json()
        query = data.get("sentence","")
        uuid = data.get("uuid",1001)
        if not query:
            return jsonify({"error":"请输入文本"}),400
        llm = ChatModelFactory().get_model()

        tools = [
            rag_qa_tool,
            report_generation_tool,
        ]

        agent = ReActAgent(
            llm=llm,
            tools=tools,
            main_prompt_file_path="prompts/main.txt"
        )

        response = launch_agent(query,agent,uuid)

        if '<think>' in response and '</think>' in response:
            answer = re.sub(r"<think>.*?</think>", "", response, flags=re.DOTALL)
        elif '<think>' in response and '</think>\n\n答:' in response:
            answer = re.sub(r"<think>.*?</think>\n\n答:", "", response, flags=re.DOTALL)
        else:
            answer = response
        return jsonify({"answer":answer}),200

    except Exception as e:
        print(e)
        return jsonify({"error":str(e)}),500

if __name__=="__main__":
    app.run(host="0.0.0.0",port=8001)
运行结果如下图所示:
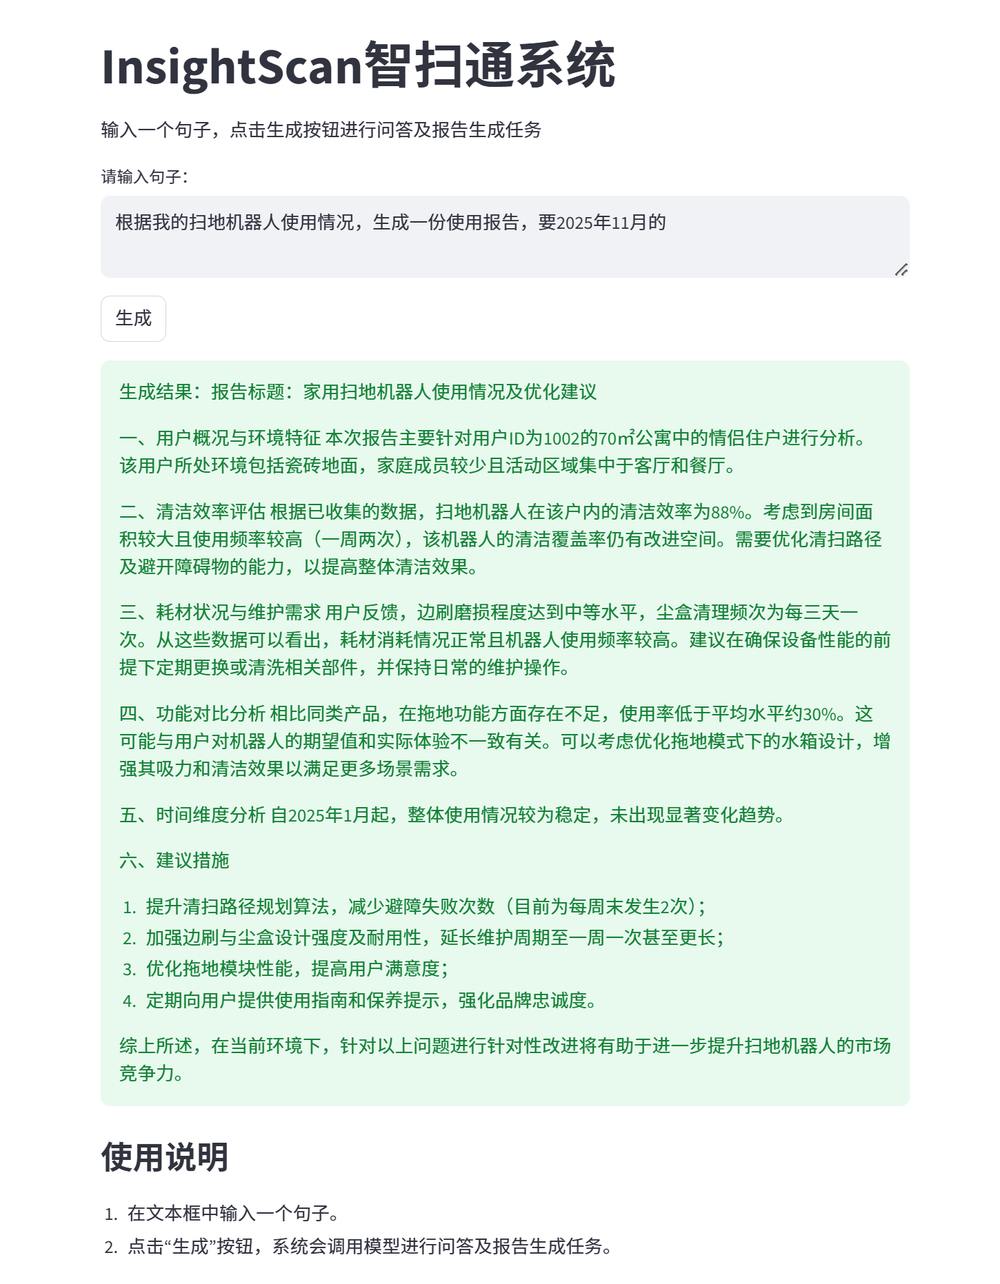
客户端
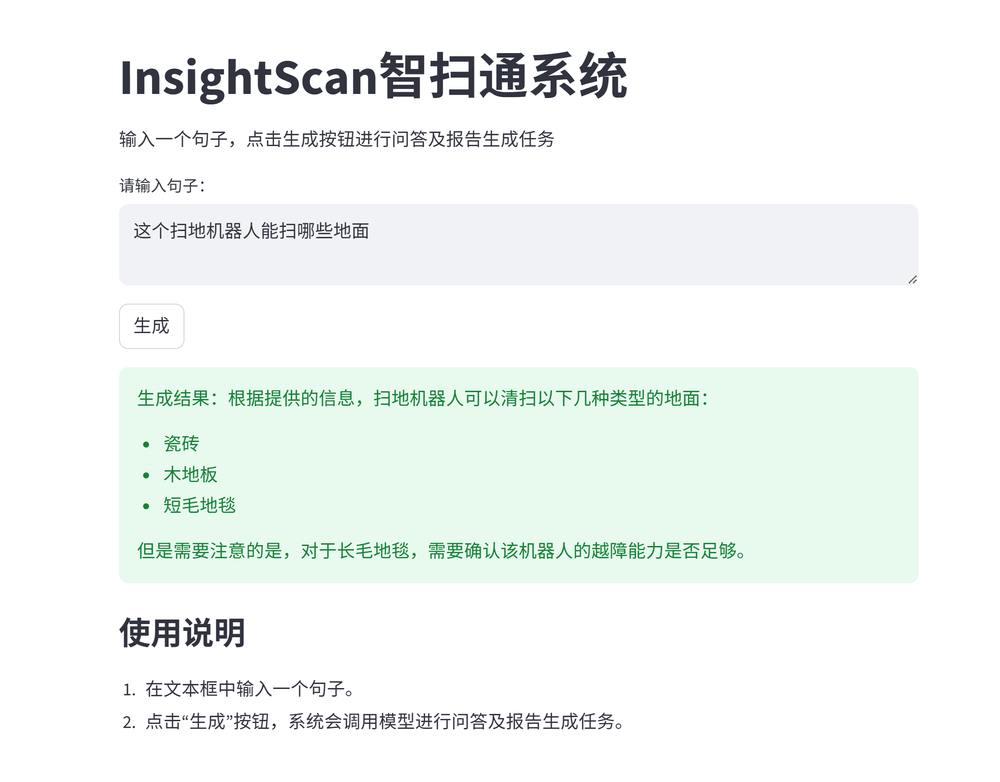
注意:在进行问答任务及报告生成任务时,完成速度依赖于部署服务的机器性能,如果是利用32G的V100部署云端服务器,问答任务耗时20-40s,报告生成任务耗时1分钟左右;但如果是笔记本自带的GPU ,比如3060,问答任务可能耗时10多分钟,报告生成任务耗时1个多小时。整体耗时大家要根据自己的机器来看。
代码位置:
ZST_code/app_test_web.py
具体代码实现:
import streamlit as st
import requests

# Streamlit页面配置
st.title("扫地机器人智能客服系统")
st.write("输入一个句子,点击生成按钮进行问答及报告生成任务")

# 输入框
sentence = st.text_area("请输入句子:",height=100)

# 生成按钮
if st.button("生成"):
    if not sentence.strip():
        st.error("请输入有效的句子!")
    else:
        try:
            # 调用FLask API
            response = requests.post("http://192.168.0.102:8001/predict",json={'sentence':sentence,"uuid":1001})
            response.raise_for_status()
            result = response.json()
            if 'answer' in result:
                st.success(f"生成结果:{result['answer']}")
            else:
                st.error(f"错误:{result.get('error','未知错误')}")
        except requests.exceptions.RequestException as e:
            st.error(f'无法连接到API:{str(e)}')

# 添加说明
st.markdown("""
### 使用说明
1. 在文本框中输入一个句子。
2. 点击“生成”按钮,系统会调用模型进行问答及报告生成任务。
""")
运行结果如下:
问答任务运行结果如下:
报告生成任务运行结果如下:
补充:配置文件
代码位置:
D:\course\single_agent-main\single_agent-main\agent_project\Configs
结构如下图所示:
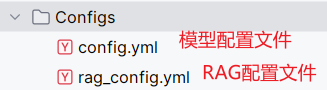
模型配置文件
代码位置如下所示:
D:\course\single_agent-main\single_agent-main\agent_project\Configs\config.yml
具体代码如下:
# 生成模型名称
model_name: qwen3:8b
# model_name: deepseek-r1:1.5b
#model_name: gemma3:1b
# 向量模型名称
embedding_name: bge-m3:latest
# ollama部署模型的ip+port
server_url: http://127.0.0.1:11434
# 报告生成提示词文件路径
reporter_prompt_path: prompts/report_prompt.txt

# 打印日志时的控制按钮,取0的时候是本地,使用PrintHandler;取1的时候,是生产环境,使用JsonFileHandler
logging_flag: 0
RAG配置文件
代码位置如下所示:
D:\course\single_agent-main\single_agent-main\agent_project\Configs\rag_config.yml
具体代码如下:
# 向量数据库保存路径
CHROMA_PATH: Chroma
# 原始知识库路径
DATA_PATH: Data
项目导图
🧠 InsightScan智扫通Agent项目.xmind · 大纲
InsightScan智扫通Agent项目
课程目的
day01_项目架构、项目环境搭建
项目背景
项目需求分析
需求:
项目环境搭建
创建虚拟环境
进入虚拟环境
安装项目所需要的包
olllama安装
windows系统
macOS系统
ollama模型部署
day02_核心技术基础
大模型管理工具Ollama
查看模型列表
拉取模型
结束终端会话
大模型开发框架LangChain
Langchain框架
models
主要类型
LLMs
Chat Model
Embedding Model
prompts
zero shot
few shot
chain
将使用大模型过程中各个组件组合在一起
代码实现
memory
短期记忆
index(RAG)
目的
组件构成
文档加载器
文本分割器
VectorStores
检索器
agent
组件基本元素
应用场景
大模型核心技术RAG
交付能力
课程内容
RAG系统必要性
大模型幻觉问题
RAG优点
RAG系统核心组件
向量化模块
文档加载与切分模块
数据库模块
检索模块
生成模块
实操
大模型核心技术ReAct
交付能力
课程内容
ReAct介绍
论文名称
作者
核心思想
三思而后行
Thought (思考)
Act (行动)
Observation (观察)
ReAct案例
实操
大模型技术Agentic RAG
交付能力
课程内容
实操
day03_主体搭建
Agent流程
ReAct简介
推理模块
行动模块
模型工厂
EmbeddingModelFactory(向量模型工厂)
构建提示词文本
工具集创建
RAG工具
报告生成工具
信息提取
从第三方系统获取数据
报告生成
day04_项目部署
部署
测试
day05_拓展-计算机视觉开发+多模态开发
项目知识库:扫地机器人 100 问
- 📕 扫地机器人100问.pdf 188.2KB
智扫通项目完整源码
39 个文件📁 Agent/
- 📄 Action.py 493B 下载
- 📄 ReAct.py 9.8KB 下载
- 📄 __init__.py 0B 下载
📁 Configs/
- 📄 config.yml 204B 下载
- 📄 rag_config.yml 59B 下载
📁 Eval/
- ⚙️ eval_data.csv 2.9KB 下载
📁 Models/
- 📄 Factory.py 1.6KB 下载
- 📄 __init__.py 0B 下载
📁 Tests/
📁 Configs/
- 📄 config.yml 297B 下载
- 📄 rag_config.yml 36B 下载
📁 data/
- ⚙️ 扫地机器人100问.pdf 188.2KB 下载
- 📄 故障分析日志.txt 15.5KB 下载
📁 prompts/
- 📄 main.txt 982B 下载
- 📄 report_prompt.txt 669B 下载
- 📄 data_tests.py 254B 下载
- 📄 extract_info_test.py 243B 下载
- 📄 fetch_data_from_others_test.py 370B 下载
- 📄 generator_test.py 211B 下载
- 📄 rag_test.py 176B 下载
📁 Tools/
- 📄 ExtractInfo.py 1.4KB 下载
- 📄 FetchFromOtherSys.py 1.3KB 下载
- 📄 RagQATool.py 344B 下载
- 📄 ReportGenerationTool.py 2.0KB 下载
- 📄 Tools.py 473B 下载
- 📄 VecStore.py 2.3KB 下载
- 📄 __init__.py 0B 下载
📁 Utils/
- 📄 FileReader.py 1.8KB 下载
- 📄 PrintHandler.py 3.7KB 下载
- 📄 create_db.py 219B 下载
📁 data/
📁 query_from_others/
- ⚙️ query_data.csv 2.2KB 下载
- ⚙️ 扫地机器人100问.pdf 188.2KB 下载
- 📄 故障分析日志.txt 15.5KB 下载
📁 prompts/
- 📄 main.txt 982B 下载
- 📄 report_prompt.txt 669B 下载
- 📄 app.py 1.7KB 下载
- 📄 app_run_streamlit.py 60B 下载
- 📄 app_test.py 1.8KB 下载
- 📄 app_web_streamlit.py 1.1KB 下载
- 📄 demo.py 1.3KB 下载