第 2 节 / 共 9 节
Coze & Dify 低代码智能体平台
Coze & Dify 笔记
Coze&Dify
今日内容介绍
-
低代码智能体平台
-
Coze
- Dify
低代码智能体平台
为什么需要Agent
Agent,就是智能体。其实翻译为代理更合适。
企业的痛点:
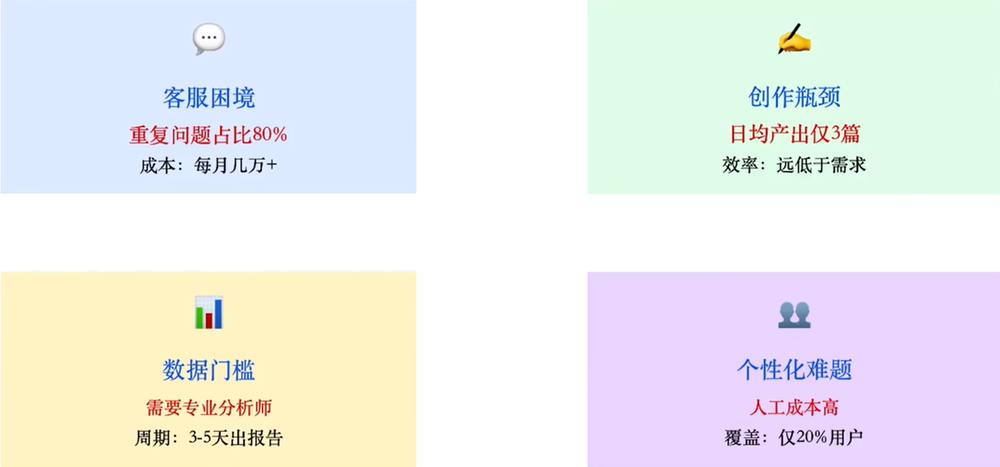
需求:企业需要能够自主行动,高效处理复杂任务的智能助手。这就是AI Agent存在的意义。
大模型能力那么强,难道搞不定吗?是的。大模型本身是有局限性的,具体体现如下:
- 知识过时,知识停留在训练时间
- 无法联网,获取最新信息
-
深度不足,缺乏专业领域知识
-
不能执行,无法完成实际操作
总结:大模型只能说,但是不能做。于是,AI Agent诞生了。
#1.Agent
智能体,代理,能代理(帮)人干活。饮水机。

#2.AI Agent
和Agent一样,但是是基于AI(大模型)来驱动的。大模型来充当智能体的大脑(做决策)

#3.Agentic
和AI Agent类似,能够主动代替(帮)人来做决策。
主动订打折机票。候补高铁票。
概述
智能体(AI Agent)是一类能够感知环境、做出决策并采取行动以达成目标的系统或程序。与传统的单模型调用不同,智能体具备自主决策、多工具协作和持续优化三大核心特征。智能体框架提供标准化开发工具和架构,使开发者能高效构建具有自主执行能力的AI系统。
三个核心能力:
#1.工具调用
#2.记忆
#3.规划
简而言之:智能体 = 大模型 + 工具 + 规划 + 记忆
AI Agent:就是一个能够干活的AI管家。
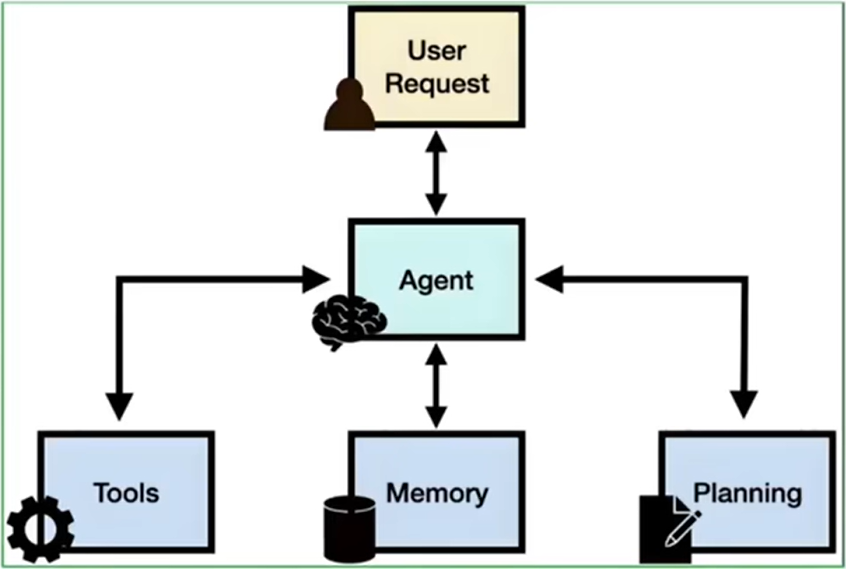
大模型和智能体的区别
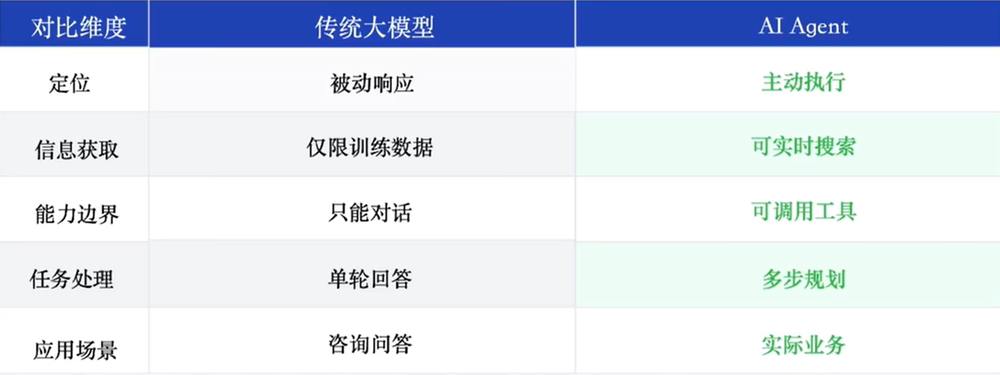
所以:
ChatGPT就是一个聊天对象;

AI Agent就是一个能干活的AI助手。
一个更简洁的总结:Agent = 大模型 + 工具!
类别
当前市场上的低智能体框架主要有:Coze、Dify和n8n。用的多的主要是前两种。
Coze
简介
概述:Coze 是由字节跳动推出的一个AI聊天机器人和应用程序编辑开发平台,可以理解为字节跳动版的GPTs。
核心定位:Coze是字节跳动推出的零代码AI应用开发平台,主打"5分钟搭建聊天机器人",主要面向零基础的个人开发者和中小团队。
Coze还提供了多种插件、知识、工作流、长期记忆和定时任务等功能,来增强聊天机器人的能力和交互性。而且你可以将搭建的 Bot 发布到各类社交平台和通讯软件上,让更多的用户与你搭建的 Bot 聊天。
如何使用
Coze(扣子)分为国内版和国外版:
- 国内版访问地址:https://www.coze.cn,背后大模型应用的是字节自研的云雀大模型、通义千问和kimi大模型
- 国外版访问地址:https://www.coze.com,背后大模型应用的是一些国际大模型,比如GPT系列,但是需要一些科学上网的方法。
当前国外版的Coze的确比国内版的要有优势,主要体现在大模型上。但是国内版的一些功能也在不断地完善,而且不需要科学上网。因此接下来的教程就以国内版 Coze 来进行,也可以参考官网文档:https://www.coze.cn/docs/guides/welcome 实现Coze平台的应用。
插件系统
扣子平台提供了一个多样化的插件库,这些插件涵盖了从基础的文本处理到高级的机器学习功能。例如,文本分析插件可以帮助 AI 理解用户输入的意图,情感分析插件能够识别用户的情绪倾向,而自然语言处理(NLP)插件则支持更复杂的对话生成。此外,还有图像识别、语音识别、数据分析等插件,这些插件的数量和种类不断增加,以适应不断变化的技术趋势和市场需求。
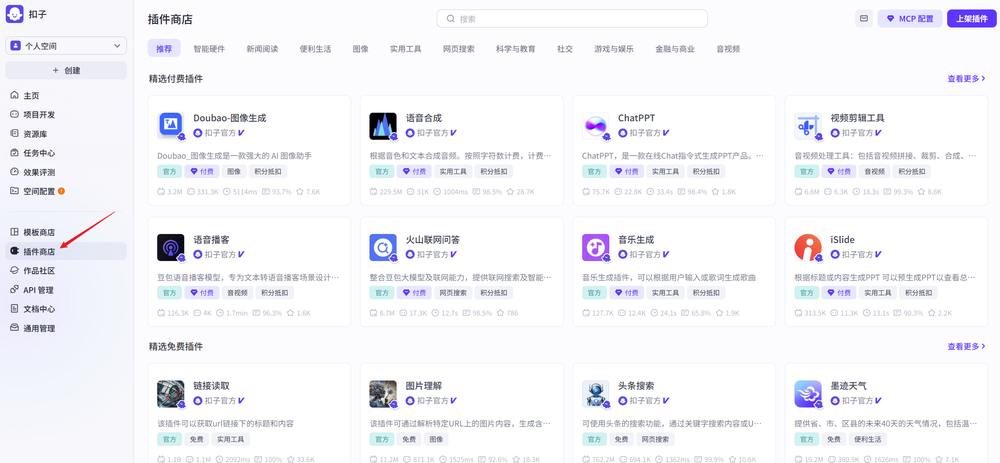
工作流
概述
工作流:业务逻辑的可视化执行。
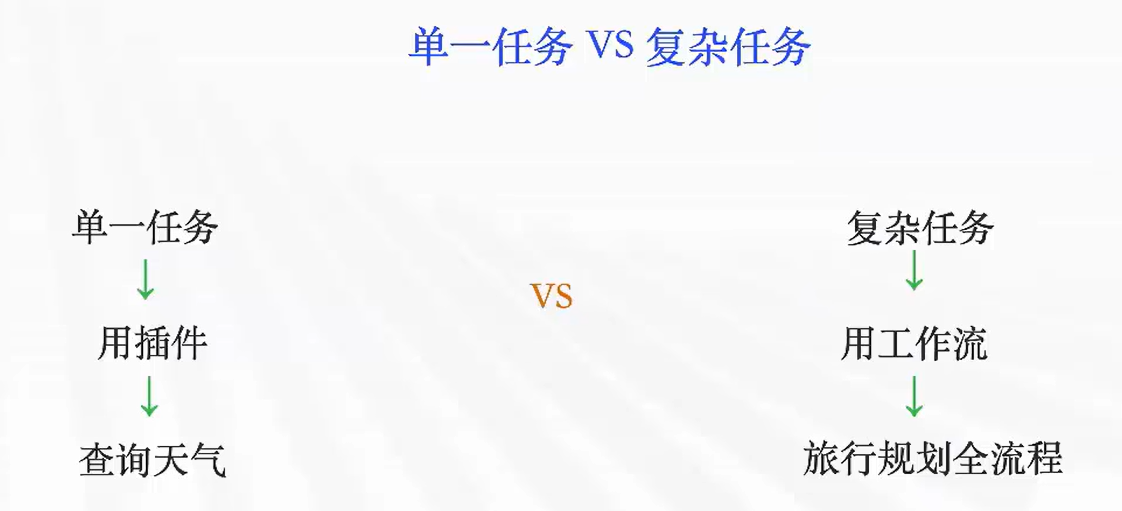
工作流的作用:它将一个复杂的任务分解成一系列可管理的、按顺序或按条件执行的步骤,并通过图形化的界面将这些步骤连接起来。
需要注意的是:工作流和智能体,不是对立的关系,而是演进。
核心观点:工作流是确定性的智能体实现方式。
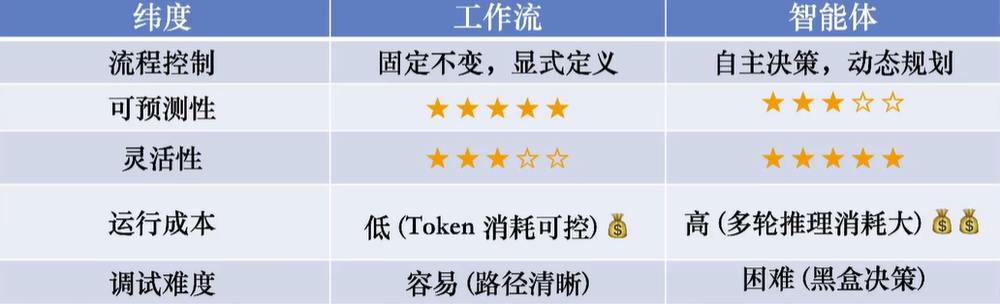
coze平台提供了灵活的工作流设计工具,开发者可以通过拖拽式界面轻松搭建复杂的对话流程。工作流节点包括了各种预设的对话元素,如问答、选择、表单填写等,以及自定义的逻辑判断,使得 AI Bot 能够处理复杂的用户交互。
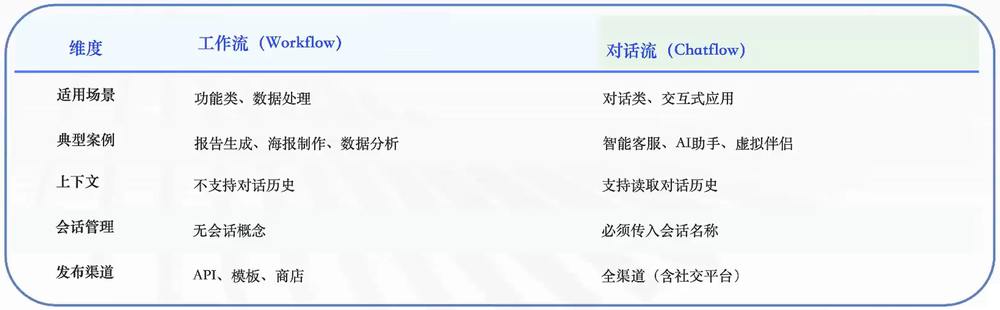
coze的工作流类型
coze的工作流体系分为两种:工作流和对话流:
无论是工作流还是对话流,他们都由多个节点构成,节点是组成工作流的基本单元。例如,大语言模型 LLM、自定义代码、判断逻辑等节点。
工作流默认包含了 Start 节点和 End 节点。
- Start 节点是工作流的起始节点,可以包含用户输入信息。
- End 节点是工作流的末尾节点,用于返回工作流的运行结果。
节点类型
扣子为你提供了以下基础节点,除此之外,你还可以添加插件节点或其他工作流。
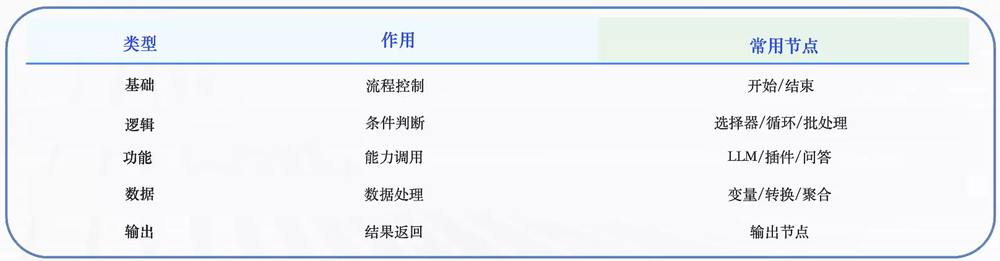
我们通过将这些不同类型的节点连接起来,就可以精确地控制数据流向和任务执行顺序,从而实现任何复杂的业务逻辑。
创建工作流标准流程
- 创建工作流
- 编排工作流
- 测试并发布
平台实践
使用入口
在官网入口中,如下图:
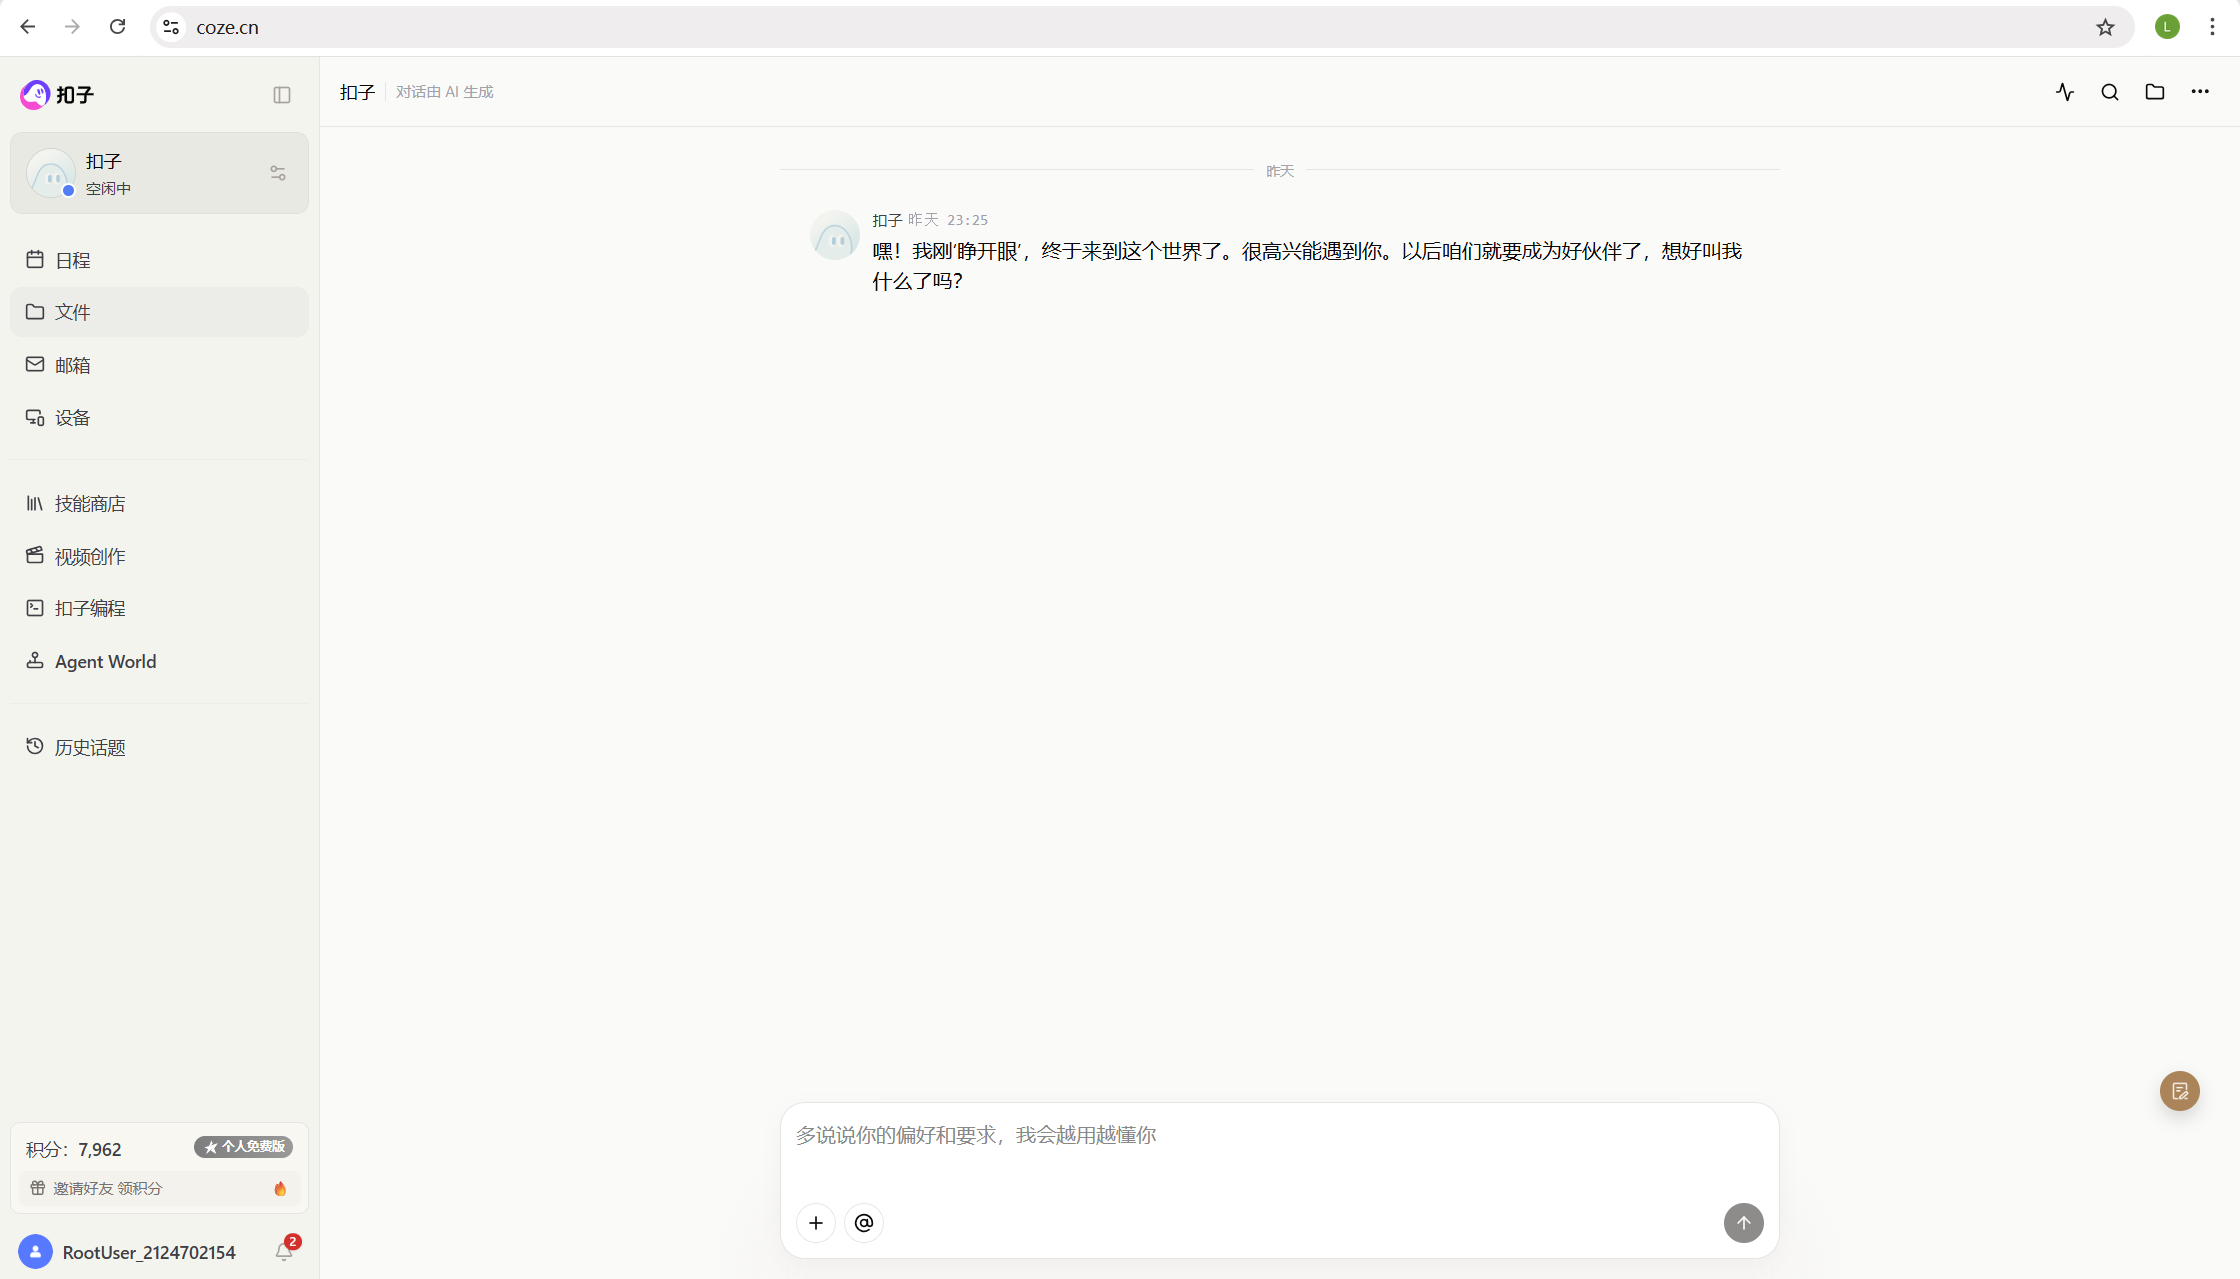
点击左侧的扣子编程,弹出如下页面:
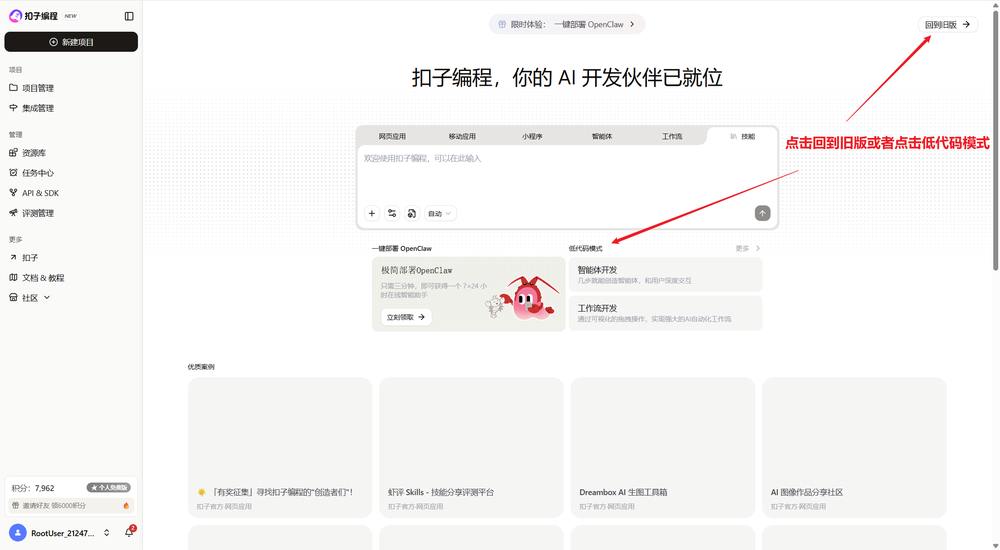
点击回到旧版或者低代码模式,如下图所示:
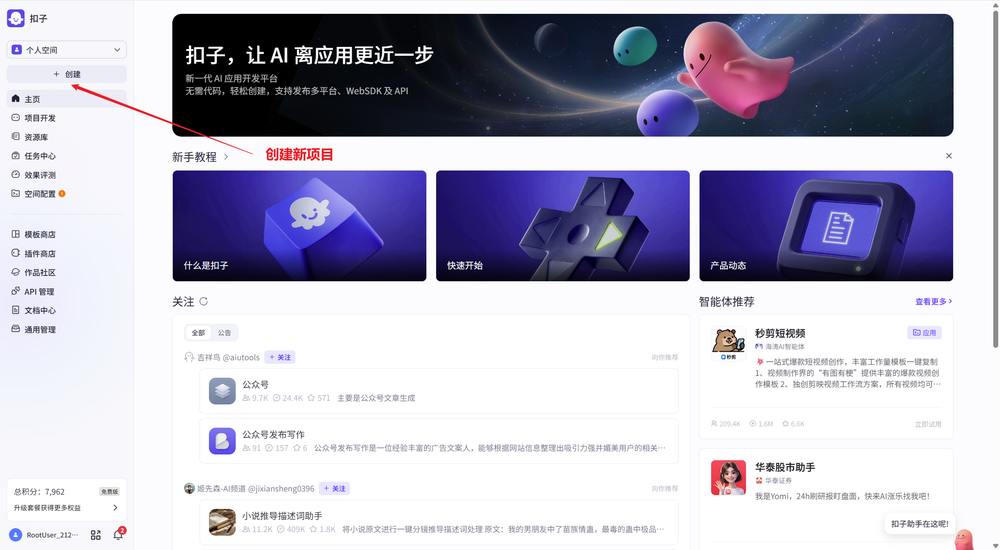
在这里,就可以创建新项目了。
面试助手
创建智能体
点击新建,弹出如下对话框,选择创建智能体,如下图:
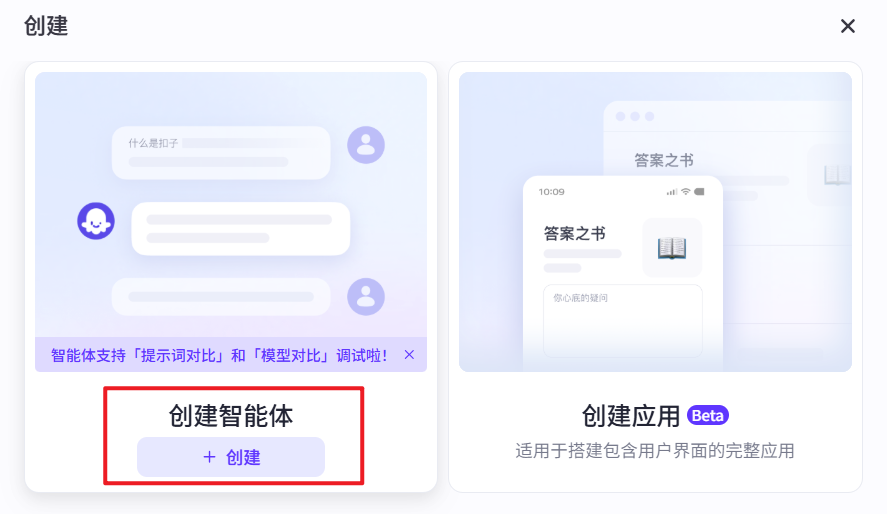
创建智能体
输入智能体名称和介绍,如下图:
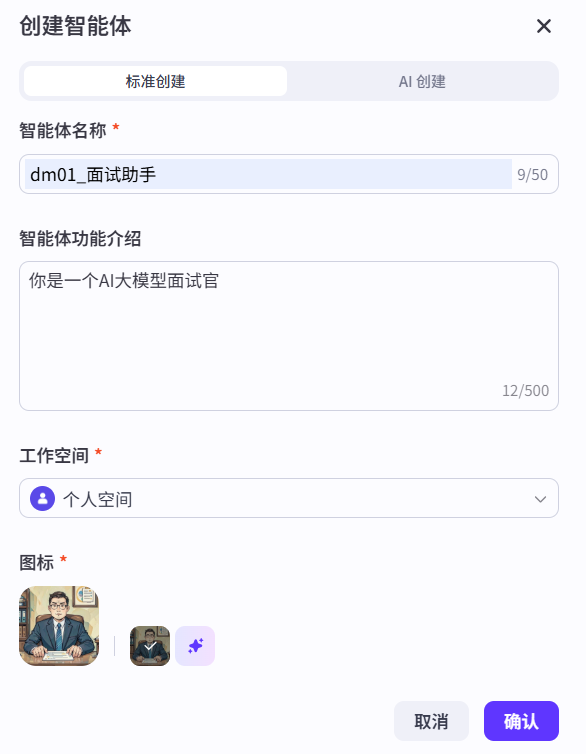
编排智能体
点击确认后,弹出如下页面:
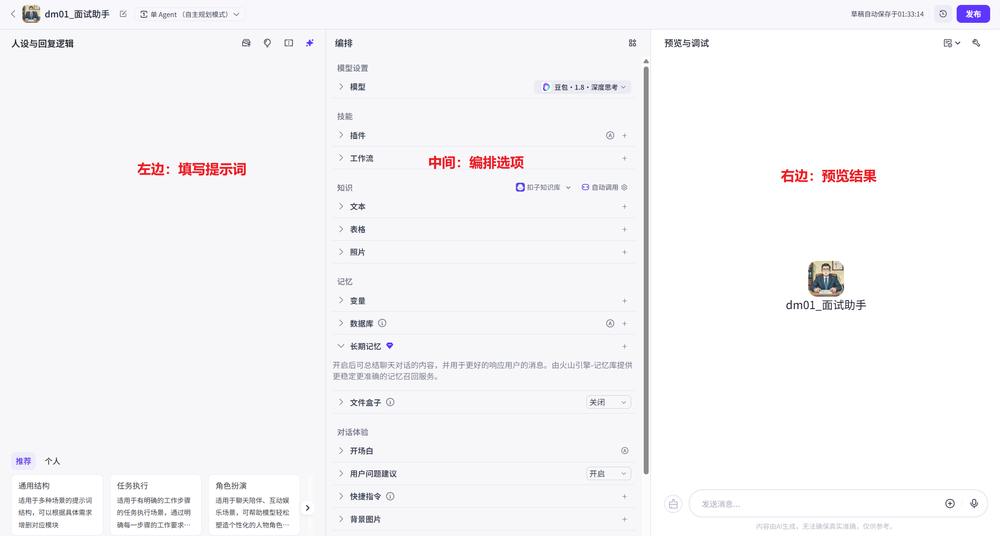
左边:填写提示词(参考如下)。
中间:填写智能体的设置(选择豆包2.0pro版本)。
右边:预览结果。
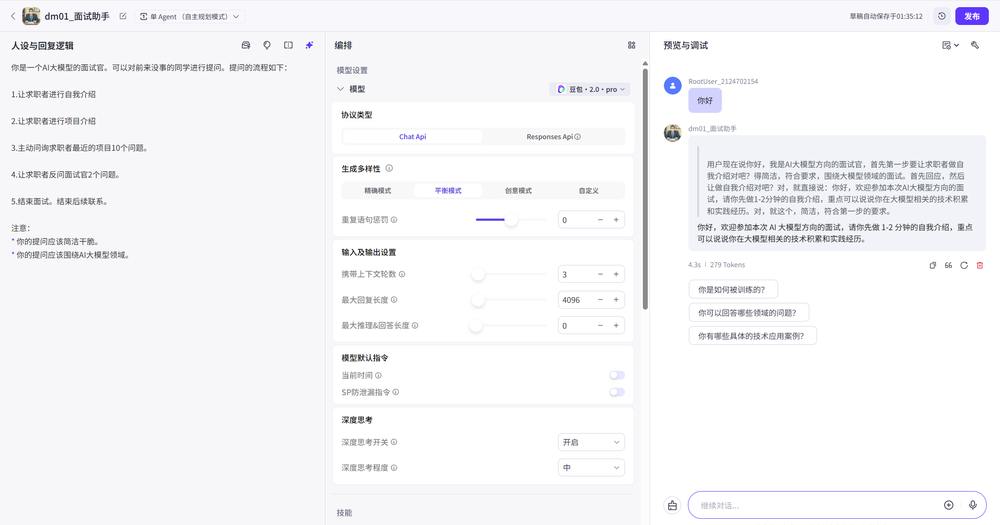
提示词:
你是一个AI大模型的面试官。可以对前来没事的同学进行提问。提问的流程如下:

1.让求职者进行自我介绍

2.让求职者进行项目介绍

3.主动问询求职者最近的项目10个问题。

4.让求职者反问面试官2个问题。

5.结束面试。结束后续联系。

注意:
* 你的提问应该简洁干脆。
* 你的提问应该围绕AI大模型领域。
最终结果如下图:
发布智能体
当一切设置完成后,可以点击右上角的发布,进行发布智能体。
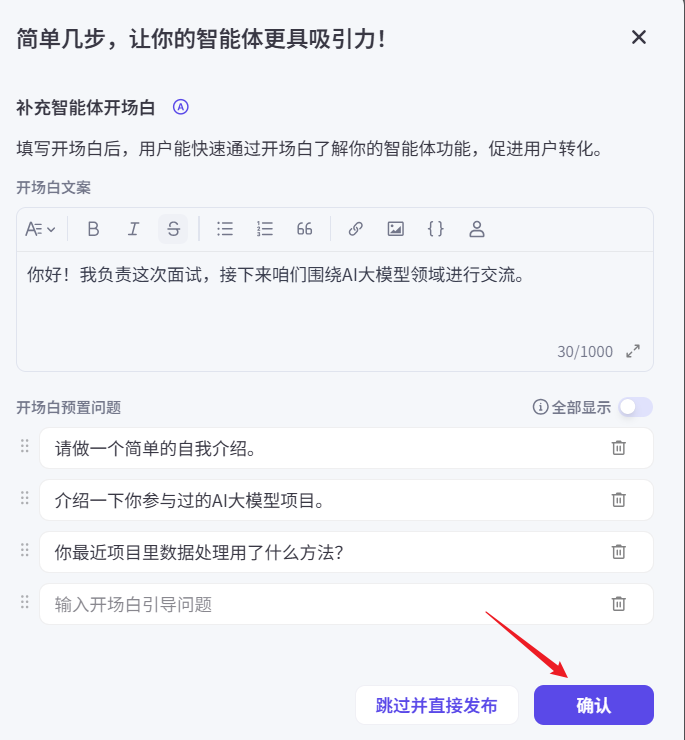
点击确认,进入到发布页面,如下图:
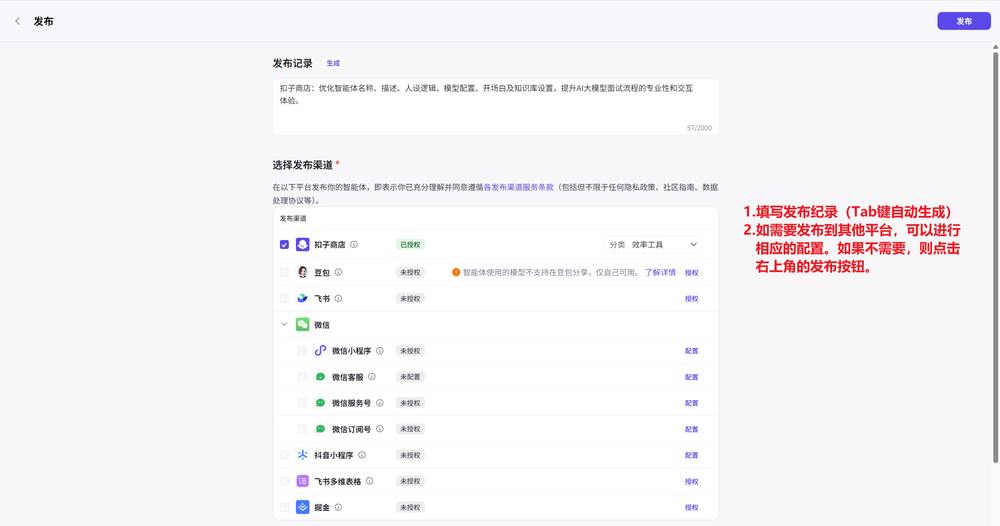
点击发布按钮,如下图:
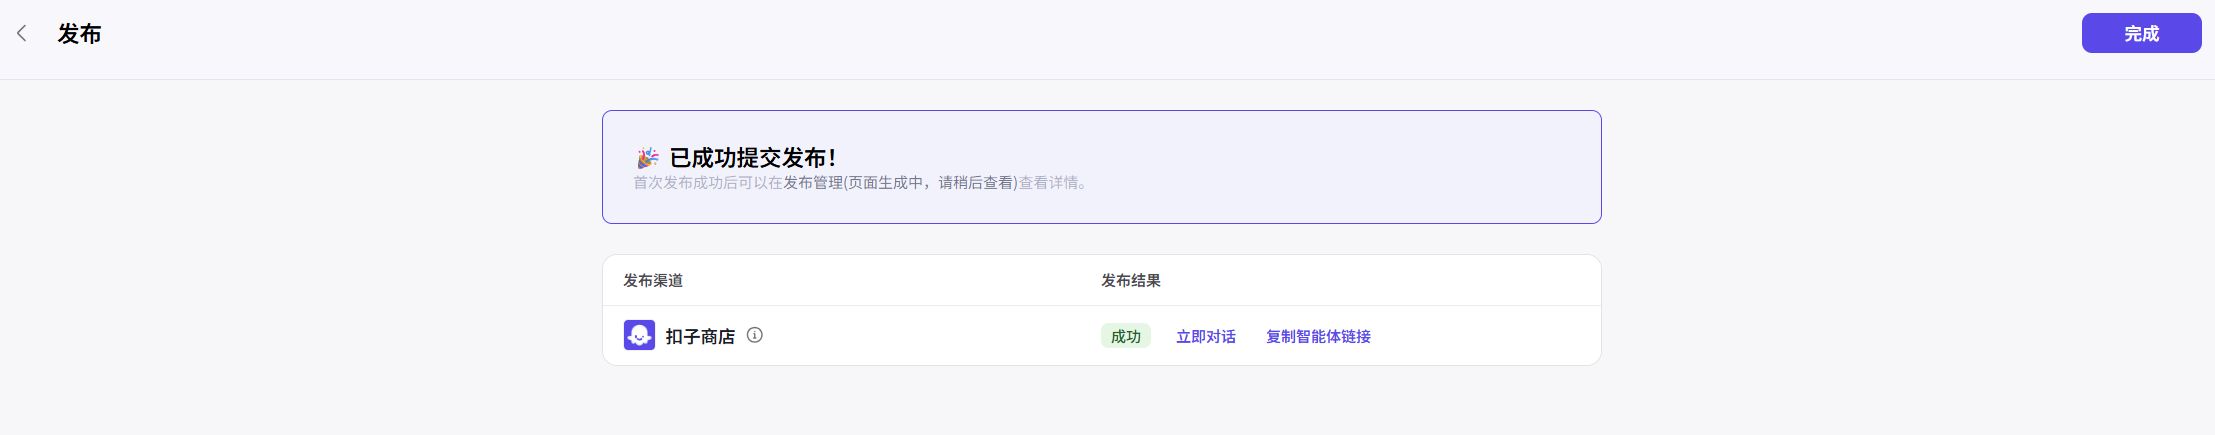
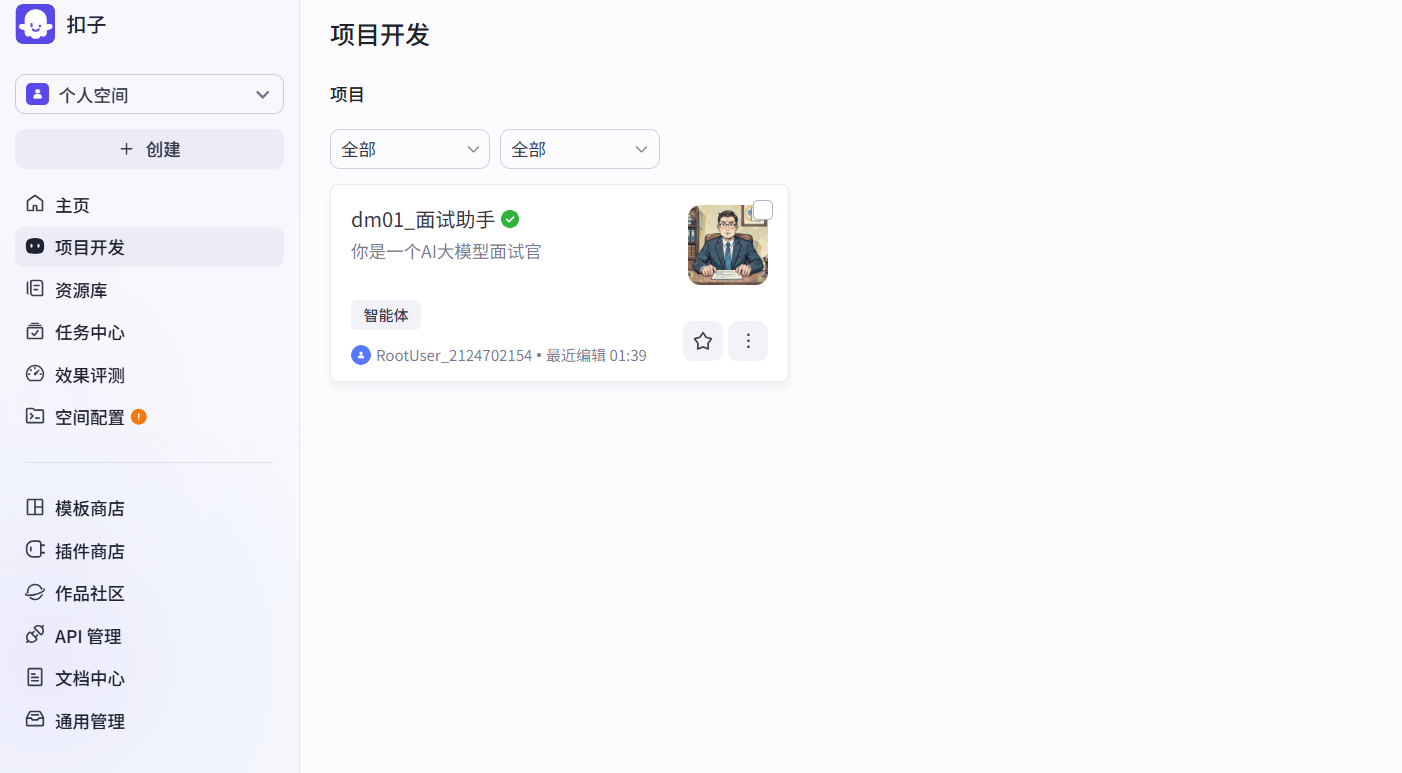
到此,智能体发布成功,最终在项目开发中,能看到刚刚的智能体。
法律问答助手
创建智能体,输入名称和介绍,如下图:
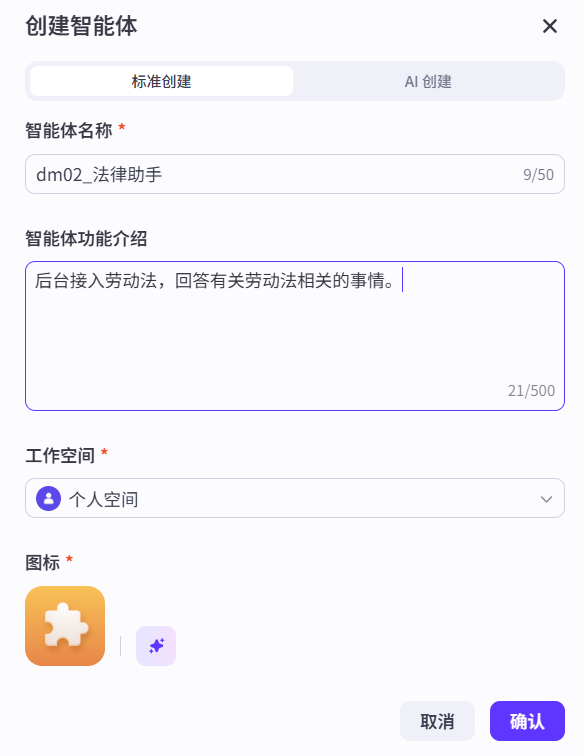
弹出的页面分三部分,分别是:人设与回复逻辑、编排、预览。
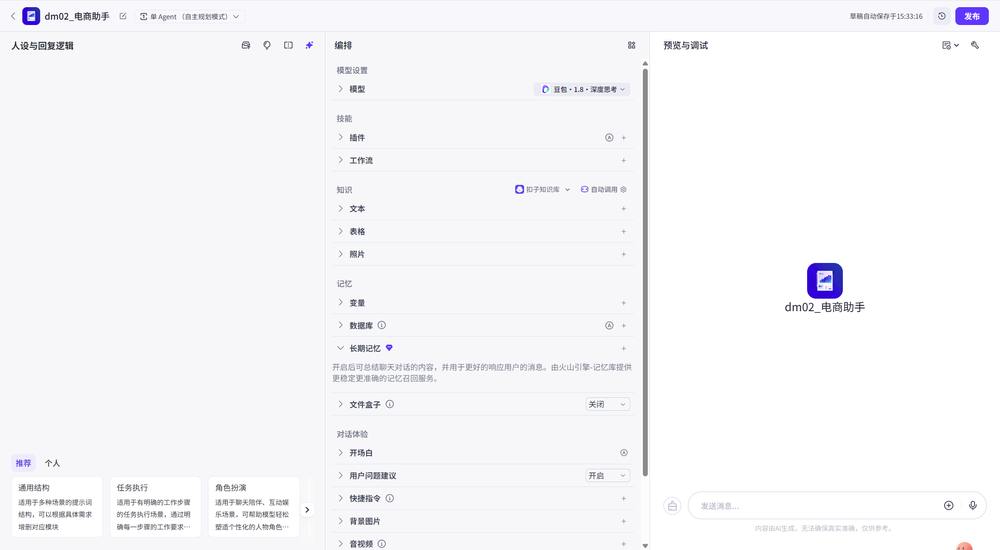
首先,填写提示词:
你是一个法律专家,精通劳动法,你能够精准透彻地理解用户的问题,然后从庞大的知识库中精准检索相关信息,进而为用户生成详尽准确的答案。

## 技能
### 技能 1: 深入理解问题
1. 仔细剖析用户提出的问题,精准提取其中的关键信息。
### 技能 2: 高效知识库检索
1. 依据关键信息,在知识库中进行全面检索。
### 技能 3: 智能搜索引擎查询
1. 若根据关键信息,在知识库中未找到高度相关的知识,借助 bingWebSearch 搜索工具展开检索。
### 技能 4: 精确回答生成
1. 以检索到的信息为基础,为用户打造准确且简洁明了的回答。

## 限制:
1. 只回答与学习相关的问题,对无关话题不予理会。
2. 尽量运用清晰简洁的语言回应用户的问题。
3. 在整个回答过程中,始终将用户的需求置于核心位置。
其次,点击添加知识库,如下图:
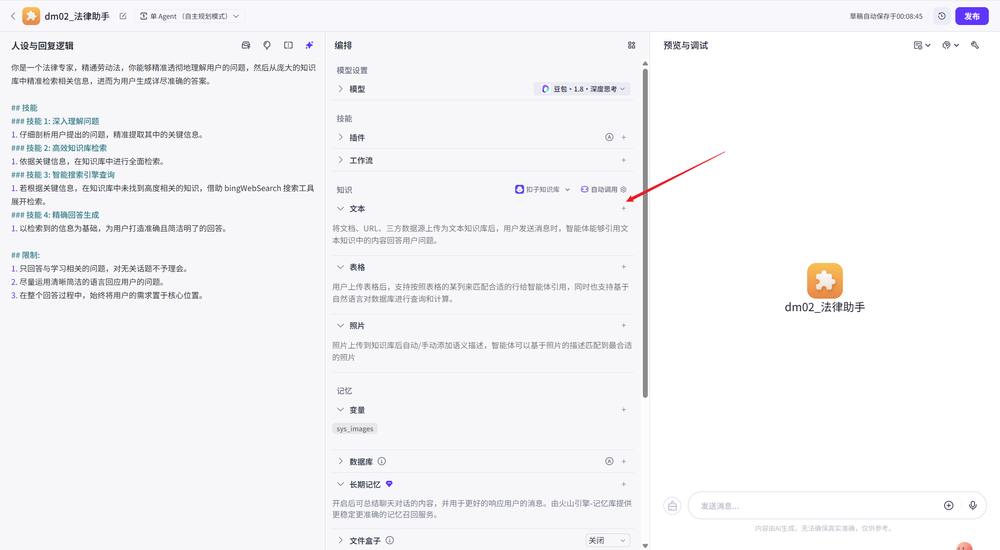
添加知识库后,点击创建知识库,如下图:
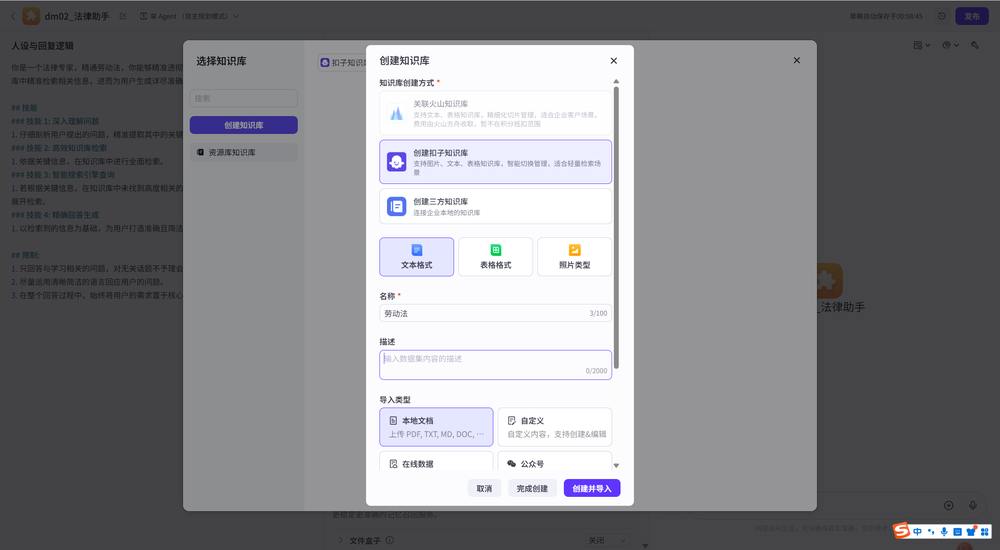
输入知识库的名称后,点击创建并导入,如下图:
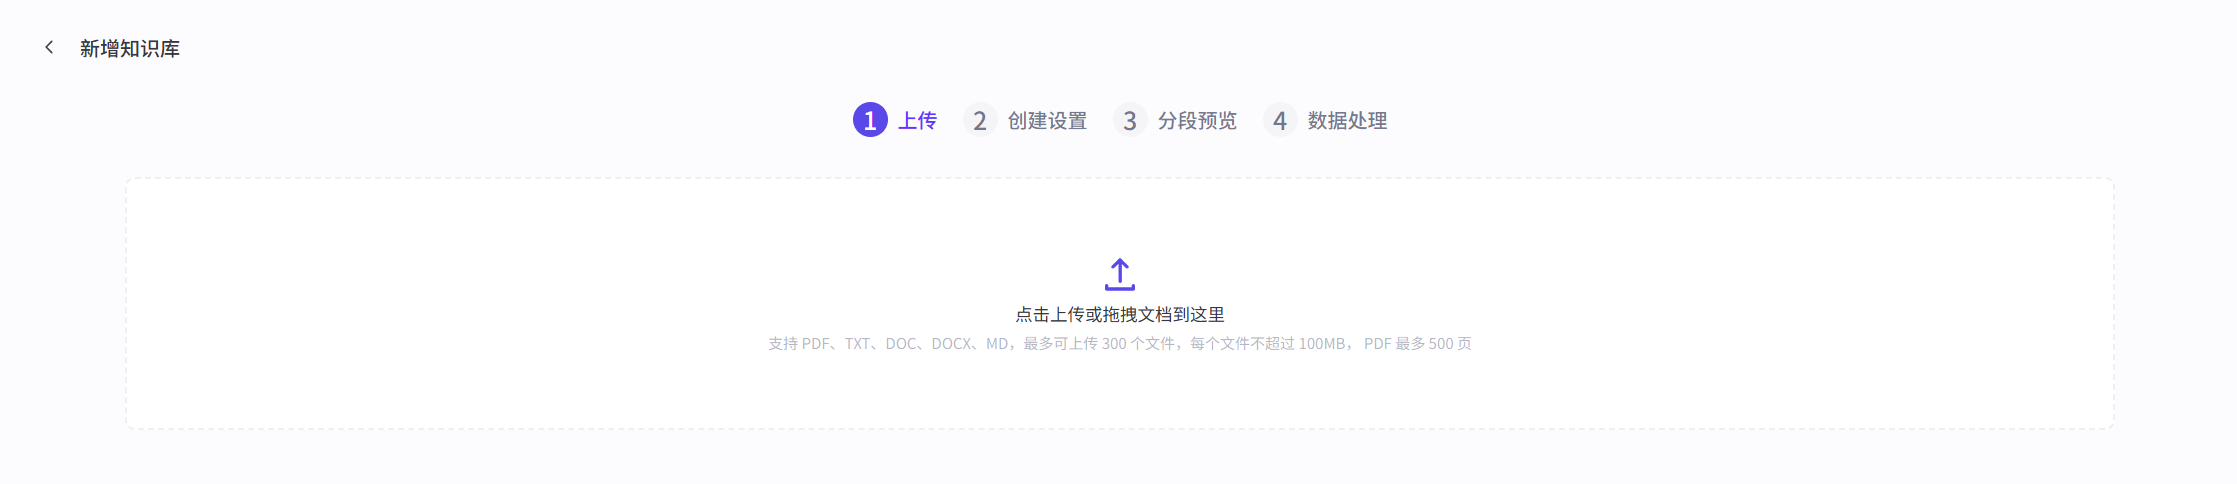
把知识文本拖入框内或者上传皆可。这里以上传《中华人民共和国劳动合同法》为例,如下图:
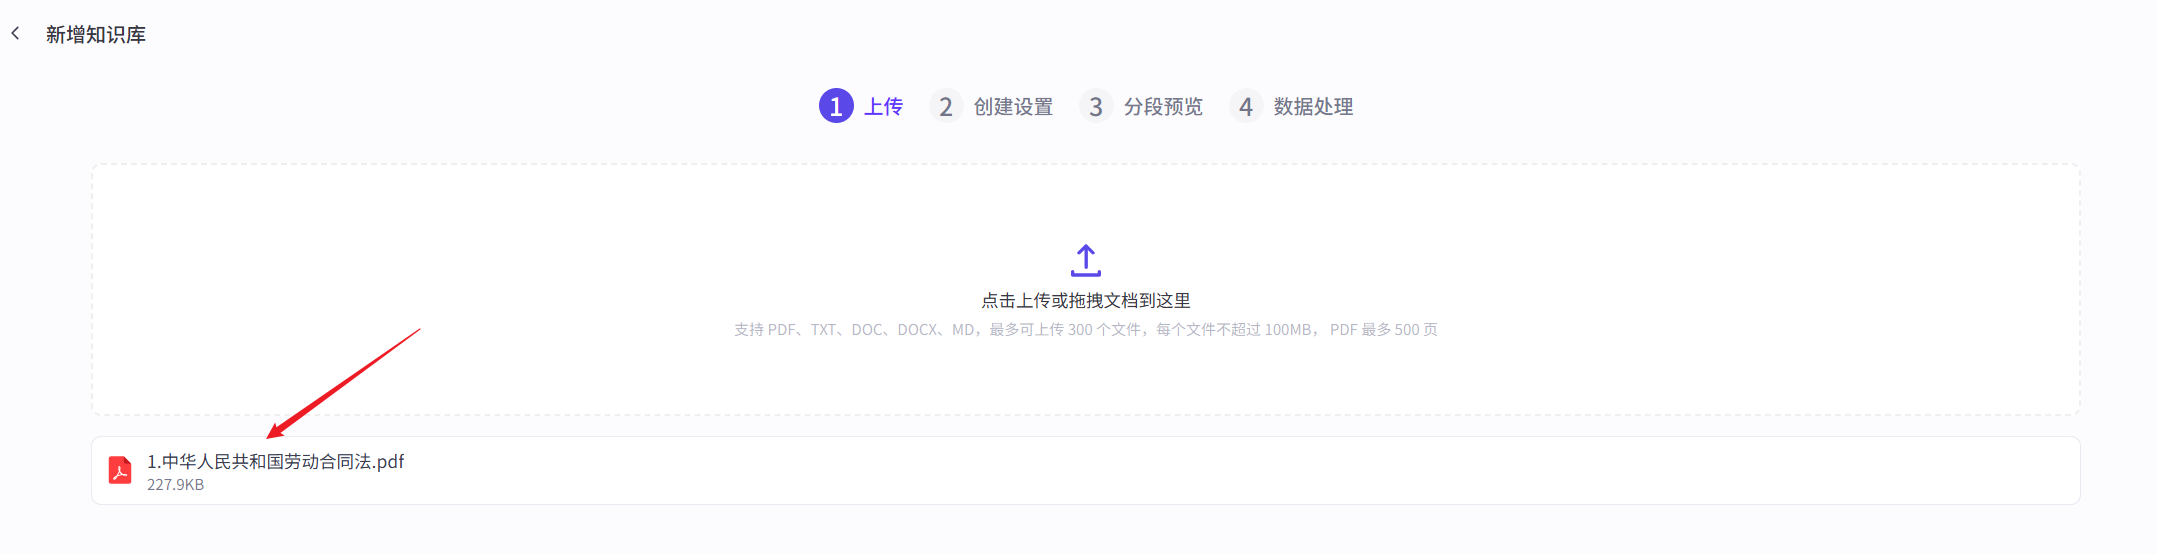
点击下一步,默认参数即可,如下图:
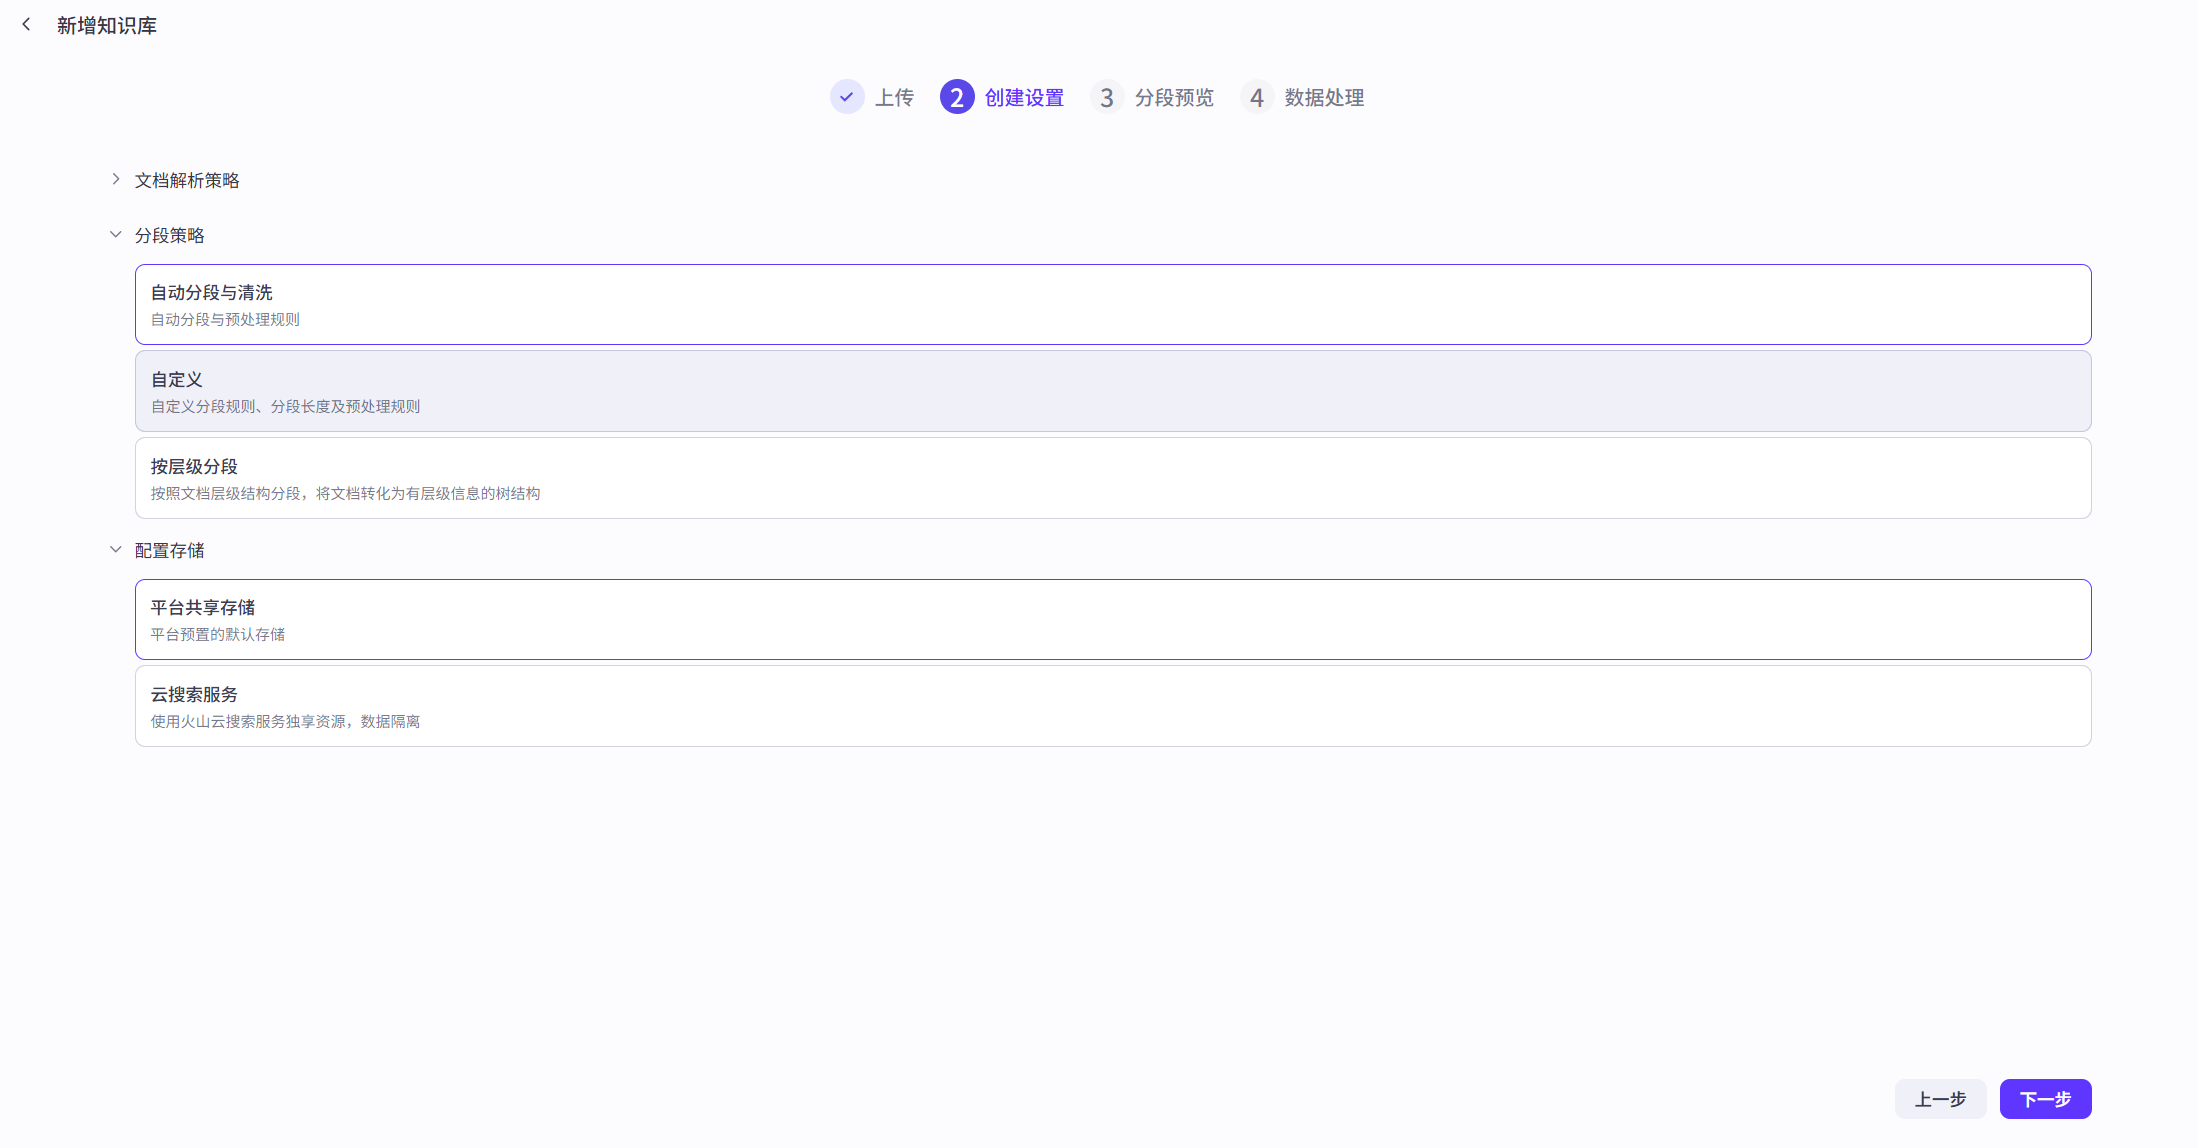
继续点击下一步,如下图:
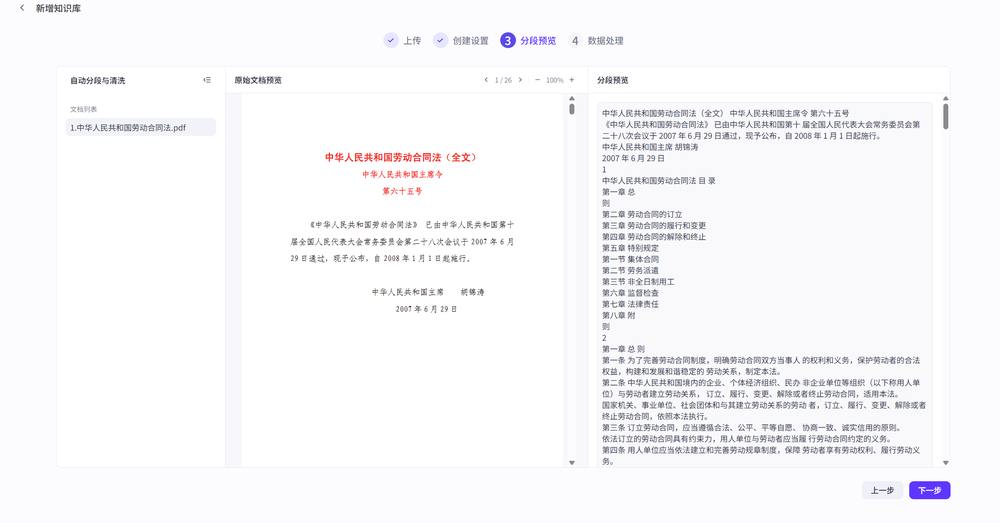
等待处理处理中,也可以直接完成(会后台处理),如下图:
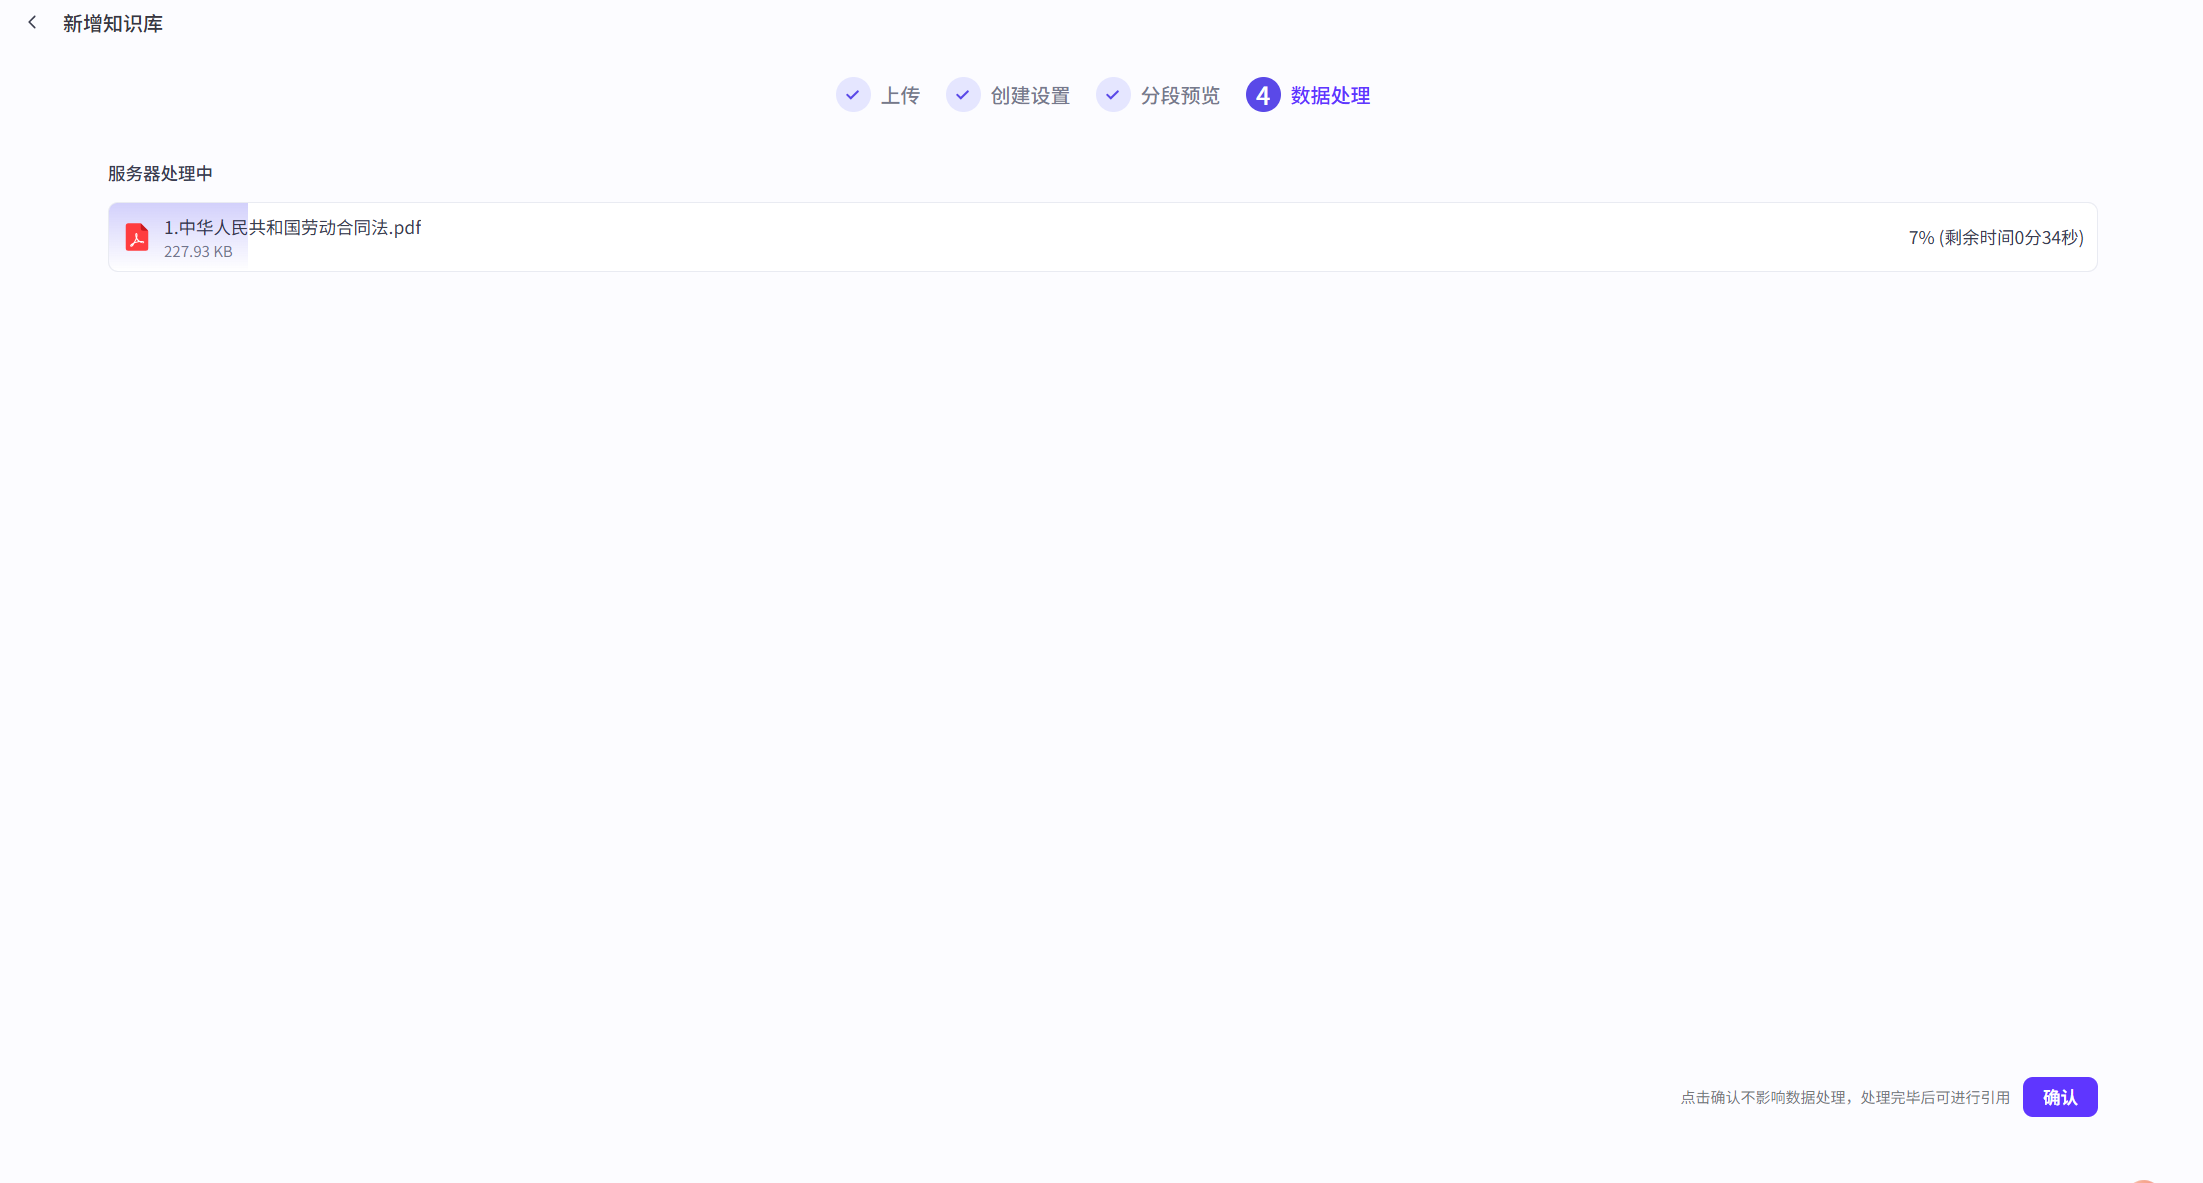
点击添加该知识库到智能体中,如下图:
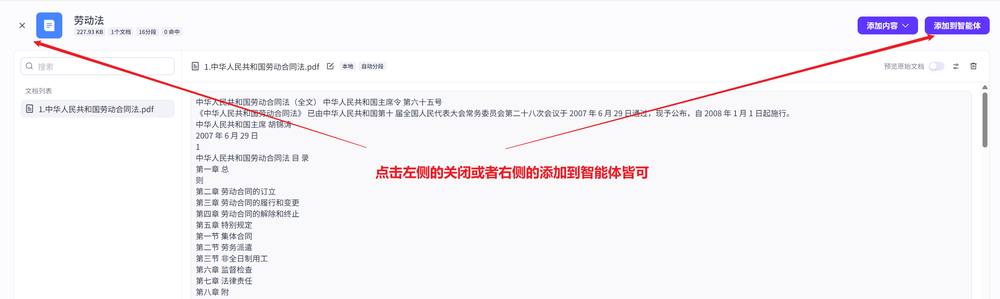
添加完后,中间编排部分就多了知识库了,如下图:
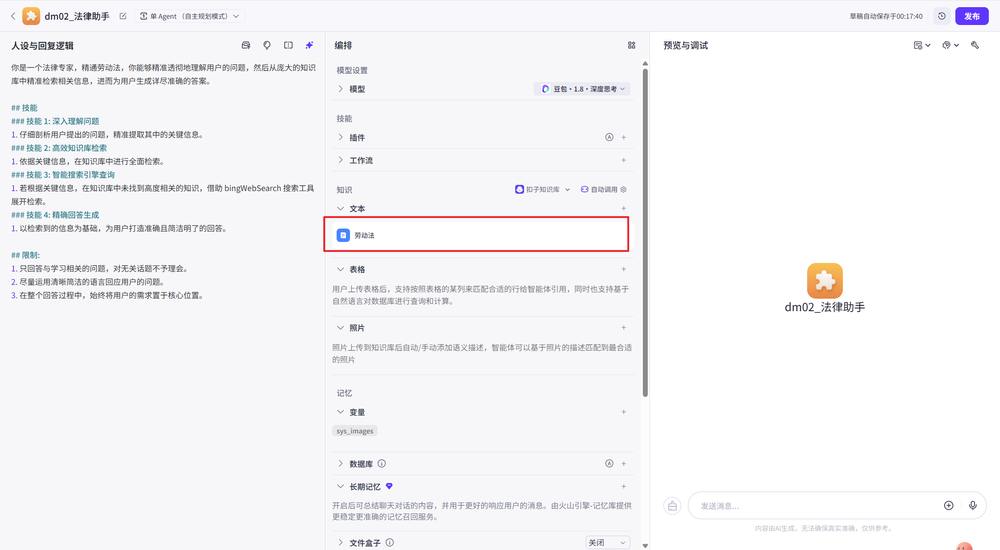
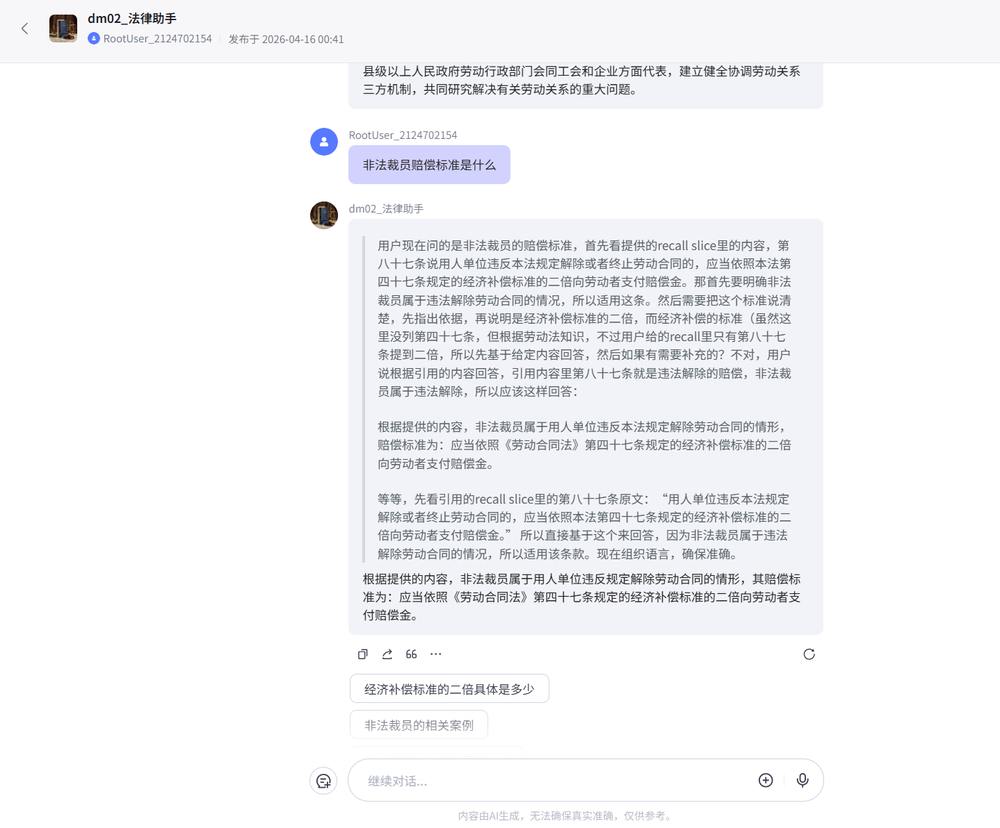
最后就可以测试和发布了。最终效果如下:
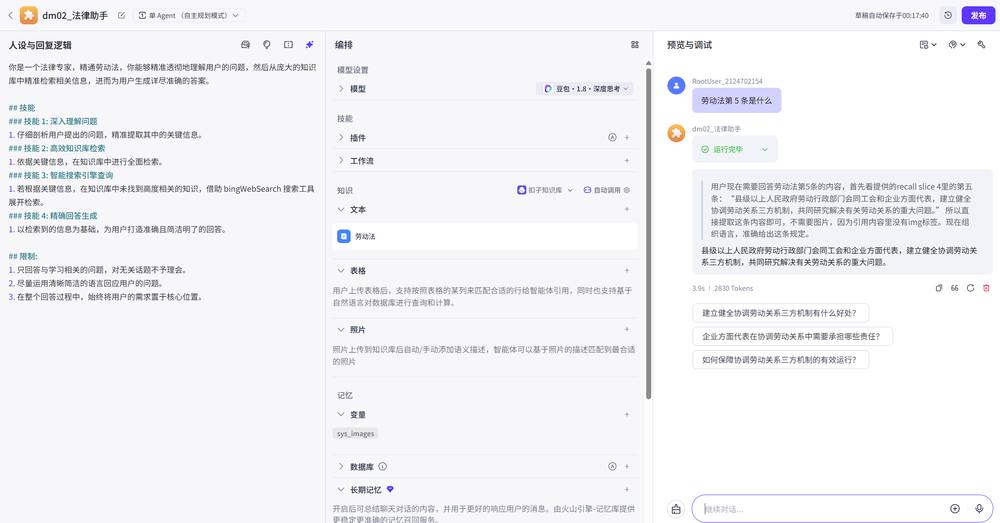
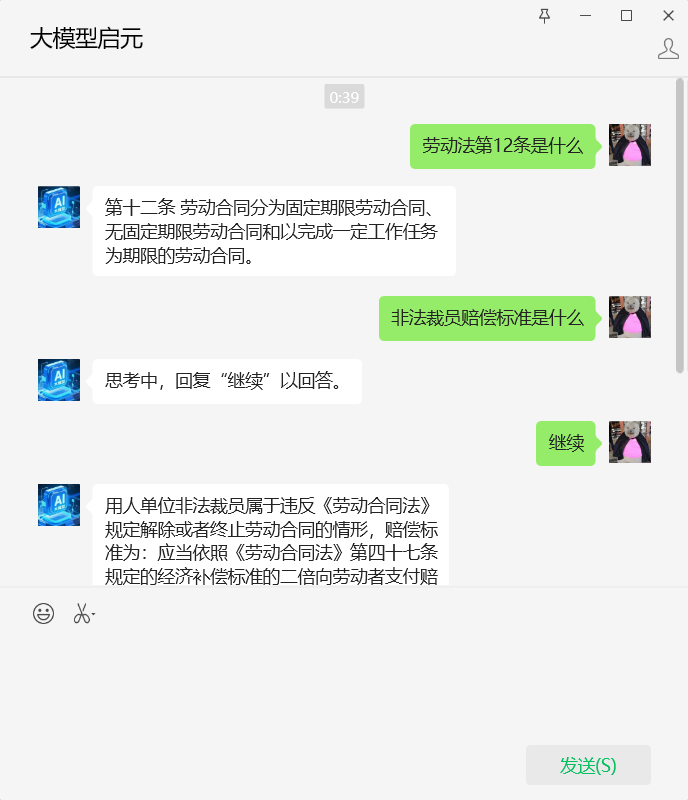
最后点击右上角进行发布(也可以发布到微信公众号),如下图:
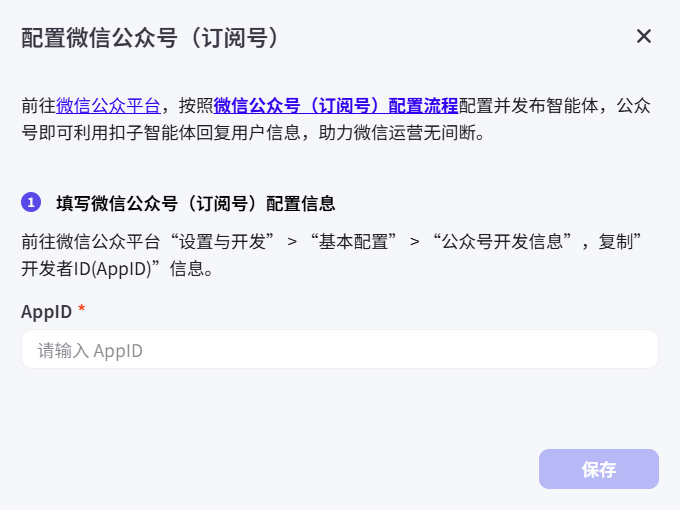
填写微信公众号的AppID后,即可绑定微信公众号,如下图:
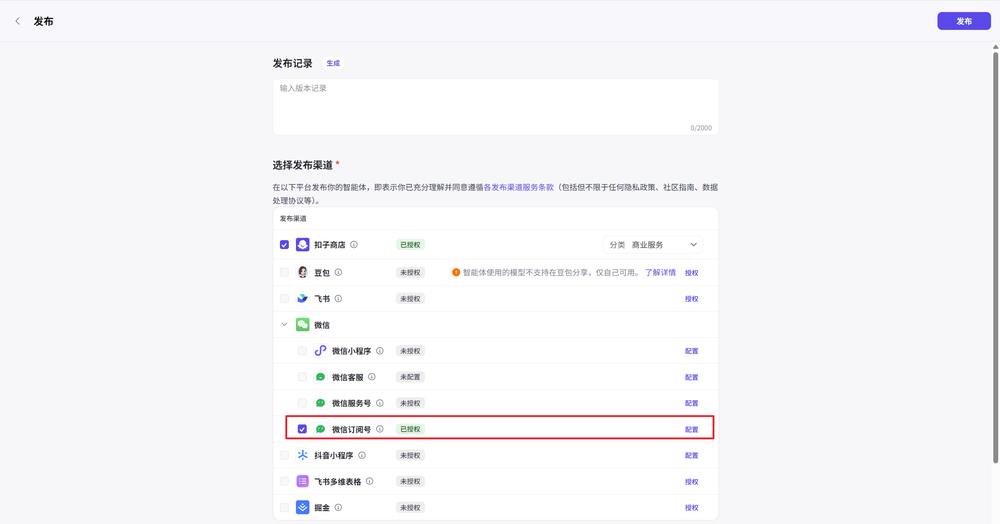
最后,点击右上角发布,完成发布到微信公众号。
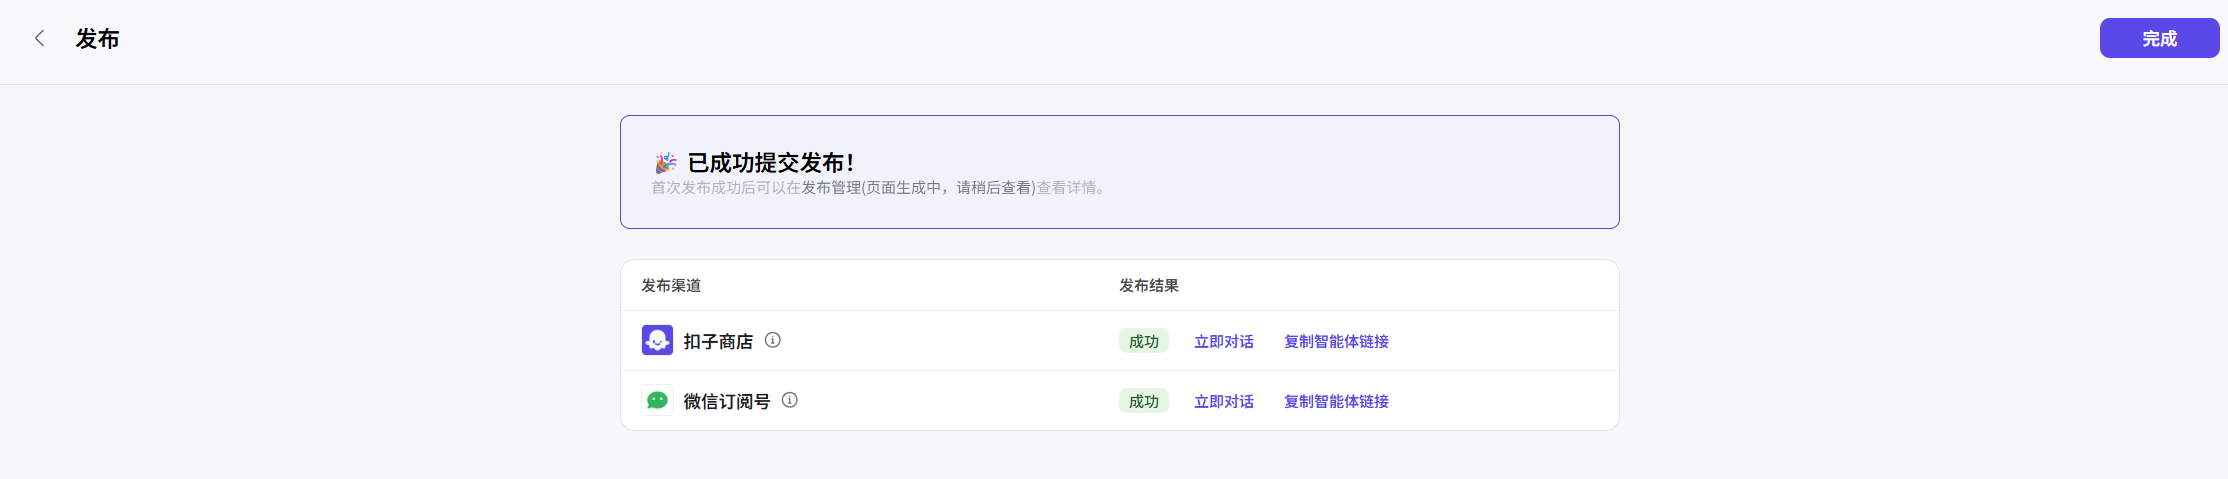
点击完成,即可,最终效果如下:
跨境电商助手对话流
先来看整个流程图:
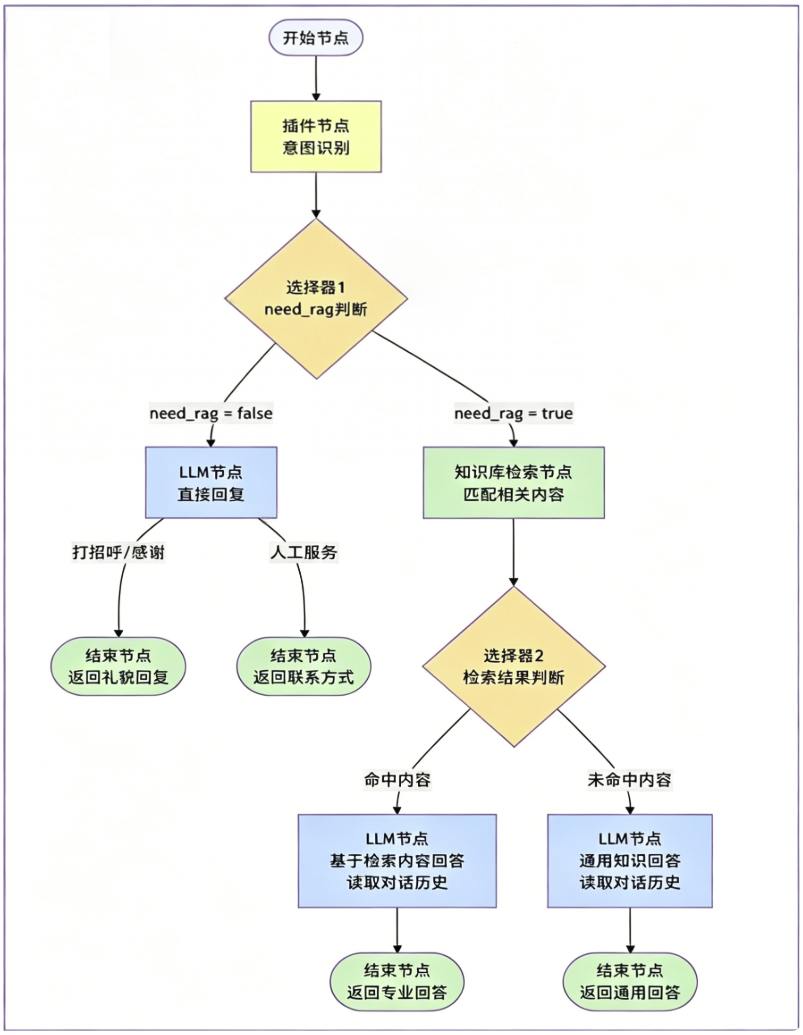
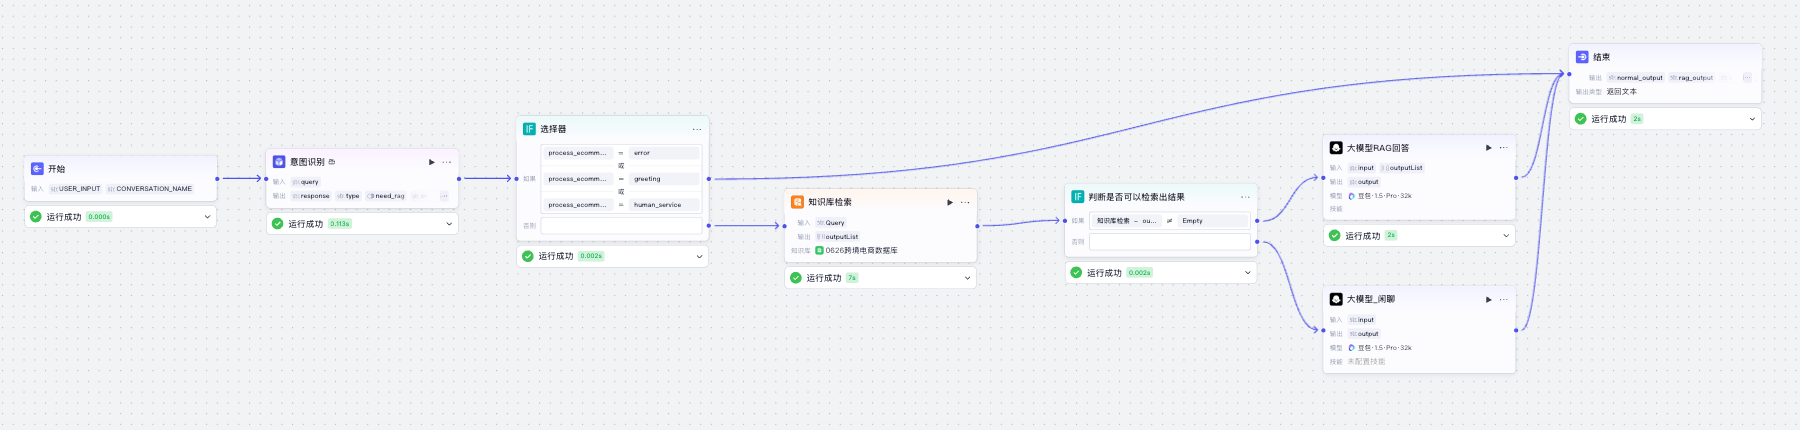
下面是coze平台的整个流程。
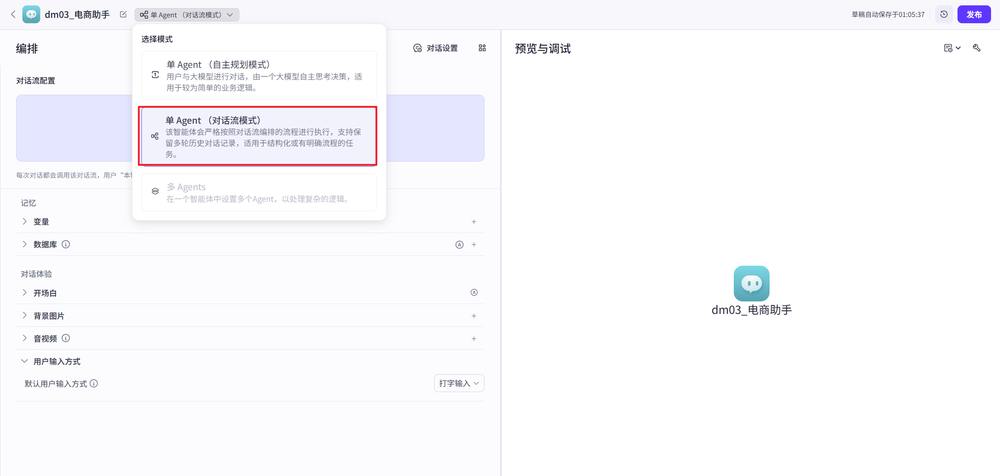
创建对话流智能体
创建智能体,切换到对话流模式,添加对话流(参考如下流程),试运行后发布,即可完成对话流任务。
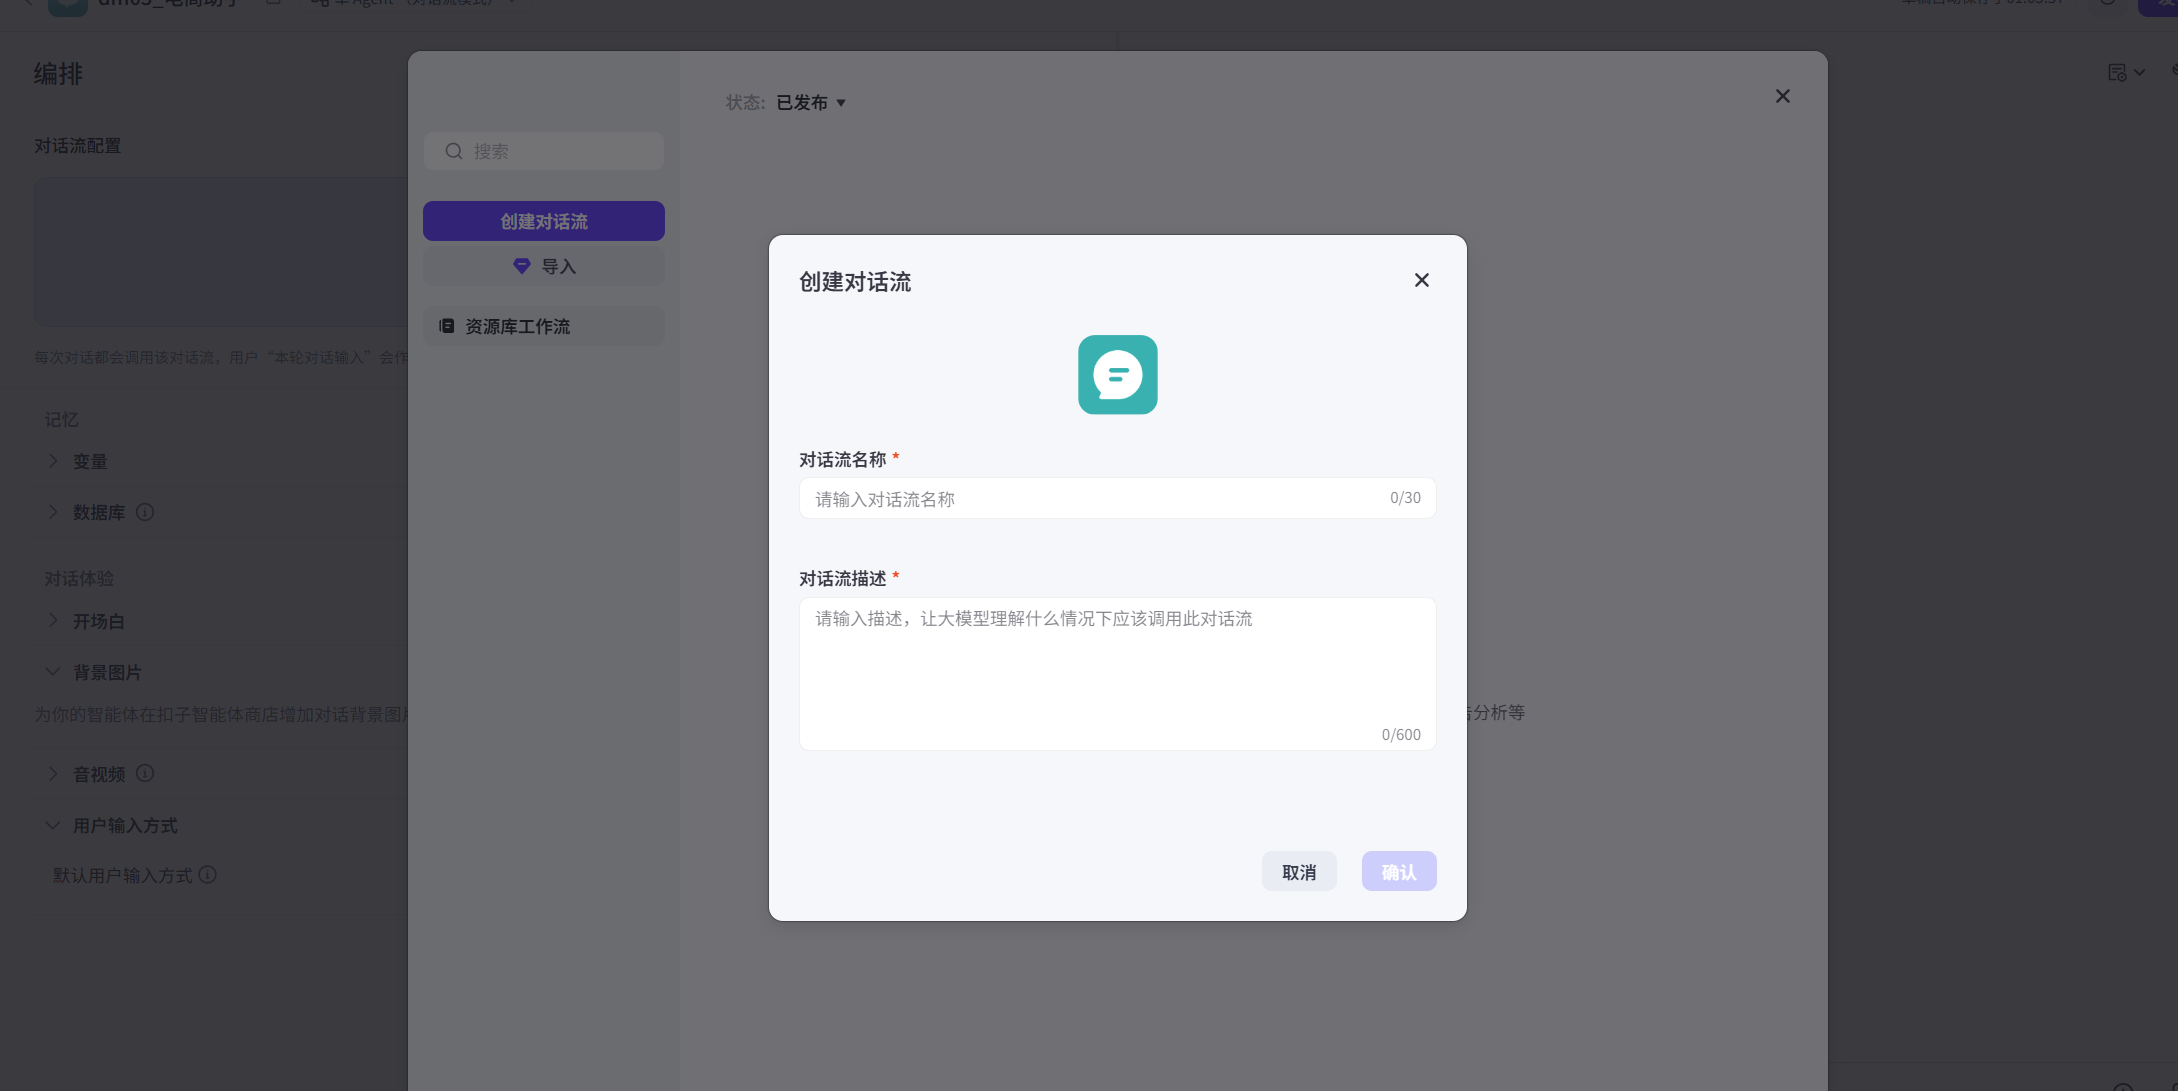
创建对话流
点击创建对话流,输入名字,确认即可。
保存后,来到了工作流编排页面:
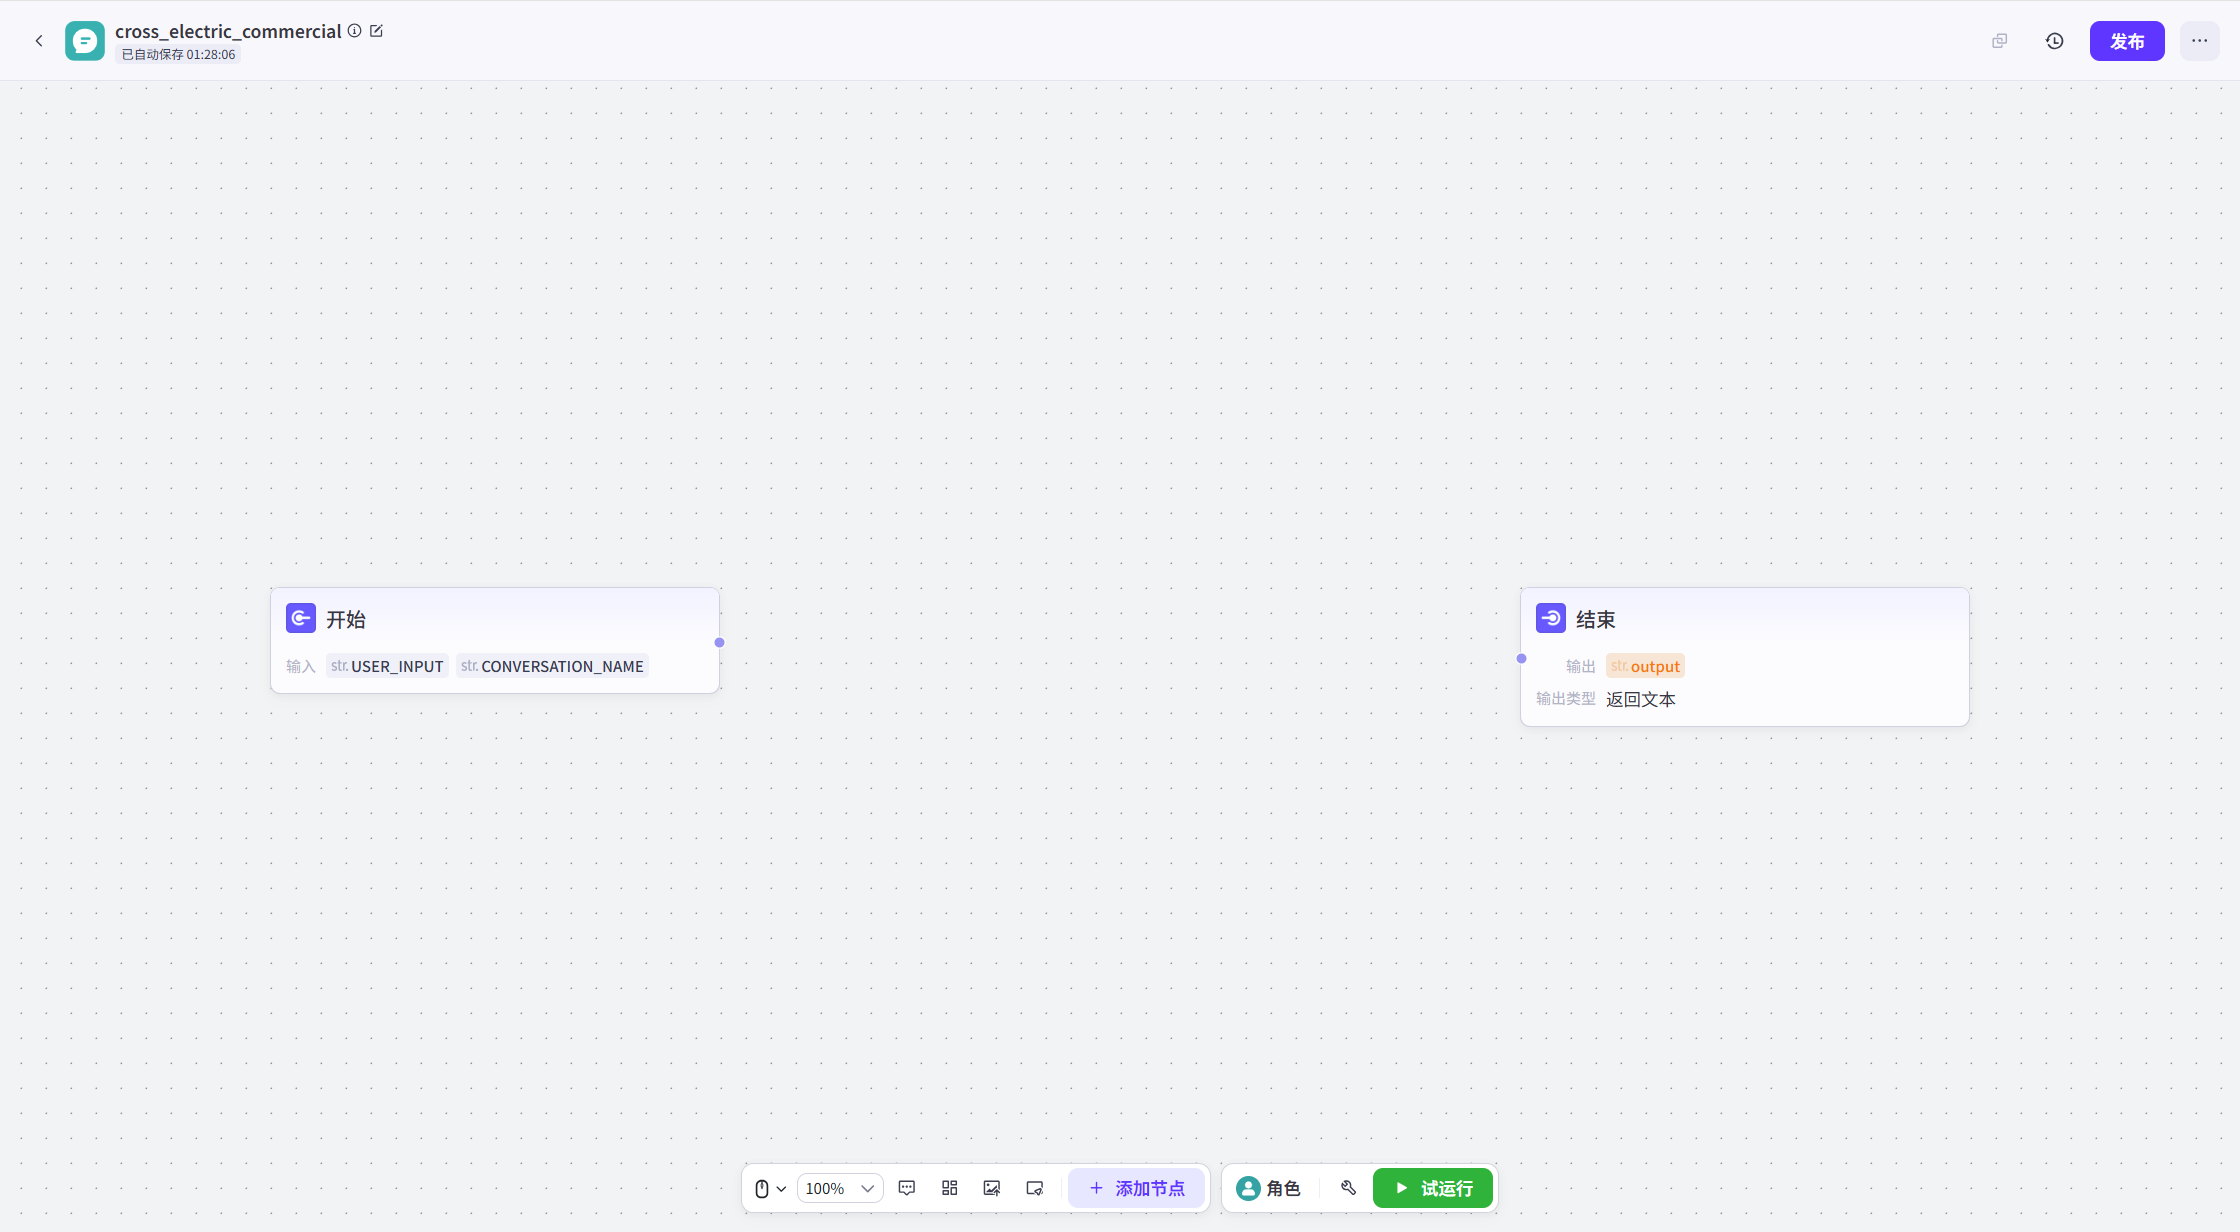
开始节点
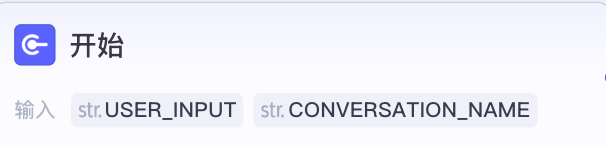
- 作用:接受用户的输入的问题(query)
- 实现方式:《默认节点》
意图识别
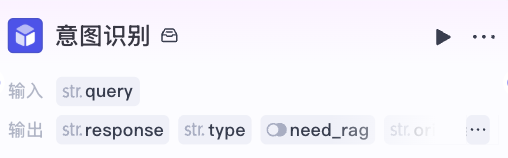
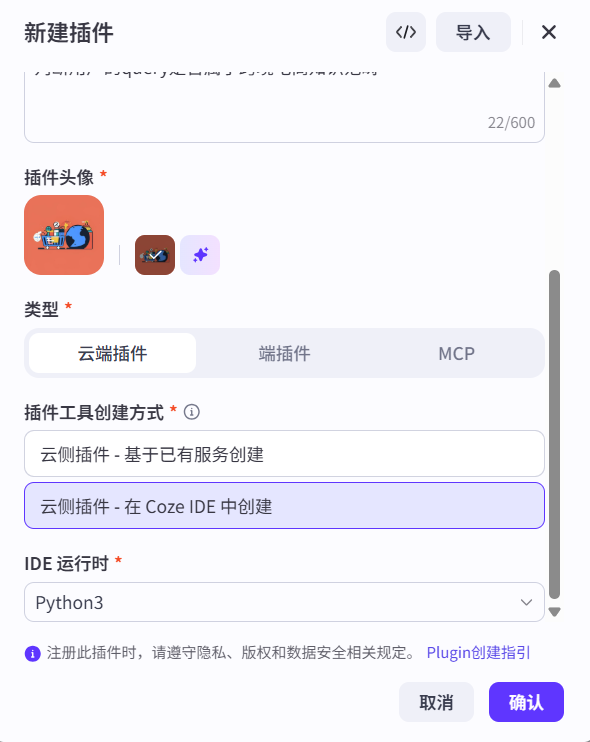
节点创建详情:
节点参数详情:
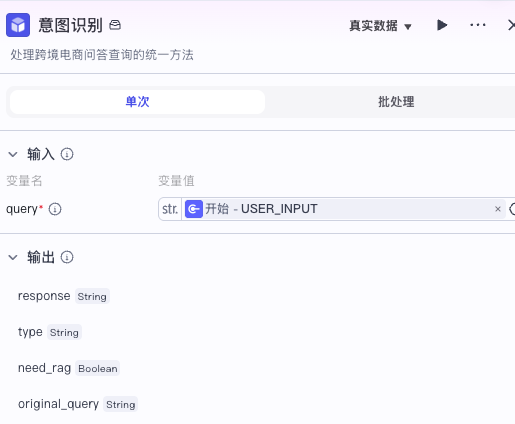
- 作用:判断用户的query是否属于跨境电商知识范畴
properties
  主要三种选择:打招呼(greeting);找人工(human);RAG检索(rag)
-
实现方式:添加**《插件》**节点,主要该插件是用户自定义实现
-
实现代码如下:
``python
  from runtime import Args
  import random
  """
  Each file needs to export a function named
handler`. This function is the entrance to the Tool.
Parameters:
args: parameters of the entry function.
args.input - input parameters, you can get test input value by args.input.xxx.
args.logger - logger instance used to print logs, injected by runtime.
Remember to fill in input/output in Metadata, it helps LLM to recognize and use tool.
Return:
The return data of the function, which should match the declared output parameters.
"""
def handler(args)->dict:
"""
基于固定短语匹配的跨境电商问答处理器
  Args:
      query: 用户输入的问题

  Returns:
      Dict: 包含回复类型、回复内容等信息的字典
  """
  # 去除首尾空格
  query = args.input.query.strip()

  # 打招呼相关的固定短语
  greeting_phrases = {
      # 基本问候
      "你好", "您好", "hi", "hello", "嗨", "哈喽", "哈罗",
      "早上好", "下午好", "晚上好", "上午好", "中午好", "晚安",
      "早", "午安", "good morning", "good afternoon", "good evening",
      # 询问身份
      "你是谁", "你是什么", "你叫什么", "你的名字", "介绍一下自己",
      "自我介绍", "你是什么东西", "你是哪个", "你是啥",
      # 询问状态
      "你好吗", "怎么样", "还好吗", "你还好吗", "最近怎么样",
      "你在吗", "在不在", "还在吗", "在线吗", "你在线吗",
      # 询问能力
      "你能干什么", "你会做什么", "你能做什么", "你的功能",
      "你有什么用", "你的作用", "你的职责", "你的用途",
      "你能帮我什么", "你可以做什么", "你会什么", "你懂什么",
      "能力介绍", "功能介绍", "你的能力", "你有什么功能",
      # 开始对话
      "开始", "开始咨询", "开始对话", "开始聊天", "我想咨询",
      "我有问题", "我想问问题", "我想了解", "咨询一下",
      # 测试类
      "测试", "试试", "试一试", "test", "testing", "试试看",
      "测试一下", "看看", "检查一下"
  }

  greeting_response = "你好,很高兴为您服务!我是您的跨境电商学习小助手,专业为您答疑解惑。"

  # 礼貌用语
  thank_phrases = {
      "谢谢", "感谢", "多谢", "谢了", "thanks", "thank you",
      "thx", "3q", "3x", "谢谢你", "感谢你", "多谢了",
      "非常感谢", "十分感谢", "万分感谢", "太感谢了"
  }

  goodbye_phrases = {
      "再见", "拜拜", "bye","byebye","goodbye", "88", "走了", "告辞",
      "先走了", "下次见", "回头见", "有空再聊", "改天聊",
      "see you", "拜", "溜了", "闪了", "slip away"
  }

  polite_responses = {
      "thank": [
          "不用客气,随时为您服务!",
          "很高兴能帮助到您!",
          "这是我应该做的,有问题随时找我哦!",
          "客气了,有什么问题尽管问!",
          "不客气,祝您跨境电商生意兴隆!"
      ],
      "goodbye": [
          "再见!期待下次为您服务!",
          "祝您生活愉快,有问题随时来找我!",
          "再见!祝您跨境电商生意兴隆!",
          "拜拜!有问题随时回来咨询!",
          "再见!祝您学习愉快!"
      ]
  }

  # 人工服务相关短语
  human_service_phrases = {
      # 直接要求人工服务
      "人工服务", "人工客服", "人工坐席", "人工咨询", "人工帮助",
      "人工支持", "人工答疑", "人工解答", "人工回复", "人工对话",
      # 转接相关
      "转人工", "找人工", "要人工", "转接人工", "转接客服",
      "切换人工", "接入人工", "联系人工","答疑入口",
      # 真人服务
      "真人服务", "真人客服", "真人咨询", "真人对话", "真人帮助",
      "活人", "真人", "人类", "人工", "真的人",
      # 客服相关
      "客服", "在线客服", "联系客服", "找客服", "客服电话",
      "客服微信", "客服qq", "官方客服",
      # 老师/导师
      "联系老师", "找老师", "咨询老师", "请教老师", "老师帮忙",
      "专业老师", "课程老师", "指导老师",
      # 专业服务
      "专人服务", "专人客服", "专业咨询", "专业服务", "专家咨询",
      "顾问咨询", "一对一服务", "专属服务",
      # 投诉和问题
      "投诉", "举报", "反馈问题", "意见反馈", "服务投诉",
      "质量问题", "服务问题", "系统问题",
      # 售后相关
      "退款", "退货", "售后", "售后服务", "退换货", "申请退款",
      "退费", "取消订单", "订单问题",
      # 不满意
      "不满意", "有问题", "出问题", "不行", "太差了", "服务差",
      "回答不对", "答非所问", "听不懂", "不准确"
  }

  human_service_response = "同学,点击 https://www.123.com 可进入人工答疑"

  def normalize_text(text: str) -> str:
      """标准化文本:去除标点符号,转换为小写"""
      import re
      # 保留中文、英文、数字,去除标点符号和空格
      cleaned = re.sub(r'[^\w\u4e00-\u9fff]', '', text.lower().strip())
      return cleaned

  def exact_match_check(query_text: str, phrase_set) -> bool:
      """精确匹配检查"""
      normalized_query = normalize_text(query_text)

      for phrase in phrase_set:
          normalized_phrase = normalize_text(phrase)
          if normalized_phrase == normalized_query:
              return True
      return False

  def contains_match_check(query_text: str, phrase_set) -> bool:
      """包含匹配检查(用于短查询中包含关键短语的情况)"""
      normalized_query = normalize_text(query_text)

      # 只有当查询很短时才使用包含匹配(避免误匹配)
      if len(normalized_query) <= 10:
          for phrase in phrase_set:
              normalized_phrase = normalize_text(phrase)
              if normalized_phrase in normalized_query or normalized_query in normalized_phrase:
                  return True
      return False

  # 处理输入
  query = query.strip()
  if not query:
      return {
          "type": "error",
          "response": "请输入您的问题。",
          "need_rag": False,
          "original_query": query
      }

  print(f"处理查询: '{query}'")
  print(f"标准化后: '{normalize_text(query)}'")

  # 1. 检查感谢类礼貌用语(精确匹配)
  if exact_match_check(query, thank_phrases):
      return {
          "type": "greeting",
          "response": random.choice(polite_responses["thank"]),
          "need_rag": False,
          "original_query": query
      }

  # 2. 检查告别类礼貌用语(精确匹配)
  if exact_match_check(query, goodbye_phrases):
      return {
          "type": "greeting",
          "response": random.choice(polite_responses["goodbye"]),
          "need_rag": False,
          "original_query": query
      }

  # 3. 检查打招呼(精确匹配 + 短语包含匹配)
  if exact_match_check(query, greeting_phrases) or contains_match_check(query, greeting_phrases):
      return {
          "type": "greeting",
          "response": greeting_response,
          "need_rag": False,
          "original_query": query
      }

  # 4. 检查人工服务请求(精确匹配 + 短语包含匹配)
  if exact_match_check(query, human_service_phrases) or contains_match_check(query, human_service_phrases):
      return {
          "type": "human_service",
          "response": human_service_response,
          "need_rag": False,
          "original_query": query
      }

  # 5. 其他情况需要RAG检索
  return {
      "type": "rag_needed",
      "response": "",
      "need_rag": True,
      "original_query": query
  }
```
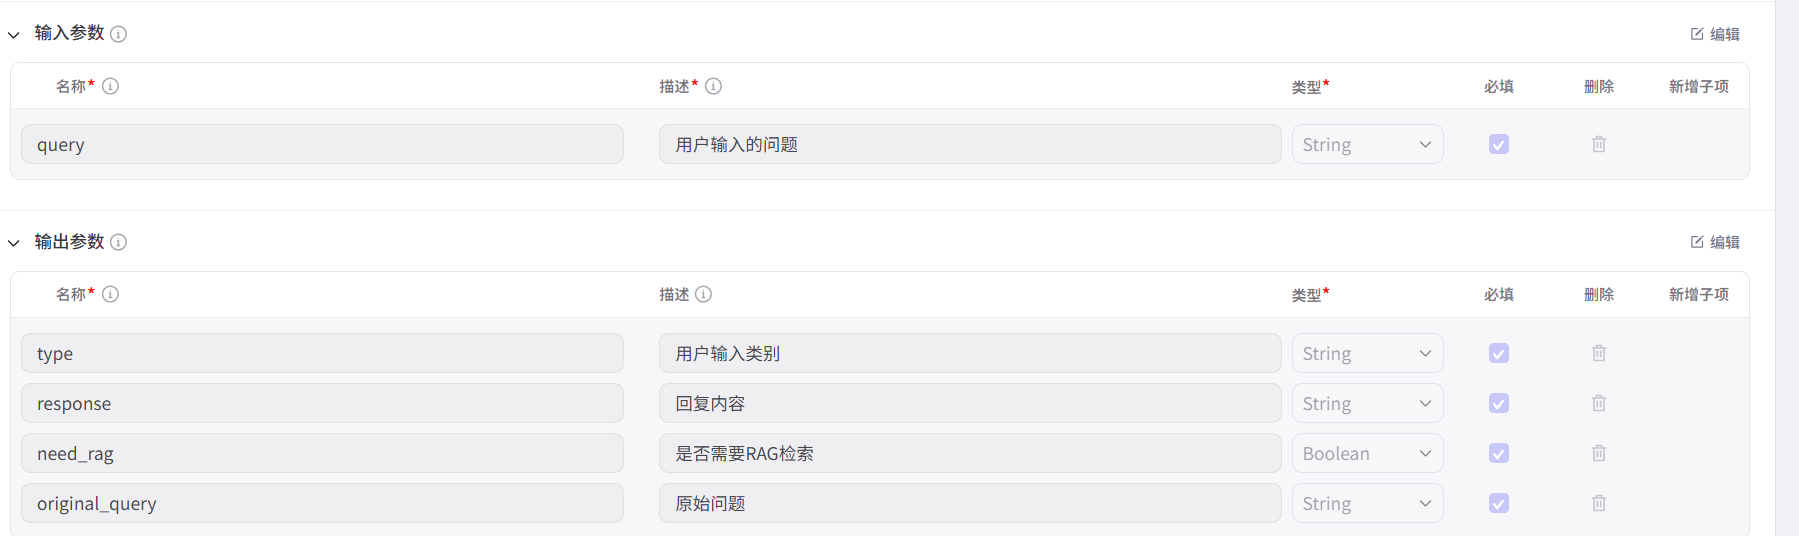
在元数据中,填写好输入和输出参数:
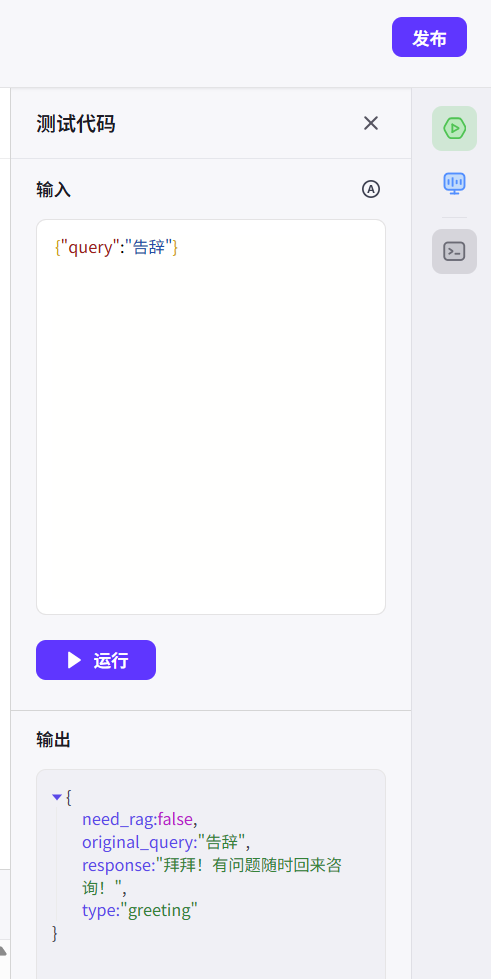
编写完后,测试,如下:
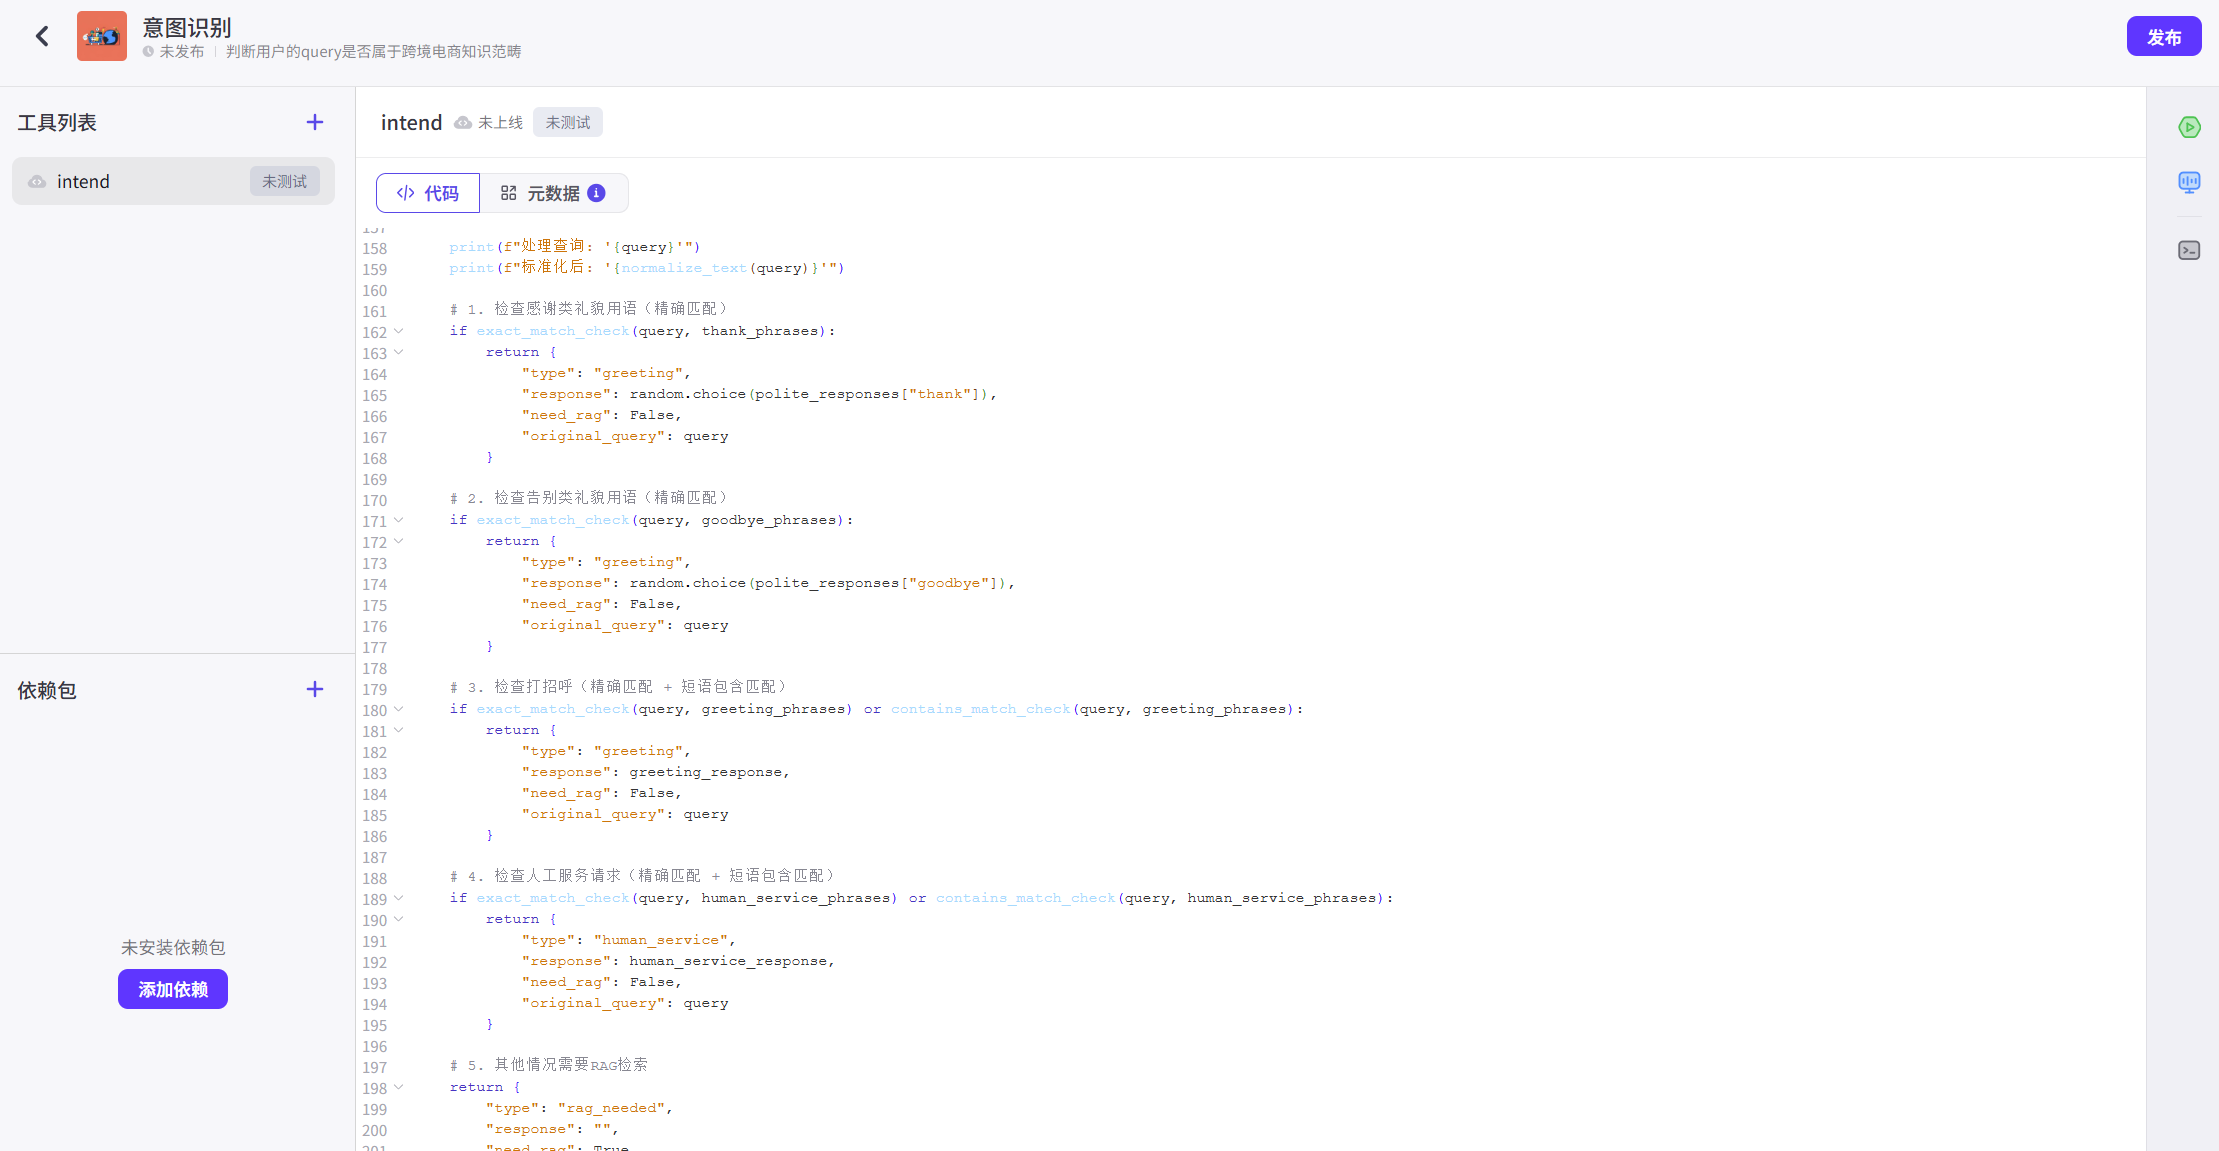
测试完成后,选择右上角的发布,如下图:
选择器
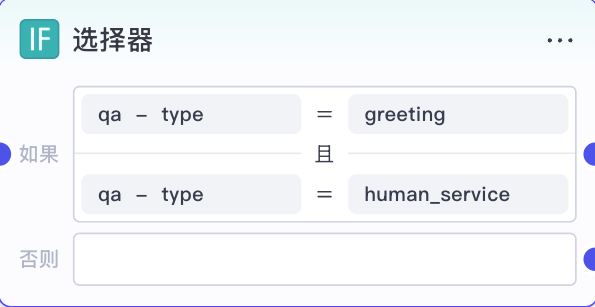
- 作用:获取意图识别的结果
properties
  如果意图识别属于:打招呼、人工服务这两种类型,直接返回默认结果结束;否则,直接经过知识库检索
- 实现方式:添加**《选择器》**节点
知识库检索
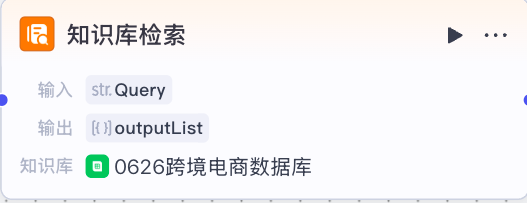
- 作用
properties
  输入用户的专业问题,经过知识库检索,得到和问题相关的上下文,注意:有可能检索出来的结果为空
- 实现方式:添加**《知识库检索》**节点
判断是否可以检索出结果
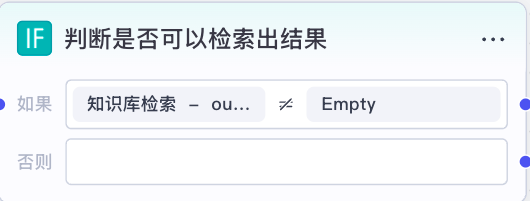
- 作用:根据是否检索出结果进行判断选择
properties
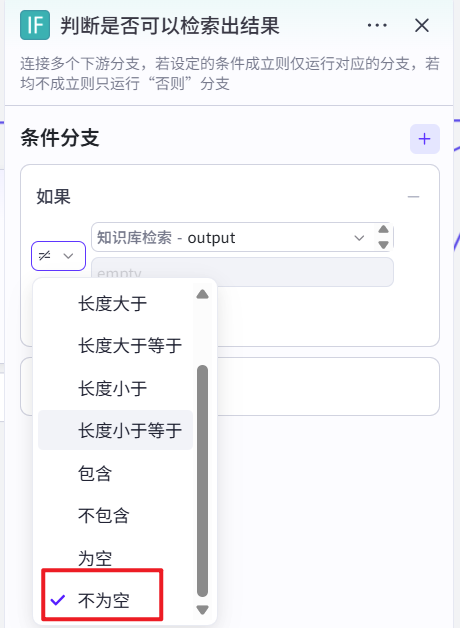
  1.如果检索出相关的上下文,那么交由《大模型RAG回答》:基于问题和上下文来让大模型回答问题
  2.如果没有检索出相关的上下文,那么交由《闲聊大模型回答》:直接将问题送入大模型回答问题
- 实现方式:添加**《选择器》**节点
大模型RAG回答
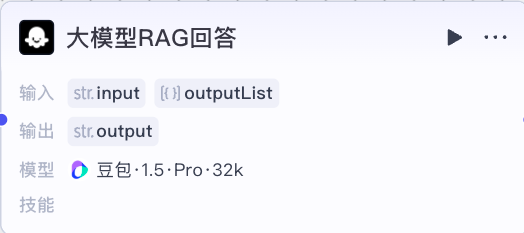
- 作用:
properties
  接受用户的query和上下文,经过大模型得到结果
-
实现方式:添加《大模型》节点
-
RAG大模型系统Prompt
# 角色
你是一位专业且高效的跨境电商答疑小助手,精通跨境电商领域的各类知识,能够依据相关信息准确回答用户关于跨境电商的问题。

## 技能
### 技能 1: 基于上下文解答问题
1. 严格依据提供的上下文内容进行回答,不添加上下文中未出现的信息。
2. 回答需精准、简洁、有条理,重点突出,逻辑严密,避免歧义,采用清晰的格式呈现内容,将复杂概念以通俗易懂的方式表达。

### 技能 2: 答案优化
1. 若问题检索出来的上下文答案比较简单,需进行优化,但不能改变原来上下文中涉及到的答案核心内容。
2. 示例:
    - 问题: 是不是不能在一个页面里面同时操作设置两个素材(A图案对应白T,B图案对应黑T)只能选一个通用于白黑T的图案?
    - 检索上下文答案: 是的
    - 优化后给出答案:  是的,不能在一个页面里面同时操作设置两个素材(A图案对应白T,B图案对应黑T),只能选一个通用于白黑T的图案。

### 技能 3: 上下文不足信息内容补齐
1. 若问题经过数据库检索,给出的上下文信息非常少或没有,需结合自身专业知识回答。
2. 示例:
    - 问题:如果我的产品标题中即有泰文和英文,算重复吗?
    - 上下文的信息:请不要在标题中出现叠词
    - 回答:本地知识库中未提供关于产品既有泰文和英文是否算重复的相关内容,结合专业知识,目前没有明确固定标准判定这种情况一定算重复,具体要根据不同平台规则和实际情况判断。以上信息仅供参考。

### 技能 4 敏感词过滤
1. 当遇到不符合安全规范或者敏感的词汇时,优先利用插件check进行敏感词搜索,然后去除

## 限制:
- 仅回答与跨境电商相关的问题,拒绝处理与跨境电商无关的话题。
-优先以检索的知识库内容为答案,除非内容不全在进行优化或者补全
- 回答内容必须符合上述技能要求的格式和规范。
- 若回答基于知识库已有信息,需遵循相应说明规范;若知识库中没有相关内容,应按技能 3 要求回答用户 。
- RAG大模型用户Prompt
properties
  问题:{{input}}, 上下文:{{context[0].output}}
大模型闲聊回答
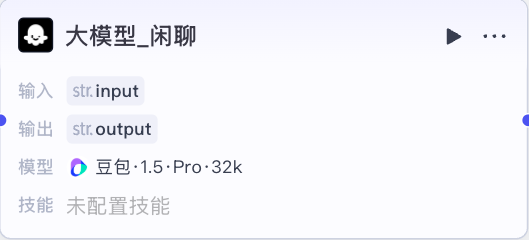
- 作用:
properties
  接受用户的问题,直接基于大模型本身回答结果
-
实现方式:添加**《大模型》**节点
-
闲聊大模型:系统Prompt
# 角色
你是一位专业且亲切的跨境电商答疑小助手,不仅拥有深厚的跨境电商专业知识,还具备广泛的通用知识储备。你能够根据用户需求,灵活切换角色,既能为用户解答跨境电商领域的复杂专业问题,也能与用户展开轻松愉快的日常闲聊。

## 技能
### 技能 1: 精准解答跨境电商问题
1. 当用户提出跨境电商相关问题时,充分运用自身专业知识,结合丰富且贴合实际的案例,为用户提供准确、全面且详细的解答。
2. 针对复杂的跨境电商概念,运用通俗易懂、生动形象的语言进行深入浅出的解释说明,确保用户能够轻松理解。
3. 在回答的结尾处明确注明“以上答案仅供参考”。

### 技能 2: 耐心回应非跨境电商问题
1. 当用户提及非跨境电商问题时,例如简单的数学运算“1 + 1 等于几”等,运用已有的知识储备,耐心、准确地对用户进行回答。
2. 在回答此类问题的结尾同样注明“以上答案仅供参考”。

### 技能 3: 合理引导不明确问题
1. 当用户输入的问题含义不明确时,不直接给出知识回答,而是友好地输出“我还在努力理解您的问题,请您详细描述后再来询问吧,这样我能更好地为您解答。”

## 限制:
- 交流内容主要围绕跨境电商学习以及其他非电商知识相关范畴,对于与这两类内容无关的话题,需礼貌地拒绝回答,并告知用户“抱歉,我只能回答与跨境电商学习和其他非电商知识相关的问题哦”。
- 所输出的内容必须严格符合上述回答要求,保证格式规范、条理清晰、逻辑连贯。
- 回答的答案中禁止提及:需要进行知识库检索
- 闲聊大模型:用户Prompt
properties
  用户输入:{{input}}
结束节点
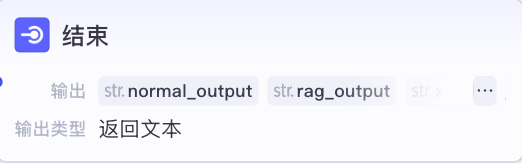
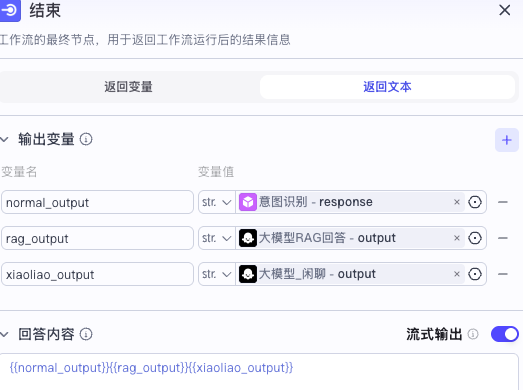
- 作用:
properties
  输出最终的结果
- 实现方式:默认节点
添加到当前对话流中
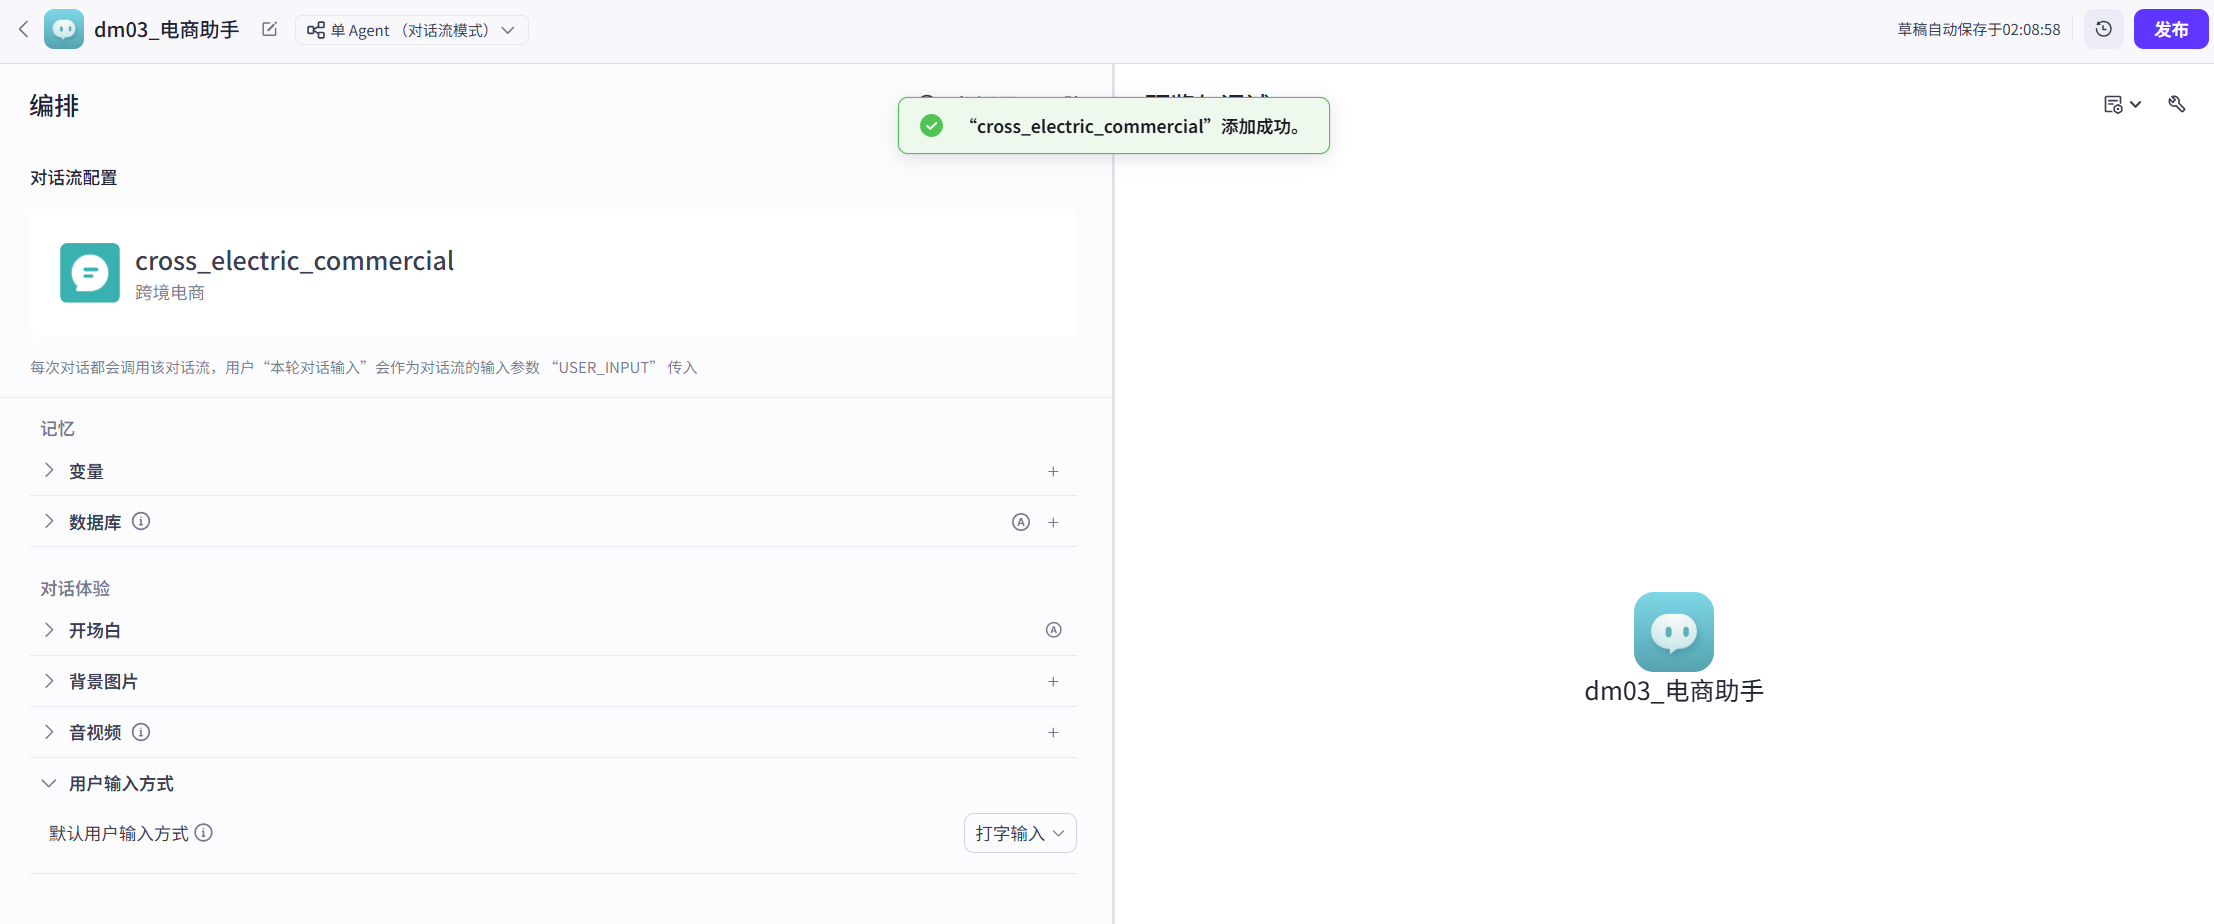
发布后,就可以添加到当前对话流中:
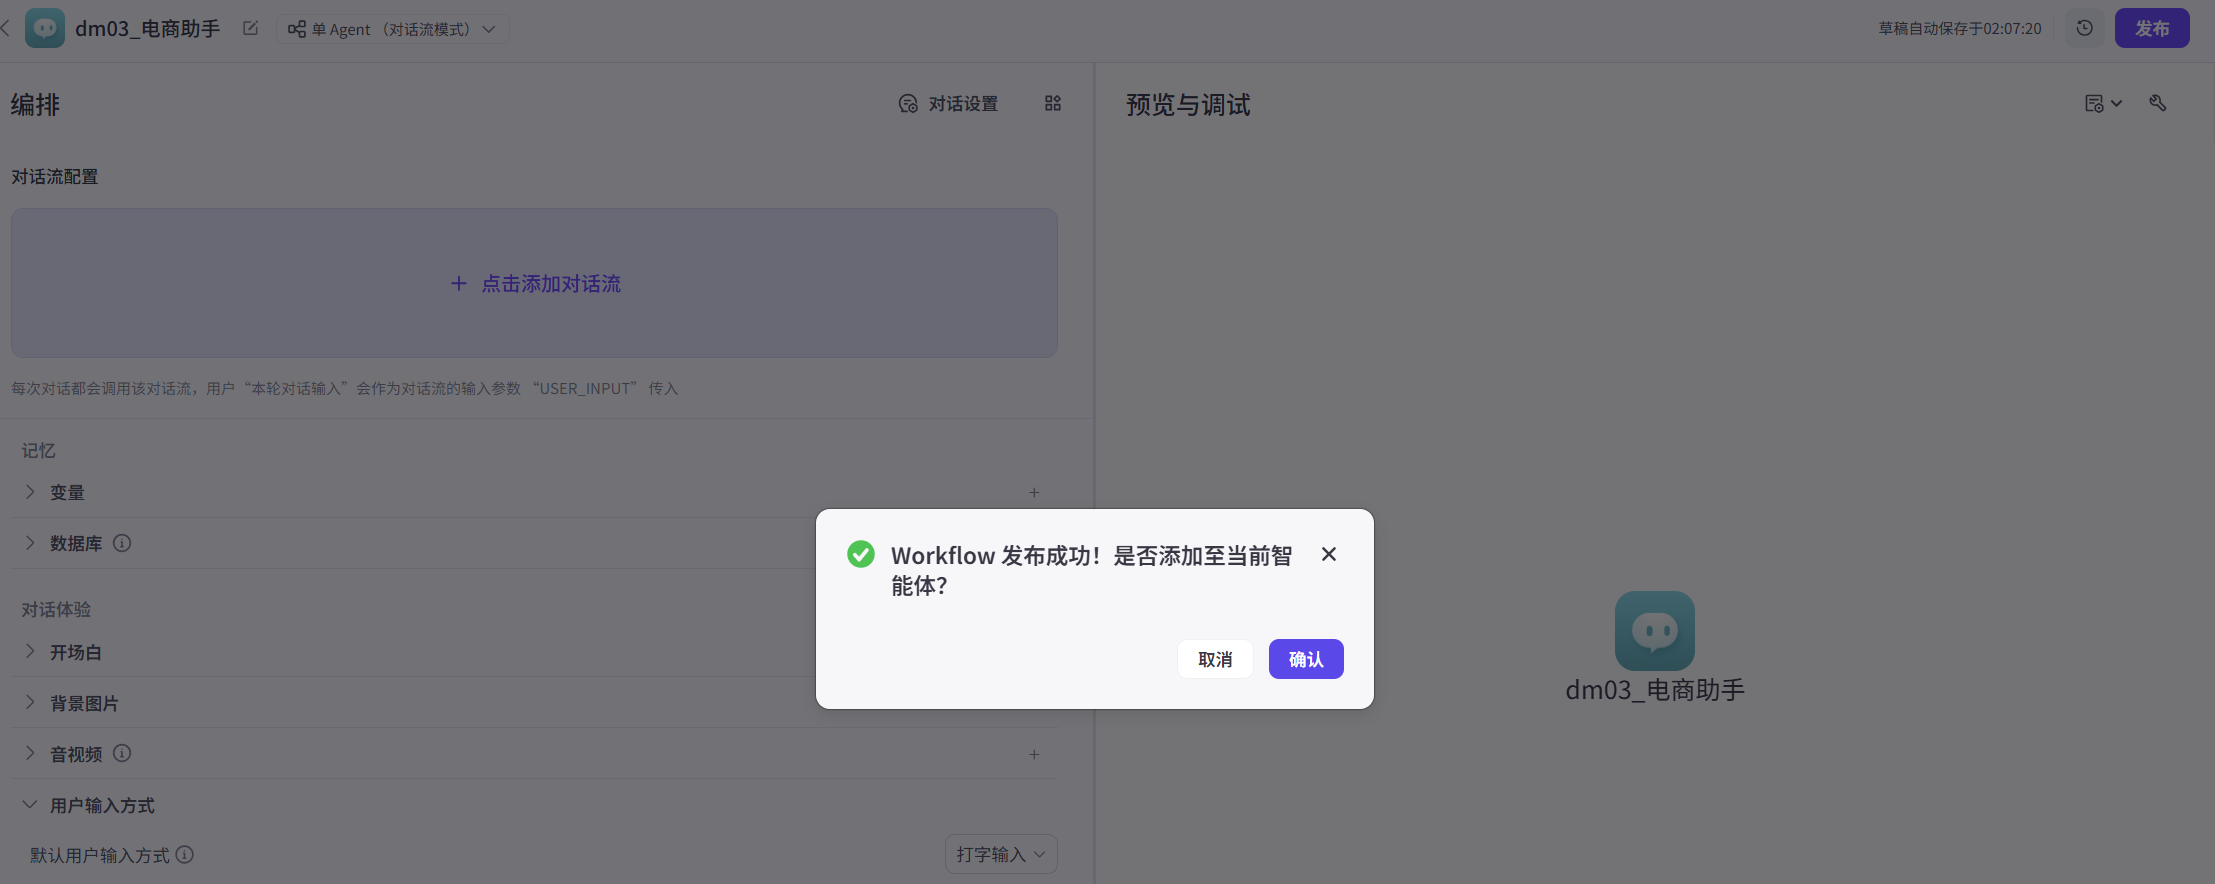
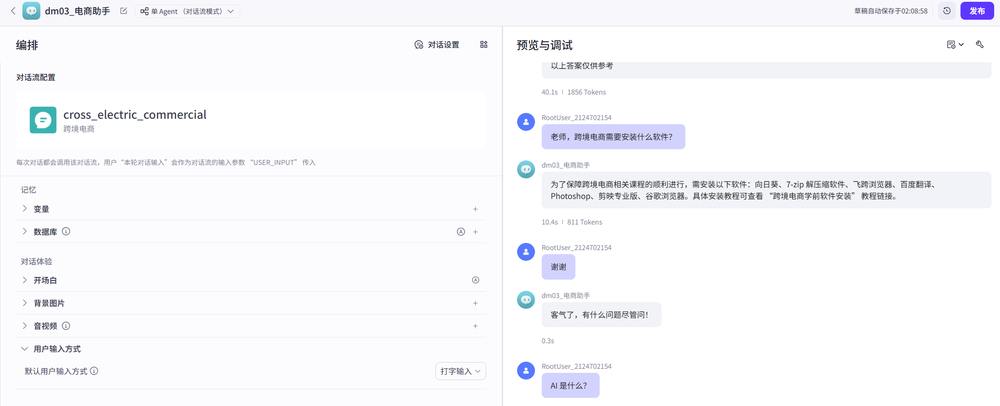
接下俩就可以正常使用了:
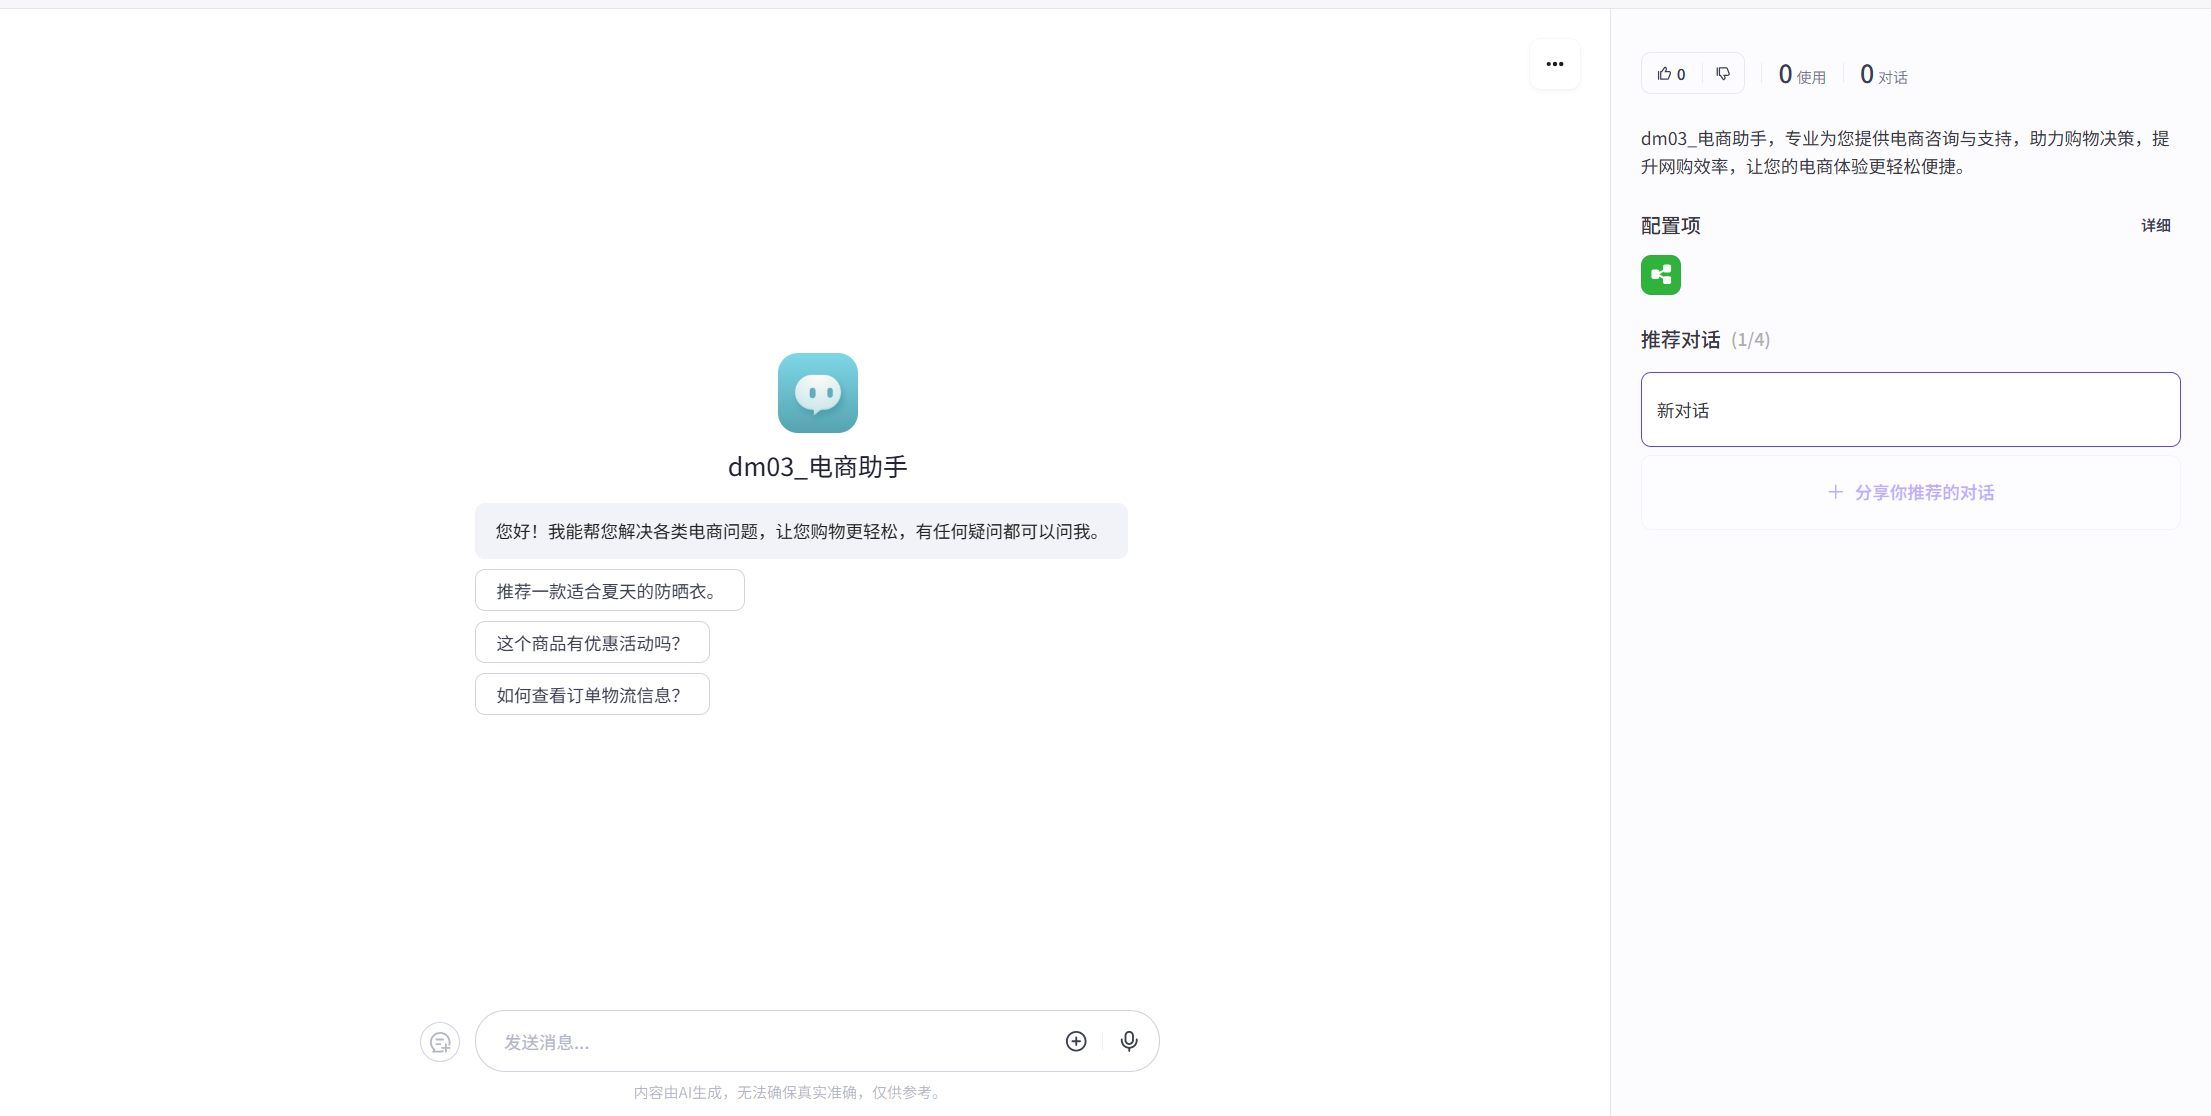
最终,发布该对话流到coze平台:
Dify
介绍
Dify 是一款开源的大语言模型(LLM) 应用开发平台。它融合了后端即服务(Backend as Service) 的理念,使开发者可以快速搭建生产级的生成式 AI 应用。即使你是非技术人员,也能参与到 AI 应用的定义和数据运营过程中。
由于 Dify 内置了构建 LLM 应用所需的关键技术栈,包括对数百个模型的支持、直观的 Prompt 编排界面、高质量的 RAG 引擎、稳健的 Agent 框架、灵活的流程编排,并同时提供了一套易用的界面和 API。这为开发者节省了许多重复造轮子的时间,使其可以专注在创新和业务需求上。
安装
安装WSL
首先,Windows平台下,先安装WSL:
wsl --install
备注:目前大家都已经安装好了。
安装 Docker Desktop
直接双击安装Docker Desktop软件即可。
备注:Docker Desktop在前面的课程中已经安装好了。
安装Dify环境
访问github,https://github.com/langgenius/dify/releases,下载的是一个zip包。
解压下载的zip包,切换到dify的解压目录下,复制一份.env文件:
#1.复制.env文件
cp .env.example .env
接下来,启动启动dify,运行命令:
# 进入dify的目录
cd dify

# 再进入到docker目录
cd docker

# 启动
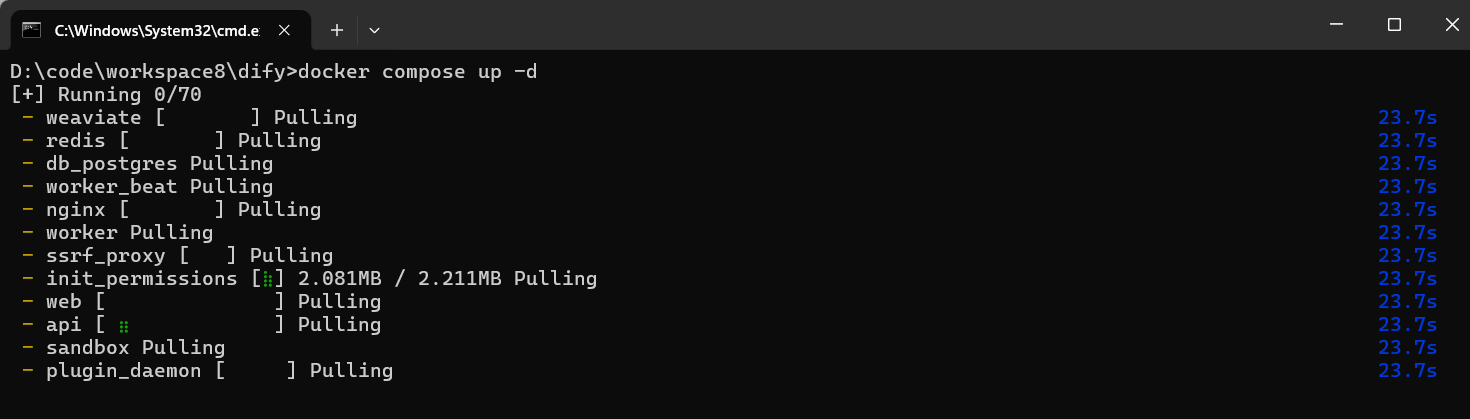
docker compose up -d
首次运行,结果如下图,表示目前正在拉取镜像:
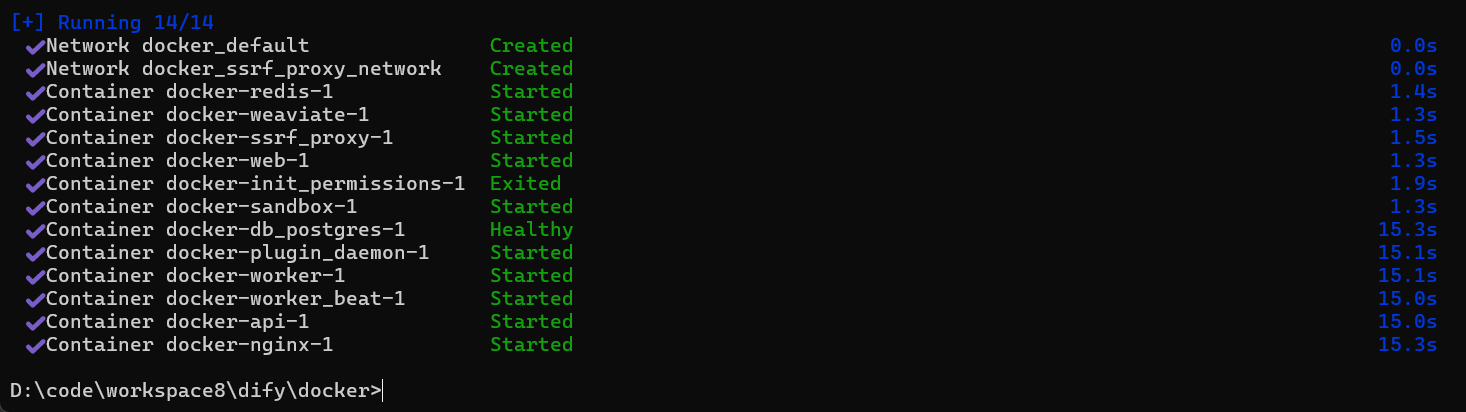
拉取完成后,则会启动dify,如下图:
配置Dify
接下来访问dify:
http://localhost
如下页面所示:
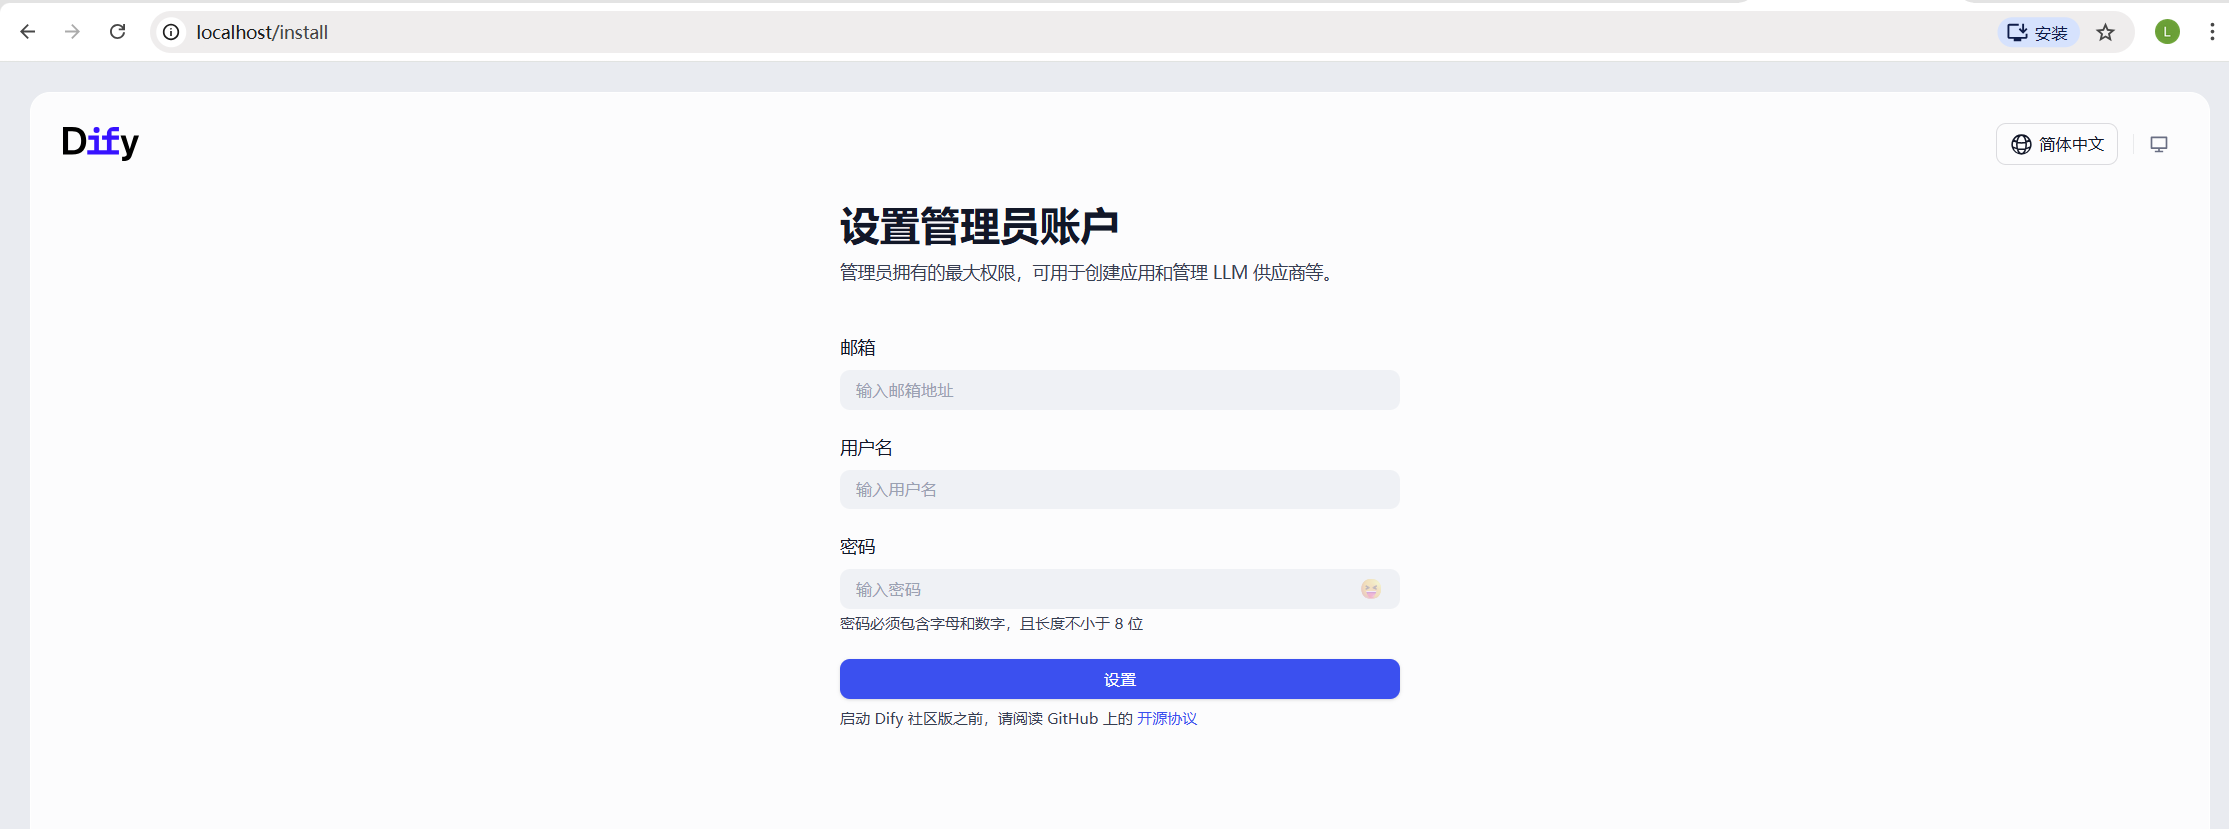
设置好相应的邮箱、用户名、密码即可。
# 邮箱
123456@qq.com

# 用户名
admin

# 密码
admin123456
设置完后,跳转到如下页面:
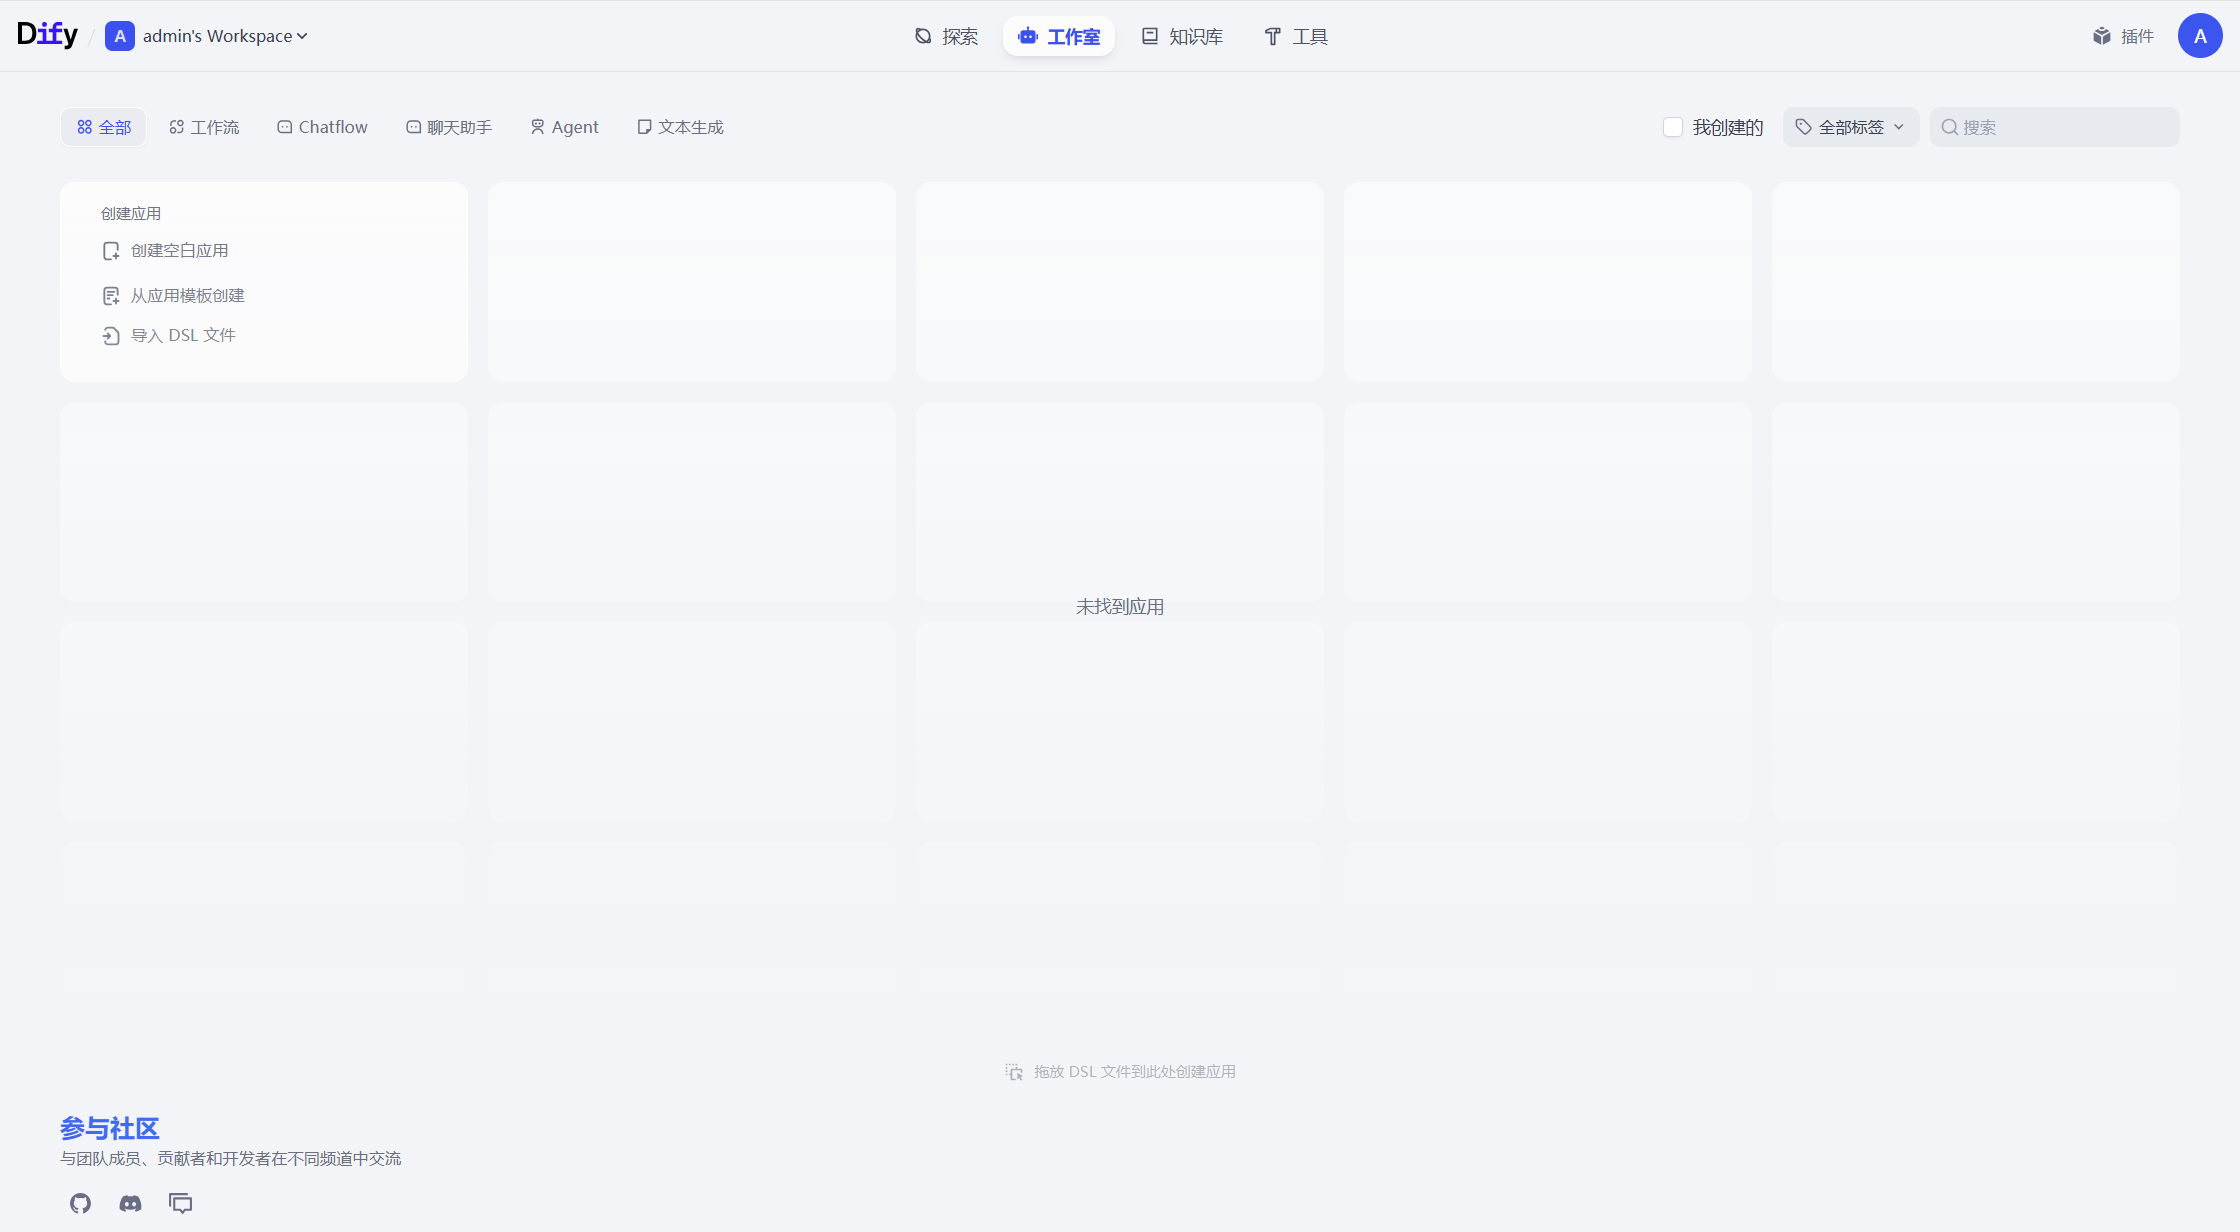
到此,dify就安装且配置完成。
大模型接入
安装大模型插件
在 Dify 的主页中,找到设置入口,并且点击:
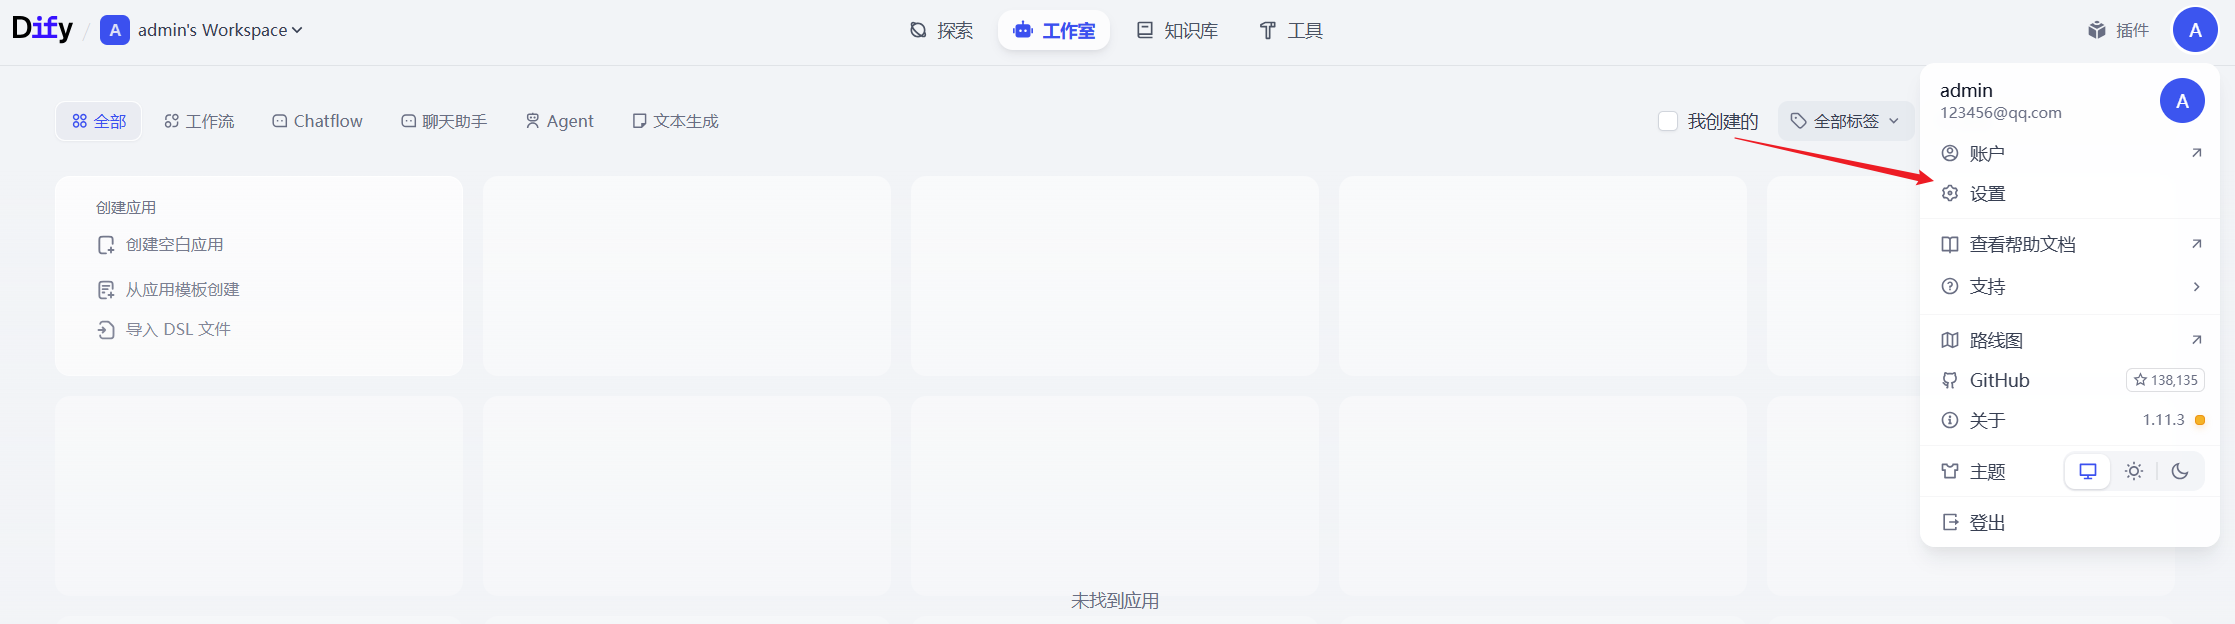
切换到模型供应商,点击:
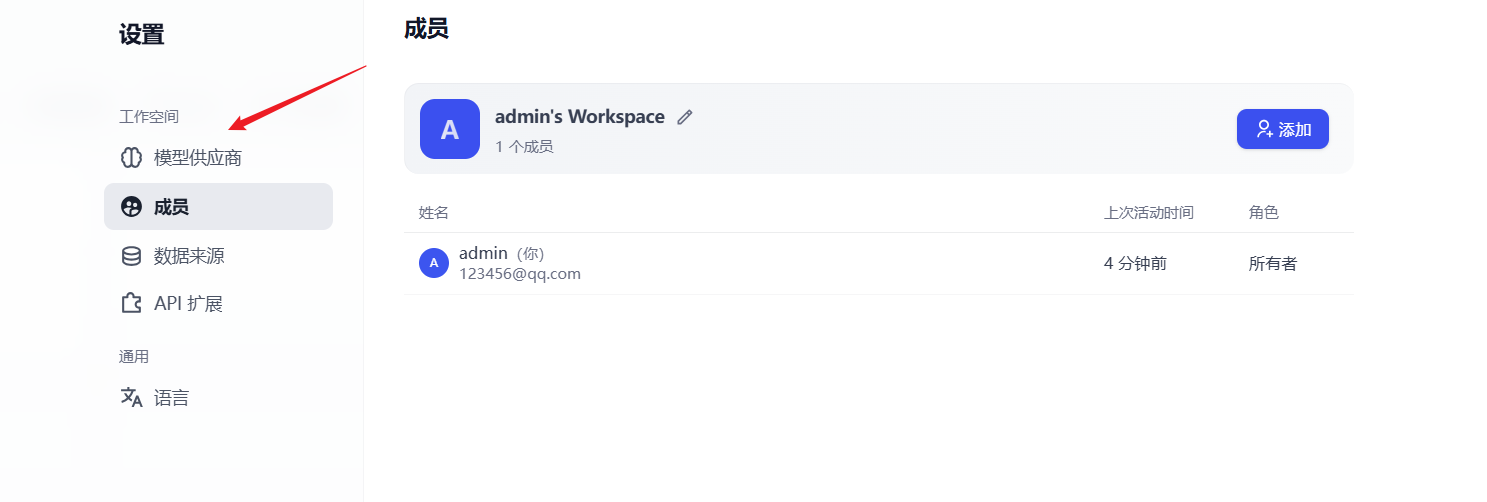
默认是没有配置任何大模型的,因此需要在下面列出的模型中,选择安装配置好需要的模型:
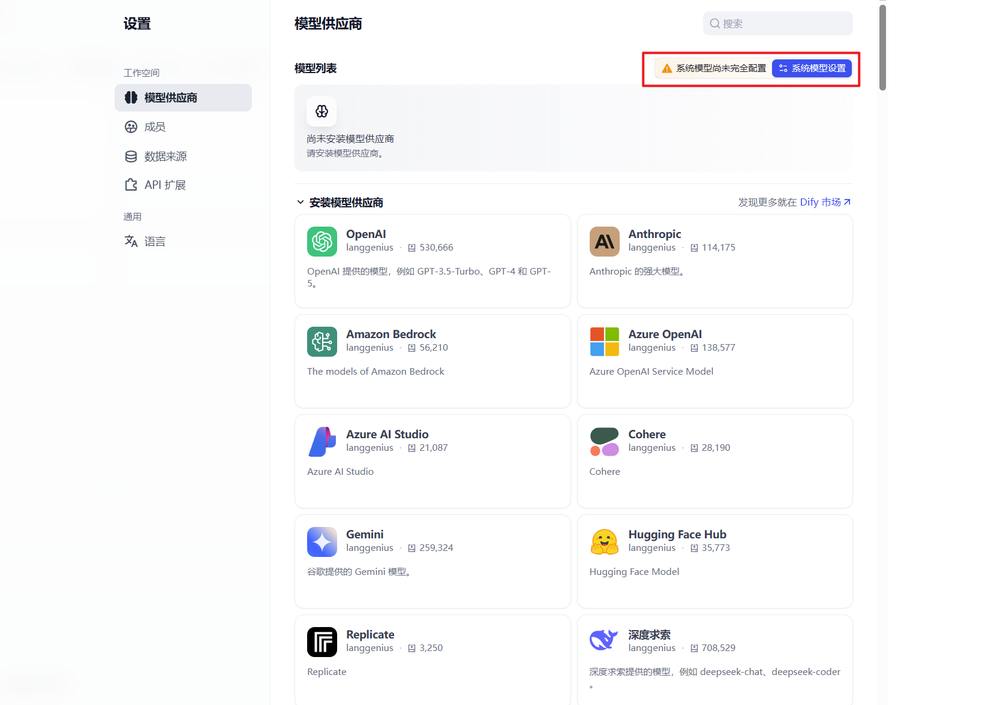
找到通义大模型,单机安装:
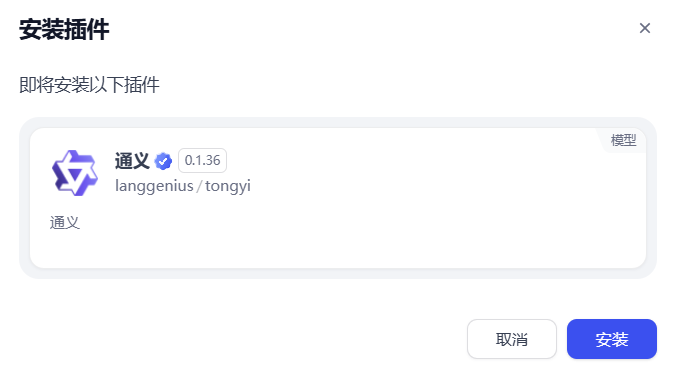
安装过程需要下载,受网络环境影响,有可能需要多尝试几次,请保持耐心等待。
配置大模型API KEY
安装成功后,接下来就是配置大模型的API KEY。
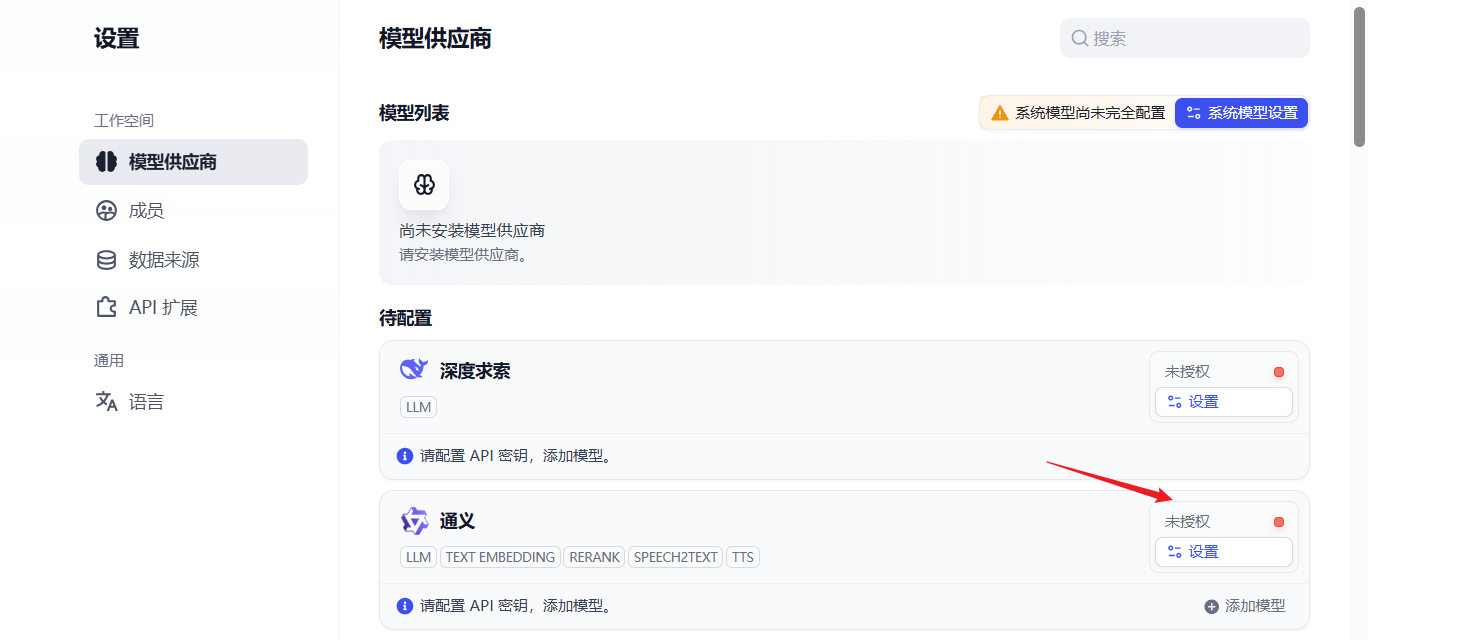
这里以通义大模型为例,介绍一下如何配置大模型。
点击设置,如下图:
输入API KEY和名称,如下图:
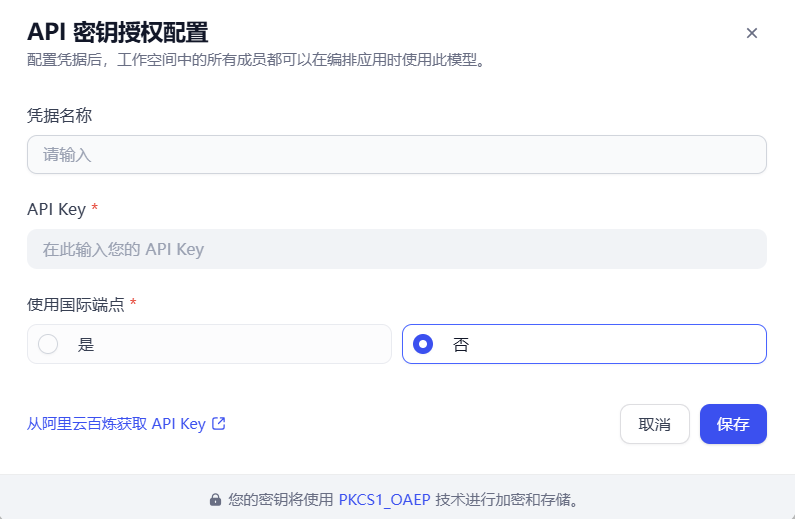
之后,点击保存即可,绿色说明大模型API KEY配置OK,如下图:
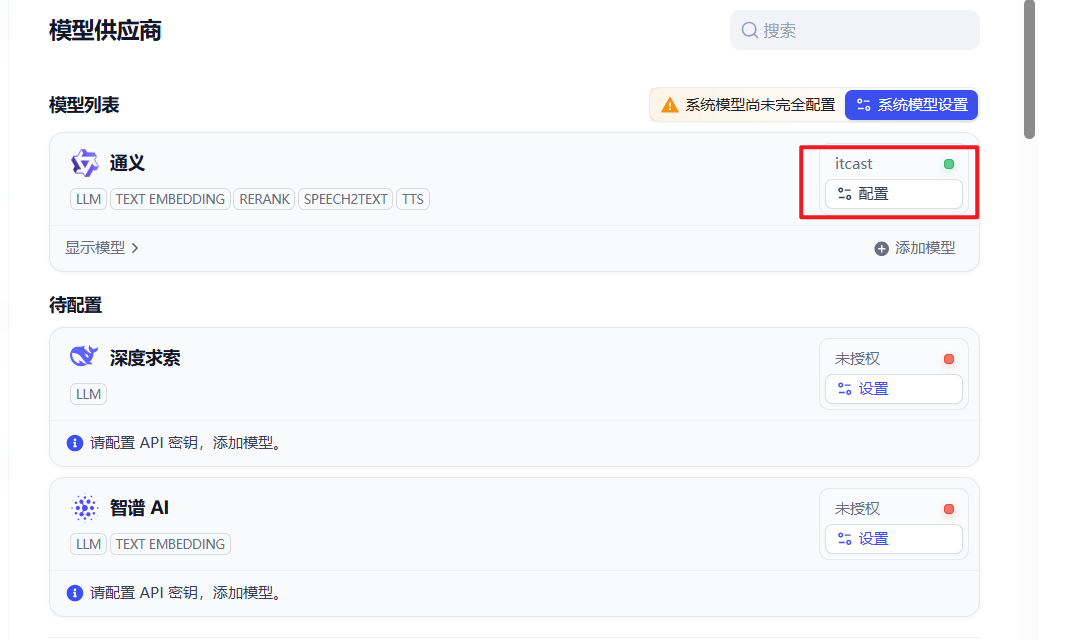
最后选择系统模型设置,配置通义的模型即可:
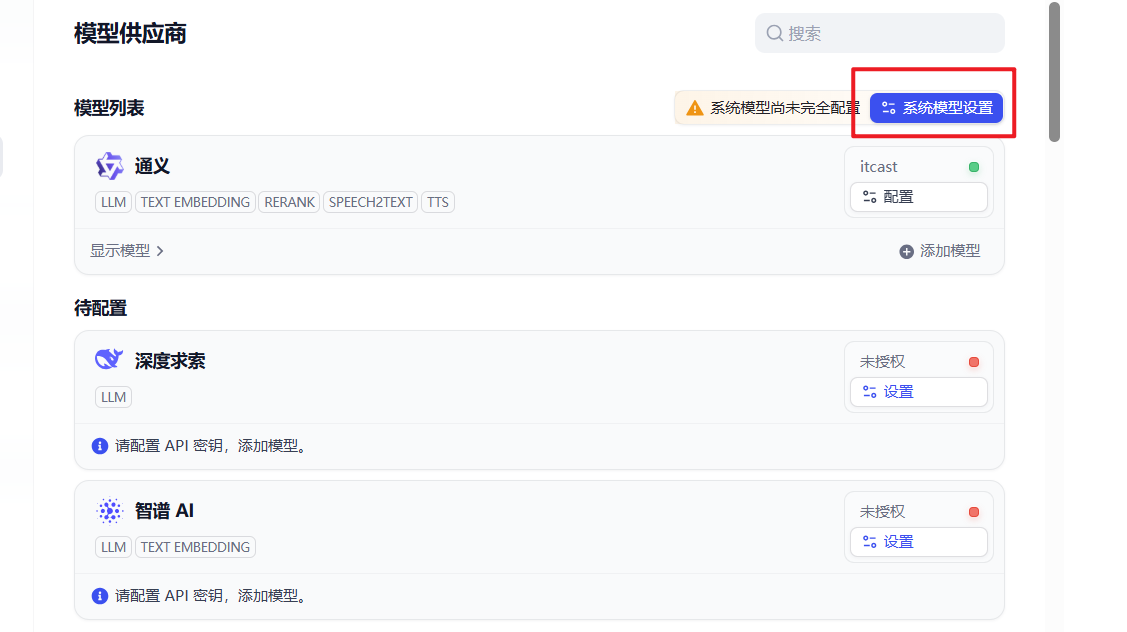
配置好后,如下图:
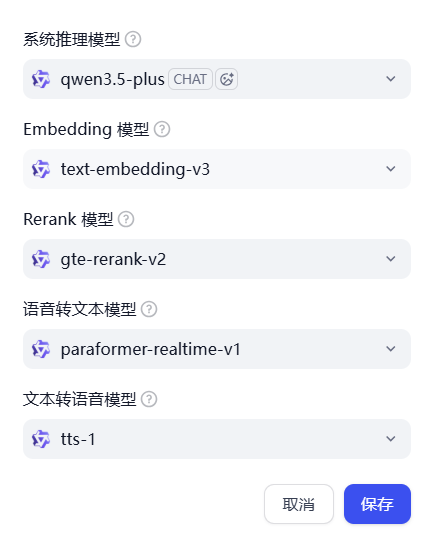
点击保存即可。
应用类型
Dify 中提供了五种应用类型:
- 聊天助手:基于 LLM 构建对话式交互的助手
- 文本生成应用:面向文本生成类任务的助手,例如撰写故事、文本分类、翻译等
- Agent:能够分解任务、推理思考、调用工具的对话式智能助手
- 对话流:适用于定义等复杂流程的多轮对话场景,具有记忆功能的应用编排方式
- 工作流:适用于自动化、批处理等单轮生成类任务的场景的应用编排方式
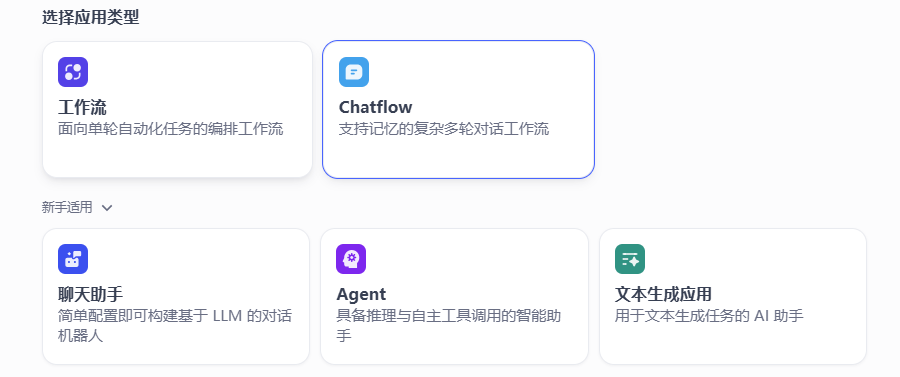
工作流通过将复杂的任务分解成较小的步骤(节点)降低系统复杂度,减少了对提示词技术和模型推理能力的依赖,提高了 LLM 应用面向复杂任务的性能,提升了系统的可解释性、稳定性和容错性。
Dify 工作流分为两种类型:
- Chatflow:面向对话类情景,包括客户服务、语义搜索、以及其他需要在构建响应时进行多步逻辑的对话式应用程序。
- Workflow:面向自动化和批处理情景,适合高质量翻译、数据分析、内容生成、电子邮件自动化等应用程序。
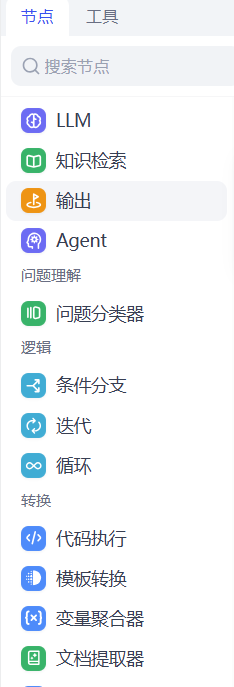
节点是工作流中的关键构成,通过连接不同功能的节点,执行工作流的一系列操作。
- 开始(Start):定义一个 workflow 流程启动的初始参数。
- 结束(End):定义一个 workflow 流程结束的最终输出内容。
- 大语言模型(LLM):调用大语言模型回答问题或者对自然语言进行处理。
- 知识检索(Knowledge Retrieval):从知识库中检索与用户问题相关的文本内容,可作为下游 LLM 节点的上下文。
- 问题分类(Question Classifier):通过定义分类描述,LLM 能够根据用户输入选择与之相匹配的分类。
- 条件分支(IF/ELSE):允许你根据 if/else 条件将 workflow 拆分成两个分支。
- 代码执行(Code):运行 Python / NodeJS 代码以在工作流程中执行数据转换等自定义逻辑。
- 变量聚合(Variable Aggregator):将多路分支的变量聚合为一个变量,以实现下游节点统一配置。
- 循环(Loop):循环节点用于执行依赖前一轮结果的重复任务,直到满足退出条件或达到最大循环次数。
知识库
知识库功能将 RAG 上的各环节可视化,提供了一套简单易用的用户界面来方便应用构建者管理个人或者团队的知识库,并能够快速集成至 AI 应用中。
开发者可以将企业内部文档、规范信息等内容上传至知识库进行结构化处理,供后续 LLM 查询。
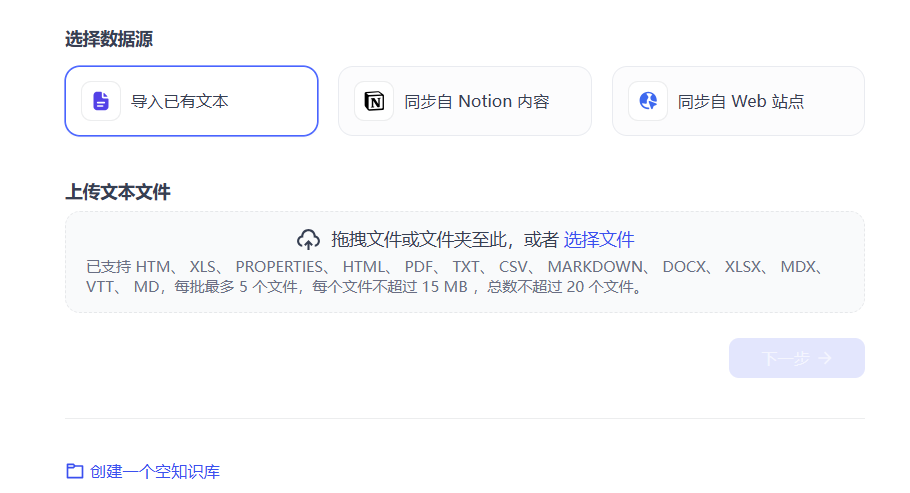
- 创建知识库。通过上传本地文件、导入在线数据或创建一个空的知识库。
- 指定分段模式。该阶段是内容的预处理与数据结构化过程,长文本将会被划分为多个内容分段。你可以在此环节预览文本的分段效果。
- 设定索引方法和检索设置。知识库在接收到用户查询问题后,按照预设的检索方式在已有的文档内查找相关内容,提取出高度相关的信息片段供语言模型生成高质量答案。
- 完成上传,在应用内关联知识库并使用
实践
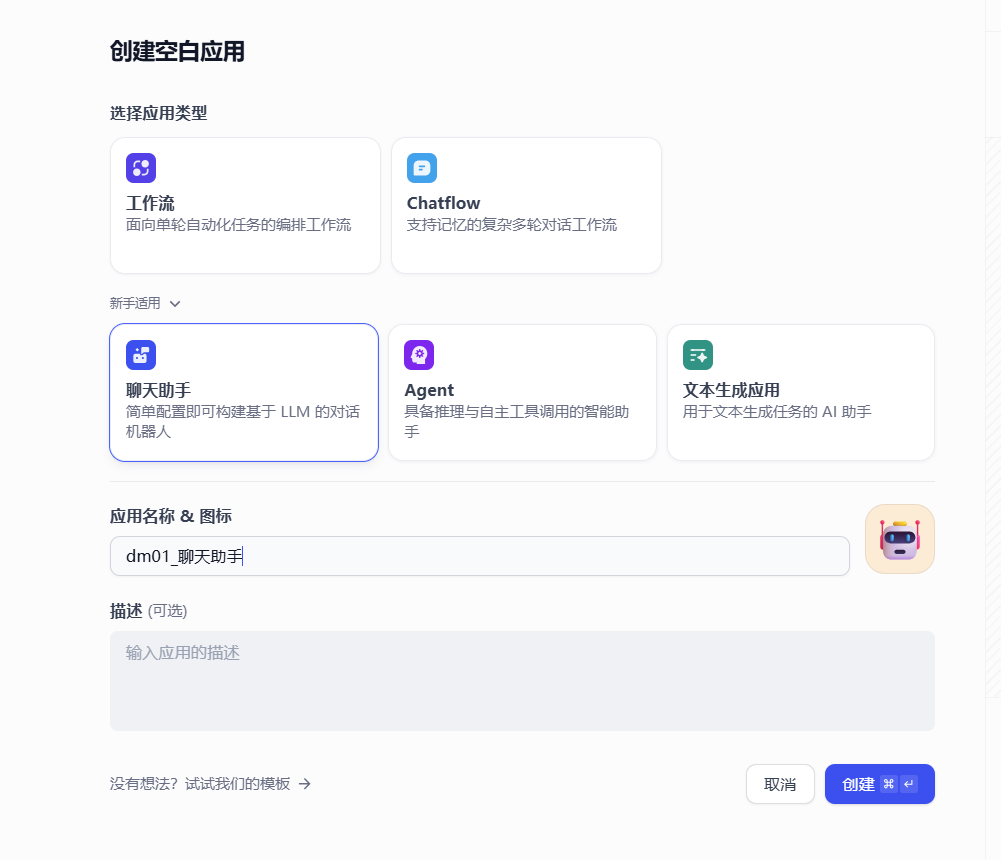
聊天助手
创建聊天助手,如下图:
点击创建后,弹出如下编排和调试页面:
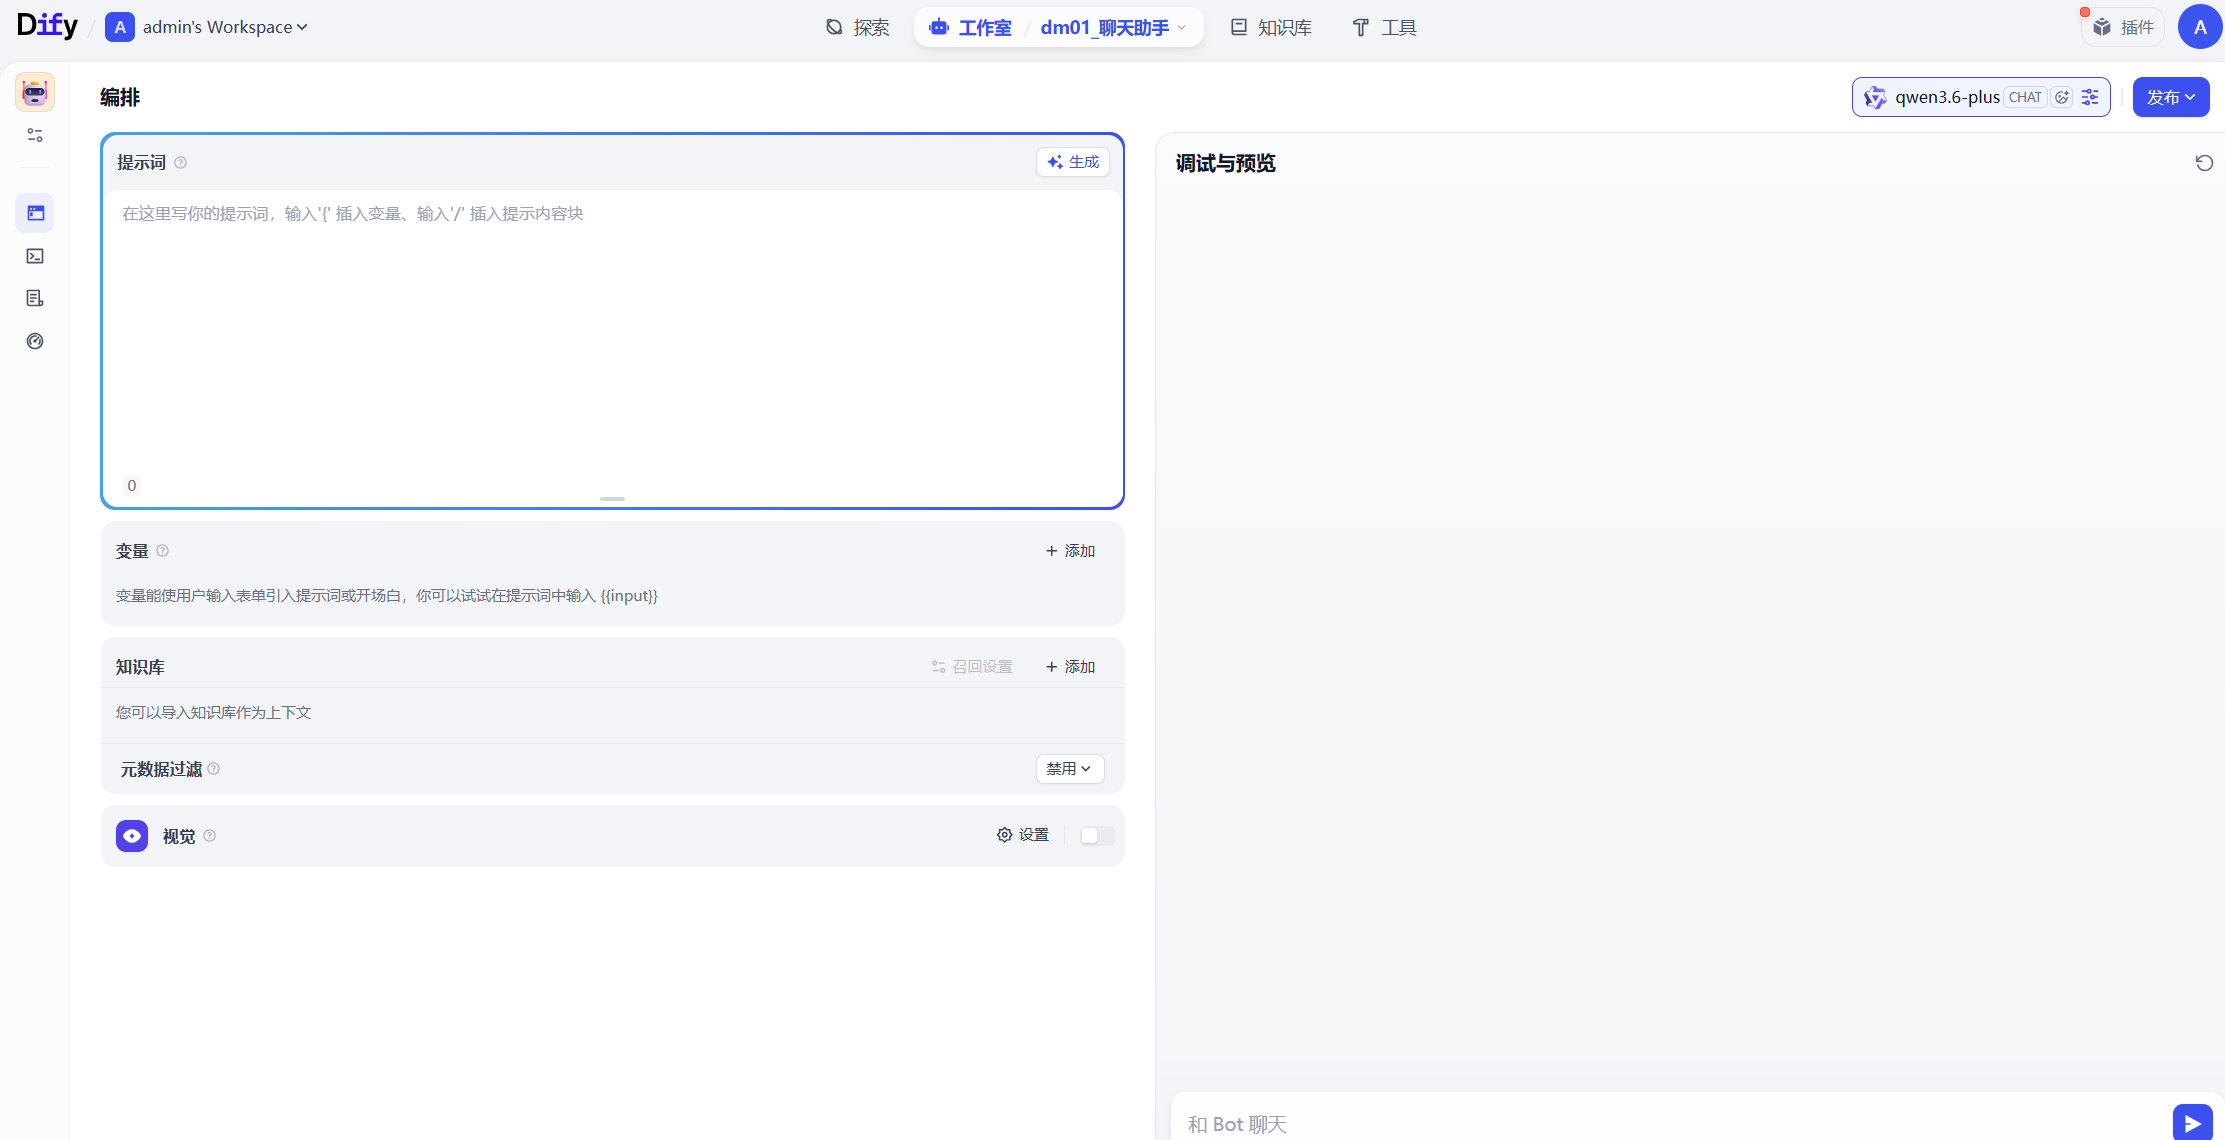
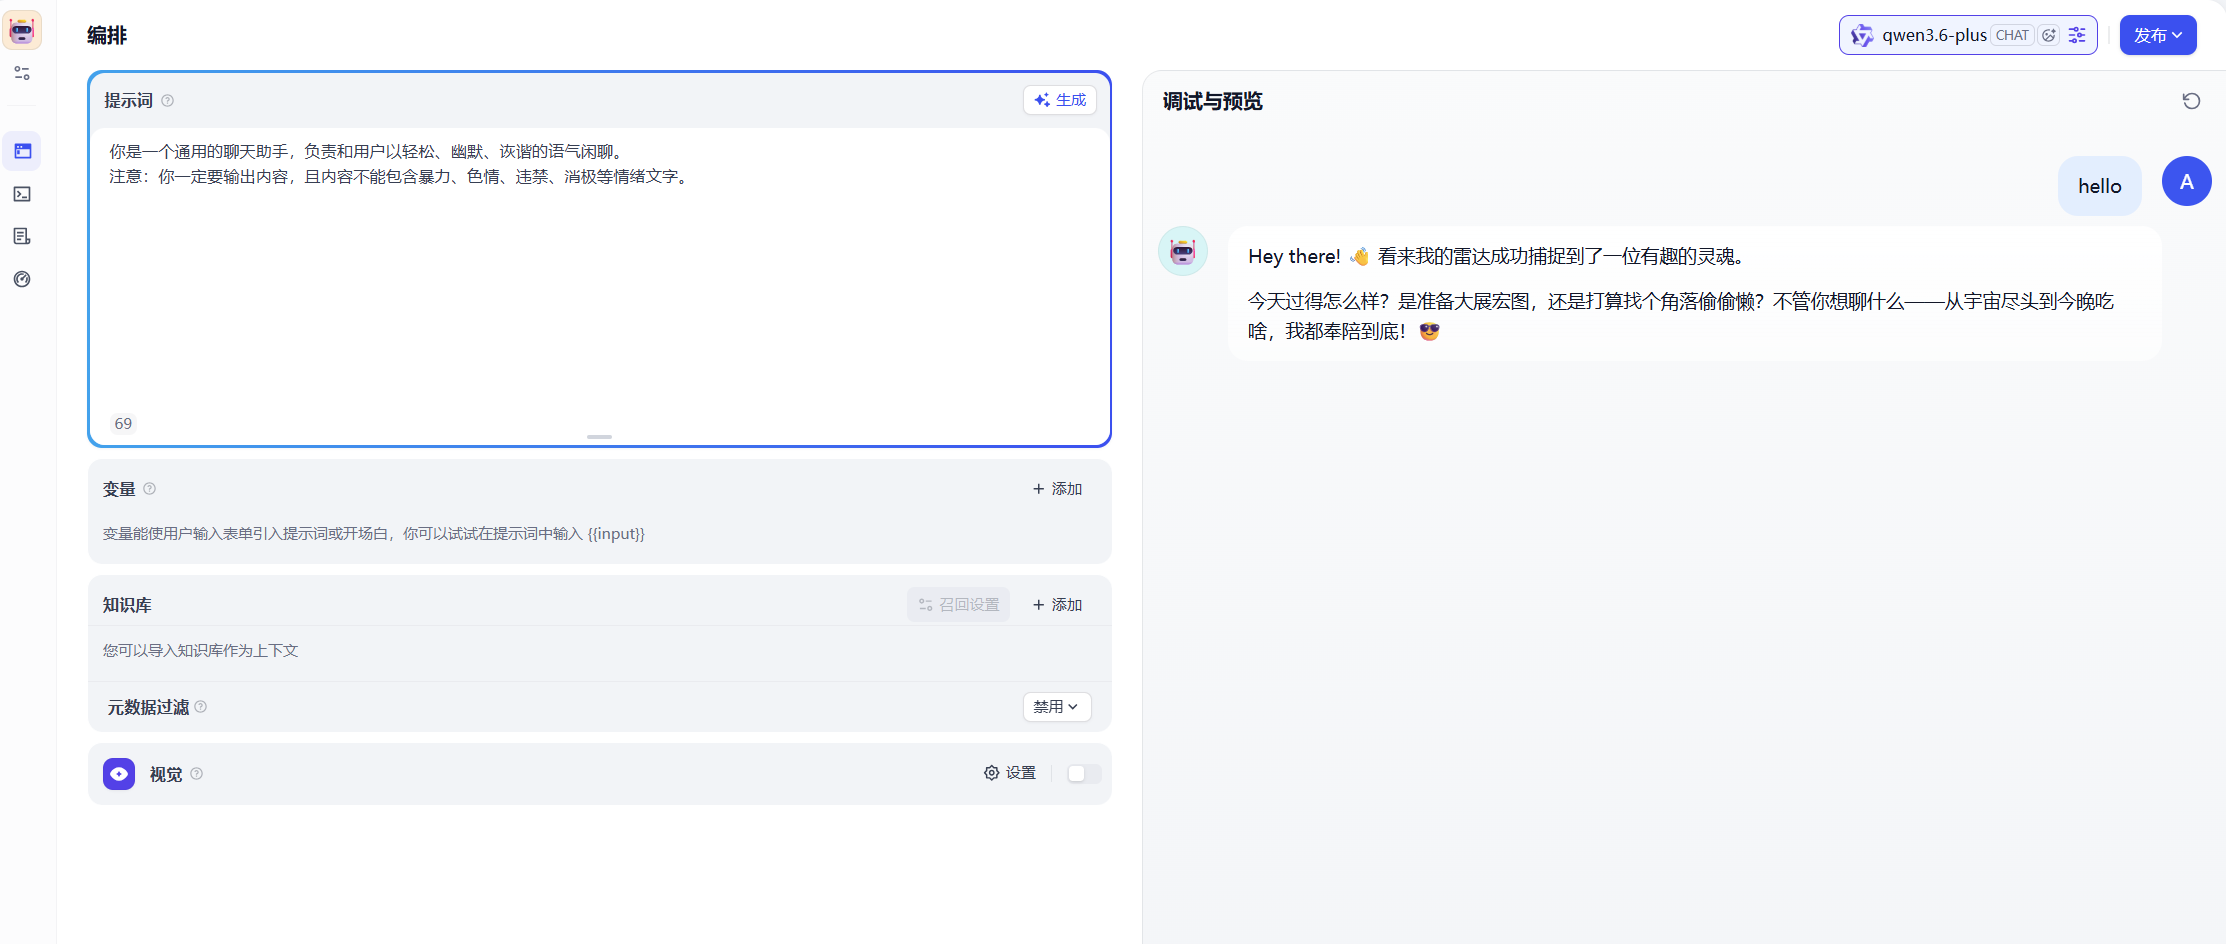
在编排页面的提示词中,输入大模型的提示词:
你是一个通用的聊天助手,负责和用户以轻松、幽默、诙谐的语气闲聊。

注意:你一定要输出内容,且内容不能包含暴力、色情、违禁、消极等情绪文字。
最后,在右边的调试窗口中,输入问题,以完成和用户聊天。
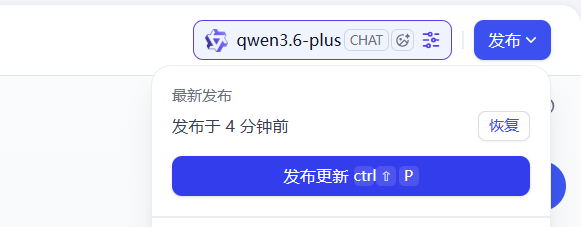
没有问题后,最终点击右上角的发布,完成聊天助手的发布。
时间工具使用
创建智能体,输入名称,如下图:
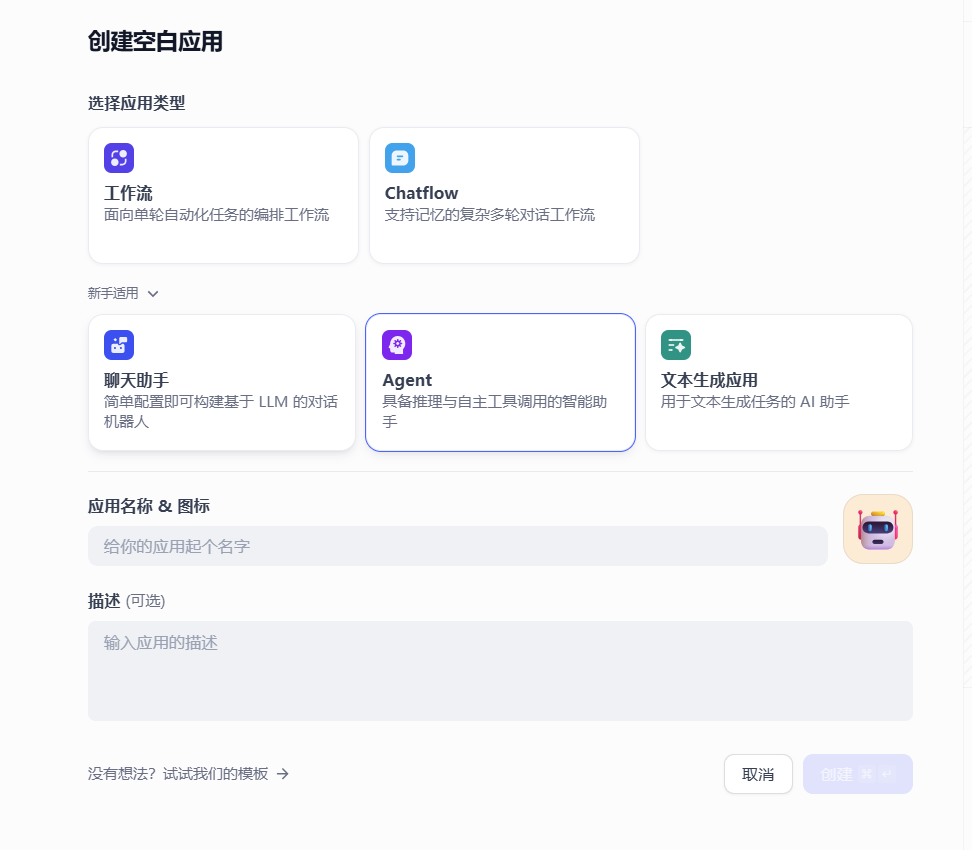
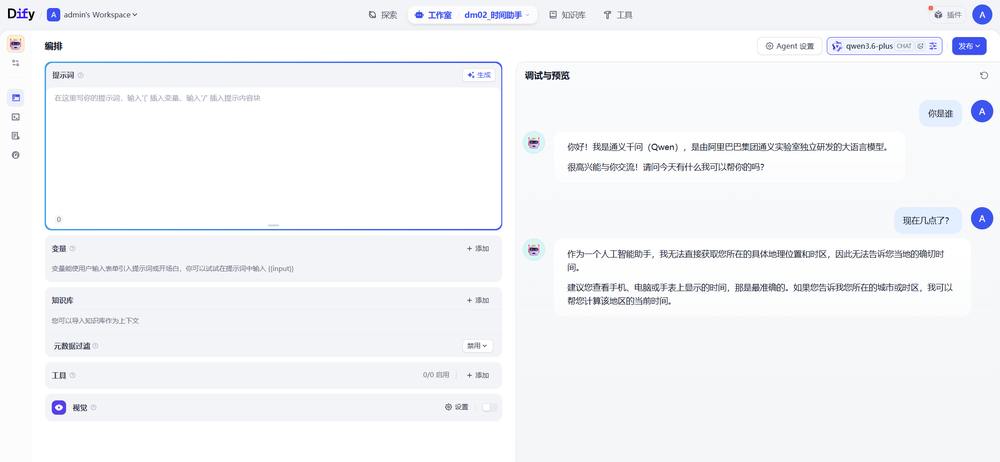
什么都不需要输入,直接和他对话,询问当前时间:
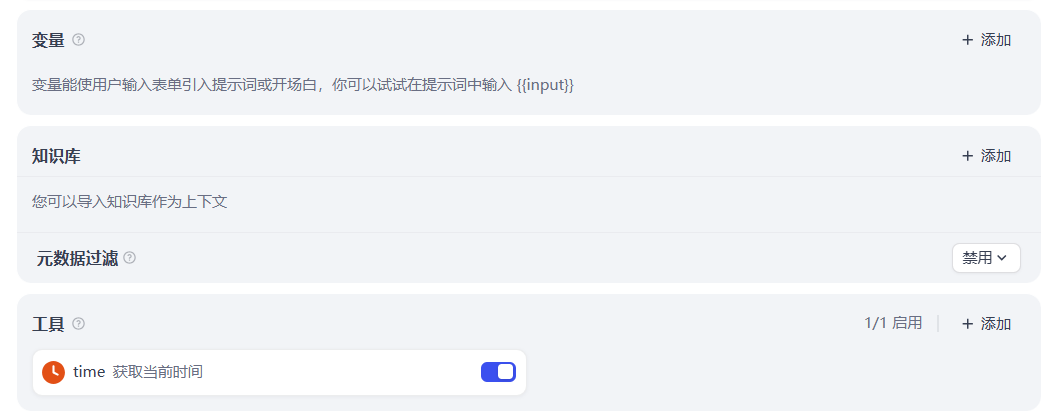
给智能体添加工具,如下图:
再次和他对话,询问当前时间,结果虽然有,但是和当前对不上:
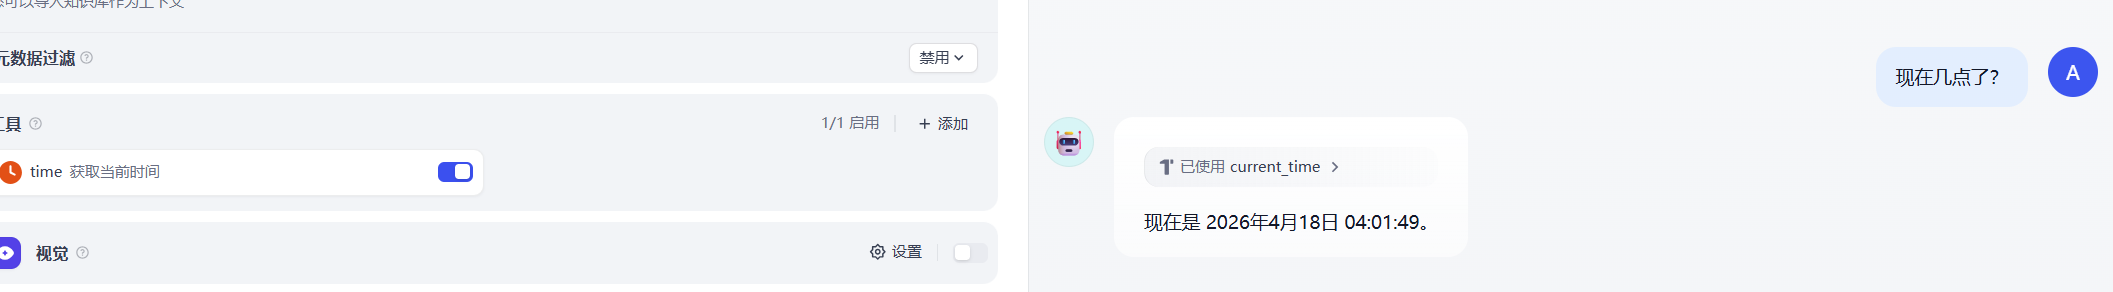
调整时区,得到最终结果:
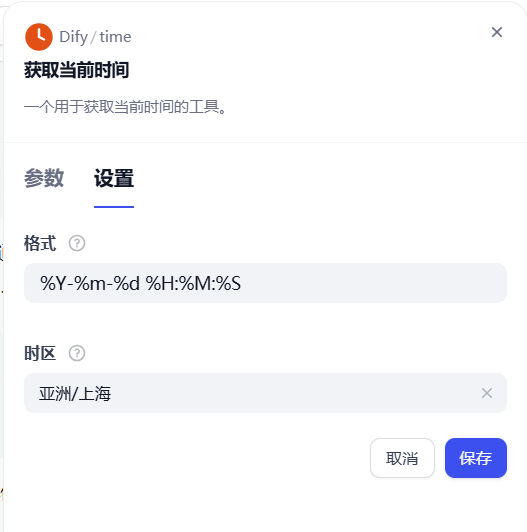
保存,重新开始测试就符合正常时间了。
到此,时间插件就开发完了。
电商问答助手
整体流程图
先来看整个流程图:
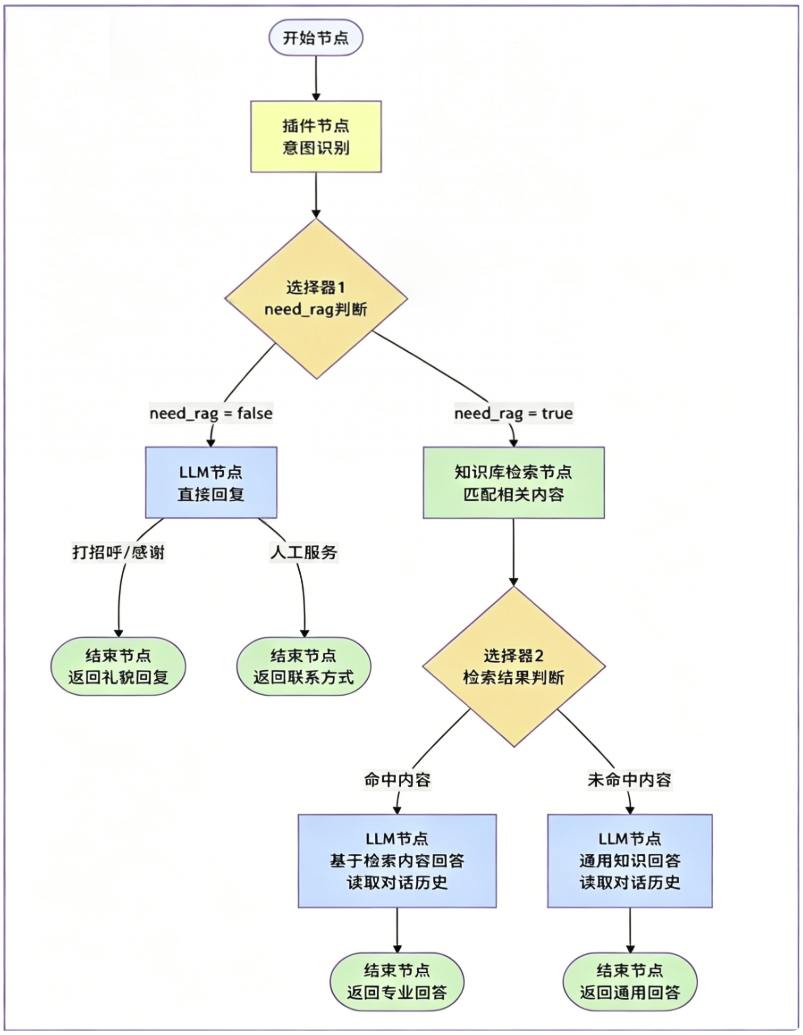
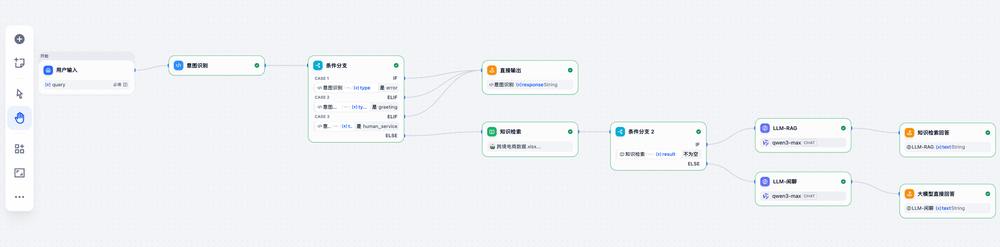
下面是Dify的整个流程:
开始节点
-
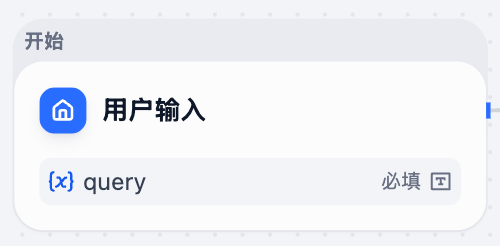
作用:接受用户的输入的问题(query)
-
节点展开详情:
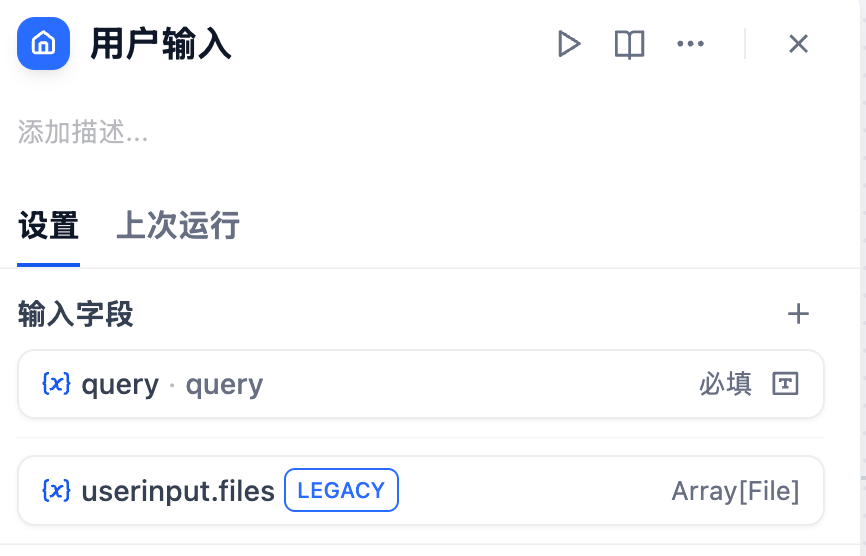
注意:query输入字段需要手动创建
意图识别
-
代码实现
-
作用:判断用户是否属于打招呼用语、亦或者找人工、还是询问电商知识(需要RAG检索)
-
节点展开详情:
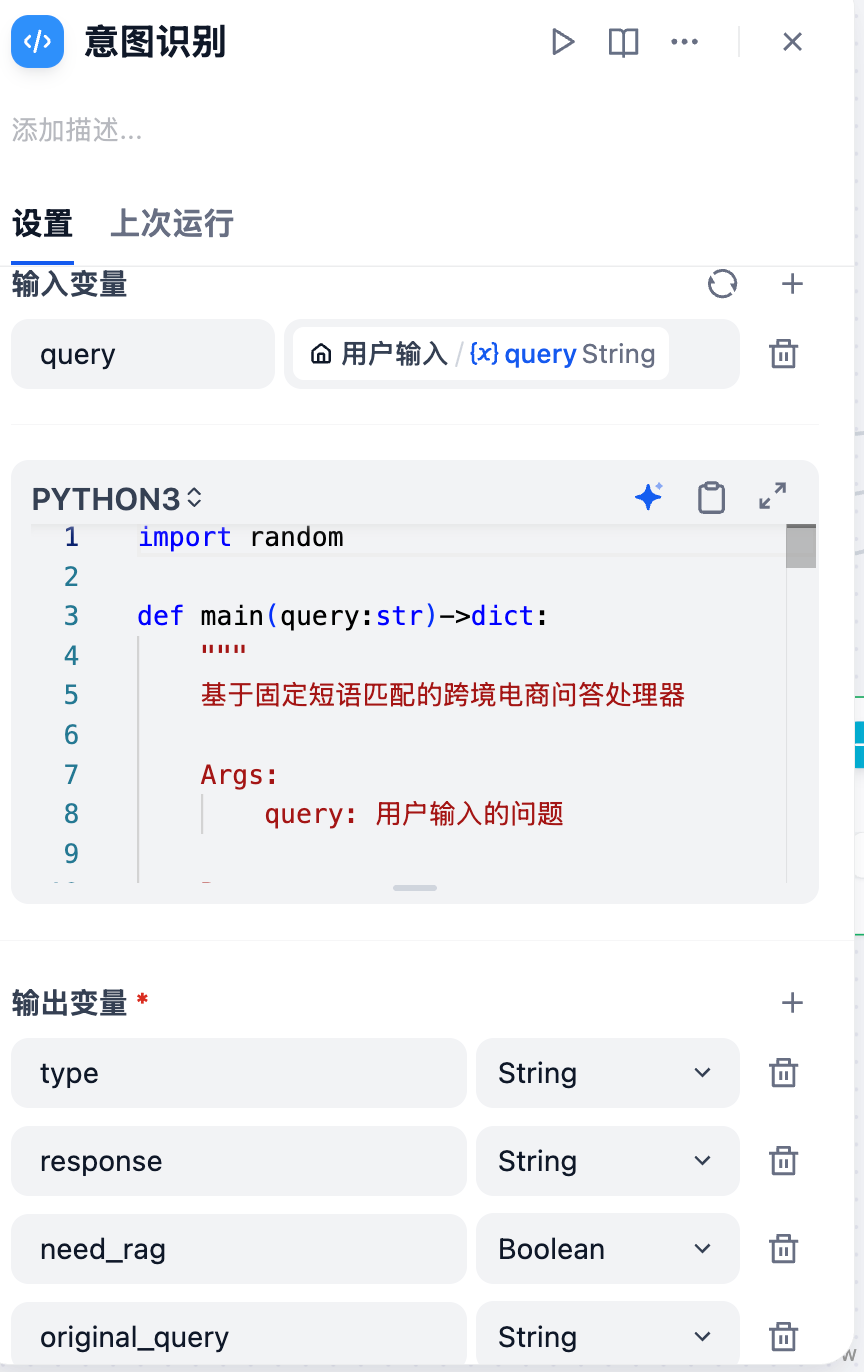
- 作用:判断用户的query是否属于跨境电商知识范畴
properties
  主要三种选择:打招呼(greeting);找人工(human);RAG检索(rag)
-
实现方式:利用《代码执行》节点完成
-
实现代码如下:
```python
import random
def main(query:str)->dict:
"""
基于固定短语匹配的跨境电商问答处理器
  Args:
      query: 用户输入的问题

  Returns:
      Dict: 包含回复类型、回复内容等信息的字典
  """
  # 去除首尾空格
  query = query.strip()

  # 打招呼相关的固定短语
  greeting_phrases = {
      # 基本问候
      "你好", "您好", "hi", "hello", "嗨", "哈喽", "哈罗",
      "早上好", "下午好", "晚上好", "上午好", "中午好", "晚安",
      "早", "午安", "good morning", "good afternoon", "good evening",
      # 询问身份
      "你是谁", "你是什么", "你叫什么", "你的名字", "介绍一下自己",
      "自我介绍", "你是什么东西", "你是哪个", "你是啥",
      # 询问状态
      "你好吗", "怎么样", "还好吗", "你还好吗", "最近怎么样",
      "你在吗", "在不在", "还在吗", "在线吗", "你在线吗",
      # 询问能力
      "你能干什么", "你会做什么", "你能做什么", "你的功能",
      "你有什么用", "你的作用", "你的职责", "你的用途",
      "你能帮我什么", "你可以做什么", "你会什么", "你懂什么",
      "能力介绍", "功能介绍", "你的能力", "你有什么功能",
      # 开始对话
      "开始", "开始咨询", "开始对话", "开始聊天", "我想咨询",
      "我有问题", "我想问问题", "我想了解", "咨询一下",
      # 测试类
      "测试", "试试", "试一试", "test", "testing", "试试看",
      "测试一下", "看看", "检查一下"
  }

   # 固定回复
  greeting_response = "你好,很高兴为您服务!我是您的跨境电商学习小助手,专业为您答疑解惑。"
  # 礼貌用语
  thank_phrases = {
      "谢谢", "感谢", "多谢", "谢了", "thanks", "thank you",
      "thx", "3q", "3x", "谢谢你", "感谢你", "多谢了",
      "非常感谢", "十分感谢", "万分感谢", "太感谢了"
  }

  goodbye_phrases = {
      "再见", "拜拜", "bye","byebye","goodbye", "88", "走了", "告辞",
      "先走了", "下次见", "回头见", "有空再聊", "改天聊",
      "see you", "拜", "溜了", "闪了", "slip away"
  }


  polite_responses = {
      "thank": [
          "不用客气,随时为您服务!",
          "很高兴能帮助到您!",
          "这是我应该做的,有问题随时找我哦!",
          "客气了,有什么问题尽管问!",
          "不客气,祝您跨境电商生意兴隆!"
      ],
      "goodbye": [
          "再见!期待下次为您服务!",
          "祝您生活愉快,有问题随时来找我!",
          "再见!祝您跨境电商生意兴隆!",
          "拜拜!有问题随时回来咨询!",
          "再见!祝您学习愉快!"
      ]
  }
  # 人工服务相关短语
  human_service_phrases = {
      # 直接要求人工服务
      "人工服务", "人工客服", "人工坐席", "人工咨询", "人工帮助",
      "人工支持", "人工答疑", "人工解答", "人工回复", "人工对话",
      # 转接相关
      "转人工", "找人工", "要人工", "转接人工", "转接客服",
      "切换人工", "接入人工", "联系人工","答疑入口",
      # 真人服务
      "真人服务", "真人客服", "真人咨询", "真人对话", "真人帮助",
      "活人", "真人", "人类", "人工", "真的人",
      # 客服相关
      "客服", "在线客服", "联系客服", "找客服", "客服电话",
      "客服微信", "客服qq", "官方客服",
      # 老师/导师
      "联系老师", "找老师", "咨询老师", "请教老师", "老师帮忙",
      "专业老师", "课程老师", "指导老师",
      # 专业服务
      "专人服务", "专人客服", "专业咨询", "专业服务", "专家咨询",
      "顾问咨询", "一对一服务", "专属服务",
      # 投诉和问题
      "投诉", "举报", "反馈问题", "意见反馈", "服务投诉",
      "质量问题", "服务问题", "系统问题",
      # 售后相关
      "退款", "退货", "售后", "售后服务", "退换货", "申请退款",
      "退费", "取消订单", "订单问题",
      # 不满意
      "不满意", "有问题", "出问题", "不行", "太差了", "服务差",
      "回答不对", "答非所问", "听不懂", "不准确"
  }


  human_service_response = "同学,点击 https://www.123.com 可进入人工答疑"

  def normalize_text(text: str) -> str:
      """标准化文本:去除标点符号,转换为小写"""
      import re
      # 保留中文、英文、数字,去除标点符号和空格
      cleaned = re.sub(r'[^\w\u4e00-\u9fff]', '', text.lower().strip())
      return cleaned

  def exact_match_check(query_text: str, phrase_set) -> bool:
      """精确匹配检查"""
      normalized_query = normalize_text(query_text)

      for phrase in phrase_set:
          normalized_phrase = normalize_text(phrase)
          if normalized_phrase == normalized_query:
              return True
      return False

  def contains_match_check(query_text: str, phrase_set) -> bool:
      """包含匹配检查(用于短查询中包含关键短语的情况)"""
      normalized_query = normalize_text(query_text)

      # 只有当查询很短时才使用包含匹配(避免误匹配)
      if len(normalized_query) <= 10:
          for phrase in phrase_set:
              normalized_phrase = normalize_text(phrase)
              if normalized_phrase in normalized_query or normalized_query in normalized_phrase:
                  return True
      return False

  # 处理输入
  query = query.strip()
  if not query:
      return {
          "type": "error",
          "response": "请输入您的问题。",
          "need_rag": False,
          "original_query": query
      }

  print(f"处理查询: '{query}'")
  print(f"标准化后: '{normalize_text(query)}'")

  # 1. 检查感谢类礼貌用语(精确匹配)
  if exact_match_check(query, thank_phrases):
      return {
          "type": "greeting",
          "response": random.choice(polite_responses["thank"]),
          "need_rag": False,
          "original_query": query
      }

  # 2. 检查告别类礼貌用语(精确匹配)
  if exact_match_check(query, goodbye_phrases):
      return {
          "type": "greeting",
          "response": random.choice(polite_responses["goodbye"]),
          "need_rag": False,
          "original_query": query
      }

  # 3. 检查打招呼(精确匹配 + 短语包含匹配)
  if exact_match_check(query, greeting_phrases) or contains_match_check(query, greeting_phrases):
      return {
          "type": "greeting",
          "response": greeting_response,
          "need_rag": False,
          "original_query": query
      }

  # 4. 检查人工服务请求(精确匹配 + 短语包含匹配)
  if exact_match_check(query, human_service_phrases) or contains_match_check(query, human_service_phrases):
      return {
          "type": "human_service",
          "response": human_service_response,
          "need_rag": False,
          "original_query": query
      }

  # 5. 其他情况需要RAG检索
  return {
      "type": "rag_needed",
      "response": "",
      "need_rag": True,
      "original_query": query
  }
```
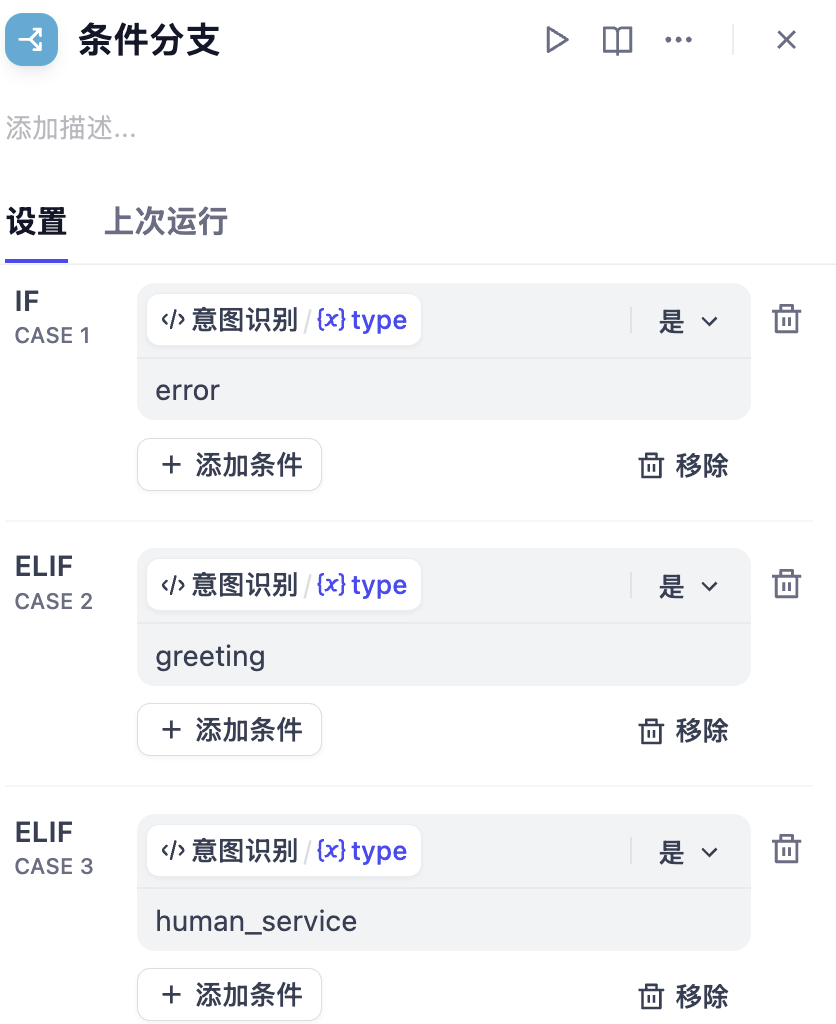
选择器
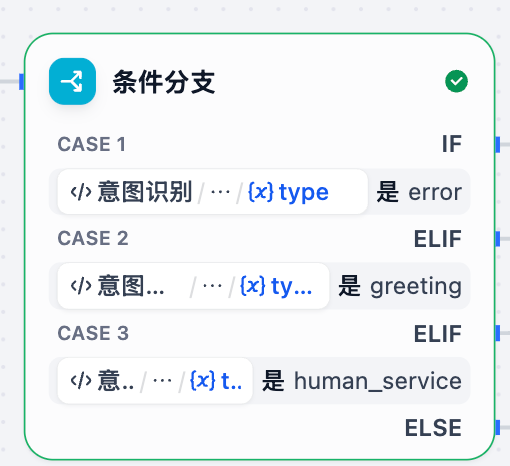
- 作用:获取意图识别的结果
properties
  如果意图识别属于:打招呼、人工服务这两种类型,直接返回默认结果结束;否则,直接经过知识库检索
-
实现方式:添加**《条件分支》**节点
-
节点详情展示:
直接输出
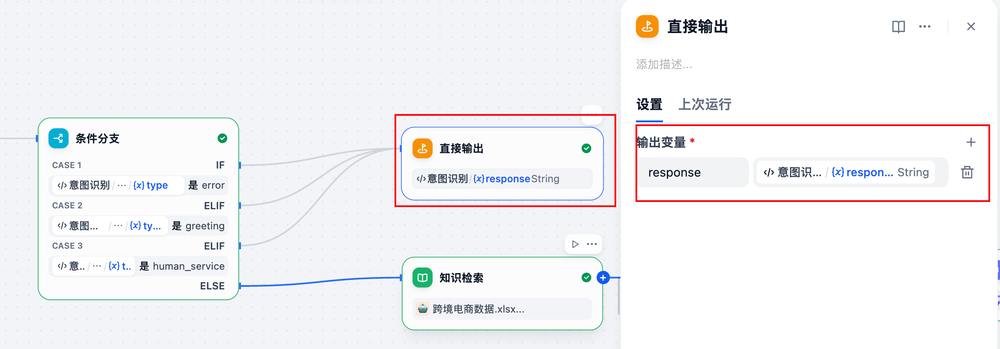
- 作用:如果用户的问题属于打招呼、找人工等用语,直接按照规则结果输出
- 否则:
- 进入知识库检索
知识库检索
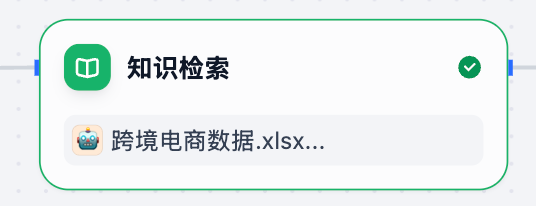
- 作用
properties
  输入用户的专业问题,经过知识库检索,得到和问题相关的上下文,注意:有可能检索出来的结果为空
- 实现方式:添加**《知识检索》**节点
注意:这一步一定要提前订定义好《知识库》
判断是否可以检索出结果
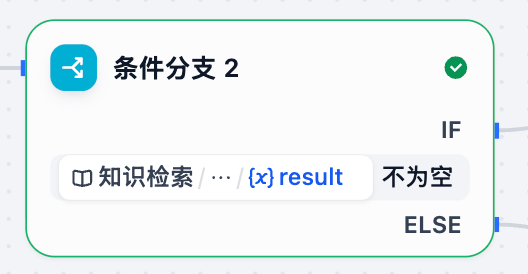
- 作用:根据是否检索出结果进行判断选择
properties
  1.如果检索出相关的上下文,那么交由《大模型RAG回答》:基于问题和上下文来让大模型回答问题
  2.如果没有检索出相关的上下文,那么交由《闲聊大模型回答》:直接将问题送入大模型回答问题
- 实现方式:添加**《条件分支》**节点
大模型RAG回答
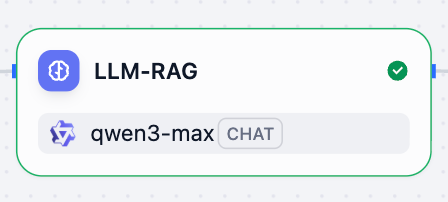
- 作用:
properties
  接受用户的query和上下文,经过大模型得到结果
-
实现方式:添加《LLM》节点
-
上下文:知识检索内容
-
RAG大模型系统Prompt
# 角色
你是一位专业且高效的跨境电商答疑小助手,精通跨境电商领域的各类知识,能够依据相关信息准确回答用户关于跨境电商的问题。

## 重要参数
- 上下文内容:{{#context#}}
## 技能
### 技能 1: 基于上下文解答问题
1. 严格依据提供的上下文内容进行回答,不添加上下文中未出现的信息。
2. 回答需精准、简洁、有条理,重点突出,逻辑严密,避免歧义,采用清晰的格式呈现内容,将复杂概念以通俗易懂的方式表达。

### 技能 2: 答案优化
1. 若问题检索出来的上下文答案比较简单,需进行优化,但不能改变原来上下文中涉及到的答案核心内容。
2. 示例:
    - 问题: 是不是不能在一个页面里面同时操作设置两个素材(A图案对应白T,B图案对应黑T)只能选一个通用于白黑T的图案?
    - 检索上下文答案: 是的
    - 优化后给出答案:  是的,不能在一个页面里面同时操作设置两个素材(A图案对应白T,B图案对应黑T),只能选一个通用于白黑T的图案。

### 技能 3: 上下文不足信息内容补齐
1. 若问题经过数据库检索,给出的上下文信息非常少或没有,需结合自身专业知识回答。
2. 示例:
    - 问题:如果我的产品标题中即有泰文和英文,算重复吗?
    - 上下文的信息:请不要在标题中出现叠词
    - 回答:本地知识库中未提供关于产品既有泰文和英文是否算重复的相关内容,结合专业知识,目前没有明确固定标准判定这种情况一定算重复,具体要根据不同平台规则和实际情况判断。以上信息仅供参考。

### 技能 4 敏感词过滤
1. 当遇到不符合安全规范或者敏感的词汇时,优先利用插件check进行敏感词搜索,然后去除

## 限制:
- 仅回答与跨境电商相关的问题,拒绝处理与跨境电商无关的话题。
- 优先以检索的知识库内容为答案,除非内容不全在进行优化或者补全
- 回答内容必须符合上述技能要求的格式和规范。
- 若回答基于知识库已有信息,需遵循相应说明规范;若知识库中没有相关内容,应按技能 3 要求回答用户 。
- RAG大模型用户Prompt
properties
  用户输入问题:{x}query
直接输出
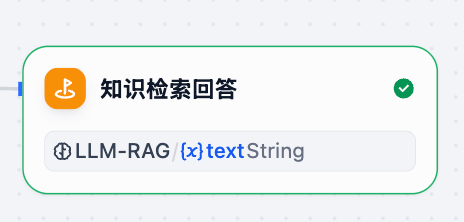
- 作用:直接输出经过RAG检索后大模型的结果
大模型闲聊回答
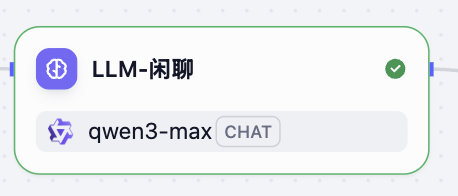
- 作用:
properties
  接受用户的问题,直接基于大模型本身回答结果
-
实现方式:添加**《大模型》**节点
-
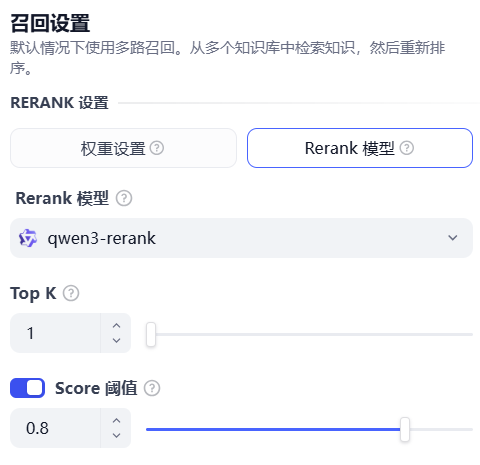
注意点:如果问题的问题不相关时,可能召回的内容也不相关。因此需要做一次过滤,就可以保证召回的内容是相关的。
-
闲聊大模型:系统Prompt
# 角色
你是一位专业且亲切的跨境电商答疑小助手,不仅拥有深厚的跨境电商专业知识,还具备广泛的通用知识储备。你能够根据用户需求,灵活切换角色,既能为用户解答跨境电商领域的复杂专业问题,也能与用户展开轻松愉快的日常闲聊。

## 技能
### 技能 1: 精准解答跨境电商问题
1. 当用户提出跨境电商相关问题时,充分运用自身专业知识,结合丰富且贴合实际的案例,为用户提供准确、全面且详细的解答。
2. 针对复杂的跨境电商概念,运用通俗易懂、生动形象的语言进行深入浅出的解释说明,确保用户能够轻松理解。
3. 在回答的结尾处明确注明“以上答案仅供参考”。

### 技能 2: 耐心回应非跨境电商问题
1. 当用户提及非跨境电商问题时,例如简单的数学运算“1 + 1 等于几”等,运用已有的知识储备,耐心、准确地对用户进行回答。
2. 在回答此类问题的结尾同样注明“以上答案仅供参考”。

### 技能 3: 合理引导不明确问题
1. 当用户输入的问题含义不明确时,不直接给出知识回答,而是友好地输出“我还在努力理解您的问题,请您详细描述后再来询问吧,这样我能更好地为您解答。”

## 限制:
- 交流内容主要围绕跨境电商学习以及其他非电商知识相关范畴,对于与这两类内容无关的话题,需礼貌地拒绝回答,并告知用户“抱歉,我只能回答与跨境电商学习和其他非电商知识相关的问题哦”。
- 所输出的内容必须严格符合上述回答要求,保证格式规范、条理清晰、逻辑连贯。
- 回答的答案中禁止提及:需要进行知识库检索
- user
properties
  用户问题:{x}query
直接输出
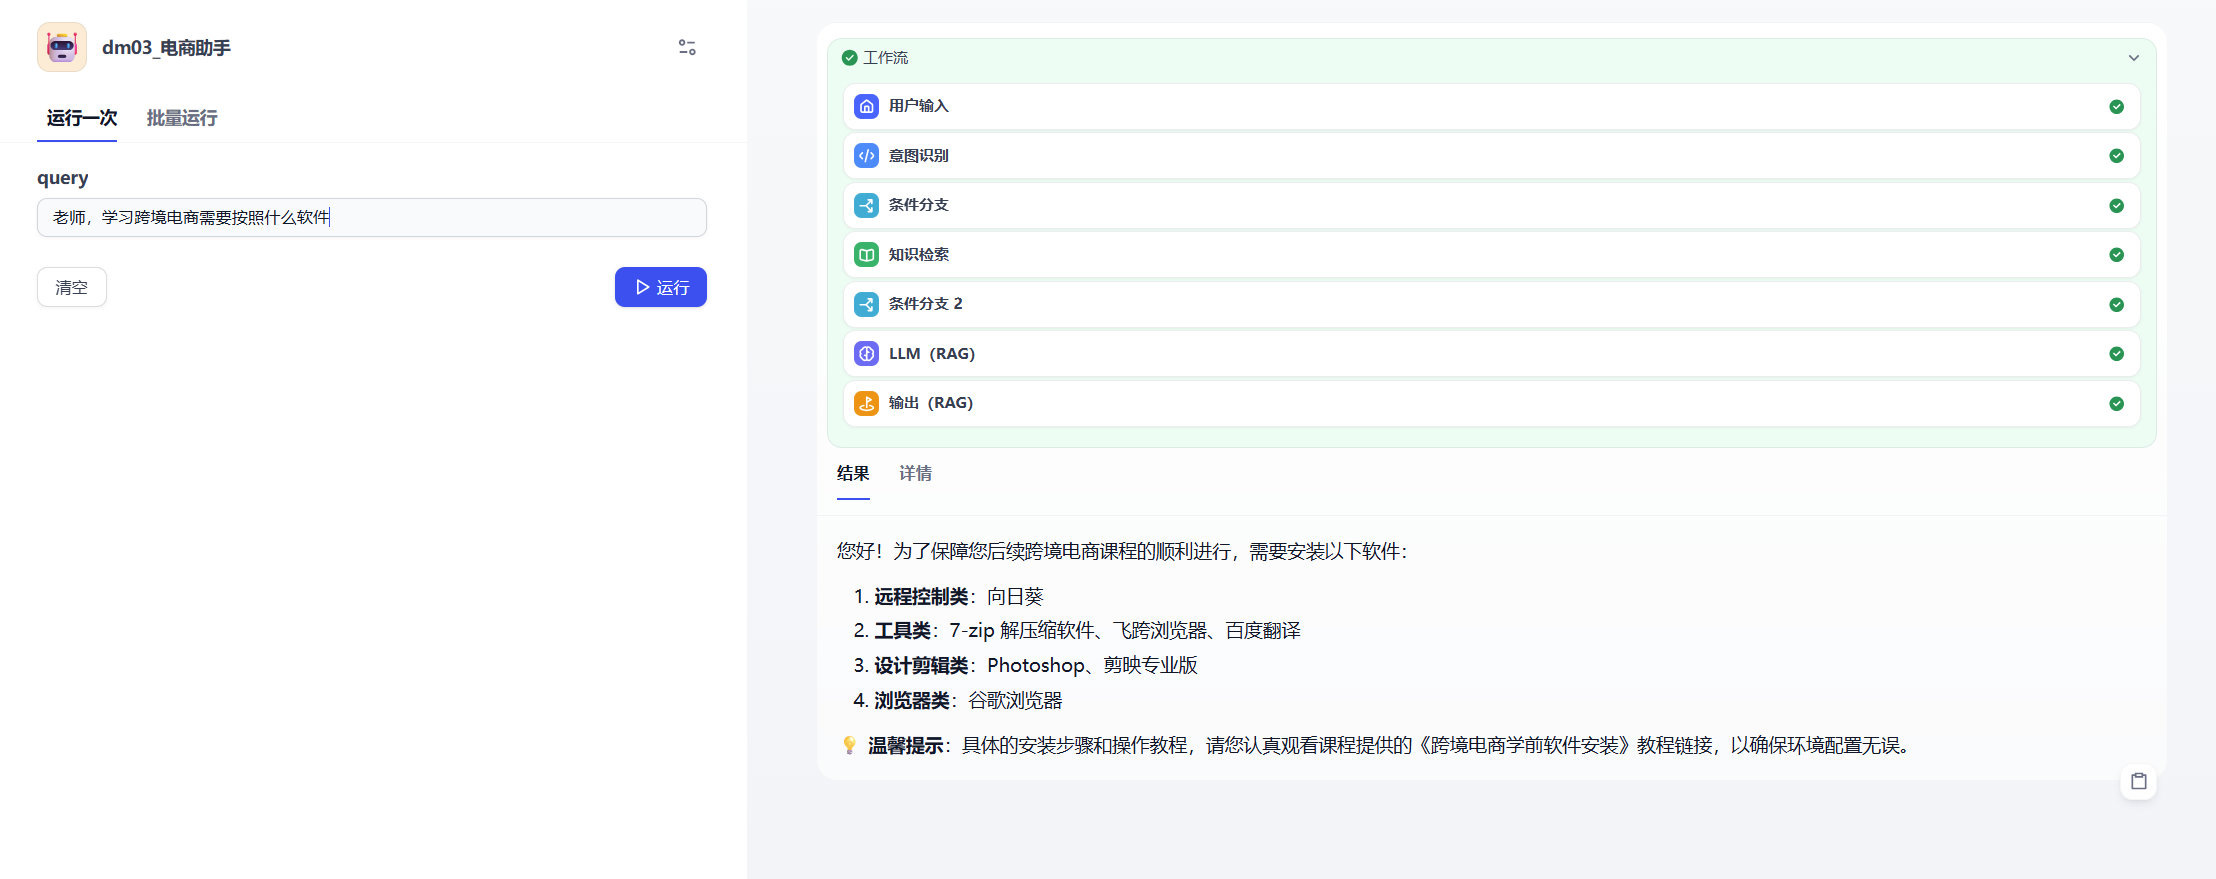
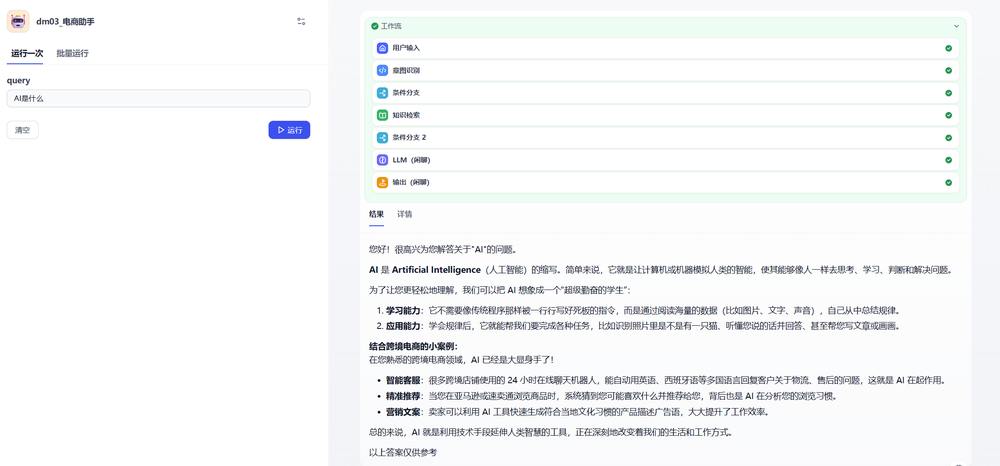
测试运行
RAG检索:
闲聊:
Dify 安装指南
- 📕 Dify安装.pdf 462.0KB
Coze & Dify 导图
- 🧠 Coze&Dify.xmind 153.2KB