第 4 节 / 共 4 节
模型压缩:量化 / 蒸馏 / 剪枝 + 简历
投满分笔记(day05-06)
投满分项目
【了解】今日内容介绍
- 模型压缩
- 模型量化
- 知识蒸馏
- 模型剪枝
【理解】模型压缩
许多实际应用程序都需要实时的设备上处理功能。例如,家庭安全摄像头上的 AI 必须能够处理是否有不明身份的人试图进入房子并通知您。
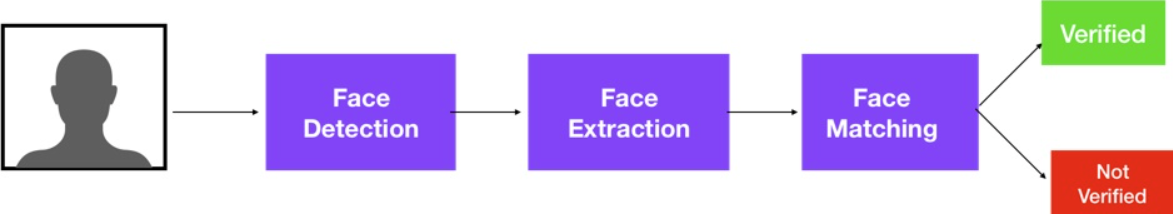
目前最在实际使用大模型时候,表现良好的深度学习模型规模较大。但是,模型越大,需要的存储空间就越多,因此很难在资源受限的设备或者业务场景上进行部署或者使用。同时,更大的模型意味着推理时间更长,推理过程中的能耗更高。
所以如何在保证一些模型性能损耗不大的情况下,使得模型尽可能的小,就是我们要解决的问题。而让模型规模变小,我们称之为模型压缩,所以基于上述背景,如何解决大模型在低资源设备硬件上提升推理效率就是模型压缩意义。
即:通过模型压缩相关技术来减小模型的大小,在一定程度上对模型准确性上产生不了太大的影响。
在本章节中,我们将探讨 3 种流行的模型压缩技术,分别是:
- 模型量化
- 模型蒸馏
- 模型剪枝
【掌握】模型量化
量化简介
量化是一种技术,通过使用低精度数据类型(如 8 位整数 int8)而不是通常的 32 位浮点 (float32)来表示权重和激活,从而降低运行推理的计算和内存成本。减少位数意味着生成的模型需要更少的内存存储,并且使用整数运算可以更快地执行矩阵乘法等运算。它还允许在嵌入式设备或者边缘设备上运行模型,这些设备有时仅支持整数数据类型。
通俗的理解,就是将模型的参数精度进行降低操作,用更少的比特位(torch.qint8)代替较多的比特位(torch.float32),从而缩减模型,并加速推断速度。
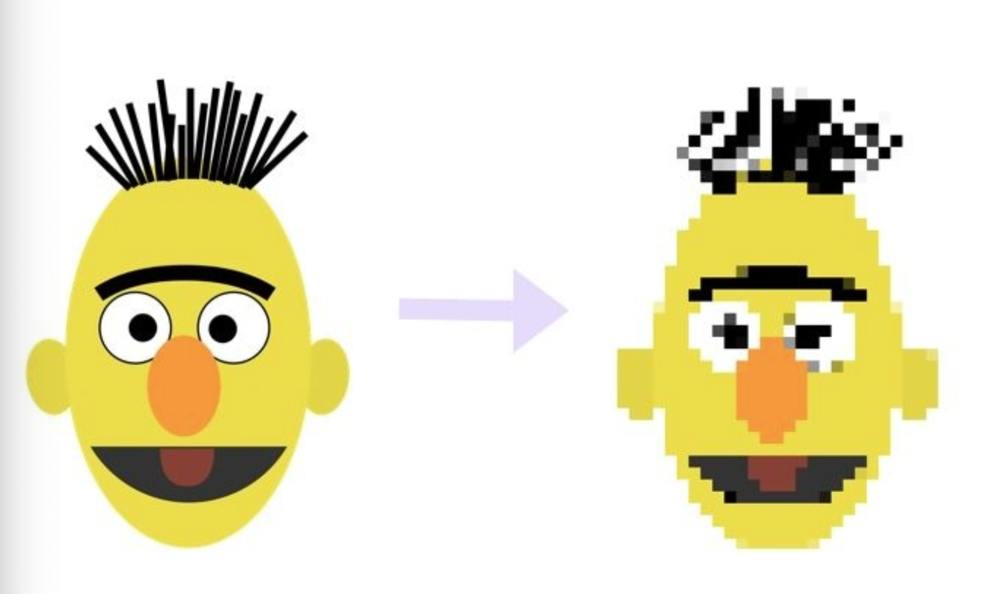
如上图所示,左侧的是原始模型拥有更高的参数精度(float32),等效于像素高,看的清晰;右侧的是量化后的模型,拥有较低的参数精度(int8),等效于像素低, 看的模糊。但依然可以准确的识别图像内容。
最常见的低精度数据类型是:
| 数据类型 (Data Type) | 累积数据类型 (Accumulation Data Type) | 值域 (Range) | 说明 |
|---|---|---|---|
| float16 | float16 | ±6.55×10⁴(约±65504) | 半精度浮点数,占用16位,精度低,范围有限。 |
| bfloat16 | float32 | ±3.39×10³⁸(近似float32范围) | 脑浮点数,16位,指数范围与float32相同,精度较低。 |
| int16 | int32 | -32768 到 32767 | 16位有符号整数,适合整数运算,无小数。 |
| int8 | int32 | -128 到 127 | 8位有符号整数,范围小,适合低精度整数运算。 |
实际部署的时候需要一些模型加速的方法,每种框架除了fp32精度外,都支持了int8的精度,而量化到int8常常可以使我们的模型更小更快,所以在部署端很受欢迎。
量化方式介绍
量化方式有很多,如下图:
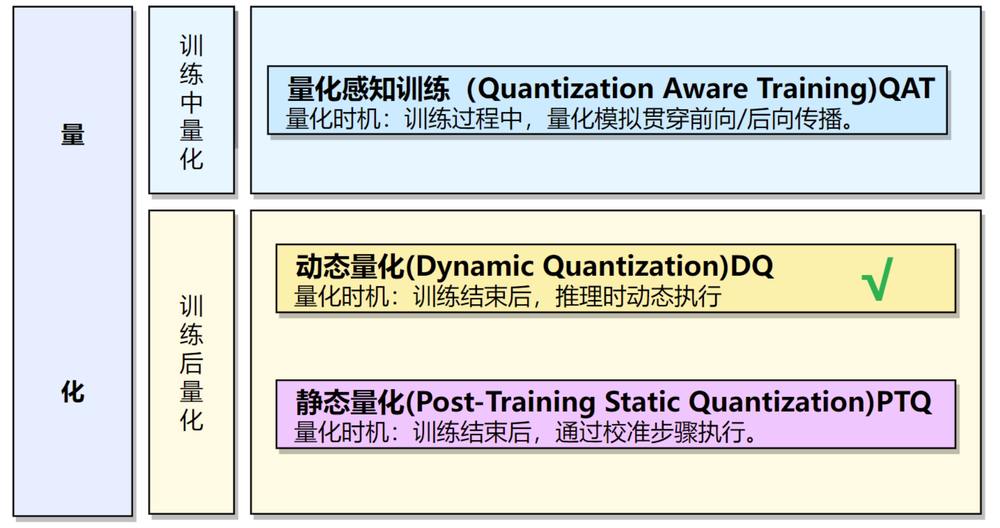
对上述量化简单介绍如下:
| 特性 | 静态量化 | 动态量化 |
|---|---|---|
| API | prepare | quantize_dynamic |
| 适用模型 | CNN(ResNet, MobileNet) | NLP模型(BERT, LSTM)等 |
官网截图如下:
动态量化和静态量化的适用场景:
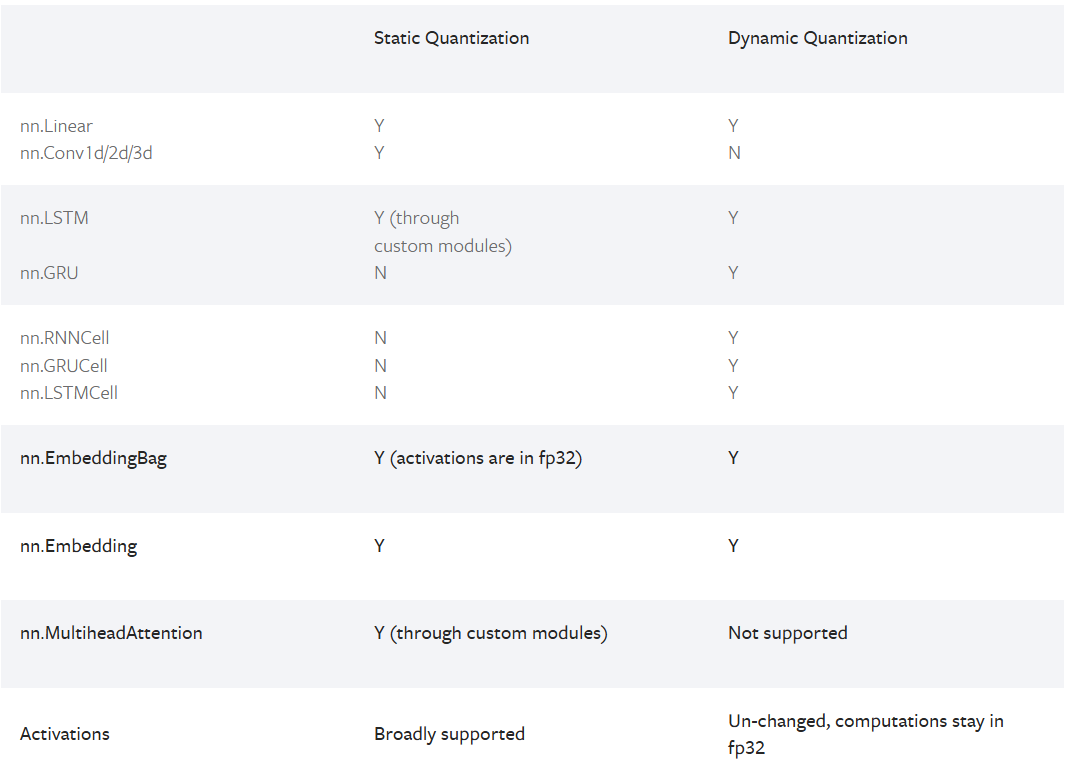
不同的模型类型选择不同的量化方式:
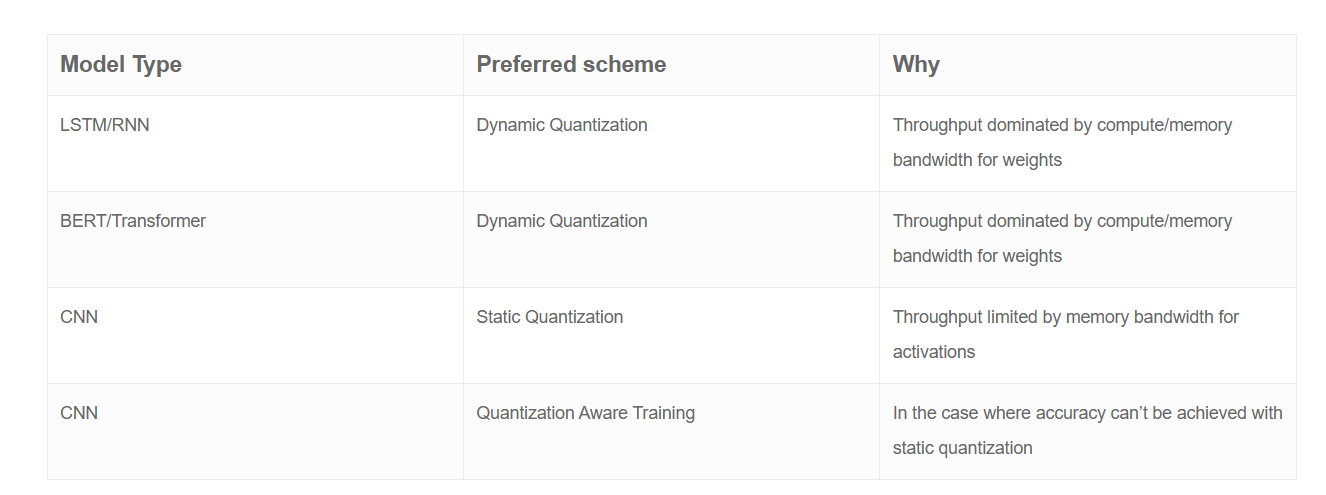
本次直接使用Pytorch的动态量化(Dynamic Quantization),即torch.quantization.quantize_dynamic()来实现量化操作即可。
Tips:PyTorch的动态量化只能在CPU上执行。
代码实现
import torch
import torch.nn as nn


# 定义一个模型
class Model(torch.nn.Module):
    def __init__(self):
        super().__init__()
        self.embedded = nn.Embedding(4, 128)
        self.rnn = nn.GRU(128, 1024, batch_first=True)
        self.linear = nn.Linear(1024, 10)
        self.dropout = nn.Dropout(p=0.1)

    def forward(self, x):
        x, hn = self.rnn(self.embedded(x))
        return self.dropout(self.linear(x))


def test_model():
    # 创建模型实例
    model1 = Model()
    model1.to(device='cpu')
    print("model1-->", model1)
    # 初始化数据
    input = torch.tensor([[1, 3, 2, 0]])
    # 把数据送给模型(未量化)
    result1 = model1(input)
    print("result1-->", result1)
    # 模型保存
    torch.save(model1.state_dict(), './model_without_quantize.pth')

    # 创建量化模型实例
    # model:原始模型
    # qconfig_spec:待量化的层参数
    # dtype:量化权重的目标类型
    model2 = torch.quantization.quantize_dynamic(model=model1,
                                                    qconfig_spec={torch.nn.Linear, nn.GRU},
                                                    dtype=torch.qint8)
    print("model2-->", model2)
    torch.save(model2.state_dict(), './model_with_quantize.pth')
    # 把数据送给模型(已量化)
    result2 = model2(input)
    print("result2-->", result2)


if __name__ == '__main__':
    test_model()
【掌握】知识蒸馏
蒸馏简介
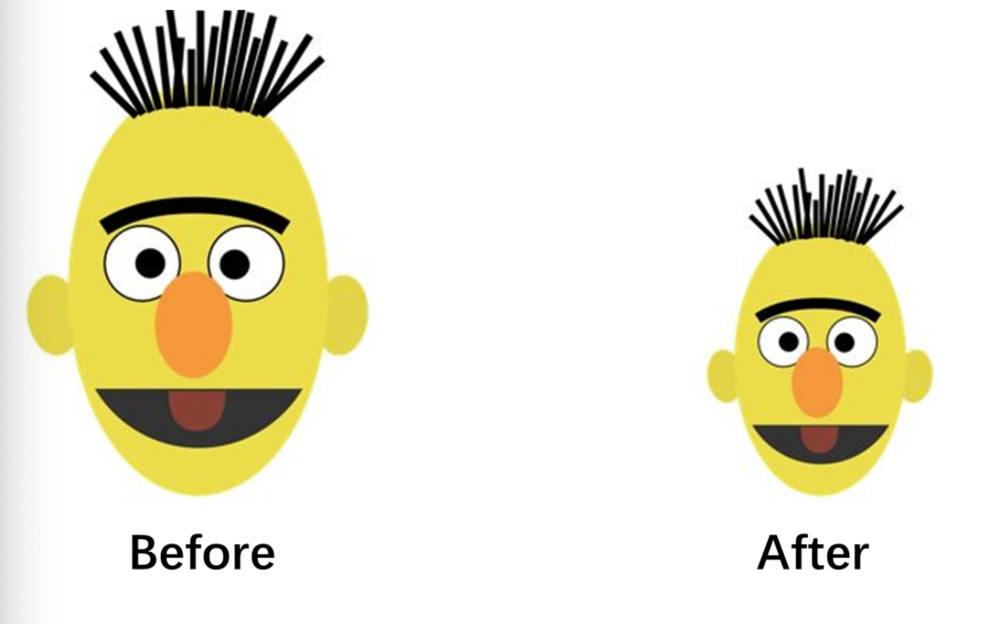
模型蒸馏是一种通过将一个复杂模型(教师模型)的知识转移给一个简单模型(学生模型)的方法,以提高学生模型的性能。在减小模型体积的同时,保持或提升模型性能。
- 知识蒸馏的概念最早由Hinton在2015年提出, 在2019年后火热起来。
- 知识蒸馏在目前已经成为一种既前沿又常用的提高模型泛化能力和部署优势的方法。
蒸馏方式
知识蒸馏方式多样,划分方式也很多,比如:
按照知识类别划分,可以有输出层蒸馏,特征图蒸馏等。
按照蒸馏策略划分,可以有离线蒸馏,在线蒸馏等。
按照任务类别划分,可以有图像分类、目标检测、语音识别等。
这里,我们以知识的来源层次划分为三类,分别是:
-
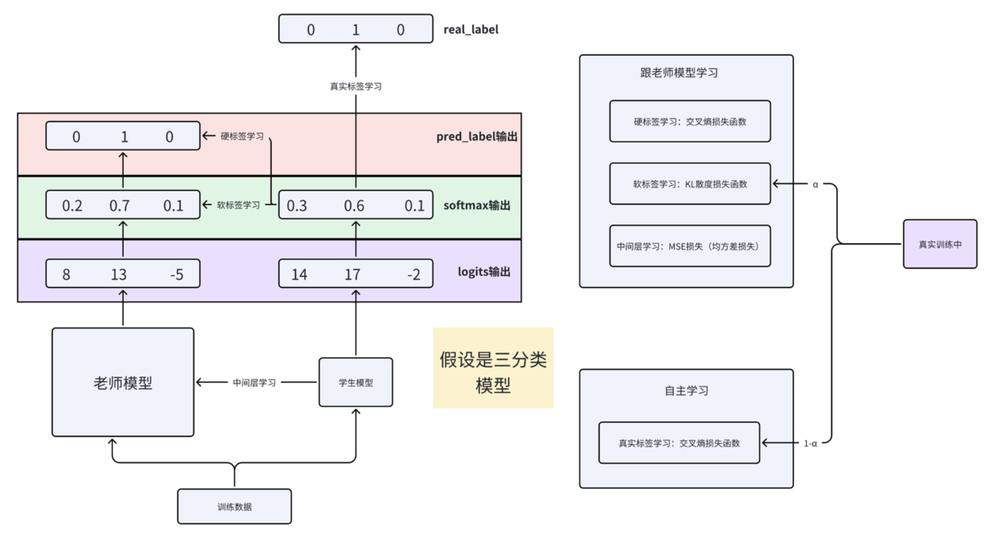
硬标签蒸馏:学生模型直接学习教师模型的分类结果。
-
软标签蒸馏:学生模型学习教师模型对每个类别的概率分布。
-
中间层蒸馏:学生模型学习教师模型的隐藏层、特征图等。
题目:
深度学习中的“深度”是指_________。
A.计算机理解的深度
B.中间神经元网络的层次很多
C.计算机对问题的处理更加灵活
D.计算机的求解更加精准
答案
B解析
在深度学习中,“深度”一词特指神经网络的结构特征。具体分析如下: A. 计算机理解的深度:深度学习是机器学习的分支,计算机本身不具备“理解”能力,这一描述不是特别准确。 B. 中间神经元网络的层次很多:深度学习中的“深度”直接指神经网络的层数较多(如深度神经网络DNN),层次结构复杂,与题意贴合。 C. 计算机对问题的处理更加灵活:灵活性是深度网络的优点之一,但并非“深度”本身的定义,隐藏描述的不太对。 D. 计算机的求解更加精准:精准性可能得益于深度结构,但同样不代表“深度”的含义,优点文不对题。 因此,B选项的说法最贴合题意,直接对应神经网络层次多的本质特征。蒸馏原理
蒸馏的核心是有两个模型,一个教师模型,一个是学生模型。
教师模型
- 定义:复杂的、高性能的模型,通常是大型深度神经网络。
- 特点:参数量大,能够学习复杂的特征和关系。
- 需要提前训练好。
学生模型
- 定义:简化的、小型的模型,可以是教师模型的子集或者简单模型。
- 特点:参数量较小,适用于资源受限的场景。
- 不需要提前训练好。
蒸馏过程
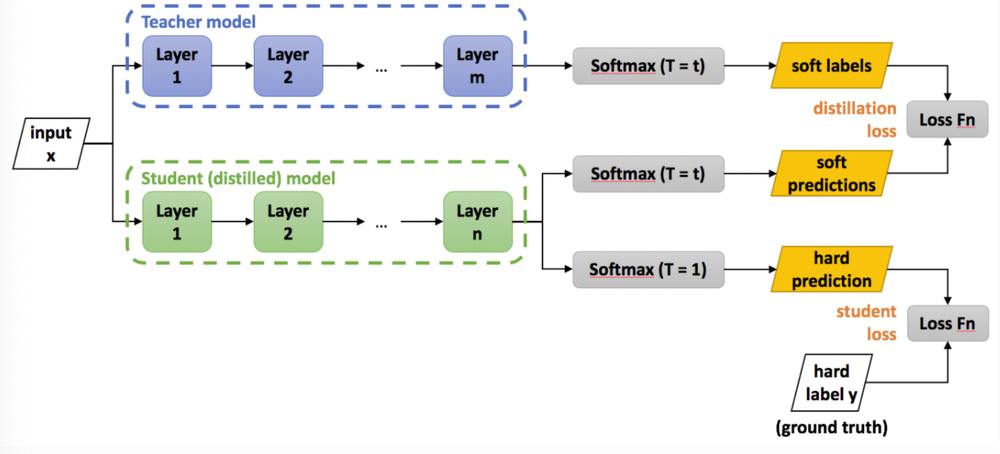
下图非常直观, 又经典的展示了知识蒸馏的架构图, 相当于有两部分的分支:
- 一部分是大模型的softmax分布作为"知识标签",让小模型去学习。
- 一部分是真实label(ground truth)作为"真实标签",让小模型去匹配。
如下图所示:
我们对知识蒸馏进行公式化处理:
先训练好一个精度较高的Teacher网络(一般是复杂度较高的大规模预训练模型),然后将Teacher网络的预测结果q作为Student网络的"学习目标",来训练Student网络(一般是速度较快的小规模模型)最终使得Student网络的结果p接近于q。
总损失函数如下:
$$
L_{kd} = (1−α) · L_{hard} + α · L{soft}
$$
其中,hard:学生与真实输出的差异(硬标签损失,交叉熵损失)soft:学生与教师输出的差异(软标签损失,KL散度)。
所以,这个公式也可以写成如下的公式:
$$
L_{KD} = (1 - α)CE(y,p) + αKL(q,p)
$$
其中,CE是交叉熵(Cross Entropy),y是真实标签,q是Teacher网络的输出结果,p是Student网络的输出结果。
KL是蒸馏损失,即衡量学生模型和教师模型的输出差异。
原始论文中关于KL散度,提出了softmax-T公式来计算上图中的q:
$$
p_i = \frac{exp(\frac{z_i}{T})}{\sum{exp(\frac{z_i}{T})}}
$$
上式中p$\(_i\)\(是Student网络学习的对象,也就是所谓的软目标(soft targets),z\)\(_i\)$是神经网络softmax前的输出logits。
不同的温度系数T值,对softmax-T算法有不同的影响。总结如下:
- 如果将T值取1,softmax-T公式就成为softmax公式,根据logits输出各个类别的概率。
- 如果T越接近于0,则最大值会越接近1,其他值会接近0,类似于退化成one-hot编码。
- 如果T越大,则输出的结果分布越平缓,相当于标签平滑的原理,起到保留相似信息的作用。
- 如果T趋于无穷大,则演变成均匀分布。
超参数说明
-
参数α:系数,控制从学生模型和教师模型学习的比例,比如α=0.8。
-
参数T:蒸馏温度,是一个平滑系数,控制softmax的输出,比如T=4。
KL散度
数学上公式如下:
$$
D_{KL}(P || Q) = \sum{P(x) \log \frac{P(x)}{Q(x)}}
$$
其中,P(x):真实分布。Q(x):预测分布。
计算举例
假设我们有一个真实的概率分布P(你要的目标)和一个模型概率分布Q(模型给出的预测):
| 分类 (x) | 真实概率 P(x) | 模型概率 Q(x) |
|---|---|---|
| A | 0.7 | 0.5 |
| B | 0.2 | 0.3 |
| C | 0.1 | 0.2 |
我们来计算 KL散度,这里我们使用自然对数。
- 对每个事件计算 P(x) * ln(P(x) / Q(x))
- A:
0.7 * ln(0.7 / 0.5) = 0.7 * ln(1.4) ≈ 0.7 * 0.3365 ≈ 0.2355 - B:
0.2 * ln(0.2 / 0.3) = 0.2 * ln(0.6667) ≈ 0.2 * (-0.4055) ≈ -0.0811 -
C:
0.1 * ln(0.1 / 0.2) = 0.1 * ln(0.5) ≈ 0.1 * (-0.6931) ≈ -0.0693 -
将所有事件的结果求和
KL ≈ 0.2355 + (-0.0811) + (-0.0693) ≈ 0.0851
这个结果 0.0851 就是P和Q之间的KL散度。它大于0,说明Q分布和P分布有差异。
代码测试
KL散度:衡量概率分布差异的指标。在这里指的是衡量教师模型和学生模型概率分布差异。
import torch
import torch.nn as nn


def dm01():
    # 真实分布
    P = torch.tensor([[0.7, 0.2, 0.1]], dtype=torch.float)
    # 模型分布
    Q = torch.tensor([[0.5, 0.3, 0.2]], dtype=torch.float)
    # 定义KL散度损失,则聚合方式应该是sum求和
    criterion = nn.KLDivLoss(reduction='sum')
    # 注意:如果希望手算和PyTorch的结果对应上
    # # 则input应该是:【log(Q),target是P】,即:【预测值,真实值】
    kl_loss_class = criterion(torch.log(Q), P)
    print("kl_loss_class-->", kl_loss_class)


def dm02():
    # 创建KL散度对象,reduction=batchmean是PyTorch推荐使用方式,一般也使用这种方式
    kl_loss = nn.KLDivLoss(reduction='batchmean')

    # 学生模型需要是log_softmax,教室模型需要softmax
    input_log_probs = torch.log_softmax(torch.tensor([[0.7, 0.2, 0.1]]), dim=1)
    target_probs = torch.softmax(torch.tensor([[0.5, 0.3, 0.2]]), dim=1)

    loss = kl_loss(input_log_probs, target_probs)
    print("loss-->", loss)


def dm03():
    # 创建KL散度对象,reduction=batchmean是推荐使用方式
    kl_loss = nn.KLDivLoss(reduction='batchmean')

    # 学生模型需要是log_softmax,教室模型需要softmax
    # 定义温度T,经验值:2或者4,这里我们依次试验【0.5, 1, 2, 4, 10, 100】
    T = 1
    input_log_probs = torch.log_softmax(torch.tensor([[0.7, 0.2, 0.1]]) / T, dim=1)
    target_probs = torch.softmax(torch.tensor([[0.6, 0.3, 0.1]]) / T, dim=1)
    loss = kl_loss(input_log_probs, target_probs)
    print("loss-->", loss)


if __name__ == '__main__':
    dm01()
    # dm02()
    # dm03()
一句话总结,模型蒸馏(Model Distillation)是一种将大型教师模型(Teacher Model)的知识迁移到小型学生模型(Student Model)的技术。其核心思想是通过软目标(Soft Targets)传递教师模型的概率分布信息,而非仅依赖硬标签(Hard Labels)。在PyTorch中,这种知识迁移通常通过计算教师模型和学生模型输出之间的KL散度损失实现。
代码实现
教师模型
首先,准备教师模型,也就是参数量比较大的模型,比如BERT等。
import torch
import torch.nn as nn
from transformers import BertModel
from config import Config

conf = Config()


class BertClassifier(nn.Module):
    def __init__(self):
        super(BertClassifier, self).__init__()
        self.bert = BertModel.from_pretrained(conf.bert_path)
        self.fc = nn.Linear(conf.bert_config.hidden_size, conf.num_classes)

    def forward(self, input_ids, attention_mask):
        with torch.no_grad():
            outputs = self.bert(
                input_ids=input_ids,
                attention_mask=attention_mask
            )
        logits = self.fc(outputs[1])
        return logits


# 测试以上模型
def test_bert_model():
    # 加载模型
    model = BertClassifier()
    # 示例文本
    texts = ["我喜欢你", "今天天气真好"]
    from transformers import BertTokenizer

    tokenizer = BertTokenizer.from_pretrained(conf.bert_path)
    # 编码文本
    encoded_inputs = tokenizer(texts,
                               padding="max_length",
                               max_length=10,
                               return_tensors="pt")

    # 获取 input_ids 和 attention_mask
    input_ids = encoded_inputs["input_ids"]
    attention_mask = encoded_inputs["attention_mask"]
    print('input_ids-->', input_ids)
    print('attention_mask-->', attention_mask)
    logits = model(input_ids, attention_mask)
    print('logits-->', logits)


if __name__ == '__main__':
    test_bert_model()
学生模型
其次,准备学生模型。学生模型一般是小的模型,也就是参数量比较小,比如LSTM等。
import torch
import torch.nn as nn
from config import Config
from transformers import BertTokenizer

conf = Config()


class BiLSTMModel(nn.Module):
    def __init__(self):
        # 调用父类初始化方法
        super().__init__()
        # 定义embedding
        self.embedding = nn.Embedding(conf.bert_config.vocab_size, conf.embed_size)
        # 定义lstm
        self.lstm = nn.LSTM(conf.embed_size, conf.hidden_size_lstm, conf.num_layers, bidirectional=True, batch_first=True)
        # 定义dropout
        self.dropout = nn.Dropout(conf.dropout)
        # 定义全连接层
        self.fc = nn.Linear(conf.hidden_size_lstm * 2, conf.num_classes)

    def forward(self, input_ids, attention_mask):
        """
        :param input_ids: 维度:[batch_size, seq_len]
        :param attention_mask: 维度:[batch_size, seq_len]
        :return:
        """
        # Embedding 层,获取ebedding词向量
        # [batch_size, seq_len, embed_size]
        embed = self.embedding(input_ids)
        print("embed-->", embed, embed.shape)
        # 经过valid mask输出对应有效字符的embedding
        # 创建掩码,过滤 [CLS] (101) 和 [SEP] (102)
        cls_token_id = 101  # 动态获取 token ID
        sep_token_id = 102

        print("input_ids-->", input_ids, input_ids.shape)
        print("attention_mask-->", attention_mask, attention_mask.shape)
        print("input_ids != cls_token_id-->", input_ids != cls_token_id)
        print("input_ids != sep_token_id-->", input_ids != sep_token_id)
        # 把101和102都置为False: tensor([False,  True,  True... ,False])
        cls_sep_mask = (input_ids != cls_token_id) & (input_ids != sep_token_id)
        print("cls_sep_mask-->", cls_sep_mask)
        # [batch_size, seq_len]
        valid_mask = attention_mask & cls_sep_mask
        print("valid_mask-->", valid_mask, valid_mask.shape)
        # [batch_size, seq_len, 1]
        valid_mask_embed = valid_mask.unsqueeze(-1)
        print("valid_mask_embed-->", valid_mask_embed)
        # 无效 token 的嵌入置为 0
        embed = embed * valid_mask_embed
        print("embed-->", embed, embed.shape)

        # 经过BiLSTM 层 前向传播
        # [batch_size, seq_len, hidden_size*2]
        lstm_out, (hn, cn) = self.lstm(embed)
        print("lstm_out-->", lstm_out, lstm_out.shape)

        # 对整个句子有效字符(token数)进行平均。先求和,再除以token的数量
        valid_mask_out = valid_mask.unsqueeze(-1)
        print("valid_mask_out-->", valid_mask_out)
        # [batch_size, seq_len, hidden_size*2]
        valid_lstm_out = lstm_out * valid_mask_out
        print("valid_lstm_out-->", valid_lstm_out, valid_lstm_out.shape)
        # 求和
        # [batch_size, hidden_size*2]
        sum_hidden = valid_lstm_out.sum(dim=1)
        print("sum_hidden-->", sum_hidden, sum_hidden.shape)
        # 有效 token 的数量,避免除以 0(加上一个极小值)
        # [batch_size, 1]
        valid_token_count = valid_mask_out.sum(dim=1) + 1e-8
        print("valid_token_count-->", valid_token_count, valid_token_count.shape)
        # 平均池化
        # [batch_size, hidden_size*2]
        hidden = sum_hidden / valid_token_count
        print("hidden-->", hidden, hidden.shape)

        # Dropout 和全连接层
        hidden = self.dropout(hidden)
        # [batch_size, num_classes]
        logits = self.fc(hidden)

        return logits


# 进行模型测试
def test_bilstm_model():
    # 编写测试数据
    model = BiLSTMModel()
    # 示例文本
    texts = ["我中意你", "你爱他"]

    tokenizer = BertTokenizer.from_pretrained(conf.bert_path)
    # 编码文本
    encoded_inputs = tokenizer(texts,
                               padding="max_length",
                               max_length=8,
                               return_tensors="pt")

    # 获取 input_ids 和 attention_mask
    input_ids = encoded_inputs["input_ids"]
    attention_mask = encoded_inputs["attention_mask"]

    # 预测
    logits = model(input_ids, attention_mask)
    print('logits-->', logits)  # 每一行对应一个样本,每个数字表示该样本属于某一类别的“得分”(logit),没有经过 softmax 归一化。

    # 获取预测概率
    probs = torch.softmax(logits, dim=-1)
    print('probs-->', probs)  # 归一化后该样本属于某类的概率(范围在 0~1 之间),概率最高的就是预测结果

    # 获取最大元素对应的索引(类别)
    preds = torch.argmax(logits, dim=-1)
    print('preds-->', preds)  # 得到每个样本的预测类别。表示两个输入文本被模型预测为类别 6(从 0 开始计数)。


if __name__ == '__main__':
    test_bilstm_model()
知识蒸馏
最后,让学生模型学习教师模型的概率分布,即:软标签蒸馏。
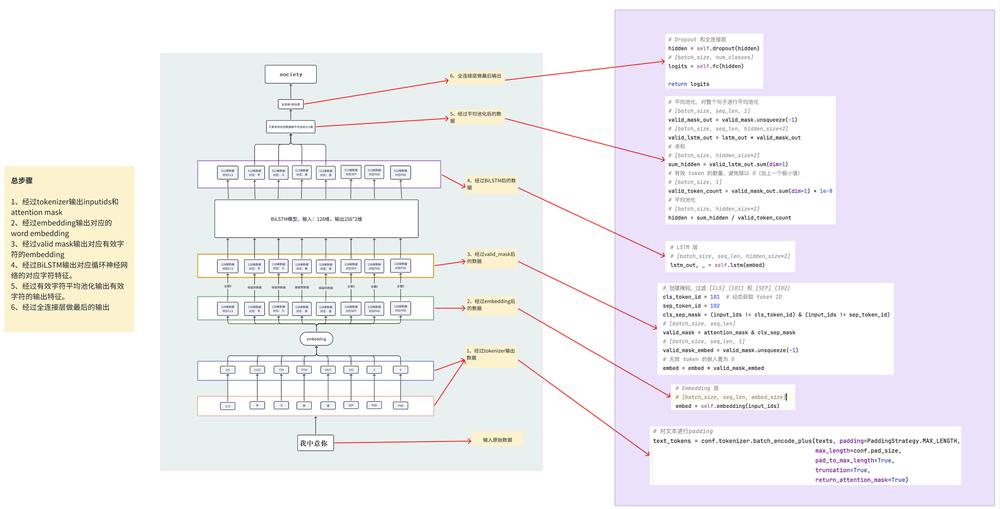
代码如下:
# 软标签蒸馏
import torch
import torch.nn as nn
import torch.nn.functional as F
from torch.optim import AdamW
from sklearn.metrics import f1_score, accuracy_score
from model2dev_utils import model2dev
from config import Config
from dataloader_utils import build_dataloader
from tqdm import tqdm
import warnings
warnings.filterwarnings("ignore")  # 忽略警告信息
from a1_bert_classifer_model import BertClassifier
from a2_bilstm_classifer_model import BiLSTMModel

conf = Config()  # 加载配置文件
# 导入教师模型和学生模型


def model2train():
    # 准备数据
    train_dataloader, dev_dataloader, test_dataloader = build_dataloader()

    # 准备模型
    # 定义教师模型Bert
    teacher_model = BertClassifier()
    # 2.1 加载模型参数
    state_dict = torch.load(conf.model_save_path)
    # 2.3 加载模型参数到模型中
    teacher_model.load_state_dict(state_dict)
    # 2.4 将模型移动到指定设备(GPU 或 CPU)
    teacher_model.to(conf.device)
    # 定义学生模型
    student_model = BiLSTMModel()
    student_model.to(conf.device)

    # 准备损失函数
    criterion = nn.CrossEntropyLoss()

    # 准备优化器(优化的是学生模型)
    optimizer = AdamW(student_model.parameters(), lr=conf.lstm_learning_rate)

    # 开始训练模型
    # 最佳F1值
    best_f1 = 0.0
    # 定义模型蒸馏的参数包括 权重系数alpha,温度参数T
    # 蒸馏参数: 温度参数T用于控制softmax()概率变平滑,这样保证学生模型学到潜在知识
    T = 2.0
    # 蒸馏参数:软标签权重用于平衡软硬标签的损失占比,alpha是软标签占比,1-alpha是硬标签占比
    alpha = 0.7

    #  遍历每个 epoch
    for epoch in range(conf.num_epochs):
        # 设置学生模型为训练模式,设置教师模型为评估模式(不更新权重)
        teacher_model.eval()
        student_model.train()
        # 设置累计损失,初始化预测和真实标签
        total_loss = 0.0
        pred_label_list, true_label_list = [], []

        # 遍历训练数据批次
        for i, batch in enumerate(tqdm(train_dataloader, desc="训练集训练中...")):
            # 8.1 input_ids, attention_mask, label放到设备
            input_ids, attention_mask, labels = batch
            input_ids = input_ids.to(conf.device)
            attention_mask = attention_mask.to(conf.device)
            labels = labels.to(conf.device)

            # 前向传播,获取学生模型的输出
            student_logits = student_model(input_ids, attention_mask)
            student_labels = torch.argmax(student_logits, dim=1)
            # 获取教师模型的输出 logits软标签与教师模型的硬标签
            with torch.no_grad():
                # 获取教师的logits分数
                teacher_logits = teacher_model(input_ids, attention_mask)
                # 获取教师硬标签
                teacher_labels = torch.argmax(teacher_logits, dim=1)

            # 计算软标签损失(KL 散度)
            # 教师模型的 log-概率
            teacher_log_soft_labels = F.log_softmax(teacher_logits / T, dim=1)
            # 学生模型的 log-概率
            student_log_soft_labels = F.log_softmax(student_logits / T, dim=1)
            # 计算KL 散度
            soft_loss = F.kl_div(student_log_soft_labels,
                                 teacher_log_soft_labels,
                                 reduction='batchmean',
                                 log_target=True)

            # 计算硬标签损失(交叉熵,使用教师模型的标签或者真实的数据标签)
            hard_loss1 = criterion(student_logits, teacher_labels)
            # 总损失:软标签和硬标签损失的加权和
            loss = (1 - alpha) * hard_loss1 + alpha * soft_loss

            # 汇集损失和预测标签以及真实标签
            total_loss += loss.item()
            pred_label_list.extend(student_labels.cpu().tolist())
            true_label_list.extend(labels.cpu().tolist())

            # 清空优化器梯度
            optimizer.zero_grad()
            # 反向传播计算梯度
            loss.backward()
            # 更新模型参数
            optimizer.step()

            # 每10个批次或一个轮次结束,计算训练集指标
            if (i + 1) % 10 == 0 or i == len(train_dataloader) - 1:
                # 计算准确率和f1值
                acc = accuracy_score(true_label_list, pred_label_list)
                f1 = f1_score(true_label_list, pred_label_list, average='macro')
                # 获取batch_count,并计算平均损失
                batch_count = i % 10 + 1
                avg_loss = total_loss / batch_count
                # 打印训练信息
                print(f"\nEpoch: {epoch + 1}, Batch: {i + 1}, Loss: {avg_loss:.4f}, acc:{acc:.4f}, f1:{f1:.4f}")
                # 清空累计损失和预测和真实标签
                total_loss = 0.0
                true_label_list, pred_label_list = [], []

            # 每 100 个 batch 验证一次,batch级别验证model2dev
            if (i + 1) % 100 == 0 or i == len(train_dataloader) - 1:
                # 获取验证集的预测结果
                reports, f1, acc, precision, recall = model2dev(student_model, dev_dataloader, conf.device)
                student_model.train()
                print("\n验证集评估报告:\n", reports)
                print(f"验证集f1,accuracy, precision, recall: {f1:.4f}, {acc:.4f}, {precision:.4f}, {recall:.4f}")

                # 验证f1并保存最好模型
                if f1 > best_f1:
                    best_f1 = f1
                    # 保存模型
                    torch.save(student_model.state_dict(), conf.bilstm_save_model_path)


if __name__ == '__main__':
    model2train()
【理解】模型剪枝
剪枝简介
基于深度神经网络的大型预训练模型拥有庞大的参数量,才能达到SOTA的效果。
但是我们参考生物的神经网络,发现却是依靠大量稀疏的连接来完成复杂的意识活动。
仿照生物的稀疏神经网络,将大型网络中的稠密连接变成稀疏的连接,并同样达到SOTA的效果,就是模型剪枝的原动力。
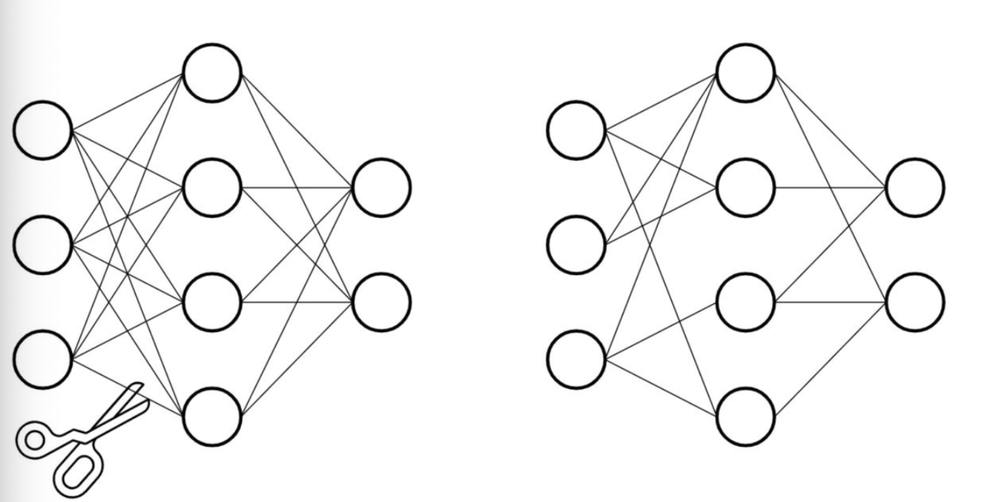
最终,整个网络就变得非常稀疏,如下所示:
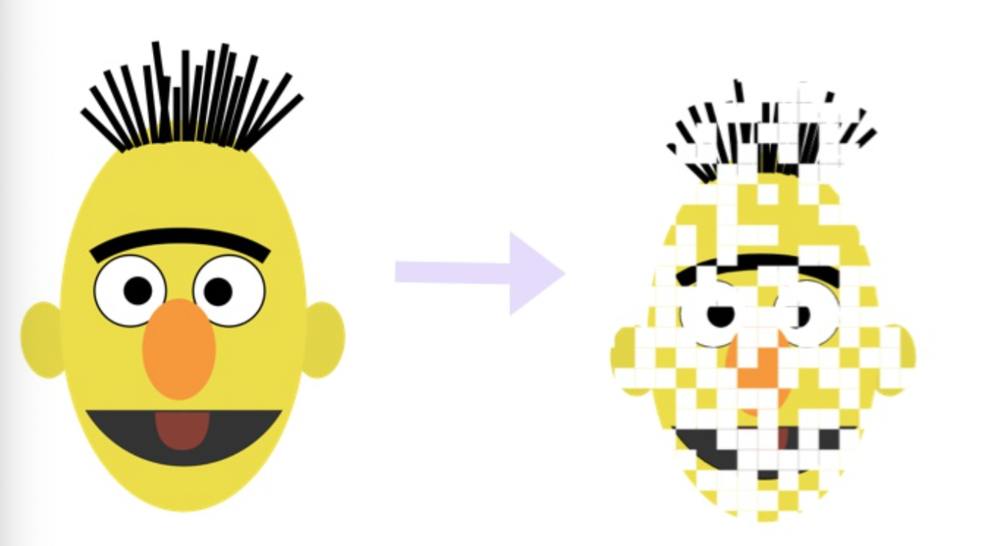
`剪枝就像裁员一样,把不重要的人裁掉!
PyTorch中的剪枝
Pytorch中对模型剪枝的支持在torch.nn.utils.prune模块中, 分以下几种剪枝方式:
-
随机剪枝
-
L1结构化剪枝
-
L1非结构化剪枝
-
全局非结构化剪枝
代码实现
import torch
import torch.nn as nn
import torch.nn.utils.prune as prune
from collections import OrderedDict


# 演示随机非结构化剪枝
def dm01():
    linear = nn.Linear(2, 3)
    print("linear-->", linear.weight)
    model = prune.random_unstructured(linear, 'weight', amount=2)
    print("model-->", model.weight)


# 演示全局非结构化剪枝
def dm02():
    net = nn.Sequential(OrderedDict([
        ('first', nn.Linear(3, 4)),
        ('second', nn.Linear(4, 2)),
    ]))
    print("net1-->", net)
    for model in net:
        print("model-->", model.weight)
    parameters_to_prune = ((net.first, 'weight'),
                           (net.second, 'weight'))
    # parameters_to_prune:待剪枝的参数
    # pruning_method:剪枝的方式,L1Unstructured表示非结构化剪枝(常用)
    # amount:如果是小数,则表示比例,如果是整数,则表示数量
    prune.global_unstructured(parameters_to_prune,
                              pruning_method=prune.L1Unstructured,
                              amount = 0.2)
    print("net2-->", net)
    for model in net:
        print("model-->", model.weight)


if __name__ == '__main__':
    # dm01()
    dm02()
随机非结构化剪枝和全局非结构化剪枝的区别:
| 非结构化剪枝 | 结构化剪枝 |
|---|---|
| 按单个权重裁剪 | 按神经元、通道、整行/列裁剪 |
| 剪枝后是稀疏矩阵 | 剪枝后是稠密矩阵 |
| 类似于裁掉部门中贡献度低的个人 | 类似于裁掉整个部门 |
小结:
#1.非结构化剪枝用L1。

#2.模型剪枝后,虽然很多权重置为0,但是默认存储还是稠密向量,类型还是float32,所以,PyTorch模型剪枝不会导致模型变小。
numel函数
numel:返回元素的总数量。
import torch

weight = torch.tensor(
    [[1.2609, 0, 1.4906],
     [-0.1462, -0.2535, 0.9246],
     [-0.8148, 0, 0.1048]]
)
print('weight-->', weight)
print('sum(weight)-->', torch.sum(weight))
print('weight==0-->', torch.sum(weight == 0))
# numel:返回weight中元素(参数)的总数量
print('weight-->', weight.numel())
print('weight-->', torch.sum(weight == 0) / weight.numel())
模型压缩 demo 代码
3 个文件- 📄 demo12_quantize.py 1.4KB 下载
- 📄 demo13_kl.py 1.7KB 下载
- 📄 demo14_prune.py 1.3KB 下载
简历模板
- 📕 resume.pdf 474.0KB
- 📕 xx-大模型开发-1年.pdf 326.4KB
- 📕 xx-简历.pdf 434.4KB
- 📕 xxx.pdf 379.0KB
- 📕 xx简历 .pdf 526.6KB
- 📕 xx简历.pdf 378.4KB
- 📕 个人简历_xxx.pdf 1.1MB