第 3 节 / 共 4 节
LLM API 文本分类
投满分笔记(day04)
投满分项目
【了解】今日内容介绍
-
大模型简介
-
DeepSeek简介
-
调用DeepSeek大模型完成新闻分类
【理解】大模型简介
概述
大语言模型,Large Language Model,简称大模型,英文缩写:LLM。
LLM通常都是具有大规模参数(通常在十亿到万亿级别)的深度学习模型。
这类模型通过在大规模数据集上进行训练,具备强大的泛化能力和复杂的任务处理能力,尤其在自然语言处理(NLP)、计算机视觉(CV)和多模态任务中表现突出。
大模型历史简介
- 2017年,Google发布Transformer框架
- 2018年,Google发布BERT模型
- 2018年,OpenAI发布GPT模型
- 2020年,OpenAI发布GPT-3模型
- 2022年底,OpenAI发布ChatGPT
- 2023年,Meta发布LLaMA模型
- 2024年底,DeepSeek发布DeepSeek-V3
- 2025年初,DeepSeek发布DeepSeek-R1
模型单位
在使用大模型时,经常看到B或者M单位的模型,或者是它的上下文长度为多少k,下面是对这些常见单位量级的理解:
- K(Kilo, 千):表示 1k=1,000。在机器学习模型中,通常用来描述较小模型的参数量,比如 100K(十万)参数。
- M(Million, 百万):表示 1M=1,000,000。一般用于中等规模的模型,比如 BERT-base(110M)。110M = 110 × 100 万 = 1.1 亿
- B(Billion, 十亿):表示1B= 1,000,000,000。大型模型通常达到这一量级,比如 GPT-3(175B)。
- T(Trillion, 万亿):表示 IT=1,000,000,000,000。这代表非常巨大的参数量。GPT-4(约1.76T)的一些版本和其他超大规模模型已经达到甚至超过 1T 参数。
大模型训练硬件
- GPU:被广泛用于AI训练,因为它特别擅长并行计算(同时处理很多小任务)。代表性企业英伟达(NVIDIA),例如显卡A100的40G显存等。
- TPU是谷歌专门为AI设计的芯片,比GPU更专注于深度学习任务,特别是张量运算(AI模型里的核心计算)。例如TPU V3的32G显存。
常见的大模型
常见国产大模型
| 公司 | 大模型 | 省市 | 类别 | 官网连接 |
|---|---|---|---|---|
| 深度求索 | Deepseek | 浙江杭州 | 通用(开源) | https://chat.deepseek.com |
| 百度 | 文心一言 | 北京 | 通用 | https://yiyan.baidu.com |
| 智谱华章 | 智谱清言 | 北京 | 通用 | https://chatglm.cn |
| 字节跳动 | 豆包 | 北京 | 通用 | https://www.doubao.com/chat |
| 阿里云 | 通义千问 | 浙江杭州 | 通用(开源) | https://www.tongyi.com |
| 百川智能 | 百川 | 北京 | 通用 | https://chat.baichuan-ai.com |
| 商汤科技 | 商量 | 上海 | 通用 | https://chat.sensetime.com/ |
| 科大讯飞 | 星火 | 安徽合肥 | 通用 | https://xinghuo.xfyun.cn |
| 华为 | 盘古 | 广东深圳 | 通用 | https://www.huaweicloud.com/product/pangu.html |
| 腾讯 | 混元 | 广东深圳 | 通用 | https://hunyuan.tencent.com |
常见海外大模型
| 公司 | 大模型 | 国家 | 类别 | 官网链接 |
|---|---|---|---|---|
| OpenAI | ChatGPT | 美国 | 通用 | https://chatgpt.com/ |
| Meta | LLaMA | 美国 | 通用(开源) | https://www.meta.ai/(访问受限) |
| Gemini | 美国 | 通用 | https://gemini.google.com/app?hl=zh | |
| Microsoft | Bing Chat | 美国 | 通用 | https://copilot.microsoft.com/ |
| Anthropic | Claude | 美国 | 通用 | https://claude.ai/(需要注册并验证) |
| xAI | Grok | 美国 | 通用 | https://grok.com/ |
【理解】DeepSeek简介
DeepSeek
本次用投满分项目分类,我们采用DeepSeek V3.2-Exp模型(该模型与2025/9/29日发布),进行新闻文本分类。
所以我们先整体了解一下deepseek(来自官网)。
深度求索(DeepSeek),成立于2023年,专注于研究世界领先的通用人工智能底层模型与技术,挑战人工智能前沿性难题。基于自研训练框架、自建智算集群和万卡算力等资源,深度求索团队仅用半年时间便已发布并开源多个百亿级参数大模型,如DeepSeek-LLM通用大语言模型、DeepSeek-Coder代码大模型,并在2024年1月率先开源国内首个MoE大模型(DeepSeek-MoE),各大模型在公开评测榜单及真实样本外的泛化效果均有超越同级别模型的出色表现。和 DeepSeek AI 对话,轻松接入 API。
官网:https://www.deepseek.com/
注意:deepseek在以远低于 OpenAI 的 o1 的成本,开发了 DeepSeek-R1 后获得了国际关注。DeepSeek V3–0324 是对前代 DeepSeek V3(于2023年12月24日发布) 的一次重要更新。
DeepSeek发布的模型
DeepSeek发布的模型非常多,以下是deepseek部分部分列表(更多模型请登录官网查看)。
deepseek目前拥有较多系列的模型, 开源模型下载地址:https://huggingface.co/deepseek-ai
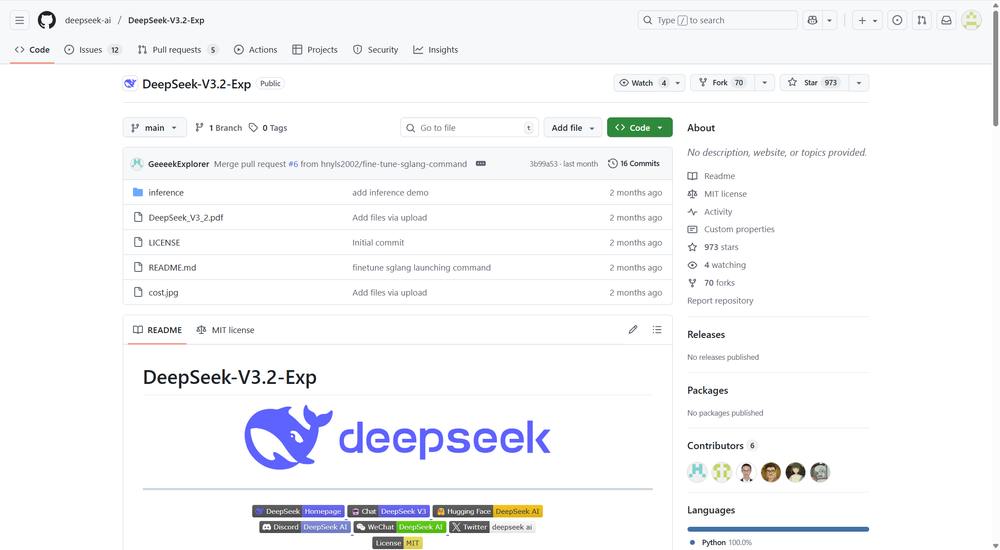
当然,github上也能找到:https://github.com/deepseek-ai/DeepSeek-V3.2-Exp
国内的魔搭社区也是可以访问的:https://modelscope.cn/organization/deepseek-ai
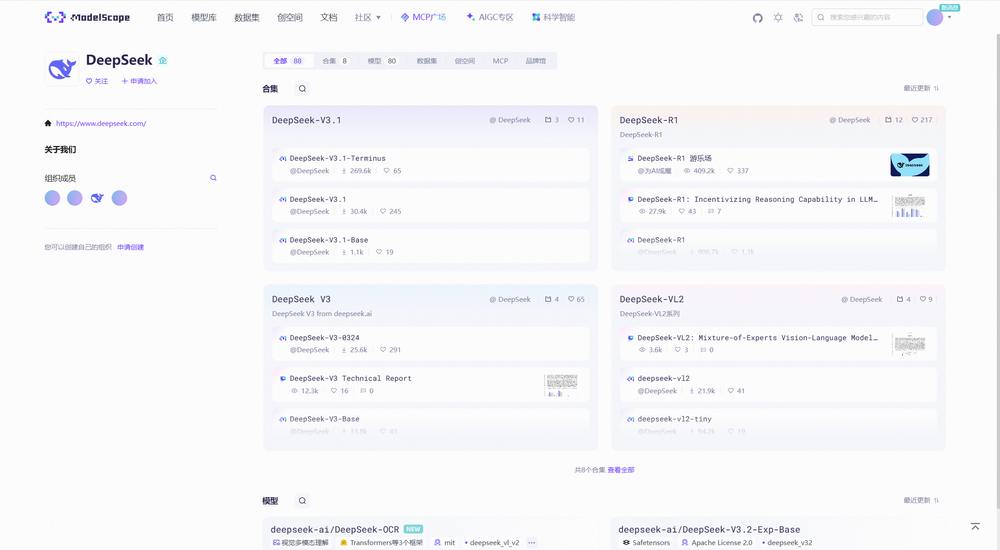
关于DeepSeek-V3和DeepSeek-R1
DeepSeek-V3
我们与 DeepSeek 交互时使用的默认模型。它是一个多功能的大型语言模型 (LLM),作为可以处理各种任务的通用工具脱颖而出。类似chatgpt一样,可以直接提问并解决通用的一些问题。
现在的DeepSeek-V3,确切地说,应该指的是DeepSeekV3.2,于2025/9/29日发布,这是一个实验性(Experimental)的版本。
最新引入了DSA(稀疏注意力),针对长文本的训练和推理效率进行了探索性的优化和验证。
使用如下:(不选择深度思考,默认就是V3)
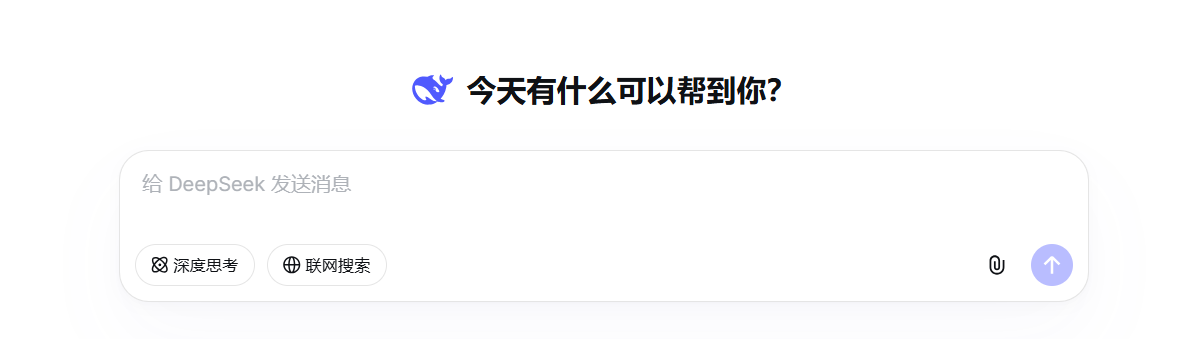
DeepSeek-R1
DeepSeek-R1是一个强大的推理模型,专为解决需要高级推理和深入解决问题的任务而构建。它的与众不同之处在于它对强化学习的特殊使用。为了训练 R1,DeepSeek 建立在 V3 奠定的基础之上,利用其广泛的能力和较大的参数空间。他们通过允许模型为解决问题的场景生成各种解决方案来执行强化学习。然后使用基于规则的奖励系统来评估答案和推理步骤的正确性。这种强化学习方法鼓励模型随着时间的推移完善其推理能力,有效地学习自主探索和开发推理路径。
使用如下:(选择深度思考,就是R1)
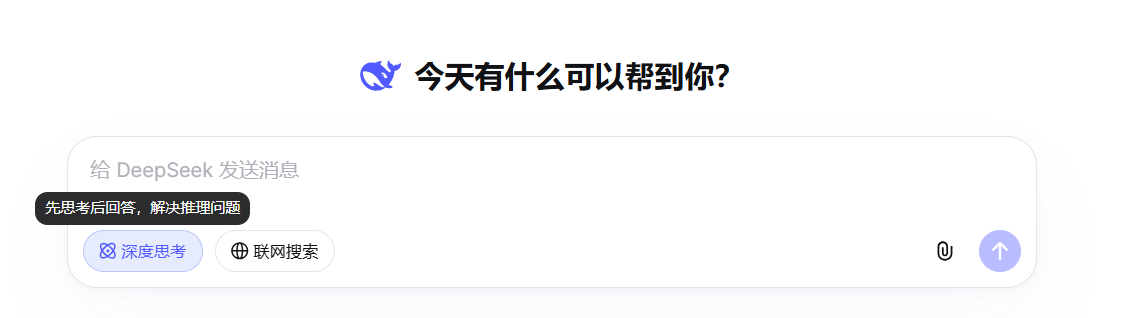
DeepSeek-V3与DeepSeek-R1比较
以下表格比较DeepSeek-V3和DeepSeek-R1在推理能力、响应速度和上下文处理上的表现,直接描述两者的优劣势,基于技术特点和通用表现,可以快速了解适用场景。
| 特性 | DeepSeek-V3 | DeepSeek-R1 | 解释 |
|---|---|---|---|
| 推理能力 | 依赖“下一词预测”,适合简单任务,不擅长复杂推理 | 通过强化学习和思维链推理,擅长复杂问题解决 | V3像会背书的学霸,知识多但不擅长原创思考;R1像逻辑严密的科学家,能推导新答案。适合简单问答用V3,复杂逻辑用R1。 |
| 响应速度 | MoE架构,响应几乎即时 | 因推理耗时,响应较慢 | V3像快餐店,快速出餐,适合实时需求;R1像大厨,精心烹饪但耗时长。适合快速回答用V3,深入分析用R1。 |
| 上下文处理 | 支持64,000字符,适合短对话 | 支持64,000字符,擅长复杂长对话 | V3像朋友间随便聊聊,适合短对话;R1像开会追踪话题,适合长篇讨论。适合简单问答用V3,研究讨论用R1。 |
总结与建议
| 任务类型 | 推荐模型 | 推荐原因 |
|---|---|---|
| 写作、内容创作、翻译 | V3 | 速度快,语言流畅,适合快速生成文本(见示例2:写作任务秒级完成,故事自然)。 |
| 可以评估输出质量的任务 | V3 | 快速回答,适合简单脚本或可手动检查的任务,成本低(V3比R1便宜)。 |
| 通用编码问题 | V3 | 快速生成简单代码,适合初级编程需求(但复杂编码需R1)。 |
| AI助手(聊天、问答) | V3 | 对话自然,响应快,适合日常交互(如实时聊天机器人)。 |
| 研究 | R1 | 推理能力强,适合需要深入分析的复杂研究任务。 |
| 复杂数学、编码或逻辑问题 | R1 | 通过思维链推理,解决复杂问题(如示例1:数学,示例3:编码修复)。 |
| 长时间迭代对话 | R1 | 在复杂多轮对话中保持逻辑一致,适合深入讨论。 |
| 了解推理过程 | R1 | 提供详细推理步骤,适合学习或验证(如示例3:编码问题分析)。 |
优先使用V3,因其快速且成本低(具体价格见DeepSeek官网API文档)。
若答案不准确或任务复杂(如数学、复杂编码),切换到R1。注意:验证输出正确性对复杂任务至关重要,R1更可靠但响应慢。
怎么使用DeepSeek-V3
通常我们实际工作中主要有以下三种使用方式:
官方网页进行使用
访问DeepSeek官网,点击开始对话即可使用,如下图:
官方的API进行使用
访问DeepSeek官网,注册账号,登录,即可看到右上角有API开放平台入口,如下图:
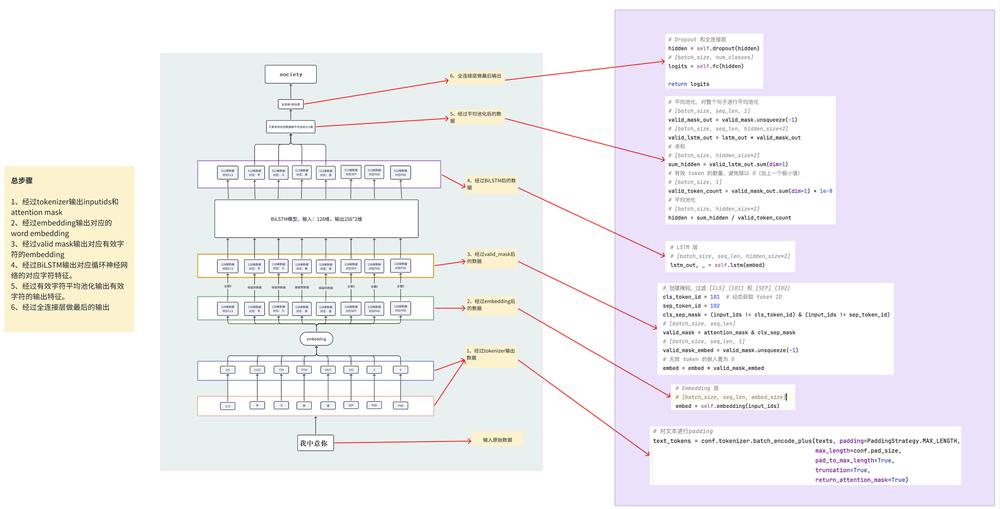
点击,如下图所示:
注意,第一次使用,需要创建API Key,如果已经使用过(已有API Key),则不需要重复创建。
API Key(应用程序接口密钥)是一种用于身份验证的唯一标识符,通常是一串由字母、数字或符号组成的代码。API Key 确保只有授权的用户或应用程序能够调用大模型的服务,同时帮助服务提供商跟踪使用情况、限制访问权限、防止滥用,并可用于计费或配额等管理。
API Key 就像是你在网上点外卖时用的“专属取餐码”。它就是你和大模型之间的“通行证”!
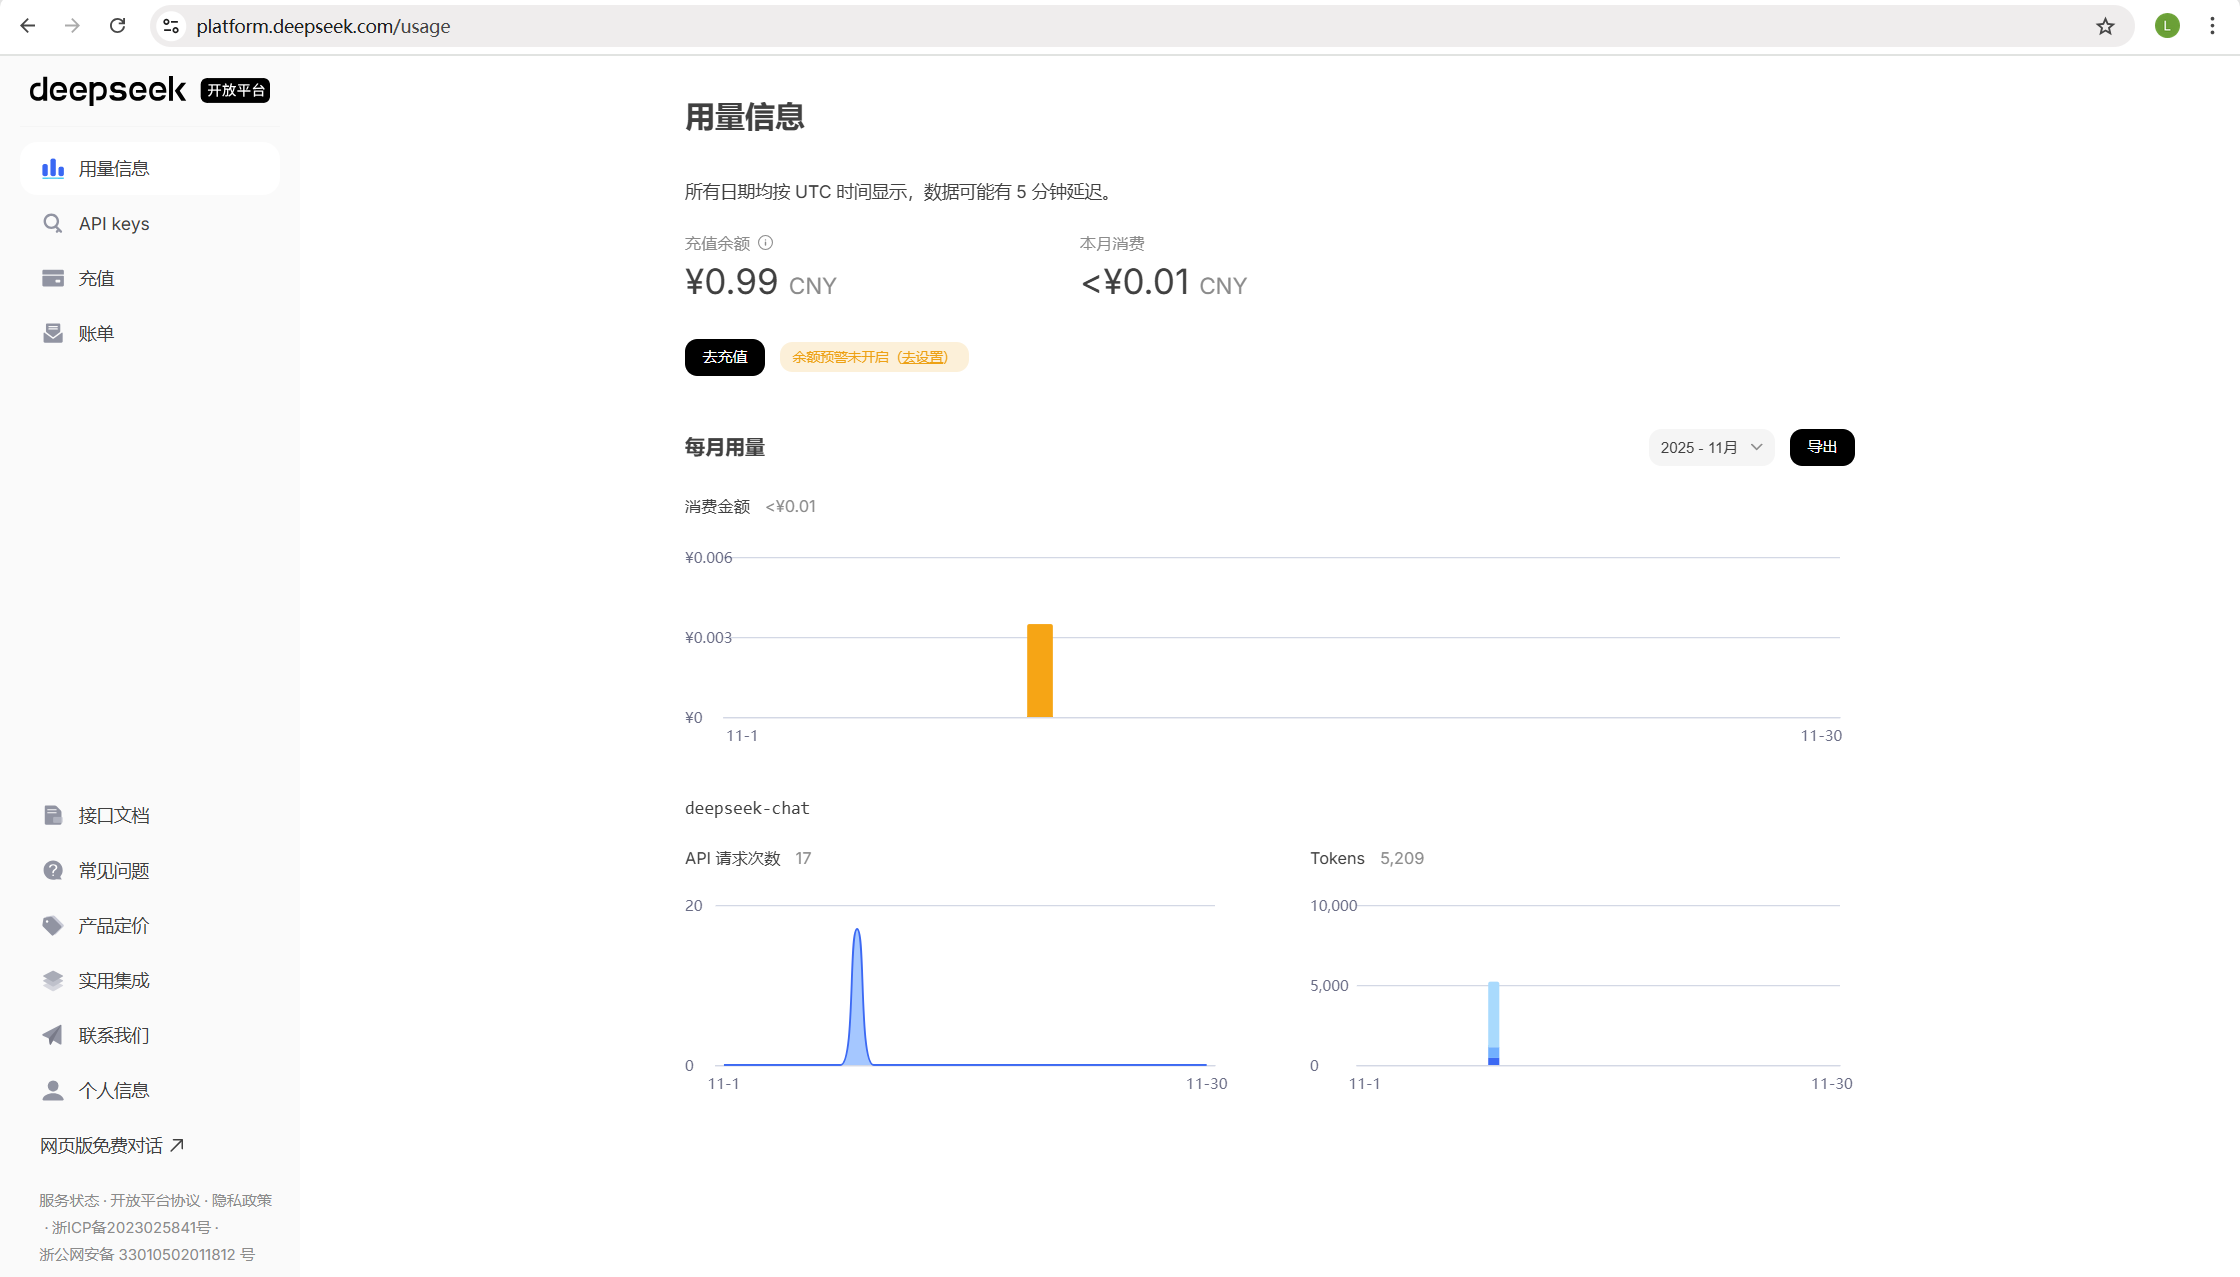
继续点击左边的API keys,创建一个API key,创建完成后如下所示:
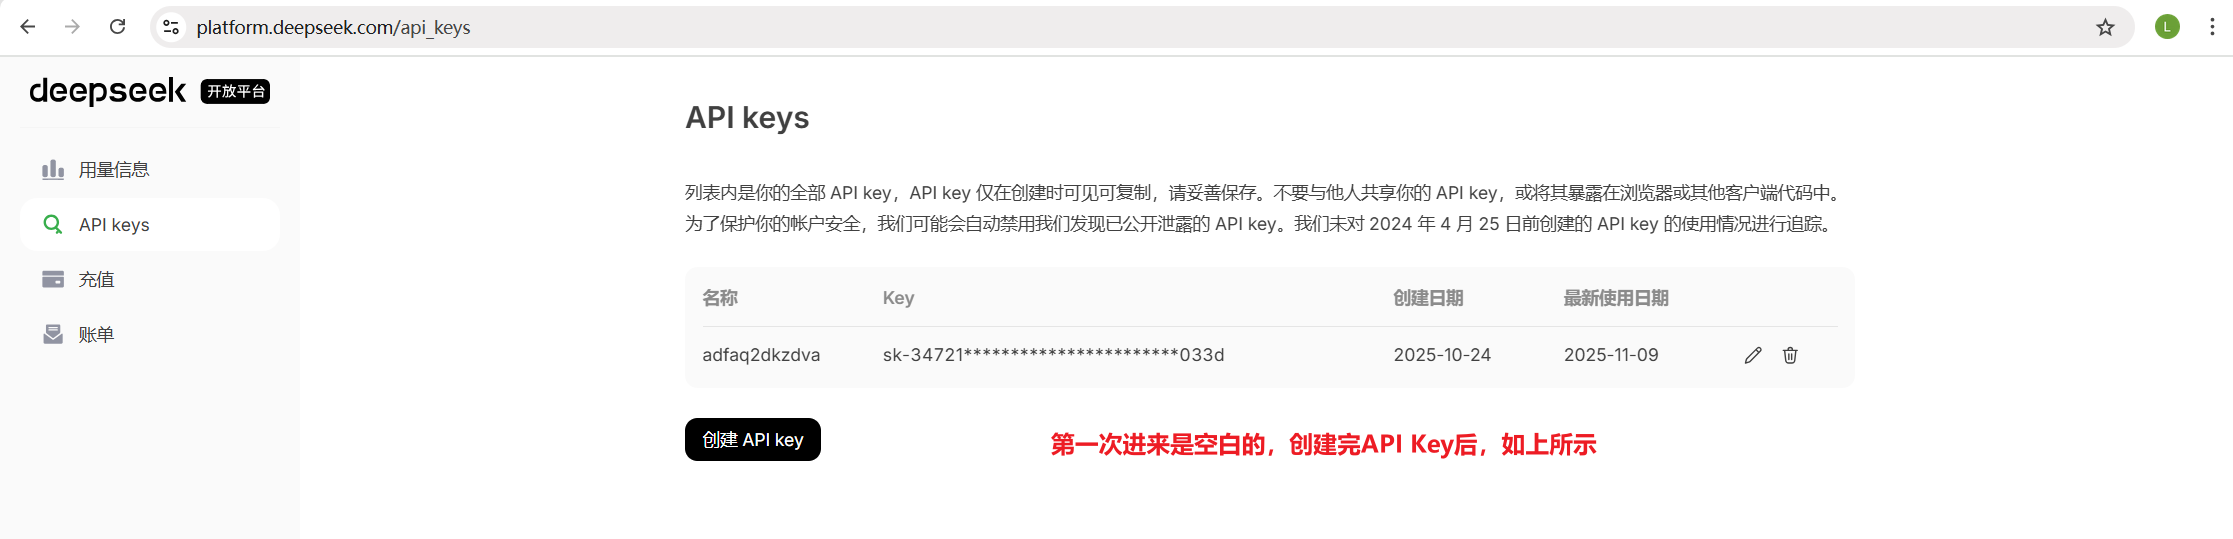
特别注意:API Key只会在第一次创建时显示一次!
到此,API Key就已经创建好了。下面就可以调用DeepSeek了。
点击左侧的接口文档,如下图:
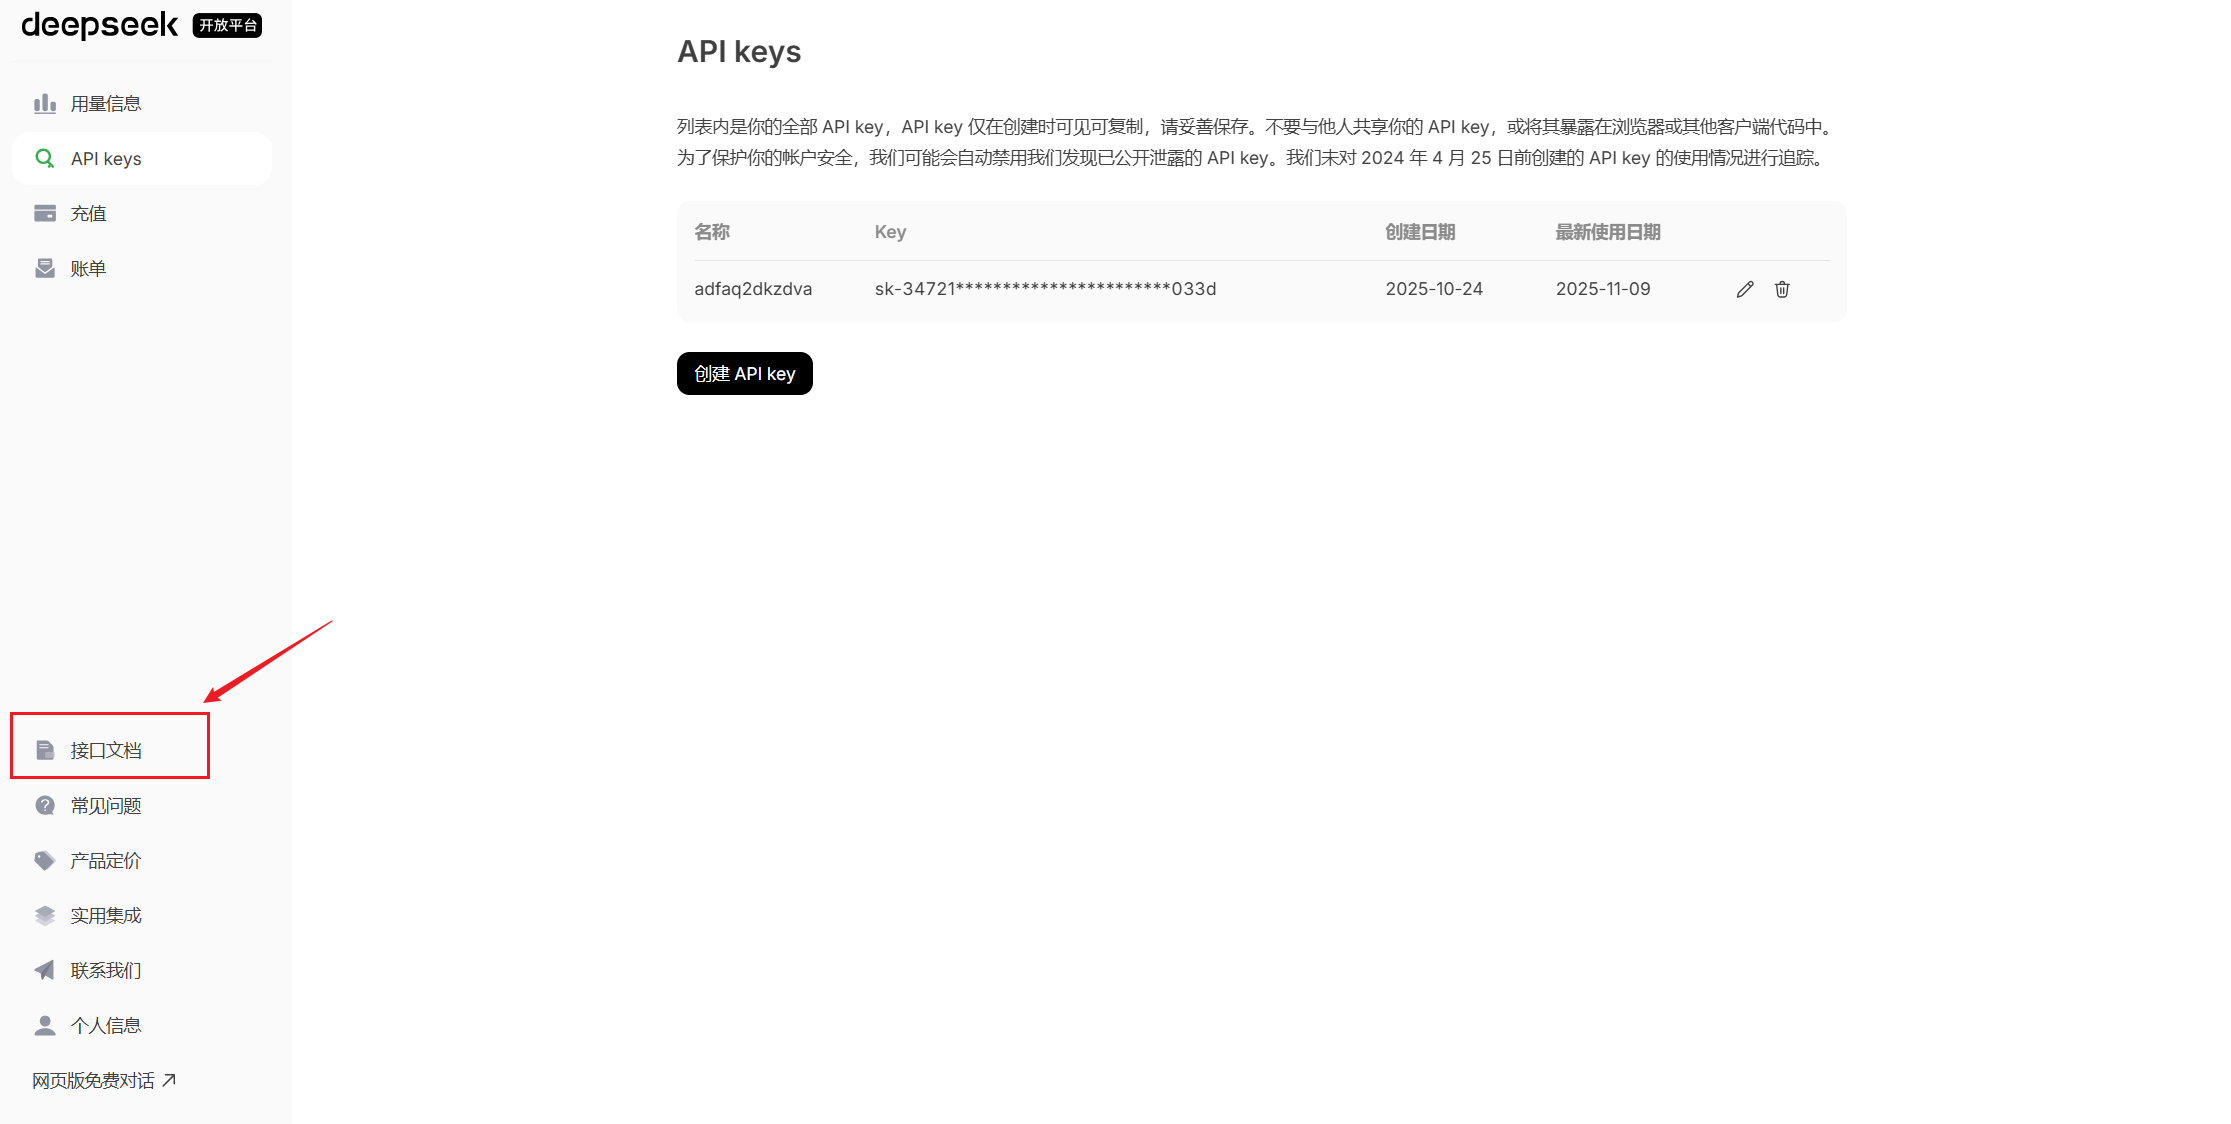
单机后,回跳转到如下页面,我们选择python,即可看到官网给的示例代码:
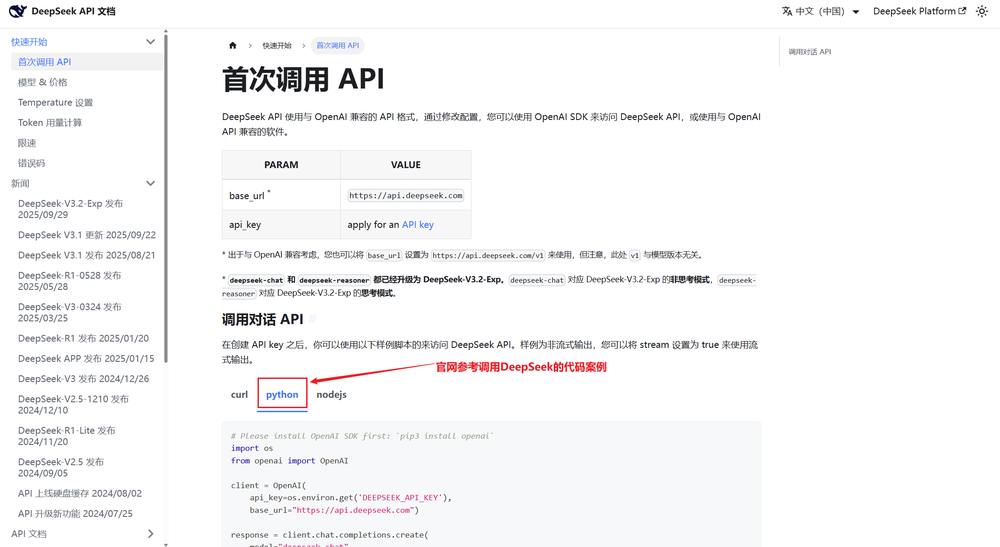
复制代码出来,给定api_key,运行如下:
from openai import OpenAI


def dm01():
    client = OpenAI(
        api_key="sk-34721a9bd4f347a7836fa2ba3e47033d",
        base_url="https://api.deepseek.com")

    response = client.chat.completions.create(
        model="deepseek-chat",
        messages=[
            {"role": "system", "content": "You are a helpful assistant"},
            {"role": "user", "content": "Hello"},
        ],
        stream=False
    )

    print(response.choices[0].message.content)


if __name__ == '__main__':
    dm01()
结果如下:
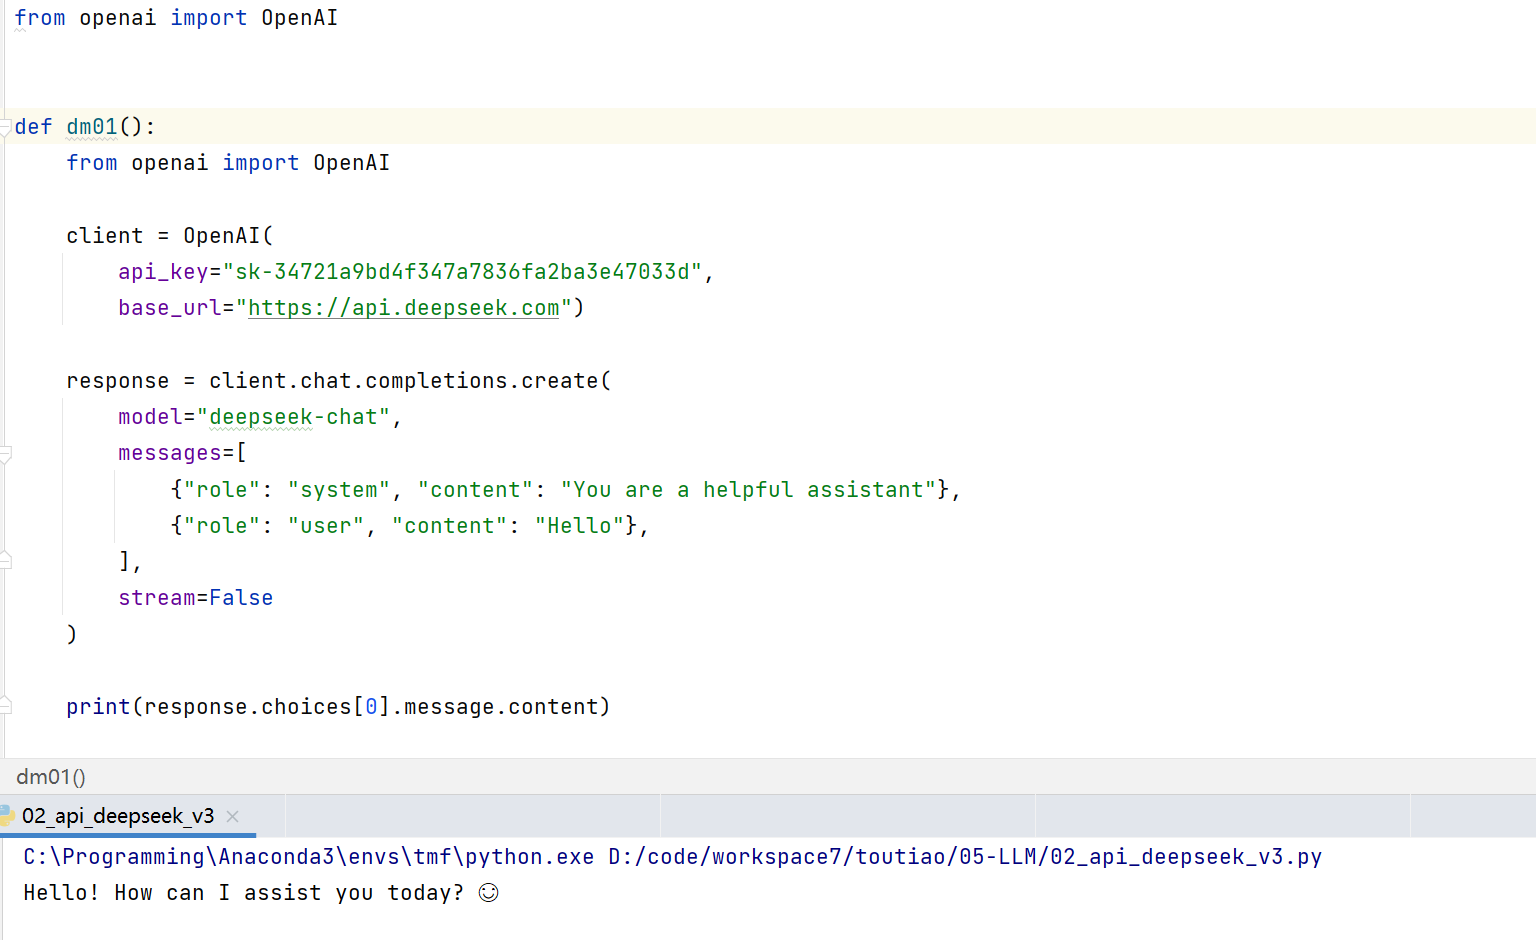
下载开源大模型
DeepSeek-V3.2下载可以在Hugging Face或者魔搭社区。
Hugging Face地址:https://huggingface.co/deepseek-ai/DeepSeek-V3.2-Exp
魔搭社区地址:https://modelscope.cn/models/deepseek-ai/DeepSeek-V3-0324
因DeepSeek-V3.2版本发布不久,魔搭社区还未更新。目前魔搭上可以下载的是V3系列的版本。
Tips:无论是从哪里下载,都不建议直接下载。因为这个模型太大了。
【实现】使用DeepSeek-V3实现新闻分类
我们可以修改Prompt,让模型按照我们的意图来输出结果。
如下代码:
from openai import OpenAI


# 调用第三方模型(远程),这里以DeepSeek为例。
def dm02(prompt):
    # 创建客户端
    client = OpenAI(api_key="sk-34721a9bd4f347a7836fa2ba3e47033d", base_url="https://api.deepseek.com")
    # 创建会话
    response = client.chat.completions.create(
        # 模型deepseek-chat是deepseek-v3
        # 模型deepseek-reasoner是deepseek-r1
        model="deepseek-chat",
        messages=[
            {"role": "system", "content": "你是一个ai助手"},
            {"role": "user", "content": prompt},
        ],
        stream=False
    )
    # 打印结果
    print(response.choices[0].message.content)


if __name__ == '__main__':
    # dm01()
    dm02("给我讲一个笑话")
结果如下:
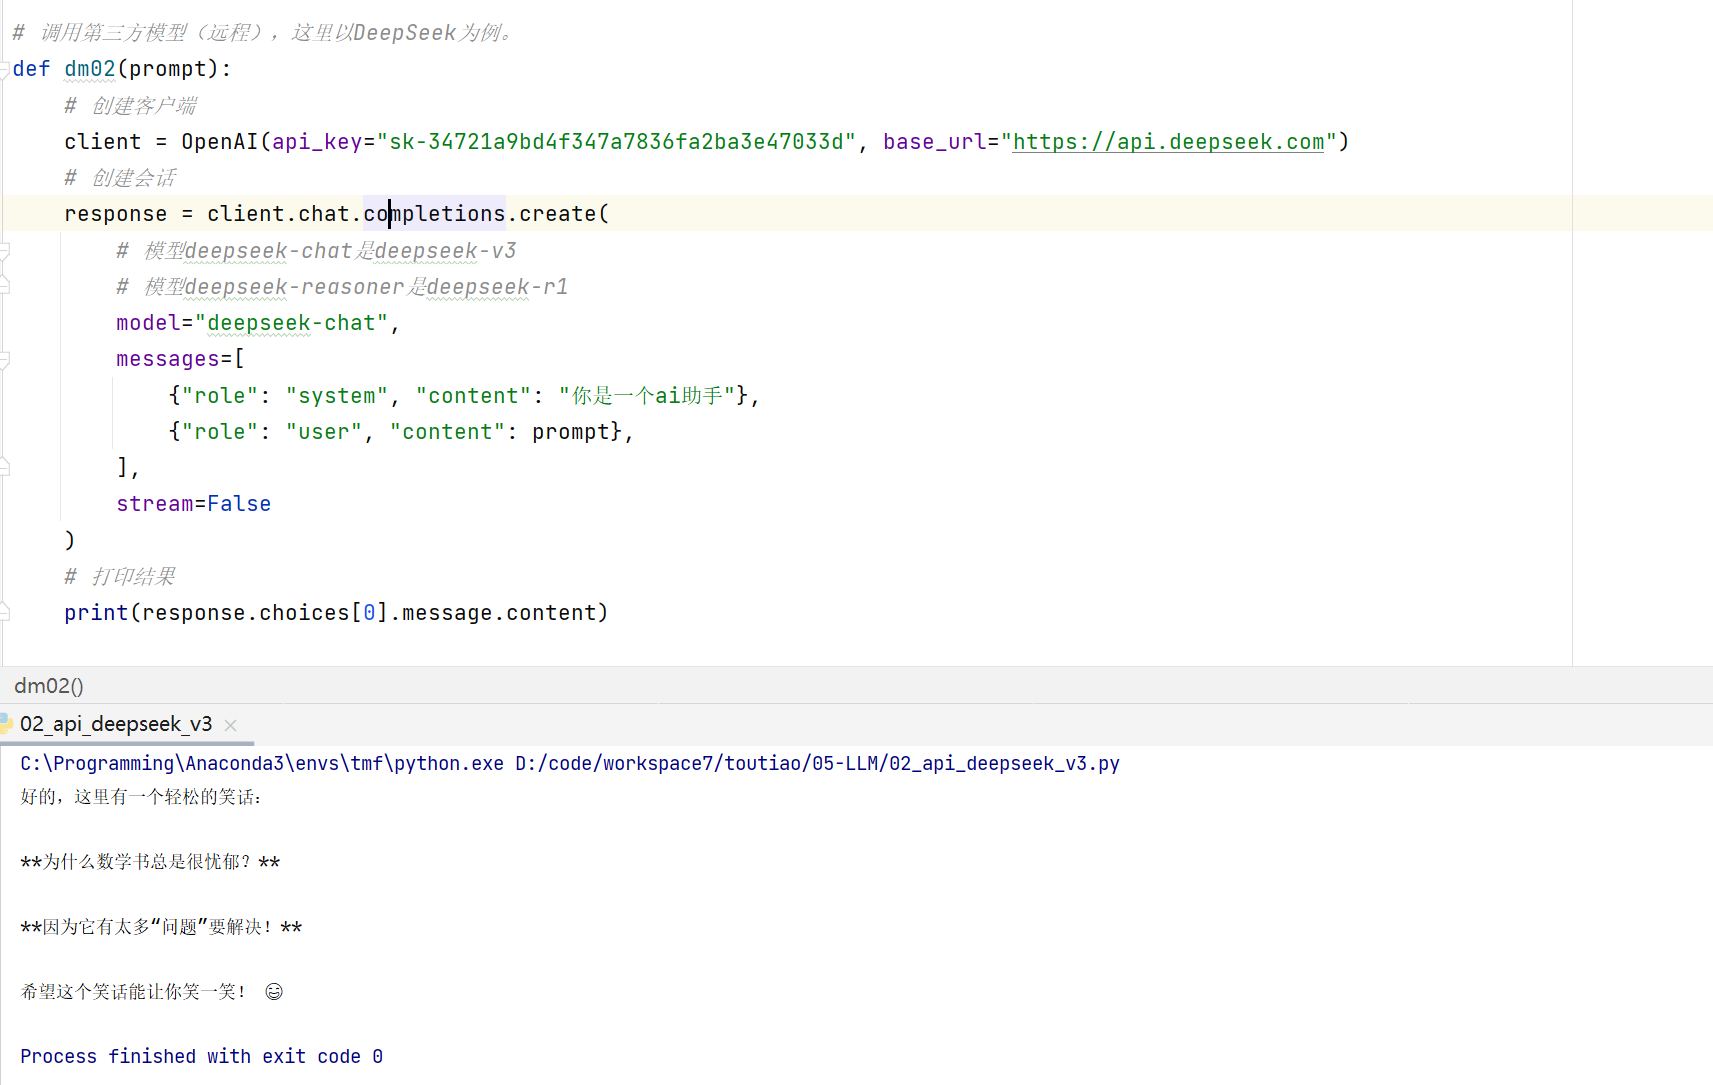
有了上述的基础后,至于如何使用DeepSeek-V3来完成新闻标题分类,就变得容易多了。
我们只需要修改Prompt提示词,或者给一个Prompt提示词即可。
# 先安装: pip install openai
# 导包
from dotenv import load_dotenv
load_dotenv()
import os
from openai import OpenAI


SYSTEM_PROMPT = """
你是一个专业的中文新闻分类器,你的任务是将输入的中文新闻标题分类到以下10个类别之一:

0 - finance (金融财经)
1 - realty (房地产)
2 - stocks (股市)
3 - education (教育)
4 - science (科技科学)
5 - society (社会民生)
6 - politics (政治)
7 - sports (体育)
8 - entertainment (娱乐)
9 - game (游戏)

分类规则:
1. 仔细分析新闻标题的内容和主题
2. 只从上述10个类别中选择最匹配的一个
3. 返回格式只需返回对应的英文类别名称
4. 如果确实无法确定类别,选择最接近的类别

示例输入输出:
输入:"体验2D巅峰 倚天屠龙记十大创新概览"
输出:"entertainment"

输入:"同步A股首秀:港股缩量回调"
输出:"stocks"

输入:"金科西府 名墅天成"
输出:"realty"

现在请对以下新闻标题进行分类:
"""


def get_deepseek_res(prompt):
    # 创建客户端
    client = OpenAI(api_key=os.getenv("DEEPSEEK_API_KEY"), base_url=os.getenv("BASE_URL"))
    # 创建会话
    response = client.chat.completions.create(
        # 模型deepseek-chat是deepseek-v3
        # 模型deepseek-reasoner是deepseek-r1
        model="deepseek-chat",
        messages=[
            {"role": "system", "content": SYSTEM_PROMPT},
            {"role": "user", "content": prompt},
        ],
        stream=False
    )
    # 返回结果
    return response.choices[0].message.content


if __name__ == '__main__':
    prompt = "体验2D巅峰 倚天屠龙记十大创新概览"
    res = get_deepseek_res(prompt)
    print(res)
运行结果如下:
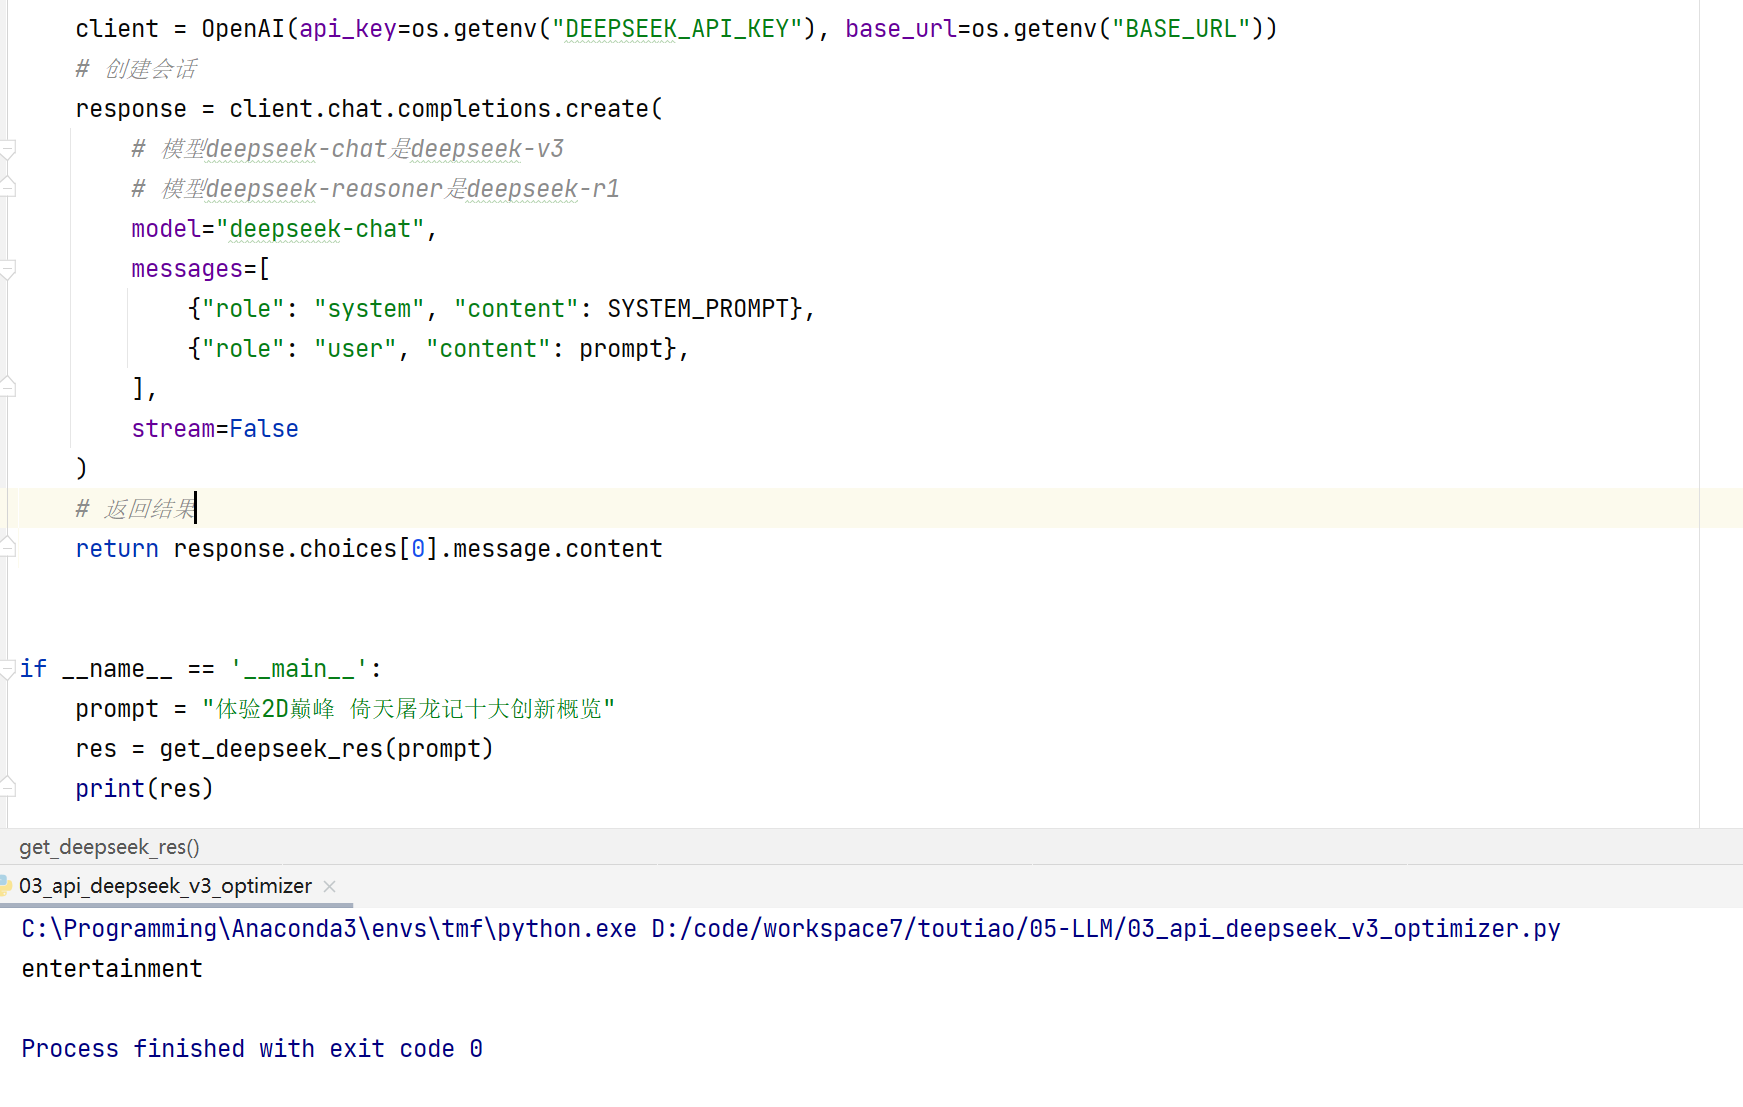
到此,使用DeepSeek-V3来实现新闻标题分类就完成了。
LLM API demo 代码
3 个文件- 📄 demo09_args.py 160B 下载
- 📄 demo10_deepseek.py 3.0KB 下载
- 📄 demo11_qwen.py 859B 下载