第 2 节 / 共 4 节
FastText 与 BERT 文本分类
投满分笔记(day03)
投满分项目
【了解】今日内容介绍
- Fasttext模型
- BERT预训练模型
【实现】Fasttext模型
前言说明
前面我们已经完成了基线模型RandomForest一个实现,但是当前场景对分类指标、泛化能力和处理复杂语义需求相对较高。RandomForest随机森林对于自然语言的处理能力有限。
所以我们需要引入更为先进自然语言处理技术,包括FasText、BERT以及大语言模型LLM。
因为这些模型在学术以及工业都有不错的性能表现,所以这里我们会进行整体技术实现以及评估,来最终获得符合当前场景需求的具体技术解决方案。
这里我们先使用Fasttext模型来训练。后续再逐步使用BERT和LLM。
模型构建流程
基于FastText分类建模思路:
#1.对数据train.txt等相关文件的文本进行分词处理,两种处理思路:字符级别和词级别。
格式:__label__标签 文本
__label__positive i love you
__label__positive 我喜欢杭州西湖
__label__positive 我 喜 欢 杭 州 西 湖 (字级别)
__label__positive 我 喜欢 杭州 西湖    (词级别)

本科未录取还有这些路可以走   3
           |
           |
          \|/
__label__education 本 科 未 录 取 还 有 这 些 路 可 以 走        ????
__label__education 本科 未 录取 还有 这些 路 可以 走            jieba


# 特性:subword(子词)

#2.利用fastext库进行建模、评估与保存。
02-fasttext_char_1_default.py
03-fasttext_char_2_auto.py
04-fasttext_word_1_default.py
05-fasttext_word_2_auto.py

#3.模型预测
model = fasttext.train_supervised()
y_pred = model.predict()
result = model.test()
model.save_model()
fasttext.load_model()

#4.模型部署,提供api接口

#5.前端预测实现
回顾
预测流程
在具体实现之前,先回顾一下,使用Fasttext来预测的流程:
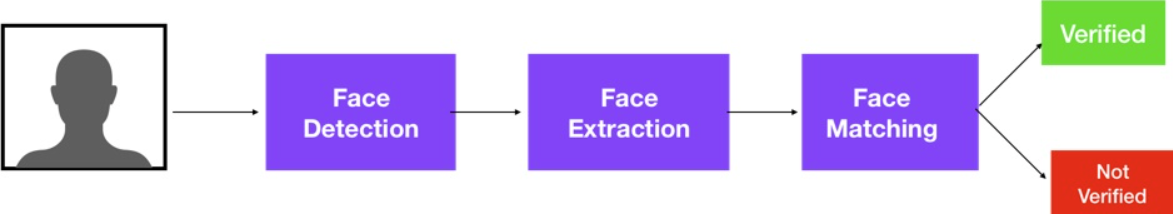
常用参数
Fasttext的参数非常多,这里罗列一些如下:
# lr                         学习率 default 0.1
# dim                        词向量维度 default 100
# ws                         上下文窗口大小 default 5
# epoch                      epochs 数量 default 5
# minCount                   最低词频 default 5
# wordNgrams                 n-gram设置 default 1
# loss                       损失函数 {hs,softmax} default softmax
# minn                       子词最小字符长度 default 0(表示禁用子词)
# maxn                       子词最大字符长度 default 0(表示禁用子词)
# verbose:                  该参数决定日志打印级别, 当设置为3, 可以将当前正在尝试自动搜索的超参数打印出来,我们设置verbose来观察超参数的值
wordNgrams:token与token之间。默认就是1,代表当前token。与前后token都不相关。
子词:token内部结构(词语的一部分)。比如(token:产品)的子词可以是:(产、品、产品)
token:次元(一个字、一次词语、标点符号)
代码实现
配置
配置文件和之前类似,注意路径要和本地词频路径对应上就行。
class Config:
    def __init__(self):
        self.root_path = r'D:\code\workspace7\toutiao/'
        # 原始数据路径
        self.train_datapath = self.root_path + '01-data/train.txt'
        self.test_datapath = self.root_path + '01-data/test.txt'
        self.dev_datapath = self.root_path + '01-data/dev.txt'
        # 类别文档
        self.class_doc_path = self.root_path + "01-data/class.txt"

        # 数据处理保存路径
        # 字符级别fasttext
        self.process_train_datapath_char = self.root_path + "03-fasttext/final_data/train_process_char.txt"
        self.process_test_datapath_char = self.root_path + "03-fasttext/final_data/test_process_char.txt"
        self.process_dev_datapath_char = self.root_path + "03-fasttext/final_data/dev_process_char.txt"

        # 词级别fasttext
        self.process_train_datapath_word = self.root_path + "03-fasttext/final_data/train_process_word.txt"
        self.process_test_datapath_word = self.root_path + "03-fasttext/final_data/test_process_word.txt"
        self.process_dev_datapath_word = self.root_path + "03-fasttext/final_data/dev_process_word.txt"

        # 处理完的数据(用于训练)
        self.final_data = self.root_path + '03-fasttext/final_data'

        # 模型路径
        self.ft_model_save_path = self.root_path + '03-fasttext/save_models'

        # 类别字典 {标签索引:标签名称}
        self.id2class_dict = {i: line.strip() for i, line in enumerate(open(self.class_doc_path))}


if __name__ == '__main__':
    conf = Config()
    print('conf.train_datapath-->', conf.train_datapath)
    print('conf.test_datapath-->', conf.test_datapath)
    print('conf.dev_datapath-->', conf.dev_datapath)
    print('conf.id2class_dict-->', conf.id2class_dict)
数据预处理
加载数据,进行分词处理。这里做了字符级别分词和词语级别分词,最后把分词后的数据组装成Fasttext模型识别的数据格式。
import jieba
from config import *

# 加载配置
conf = Config()


# 定义函数读取指定文件数据,并转为fasttext输入格式
def process_data(datapath, processed_datapath, is_char=True):
    # 读取原始文件
    with open(datapath, 'r', encoding='utf-8') as f:
        # 处理后数据写入新文件
        with open(processed_datapath, 'w', encoding='utf-8') as fw:
            for line in f.readlines():  # 此处.readlines()可以省略
                # 转换为fasttext格式:__label__字符串标签 分词后文本
                # 按行去除首尾多余字符
                line = line.strip()
                # 如果数据为空,则结束本轮循环,继续循环下一行
                if not line:
                    continue
                # 获取标签和文本
                text, label = line.split('\t')
                # 标签转换为整数索引
                label = int(label)
                # 获取标签字符串
                label_str = conf.id2class_dict[label]
                # 进行分词
                if is_char:
                    text_split = " ".join(list(text))
                else:
                    text_split = " ".join(jieba.lcut(text))
                # 打印测试结果
                # print(text_split)
                # print(label_str)
                # 构建fasttext格式
                ft_line = "__label__" + label_str + " " + text_split + "\n"
                # 写入文件
                fw.write(ft_line)


if __name__ == '__main__':
    # 字符级别处理
    process_data(conf.train_datapath, conf.process_train_datapath_char, is_char=True)
    process_data(conf.test_datapath, conf.process_test_datapath_char, is_char=True)
    process_data(conf.dev_datapath, conf.process_dev_datapath_char, is_char=True)

    # 分词级别处理
    process_data(conf.train_datapath, conf.process_train_datapath_word, is_char=False)
    process_data(conf.test_datapath, conf.process_test_datapath_word, is_char=False)
    process_data(conf.dev_datapath, conf.process_dev_datapath_word, is_char=False)
模型训练
字符级别,默认参数
# 导入工具包
import fasttext
from config import Config
import datetime
import os

# 获取时间
current_time = datetime.datetime.now().date().today().strftime("%Y%m%d")
print("current_time-->", current_time)


# 加载配置
conf = Config()

# 1、模型训练
model = fasttext.train_supervised(input=conf.process_train_datapath_char,
                                  dim=10,  # 词向量的维度  默认100
                                  minn=1,  # 子词最小长度  默认0
                                  maxn=4,  # 子词最大长度  默认0
)
# 模型训练后信息:词向量信息,标签信息,词频信息和预测能力,子词信息等
print(model.get_word_vector("日"))
print(model.labels)
print(len(model.labels))
# </s>:句子结束标记(sentence end)所以它的词频是样本数
print(model.get_words(include_freq=True))
print(list(zip(*model.get_words(include_freq=True))))
print(len(list(zip(*model.get_words(include_freq=True)))))
print('-----------------------------------------------------')

# 2、模型保存
# model_path = config.ft_model_save_path + "/model_char_1_default.bin"
model_path = os.path.join(conf.ft_model_save_path, "model_char_1_default1.bin")
model.save_model(model_path)

# 3、模型预测
print(model.predict("日 本 地 震 : 金 吉 列 关 注 在 日 学 子 系 列 报 道"))

# 4、模型词表的查看
print(model.words[:10])

# 5、模型子词查看,注意:上述训练未开启子词
# < 和 > :子词模式中用于包裹词的边界符号
print(model.get_subwords("日本地震!"))
# 输出模型维度
print(model.get_dimension())

# 6、模型评估
# 结果(10000, 0.8634, 0.8634)
# 说明:(样本数,精确率,召回率)
print(model.test(conf.process_test_datapath_char))
字符级别,自动调参
# 导入工具包
import fasttext
from config import Config
import datetime

"""
fastText 自从 v0.9.0 版本起,支持了内置的 自动调参(Auto Tuning) 功能,
通过设置 autotuneValidationFile 参数,可以让模型在训练时根据你提供的验证集自动调整以下超参数:
学习率(lr)
epoch 数量(epoch)
词向量维度(dim)
字符 n-gram 长度范围(minn, maxn)
单词 n-gram 数量(wordNgrams)
损失函数类型(loss)
注意: 若你没有设置 autotuneValidationFile,fastText 将不会进行自动调参!!!
"""
# 加载配置
conf = Config()

# 获取时间
current_time = datetime.datetime.now().date().today().strftime("%Y%m%d")

# 自动调参学习
# 1、模型训练
model = fasttext.train_supervised(input=conf.process_train_datapath_char,
                                  autotuneValidationFile=conf.process_dev_datapath_char,
                                  autotuneDuration=300,  # 自动调参时长
                                  thread=1, verbose=3,  # 可设置0,1,2,3,其中3输出更详细的调试信息,包括自动调参过程、每个 epoch 的 loss等
                                  seed=42  # 设置随机数生成器的种子值,确保实验的可重复性
)
# 2、模型保存
# 保存路径
model_path = conf.ft_model_save_path + f"/model_char_2_auto_{current_time}.bin"
model.save_model(model_path)

# 3、模型预测
print(model.predict("日 本 地 震 : 金 吉 列 关 注 在 日 学 子 系 列 报 道"))

# 4、模型词表的查看
print(model.words[:10])

# 5、模型子词查看
print(model.get_subwords("日"))
# 打印向量维度
print(model.get_dimension())

# 6、模型评估
print(model.test(conf.process_test_datapath_char))
词语级别,默认参数
# 导入工具包
import fasttext
from config import Config


# 获取时间
conf = Config()

# 1、模型训练
model = fasttext.train_supervised(input=conf.process_train_datapath_word, seed=42)

# 2、模型保存
model_path = conf.ft_model_save_path + "/model_word_1_default.bin"
model.save_model(model_path)

# 3、模型预测
print(model.predict("日本 地震 : 金吉列 关注 在 日 学子 系列报道"))

# 4、模型词表的查看
print(model.words[:10])

# 5、模型子词查看
print(model.get_subwords("日本"))
# 输出模型维度
print(model.get_dimension())

# 6、模型评估
print(model.test(conf.process_test_datapath_word))
词语级别,自动调参
# 导入工具包
import fasttext
from config import Config
import datetime

conf = Config()

# 获取时间
current_time = datetime.datetime.now().date().today().strftime("%Y%m%d")

# 自动调参学习
# 1、模型训练
model = fasttext.train_supervised(input=conf.process_train_datapath_word,
                                  autotuneValidationFile=conf.process_dev_datapath_word,
                                  seed=42,
                                  verbose=3
)
# 2、模型保存
# 保存路径
model_path = conf.ft_model_save_path + f"/model_word_2_auto_{current_time}.bin"
model.save_model(model_path)

# 3、模型预测
print(model.predict("日本 地震 : 金吉列 关注 在 日 学子 系列报道"))

# 4、模型词表的查看
print(model.words[:10])

# 5、模型子词查看
print(model.get_subwords("日本"))
# 打印向量维度
print(model.get_dimension())

# 6、模型评估
print(model.test(conf.process_test_datapath_word))
模型预测(评估)
一行代码,已经嵌入在模型训练中了。
print(model.test(conf.process_test_datapath_word))
Fasttext模型准确率:91%左右。
模型部署
服务端
首先,准备一个预测函数。用于对输入的文本进行预测。
import jieba
import pickle
from config import Config
import warnings
warnings.filterwarnings('ignore')

# 加载配置
conf = Config()
# 忽略警告信息

# 加载模型
with open(conf.rf_model_save_path, 'rb') as f:
    model = pickle.load(f)
# 加载向量化器
with open(conf.tfidf_model_save_path, 'rb') as f:
    tfidf = pickle.load(f)


def predict_fun(data):
    # jieba分词
    words = " ".join(jieba.lcut(data['text'])[:30])
    # 向量化
    features = tfidf.transform([words])
    # 预测
    y_pred_id = model.predict(features)[0]

    # 设置标签索引和名称对应关系
    id2class = {i: line.strip() for i, line in enumerate(open(conf.class_doc_path, encoding='utf-8'))}
    # 获取预测类别名称
    y_pred = id2class[y_pred_id]
    data["pred_class"] = y_pred
    return data


if __name__ == '__main__':
    data = {"text": "体验2D巅峰 倚天屠龙记十大创新概览"}
    result = predict_fun(data)
    print(result)
其次,把这个预测函数使用Flask封装成API接口的形式,使其可以通过requests库远程请求访问。
from flask import Flask, request, jsonify
from rf_predict_func import predict_fun
import warnings
warnings.filterwarnings('ignore')

# 创建app
app = Flask(__name__)


# 创建预测接口
# 用户访问url: http://127.0.0.1:8008/predict
@app.route('/predict', methods=['POST'])
def predict():
    # 获取post请求携带的用户数据
    data = request.get_json()
    print('data-->', data)
    print('type(data)-->', type(data))
    # 根据用户请求数据进行预测
    result = predict_fun(data)
    print("result-->", result)
    # 返回结果给用户
    print("Response-->", jsonify(result))
    return jsonify(result)


# 启动服务,测试
if __name__ == '__main__':
    app.run(host='0.0.0.0', port=8008, debug=True)
到此,分段的代码就实现了。
客户端
首先,先写个测试代码,看看能不能通过requests请求服务端的API接口。
import requests
# 定义接口地址
url = 'http://127.0.0.1:8008/predict'

try:
    # 测试调用api接口
    # 获取用户录入的新闻标题
    text = input("请输入新闻标题:")
    response = requests.post(url, json={'text': text})
    print('response-->', response.json())

except Exception as e:
    print("Error occurred:", e)
上述代码运行OK后,下面使用Streamlit编写HTML页面。让客户通过web可视化的方式访问。
import streamlit as st
import requests
import time

# streamlit创建页面
# 设置标题
st.title("投满分分类项目")
st.write("这是一个投满分分类项目")
# 获取用户输入的文本
text = st.text_input("请输入要查询分类的文本:")

# 后台发送请求
# 准备url
url = 'http://127.0.0.1:8008/predict'
if st.button("基于随机森林模型获取分类!"):
    start_time = time.time()
    try:
        # 发送请求
        response = requests.post(url, json={'text': text})
        print('response-->', response.json())
        # 计算耗时
        estimated_time = (time.time() - start_time) * 1000
        st.write("耗时:", estimated_time, "ms")
        # 显示结果到页面
        st.write("预测结果", response.json()["pred_class"])
    except Exception as e:
        print("Error occurred:", e)
最后,Streamlit不能直接运行,需要使用命令运行,命令如下:
import os

# 执行指令
os.system('streamlit run D:/code/workspace7/toutiao/02-rf/app_streamlit.py')
【实现】BERT模型
模型构建流程
#1.下载bert预训练模型
目前bert的版本脚本,本次使用中文版的bert,即bert-base-chinese

#2.构建数据处理脚本 对数据train.txt等相关样本文件进行处理,构建符合模型输入要求的训练数据

#3.构建 “bert+线性层” 的分类模型
Bert是一个预训练模型,所以我们可以基于bert模型本身加上一个线性分类层来构建我们的下游任务

#4.模型训练
全参微调,效果要好。

#5.模型预测

#6.模型部署
代码实现
配置
import torch
import datetime
from transformers import BertModel, BertTokenizer, BertConfig

# 获取当前日期字符串
current_date = datetime.datetime.now().date().strftime("%Y%m%d")


# 配置类
class Config(object):
    def __init__(self):
        """
        配置类,包含模型和训练所需的各种参数。
        """
        self.model_name = "bert"  # 模型名称
        # 路径
        # 根目录
        self.root_path = r'D:\code\workspace7\toutiao/'
        # 原始数据路径
        self.train_datapath = self.root_path + '01-data/train.txt'
        self.test_datapath = self.root_path + '01-data/test.txt'
        self.dev_datapath = self.root_path + '01-data/dev.txt'
        # 类别文档
        self.class_path = self.root_path + "01-data/class.txt"
        # 类别名列表
        self.class_list = [line.strip() for line in open(self.class_path, encoding="utf-8")]  # 类别名单

        # 模型训练保存路径
        self.model_save_path = self.root_path + "04-bert/save_models/bert_classifer_model.pt"  # 模型训练结果保存路径

        # 模型训练+预测的时候  训练设备,如果GPU可用,则为cuda,否则为cpu
        self.device = torch.device("cuda" if torch.cuda.is_available() else "cpu")

        self.bert_path = self.root_path + "/04-bert/bert-base-chinese"  # 预训练BERT模型的路径
        self.bert_model = BertModel.from_pretrained(self.bert_path)  # 加载预训练BERT模型
        self.tokenizer = BertTokenizer.from_pretrained(self.bert_path)  # BERT模型的分词器
        self.bert_config = BertConfig.from_pretrained(self.bert_path)  # BERT模型的配置

        # 参数
        self.num_classes = len(self.class_list)  # 类别数
        self.num_epochs = 1  # epoch数
        self.batch_size = 64  # mini-batch大小
        self.pad_size = 32  # 每句话处理成的长度(短填长切)
        self.learning_rate = 5e-5  # 学习率

        # 量化模型存放地址
        # 注意: 量化的时候模型需要的设备首选是cpu
        self.bert_model_quantization_model_path = self.root_path + "04-bert/save_models/bert_classifer_quantization_model.pt"  # 模型训练结果保存路径


if __name__ == '__main__':
    # 测试
    conf = Config()
    print('conf.device-->', conf.device)
    print('conf.class_list-->', conf.class_list)
    print('conf.tokenizer-->', conf.tokenizer)
    input_size = conf.tokenizer.convert_tokens_to_ids(["你", "好", "中", "人"])
    print('input_size-->', input_size)
    # print('conf.bert_model-->', conf.bert_model)
    # print('conf.bert_config-->', conf.bert_config)
数据预处理
BERT模型的数据预处理,需要先加载数据,然后把数据转换为Dataset,最后再转换为DataLoader。
# 加载数据工具类
from tqdm import tqdm
import torch
from torch.utils.data import Dataset, DataLoader
from config import Config

# 加载配置
conf = Config()


# 1.加载并处理原始数据
def load_raw_data(file_path):
    """
    从指定文件中加载原始数据。处理文本文件,返回(文本, 标签类别索引)元组列表
    参数:file_path: 原始文本文件路径
    返回:list: 包含(文本, 标签类别索引)的元组列表,类别为int类型
    [('体验2D巅峰 倚天屠龙记十大创新概览', 8), ('60年铁树开花形状似玉米芯(组图)', 5)]
    """
    result = []
    # 打印指定文件
    with open(file_path, 'r', encoding='utf-8') as f:
        # 使用tqdm包装文件读取迭代器,以便显示加载数据的进度条
        for line in tqdm(f, desc=f"加载原始数据{file_path}"):
            # 移除行两端的空白字符
            line = line.strip()
            # 跳过空行
            if not line:
                continue
            # 将行分割成文本和标签两部分
            text, label = line.split("\t")
            # 将标签转为int作为类别
            label = int(label)
            # 将文本和转换为整数的标签作为元组添加到数据列表中
            result.append((text, label))
    # 返回处理后的列表
    return result


def test_load_raw_data():
    # 测试load_raw_data方法
    data_list = load_raw_data(conf.dev_datapath)
    # print("data_list-->", data_list)
    print(data_list[0])
    print(data_list[1])
    # print(data_list[:10])  # [('体验2D巅峰 倚天屠龙记十大创新概览', 8), ('60年铁树开花形状似玉米芯(组图)', 5)]


# 2.自定义数据集
class TextDataset(Dataset):
    # 初始化数据
    def __init__(self, data_list):
        self.data_list = data_list

    # 返回数据集长度
    def __len__(self):
        return len(self.data_list)

    # 根据样本索引,返回对应的特征和标签
    def __getitem__(self, idx):
        text, label = self.data_list[idx]
        return text, label


def test_text_dataset():
    # 测试TextDataset类
    data_list = load_raw_data(conf.dev_datapath)
    dataset = TextDataset(data_list)
    print(dataset[0])
    print(dataset[1])


# 3.批量处理数据
"""
每当 DataLoader 从 Dataset 中取出一批batch 的原始数据后,
就会调用 collate_fn 来对这个 batch 进行统一处理(如填充、转换为张量等)。
"""
def collate_fn(batch):
    """
    对batch数据进行padding处理
    参数: batch: 包含(文本, 标签)元组的batch数据
    返回: tuple: 包含处理后的input_ids, attention_mask和labels的元组
    """
    # 使用zip()将一批batch数据中的(text, label)元组拆分成两个独立的元组
    # texts = [item[0] for item in batch]
    # labels = [item[1] for item in batch]
    texts, labels = zip(*batch)
    # 对文本进行padding
    text_tokens = conf.tokenizer.batch_encode_plus(
        texts,
        add_special_tokens=True,  # 默认True,自动添加 [CLS] 和 [SEP]
        # padding=True,自动填充到数据中的最大长度       padding='max_length':填充到指定的固定长度
        padding='max_length',
        max_length=conf.pad_size,  # 设定目标长度
        truncation=True,  # 开启截断,防止超出模型限制
        return_attention_mask=True  # 请求返回注意力掩码,以区分输入中的有效信息和填充信息
    )
    # print("text_tokens-->", text_tokens)
    # 从文本令牌中提取输入ID
    input_ids = text_tokens['input_ids']
    # 从文本令牌中提取注意力掩码
    attention_mask = text_tokens['attention_mask']
    # 将输入的token ID列表转换为张量
    input_ids = torch.tensor(input_ids)
    # 将注意力掩码列表转换为张量
    attention_mask = torch.tensor(attention_mask)
    # 将标签列表转换为张量
    labels = torch.tensor(labels)
    # 返回转换后的张量元组
    return input_ids, attention_mask, labels


# 4.构建dataloader
def build_dataloader():
    # 加载原始数据
    train_data_list = load_raw_data(conf.train_datapath)
    dev_data_list = load_raw_data(conf.dev_datapath)
    test_data_list = load_raw_data(conf.test_datapath)

    # 构建训练集
    train_dataset = TextDataset(train_data_list)
    dev_dataset = TextDataset(dev_data_list)
    test_dataset = TextDataset(test_data_list)

    # 构建DataLoader
    train_dataloader = DataLoader(train_dataset, batch_size=conf.batch_size, shuffle=False, collate_fn=collate_fn, drop_last=True)
    dev_dataloader = DataLoader(dev_dataset, batch_size=conf.batch_size, shuffle=False, collate_fn=collate_fn, drop_last=True)
    test_dataloader = DataLoader(test_dataset, batch_size=conf.batch_size, shuffle=False, collate_fn=collate_fn, drop_last=True)

    return train_dataloader, dev_dataloader, test_dataloader


def test_build_dataloader():
    # 测试build_dataloader方法
    train_dataloader, dev_dataloader, test_dataloader = build_dataloader()
    print('len(train_dataloader)-->', len(train_dataloader)) # ceil(180000/64) = 2813
    print('len(dev_dataloader)-->', len(dev_dataloader)) # ceil(10000/64) = 157
    print('len(test_dataloader)-->', len(test_dataloader)) # ceil(10000/64) = 157

    # 测试collate_fn方法
    """
    for i, batch in enumerate(train_dataloader)流程如下:
        1.DataLoader 从你的 Dataset 中取出一组索引;
        2.使用这些索引调用 Dataset.__getitem__ 获取原始样本;
        3.将这一组样本组成一个 batch(通常是 (text, label) 元组的列表);
        4.自动调用你传入的 collate_fn 函数来处理这个 batch 数据;
        5.返回处理后的 batch(如 input_ids, attention_mask, labels)供模型使用。
    """
    for i, batch in enumerate(train_dataloader):
        input_ids, attention_mask, labels = batch
        print("input_ids: ", input_ids.tolist())
        print("input_ids形状: ", input_ids.shape)
        print("attention_mask: ", attention_mask.tolist())
        print("attention_mask形状: ", attention_mask.shape)
        print("labels: ", labels.tolist())
        print("labels形状: ", labels.shape)
        break


if __name__ == '__main__':
    # test_load_raw_data()
    # test_text_dataset()
    test_build_dataloader()
模型训练
模型训练分为两步:先自定义模型,其次再进行模型训练。
如下代码是自定义模型。
import torch
import torch.nn as nn
from transformers import BertModel, BertTokenizer
from config import Config

# 加载配置
conf = Config()


# 定义bert模型
class BertClassifier(nn.Module):
    def __init__(self):
        # 初始化父类类的构造函数
        super().__init__()
        # 下面的BertModel是从transformers库中加载的预训练模型
        # config.bert_path是预训练模型的路径
        self.bert = BertModel.from_pretrained(conf.bert_path)
        # 定义全连接层(fc),用于分类任务
        # 输入尺寸是Bert模型隐藏层的大小,即768(对于Base模型)
        # 输出尺寸是类别数量10,由config.num_classes指定
        self.fc = nn.Linear(conf.bert_config.hidden_size, conf.num_classes)

    def forward(self, input_ids, attention_mask):
        # 使用BERT模型处理输入的token ID和注意力掩码,获取BERT模型的输出
        # outputs拆包是: _,pooled池化
        with torch.no_grad():
            outputs = self.bert(
                input_ids=input_ids,  # 输入的token ID
                attention_mask=attention_mask  # 注意力掩码用于区分有效token和填充token
            )
        # print('outputs-->',outputs)  # 观察结果
        # 通过全连接层对BERT模型的输出进行分类
        logits = self.fc(outputs.pooler_output)
        # 返回分类的logits(未归一化的预测分数)
        return logits


# 测试以上模型
def test_bert_classifier():
    # 加载tokenizer
    tokenizer = BertTokenizer.from_pretrained(conf.bert_path)

    # 示例文本
    texts = ["王者荣耀", "今天天气真好"]

    # 编码文本
    encoded_inputs = tokenizer(
        texts,
        # padding=True,  #  所有的填充到文本最大长度
        padding="max_length",  # 所有的填充到指定的max_length长度
        max_length=9,
        truncation=True,  # 如果超出指定的max_length长度,则截断
        return_tensors="pt"  # 返回 pytorch 张量,"pt" 时,分词器会将输入文本转换为模型可接受的格式
    )

    # 获取 input_ids 和 attention_mask
    input_ids = encoded_inputs["input_ids"]
    attention_mask = encoded_inputs["attention_mask"]
    print('input_ids-->', input_ids)
    print('attention_mask-->', attention_mask)

    # 创建自定义的bert模型
    model = BertClassifier()  # __init__()执行了

    # 预测
    logits = model(input_ids=input_ids, attention_mask=attention_mask)  # forward()执行了
    print('logits-->', logits)  # 每一行对应一个样本,每个数字表示该样本属于某一类别的“得分”(logit),没有经过 softmax 归一化。

    # 获取预测概率
    probs = torch.softmax(logits, dim=-1)
    print('probs-->', probs)  # 归一化后该样本属于某类的概率(范围在 0~1 之间),概率最高的就是预测结果

    # 获取预测结果
    preds = torch.argmax(logits, dim=-1)
    print('preds-->', preds)  # 得到每个样本的预测类别。表示两个输入文本被模型预测为类别 6(从 0 开始计数)。


if __name__ == '__main__':
    test_bert_classifier()
接下来是模型训练。
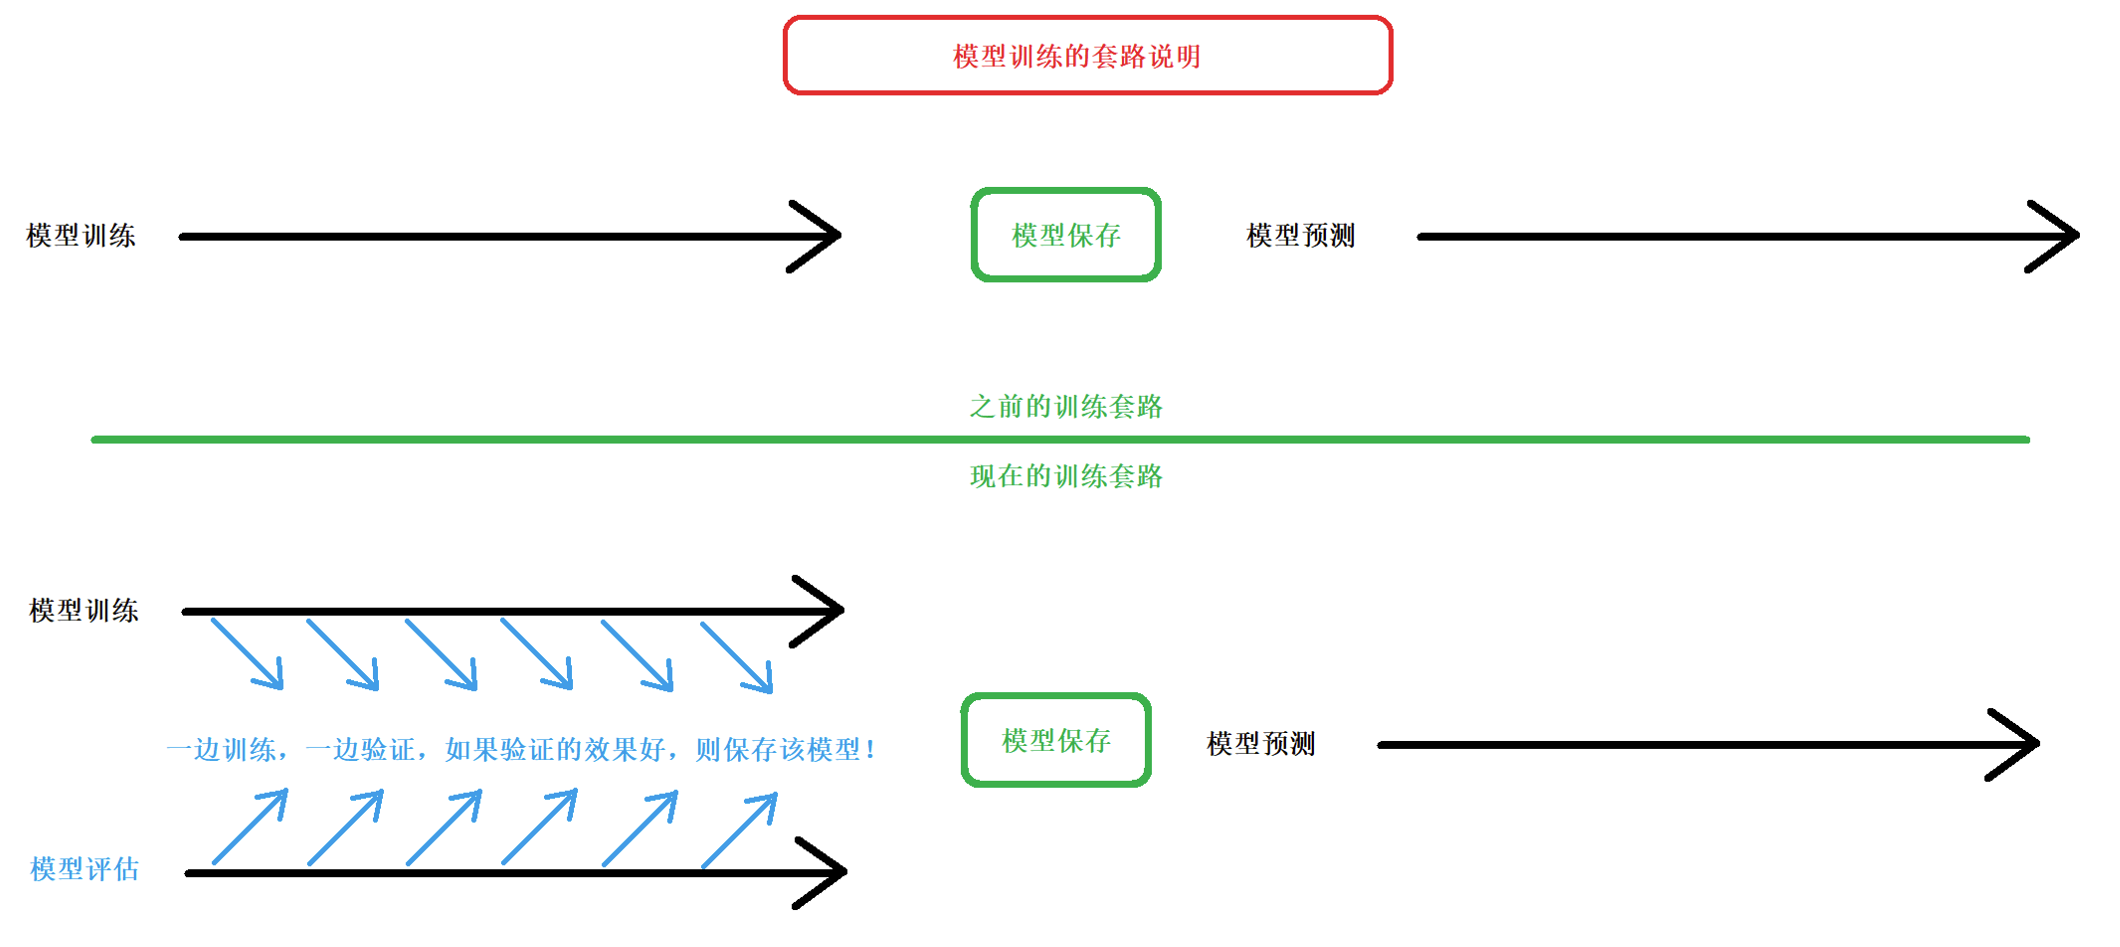
这里模型训练的套路和之前的不一样。
之前的流程:先训练,训练完后保存模型,再使用保存的模型来预测。
现在的流程:一边训练,一边验证。如果模型效果比上一个好就保存,最后使用最优的模型来预测。
如下图所示:
代码如下:
import torch
import torch.nn as nn
from torch.optim import AdamW
from sklearn.metrics import f1_score, accuracy_score, precision_score, recall_score, classification_report
from tqdm import tqdm
from model2dev_utils import model2dev
from config import Config
import warnings
# 导入数据处理工具类
from a1_dataloader_utils import build_dataloader
# 导入bert模型
from a2_bert_classifer_model import BertClassifier

warnings.filterwarnings("ignore")

# 加载配置对象,包含模型参数、路径等
conf = Config()


def model2train():
    """
    训练 BERT 分类模型并在验证集上评估,保存最佳模型。
    参数:无显式参数,所有配置通过全局 conf 对象获取。
    返回:无返回值,训练过程中保存最佳模型到指定路径。
    """
    # 准备数据
    train_dataloader, dev_dataloader, test_dataloader = build_dataloader()

    # 准备模型
    # 初始化bert分类模型
    model = BertClassifier()
    # 将模型移动到指定的设备
    model.to(conf.device)

    # 准备损失函数
    loss_fn = nn.CrossEntropyLoss()

    # 准备优化器
    optimizer = AdamW(model.parameters(), lr=conf.learning_rate)

    # 开始训练模型
    # 初始化F1分数,用于保存最好的模型
    best_f1 = 0.0
    # 外层循环遍历每个训练轮次
    #  (每次需要设置训练模式,累计损失,预存训练集测试和真实标签)
    for epoch in range(conf.num_epochs):
        # 设置模型为训练模式
        model.train()
        # 初始化累计损失,初始化训练集预测和真实标签
        total_loss = 0.0
        train_preds, train_labels = [], []
        # 内层循环遍历训练DataLoader每个批次
        for i, batch in enumerate(tqdm(train_dataloader, desc="训练集训练中...")):
            # 提取批次数据并移动到设备
            input_ids, attention_mask, labels = batch
            input_ids = input_ids.to(conf.device)
            attention_mask = attention_mask.to(conf.device)
            labels = labels.to(conf.device)

            # 前向传播:模型预测
            logits = model(input_ids, attention_mask)
            # 计算损失
            loss = loss_fn(logits, labels)
            # 累计损失
            total_loss += loss.item()
            # 获取预测结果(最大logits对应的类别)
            y_pred_list = torch.argmax(logits, dim=1)
            # 存储预测和真实标签,用于计算训练集指标
            train_preds.extend(y_pred_list.cpu().tolist())
            train_labels.extend(labels.cpu().tolist())

            # 梯度清零
            optimizer.zero_grad()
            # 反向传播:计算梯度
            loss.backward()
            # 参数更新:根据梯度更新模型参数
            optimizer.step()

            # 每10个批次或一个轮次结束,计算训练集指标
            if (i + 1) % 10 == 0 or i == len(train_dataloader) - 1:
                # 计算准确率和f1值
                acc = accuracy_score(train_labels, train_preds)
                f1 = f1_score(train_labels, train_preds, average='macro')
                # 获取batch_count,并计算平均损失
                batch_count = i % 10 + 1
                avg_loss = total_loss / batch_count
                # 打印训练信息
                print(f"\n轮次: {epoch + 1}, 批次: {i + 1}, 损失: {avg_loss:.4f}, acc准确率:{acc:.4f}, f1分数:{f1:.4f}")
                # 清空累计损失和预测和真实标签
                total_loss = 0.0
                train_preds, train_labels = [], []

            # 每100个批次或一个轮次结束,计算验证集指标,打印,保存模型
            if (i + 1) % 100 == 0 or i == len(train_dataloader) - 1:
                # 计算在测试集的评估报告,准确率,精确率,召回率,f1值
                report, f1score, accuracy, precision, recall = model2dev(model, dev_dataloader, conf.device)
                print("验证集评估报告:\n", report)
                print(f"验证集的f1: {f1score:.4f}, accuracy:{accuracy:.4f}, precision:{precision:.4f}, recall:{recall:.4f}")
                # 将模型再设置为训练模式
                model.train()
                # 如果验证F1分数优于历史最佳,保存模型
                if f1score > best_f1:
                    # 更新历史最佳F1分数
                    best_f1 = f1score
                    # 保存模型
                    torch.save(model.state_dict(), conf.model_save_path)
                    print("保存模型成功, 当前f1分数:", best_f1)


if __name__ == '__main__':
    model2train()
模型预测(评估)
使用保存好的模型来预测,和模型验证差不多。
import torch
from sklearn.metrics import f1_score, accuracy_score, precision_score, recall_score, classification_report
from tqdm import tqdm
from config import Config
import warnings
# 导入数据处理工具类
from a1_dataloader_utils import build_dataloader
# 导入bert模型
from a2_bert_classifer_model import BertClassifier

warnings.filterwarnings("ignore")

# 加载配置对象,包含模型参数、路径等
conf = Config()


def model2predict():
    # 准备数据
    train_dataloader, dev_dataloader, test_dataloader = build_dataloader()
    # 准备模型
    # 初始化bert分类模型
    model = BertClassifier()
    model.load_state_dict(torch.load(conf.model_save_path))
    # 将模型移动到指定的设备
    model.to(conf.device)
    # 设置模型为评估模式(禁用 dropout,并改变batch_norm行为)
    model.eval()
    # 初始化列表,存储预测结果和真实标签
    all_preds, all_labels = [], []
    # torch.no_grad()禁用梯度计算以提高效率并减少内存占用
    with torch.no_grad():
        # 4. 遍历数据加载器,逐批次进行预测
        for i, batch in enumerate(tqdm(test_dataloader, desc="测试集测试中...")):
            # 提取批次数据并移动到设备
            input_ids, attention_mask, labels = batch
            input_ids = input_ids.to(conf.device)
            attention_mask = attention_mask.to(conf.device)
            labels = labels.to(conf.device)
            # 前向传播:模型预测
            outputs = model(input_ids, attention_mask=attention_mask)
            # print("output-->", outputs, outputs.shape)

            # 获取预测结果(最大 logits分数 对应的类别)
            y_pred_list = torch.argmax(outputs, dim=-1)

            # 存储预测和真实标签
            all_preds.extend(y_pred_list.cpu().tolist())
            all_labels.extend(labels.cpu().tolist())
    accuracy = accuracy_score(all_labels, all_preds)
    precision = precision_score(all_labels, all_preds, average='macro')
    f1score = f1_score(all_labels, all_preds, average='macro')
    recall = recall_score(all_labels, all_preds, average='macro')
    report = classification_report(all_labels, all_preds)

    print("accuracy-->", accuracy)
    print("precision-->", precision)
    print("f1score-->", f1score)
    print("recall-->", recall)
    print("report-->", report)


if __name__ == '__main__':
    model2predict()
BERT模型准确率:训练一轮的情况下75%左右。如果训练多次,效果要优于Fasttext,可以到达93%左右。
模型部署
服务端
服务端使用Flask来部署。先提供一个预测函数,然后把该函数使用Flask封装为在线的API,最终以url的形式供外界访问。
这里是一个预测函数:
import torch
from a2_bert_classifer_model import BertClassifier
from config import Config
from a1_dataloader_utils import build_dataloader

# 加载配置
conf = Config()

# 准备模型
model = BertClassifier()
# 加载模型参数
model.load_state_dict(torch.load(conf.model_save_path))
# 添加模型到指定设备
model.to(conf.device)
# 设置模型为评估模式
model.eval()


# 定义predict_fun函数预测函数
def predict_func(data_dict):
    """
    根据用户录入数据,返回分类信息
    :param 参数 data_dict: {"text":"状元心经:考前一周重点是回顾和整理"}
    :return: 返回 data_dict: {"text":"状元心经:考前一周重点是回顾和整理", "pred_class":"education"}
    """
    # 获取文本
    text = data_dict['text']
    # 将文本转为id
    text_tokens = conf.tokenizer.batch_encode_plus([text],
                                                   padding="max_length",
                                                   max_length=conf.pad_size)
    # print("text_tokens-->", text_tokens)
    # 获取input_ids和attention_mask
    input_ids = text_tokens['input_ids']
    attention_mask = text_tokens['attention_mask']
    # 将input_ids和attention_mask转为tensor, 并指定到设备
    input_ids = torch.tensor(input_ids).to(conf.device)
    attention_mask = torch.tensor(attention_mask).to(conf.device)

    # 设置不进行梯度计算(在该上下文中禁用梯度计算,提升推理速度并减少内存占用)
    with torch.no_grad():
        # 前向传播(模型预测)
        logits = model(input_ids, attention_mask)
        # print("logits-->", logits, logits.shape)
        # 获取预测类别索引张量
        preds = torch.argmax(logits, dim=-1)
        # print("preds-->", preds)
        # 获取预测类别索引标量
        pred_idx = preds.item()
        # 获取类别名称
        pred_class = conf.class_list[pred_idx]
        # print('pred_class-->', pred_class)
        # 将预测结果添加到data_dict中
        data_dict['pred_class'] = pred_class
    # 返回data_dict
    return data_dict


if __name__ == '__main__':
    data_dict = {'text': '状元心经:考前一周重点是回顾和整理'}
    result = predict_func(data_dict)
    print("result-->", result)
这里是把预测函数封装为Flask的API:
from flask import Flask, request, jsonify
from bert_predict_func import predict_func
import warnings

warnings.filterwarnings('ignore')

# 创建flask对象
app = Flask(__name__)

#
# 用户访问url: http://主机ip:8010/predict
@app.route('/predict', methods=['POST'])
def predict():
    # 获取json数据
    data = request.get_json()
    print(type(data))
    print(data)
    # 调用预测函数
    result = predict_func(data)
    # 返回结果
    return jsonify(result)


if __name__ == '__main__':
    # 启动服务
    app.run(host='0.0.0.0', port=8010, debug=False)
到此,服务端的代码就结束了。
客户端
客户端的目的,就是要去访问服务端提供的URL链接。
所以,需要使用requests库。
我们首先使用requests库写一个demo,测试一下服务端的API接口是否可以访问。
# 测试调用api接口
import requests

# 准备url
url = 'http://127.0.0.1:8010/predict'

try:
    # 获取用户问题
    text = input("请输入文本内容:")
    # 发送POST请求
    r = requests.post(url, json={'text': text})
    print(r.json())

except Exception as e:
    print("Error occurred:", e)
上述代码如果运行OK,表示服务端的API接口可以正常访问。
接下来,就是提供一个可视化web的方式,让客户进行友好访问。
import streamlit as st
import requests
import time

# streamlit准备页面
st.title("投满分分类项目")
st.write("这是一个投满分分类项目")
# 获取用户输入
text = st.text_input("请输入文本")
# 发送请求
url = 'http://127.0.0.1:8010/predict'
if st.button("基于bert原生模型获取分类!"):
    start_time = time.time()
    try:
        # 发送post请求
        r = requests.post(url, json={'text': text})
        print(r.json())

        # 显示结果到页面
        st.write("预测结果:", r.json()["pred_class"])

        # 计算耗时
        estimated_time = (time.time() - start_time) * 1000
        st.write("耗时:", estimated_time, "ms")

    except Exception as e:
        print("Error occurred:", e)
这个可视化的web是Streamlit框架写的。这个框架仅做了解。
最后把这个可视化web运行,通过如下的命令:
import os

# 执行指令
os.system('streamlit run D:/code/workspace7/toutiao/04-bert/app_streamlit.py')
到此,客户端的代码就全部结束了。
【扩展】FastText子词与wordNgrams
OOV问题:Out Of Vocabulary,未登录词。
翻译案例:词表大小就是5000以内(常见词)。
万一,以后在真实上线的场景下,遇到了一个生僻字(之前没有见到的英文单词)。这个时候,在词表中就没有这个词语。
于是,模型在Embedding的时候,就会报错。
如何解决?
子词。(遇到陌生词语也不用担心了)
数据准备与分词
文本:这是一个很好的产品
训练这条文本,使用jieba分词,词间以空格分隔,保存为FastText格式:
train_data = [
"__label__positive 这是一个很好的产品",
"__label__positive 质量非常好,推荐购买",
"__label__positive 传智黑马程序员,推荐加入",
"__label__negative 产品不好用,失望",
"__label__negative 质量差,很快就坏了"
]
子词生成与Ngrams
FastText支持两种n-gram机制:
- 字符级n-gram:分解词为子词(如<产、产品),添加<和>标记词边界,捕捉词内部结构,解决OOV问题。
- 词级n-gram(wordNgrams):组合相邻词为短语(如这个_产品),增强上下文建模。
字符级n-gram(minn=2,maxn=4)
文本:“这个 产品 很棒”,以产品为例,启动子词:
# 不开启子词
'产品'

# 开启子词(默认会在词语的左右边界上添加<>尖括号) <产品>
'产品':'<产', '<产品', '<产品>', '产品', '产品>', '品>'
词级n-gram(wordNgrams=2 示例)
⽂本:“这个 产品 很棒”,启用wordNgrams=2:
1-gram:这个、产品、很棒
2-gram:这个_产品、产品_很棒
模型训练
使用以下参数训练有监督模型,生成词表和子词表示:
import fasttext


def dm01():
    # 禁用子词:
    # minn=0:子词最小长度,文本分类任务下,默认就是0,表示禁用
    # maxn=0:子词最大长度,文本分类任务下,默认就是0,表示禁用
    # bucket:子词哈希桶数量,一个平衡模型性能与内存开销的参数,默认就是2000000
    model = fasttext.train_supervised(input='', dim=10, minn=0, maxn=0, bucket=2000000)
    print("model-->", model)
    all_words = model.get_words()
    print("all_words-->", all_words)
    result = model.get_subwords("产品棒")
    print("result-->", result)
    result = model.get_word_vector("产品棒")
    print("result-->", result)

    # 开启子词:
    # minn=2:子词最小长度
    # maxn=4:子词最大长度
    # bucket:子词哈希桶数量
    model = fasttext.train_supervised(input='./a.txt', dim=10, minn=2, maxn=4, bucket=2000000)
    print("model-->", model)
    all_words = model.get_words()
    print("all_words-->", all_words)
    result = model.get_subwords("产品棒")
    print("result-->", result)
    result = model.get_word_vector("产品棒")
    print("result-->", result)


if __name__ == '__main__':
    dm01()
FastText 和 Word2Vec
- FastText:字符级n-gram(⼦词)+ 词级n-gram(wordNgrams),灵活处理OOV和上下⽂。
- Word2Vec:仅支持词级n-gram(需预处理,如New_York),无法处理OOV词。
这两者并不冲突,恰恰相反,子词和Ngrams结合使用:
model = fasttext.train_supervised(input='./a.txt', dim=10, minn=2, maxn=4, bucket=2000000, wordNgrams=2)
【扩展】数据集
如果自己想要练习NLP项目,首先最主要的就是找数据。
数据决定模型的上限。如果数据质量不高,那么,模型再怎么训练都不怎么好。
如何获取数据呢?
平台
#1.kaggle
www.kaggle.com
里面包含非常丰富的AI训练数据集。

#2.hugging face

#3.modelscope

#4.天池数据集

#5.github/gitee
平台数据集,质量可能高,但是也可能很低。
其他
#1.大模型生成
质量特别高。

#2.数据平台买数据

#3.接口数据
和风API
建议
模型层面
自己练习项目时,建议选择2-3个模型尝试。
#1.fasttext(必选)

#2.Bert(必选)

#3.大模型(可选)
数据层面
注意:如果是fasttext模型,数据量大一点也行。
如果是Bert模型,建议数据量别太大,几千条就够用,1-2K就够用。(尤其是没有GPU的情况下)
TMF 文本分类完整工程
76 个文件📁 00-data/
📁 data/
- 📄 class.txt 83B 下载
- 📄 dev.txt 538.4KB 下载
- 📄 stopwords.txt 5.5KB 下载
- 📄 test.txt 538.7KB 下载
📁 eda/
- 📄 config.py 452B 下载
- 📄 data_eda.py 2.0KB 下载
📁 01-rf/
📁 result/
- ⚙️ dev.csv 1.1MB 下载
- 📄 api_flask_server.py 1.2KB 下载
- 📄 api_local_client.py 439B 下载
- 📄 app_streamlit.py 861B 下载
- 📄 config.py 1.5KB 下载
- 📄 data_preprocessing.py 3.2KB 下载
- 📄 rf_predict.py 1.3KB 下载
- 📄 rf_predict_service.py 1.7KB 下载
- 📄 rf_train.py 2.7KB 下载
- 📄 run_streamlit.py 492B 下载
📁 02-fasttext/
📁 data/
- 📄 process_char_dev.txt 874.7KB 下载
- 📄 process_char_test.txt 875.4KB 下载
- 📄 process_word_dev.txt 787.2KB 下载
- 📄 api_flask_server.py 498B 下载
- 📄 app_streamlit.py 821B 下载
- 📄 config.py 1.7KB 下载
- 📄 data_preprocessing.py 2.6KB 下载
- 📄 ft_predict_service.py 1.5KB 下载
- 📄 ft_train.py 4.3KB 下载
- 📄 run_streamlit.py 55B 下载
- 📄 字典测试.py 144B 下载
📁 03-bert/
- 📄 api_flask_server.py 498B 下载
- 📄 app_streamlit.py 821B 下载
- 📄 bert_model.py 1.5KB 下载
- 📄 bert_predict_service.py 1.5KB 下载
- 📄 bert_train_and_eval.py 4.0KB 下载
- 📄 config.py 1.4KB 下载
- 📄 data_preprocessing.py 4.9KB 下载
- 📄 run_streamlit.py 55B 下载
- 📄 模型量化_DQ.py 1.9KB 下载
- 📄 测试代码.py 145B 下载
📁 04-LLM/
- 📄 01-阿里百炼平台使用.py 706B 下载
- 📄 02-DeepSeek平台使用.py 494B 下载
- 📄 api_flask_server.py 497B 下载
- 📄 app_streamlit.py 821B 下载
- 📄 llm_predict_service.py 2.6KB 下载
- 📄 run_streamlit.py 55B 下载
📁 05-distill/
📁 data/
- 📄 class.txt 83B 下载
- 📄 dev.txt 538.4KB 下载
- 📄 test.txt 538.7KB 下载
- 📄 api_flask_server.py 501B 下载
- 📄 app_streamlit.py 821B 下载
- 📄 config.py 1.2KB 下载
- 📄 data_preprocessing.py 4.4KB 下载
- 📄 model_distll.py 5.7KB 下载
- 📄 run_streamlit.py 55B 下载
- 📄 student_bilstm_model.py 4.2KB 下载
- 📄 student_predict_service.py 1.5KB 下载
- 📄 teacher_bert_model.py 2.1KB 下载
- 📄 测试代码.py 1.0KB 下载
📁 06-prune/
📁 data/
- 📄 class.txt 83B 下载
- 📄 dev.txt 538.4KB 下载
- 📄 bert_model.py 1.5KB 下载
- 📄 config.py 982B 下载
- 📄 data_preprocessing.py 4.4KB 下载
- 📄 model_eval.py 1.7KB 下载
- 📄 model_prune.py 2.8KB 下载
- 📄 model_prune_plus.py 4.4KB 下载
- 📄 测试代码.py 112B 下载
📁 test/
- 📄 demo01_counter.py 197B 下载
- 📄 demo02_sample.py 1.2KB 下载
- 📄 demo03_tf_idf.py 1.8KB 下载
- 📄 demo04_flask.py 427B 下载
- 📄 demo05_requests.py 362B 下载
- 📄 demo06_subword.py 1.2KB 下载
- 📄 demo07_split.py 215B 下载
- 📄 demo08_zip.py 146B 下载
- 📄 subword.txt 55B 下载