第 5 节 / 共 7 节
损失函数
Day05 笔记:ANN 人工神经网络
Day 05 - ANN人工神经网络
学习目标
- 了解学习率衰减策略
- 掌握正则化方法
- 掌握神经网络训练的一般工作流
- 实现手机价格分类案例
# 导包
import torch
import torch.nn as nn
import torch.optim as optim
import numpy as np
import matplotlib.pyplot as plt
# 设置中文字体
plt.rcParams['font.sans-serif'] = ['SimHei']  # 微软雅黑
plt.rcParams['axes.unicode_minus'] = False            # 解决负号显示问题
# 设置设备
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
2.学习率衰减策略
在训练神经网络时,一般情况下学习率都会随着训练而变化。主要是由于,在神经网络训练的后期,如果学习率过高,会造成loss的振荡,但是如果学习率减小的过慢,又会造成收敛变慢。
import torch
import matplotlib.pyplot as plt

def func(x_t):
    return torch.pow(2*x_t, 2)  # y = 4 x ^2

# 采用较小的学习率,梯度下降的速度慢
# 采用较大的学习率,梯度下降太快越过了最小值点,导致不收敛,甚至震荡
def demo01():
    # 定义不同的学习率进行实验
    learning_rates = [0.01, 0.1, 0.125, 0.2, 0.4]
    max_iteration = 4

    # 创建图像和子图
    fig, axes = plt.subplots(2, len(learning_rates), figsize=(5 * len(learning_rates), 8))

    for idx, lr in enumerate(learning_rates):
        # 重置参数
        x = torch.tensor([2.], requires_grad=True)
        iter_rec, loss_rec, x_rec = list(), list(), list()

        # 梯度下降过程
        for i in range(max_iteration):
            y = func(x)
            y.backward()

            x_rec.append(x.item())
            x.data.sub_(lr * x.grad)
            x.grad.zero_()

            iter_rec.append(i)
            loss_rec.append(y.item())

        # 绘制损失曲线
        axes[0, idx].plot(iter_rec, loss_rec, '-ro')
        axes[0, idx].set_title(f'LR={lr}\nLoss Curve')
        axes[0, idx].set_xlabel("Iteration")
        axes[0, idx].set_ylabel("Loss")
        axes[0, idx].grid(True)

        # 绘制函数曲线和下降轨迹
        x_t = torch.linspace(-3, 3, 100)
        y_t = func(x_t)
        axes[1, idx].plot(x_t.detach().numpy(), y_t.detach().numpy(), 'b-', alpha=0.7, label="y = 4*x²")

        y_rec = [func(torch.tensor(i)).item() for i in x_rec]
        axes[1, idx].plot(x_rec, y_rec, '-ro', label="Gradient Descent")
        axes[1, idx].set_title(f'LR={lr}\nOptimization Path')
        axes[1, idx].set_xlabel("x")
        axes[1, idx].set_ylabel("y")
        axes[1, idx].grid(True)
        axes[1, idx].legend()

    plt.tight_layout()
    # plt.show()
# 测试
if __name__ == '__main__':
    demo01()
C:\Users\angmi\AppData\Local\Temp\ipykernel_20328\4057500276.py:54: UserWarning: Glyph 178 (\N{SUPERSCRIPT TWO}) missing from font(s) SimHei.
  plt.tight_layout()
C:\Users\angmi\AppData\Roaming\Python\Python313\site-packages\IPython\core\events.py:96: UserWarning: Glyph 178 (\N{SUPERSCRIPT TWO}) missing from font(s) SimHei.
  func(*args, **kwargs)
C:\Users\angmi\AppData\Roaming\Python\Python313\site-packages\IPython\core\pylabtools.py:170: UserWarning: Glyph 178 (\N{SUPERSCRIPT TWO}) missing from font(s) SimHei.
  fig.canvas.print_figure(bytes_io, **kw)
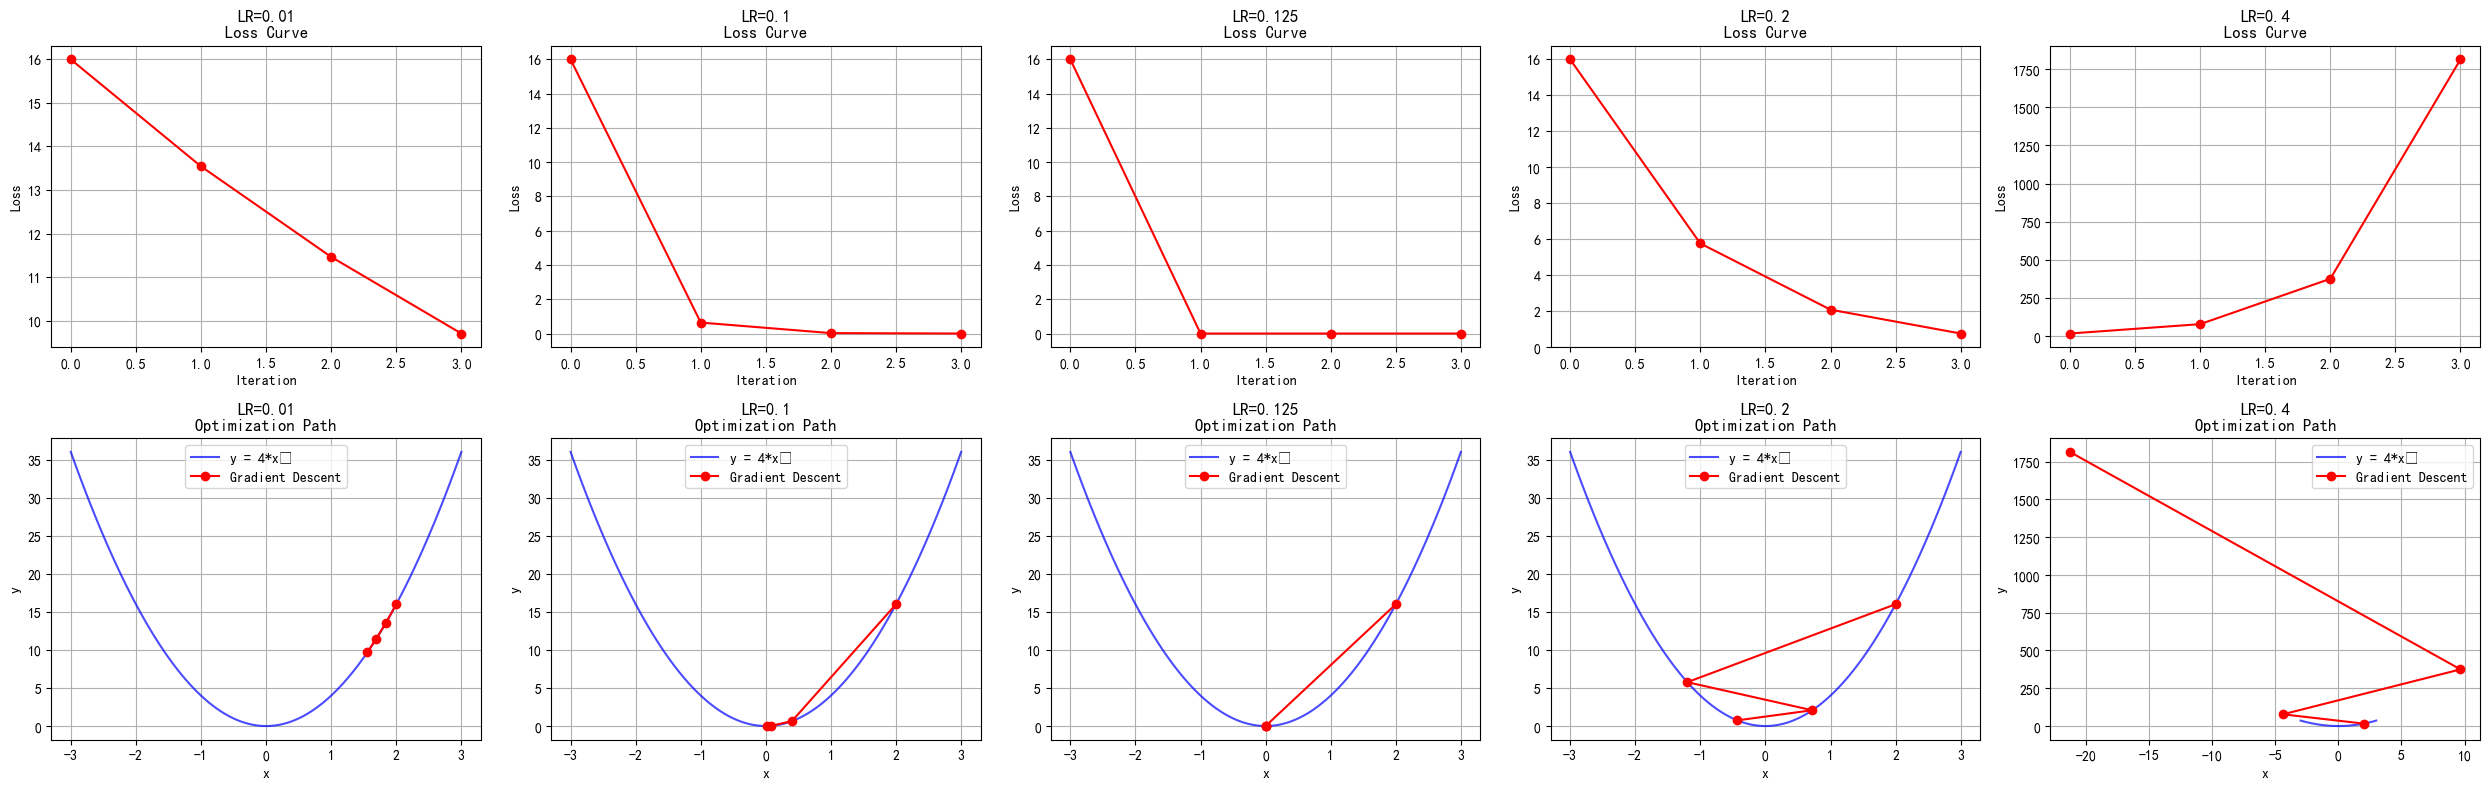
可以看出:采用较小的学习率,梯度下降的速度慢;采用较大的学习率,梯度下降太快越过了最小值点,导致震荡,甚至不收敛(梯度爆炸)。
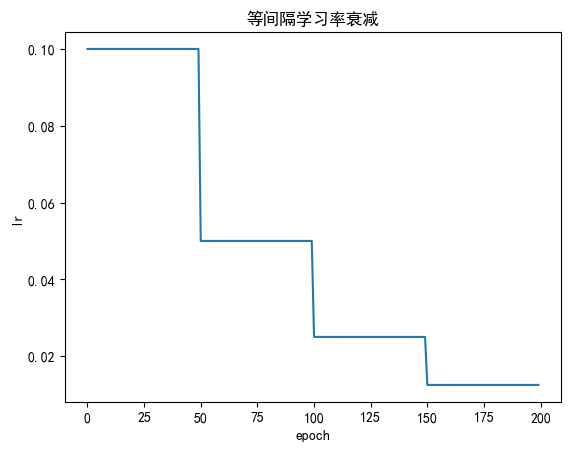
等间隔学习率衰减 optim.lr_scheduler.StepLR
固定步长衰减
# 定义函数,演示 等间隔学习率衰减
def demo01():
    # 1.定义变量,记录初始的 学习率,总训练轮数,每轮的批次数
    lr = 0.1
    epochs = 200
    iteration = 10
    # 2.创建数据集,y_true, x, w
    y_true = torch.tensor([0], dtype=torch.float32)
    # 输入特征
    x = torch.tensor([1.0], dtype=torch.float32)
    # 权重w,需要开启自动微分
    w = torch.tensor([1.0], requires_grad=True, dtype=torch.float32)

    # 3.创建优化器,动量法Momentum
    # 参数1:待优化的模型参数,参数2:学习率,参数3:动量系数
    optimizer = optim.SGD([w], lr=lr, momentum=0.9)

    # 4.创建学习率衰减策略的对象
    scheduler = optim.lr_scheduler.StepLR(optimizer, step_size=50, gamma=0.5)   # [0.1, 0.05, 0.025, 0.0125, ...]

    # 5.记录 训练轮数 和 每轮训练用的学习率
    lr_list = []
    epoch_list = []
    # 6.遍历训练轮数
    for epoch in range(epochs):
        # 7.获取 当前轮数 和 学习率,保存到记录列表中
        epoch_list.append(epoch)
        lr_list.append(scheduler.get_last_lr()[0])
        # 8.遍历批次,开始训练
        for batch in range(iteration):
            # 9.前向传播,计算预测值
            y_pred = w * x
            # 10.计算损失值, 平方差
            loss = (y_pred - y_true) ** 2
            # 11.梯度清零
            optimizer.zero_grad()
            # 12.反向传播
            loss.mean().backward()
            # 13.更新参数
            optimizer.step()

        # 14.更新学习率
        scheduler.step()

    # 15.打印结果
    print(f"lr_list: {lr_list}")
    # 16.绘制 学习率lr-轮数epoch 折线图
    plt.plot(epoch_list, lr_list)
    plt.xlabel("epoch")
    plt.ylabel("lr")
    plt.title("等间隔学习率衰减")
    plt.show()

demo01()
lr_list: [0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125]
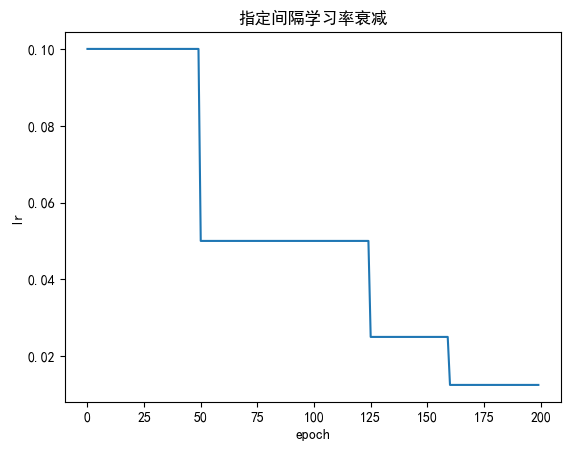
指定间隔学习率衰减 optim.lr_scheduler.MultiStepLR
指定步长衰减
# 定义函数,演示 指定间隔学习率衰减
def demo02():
    # 1.定义变量,记录初始的 学习率,总训练轮数,每轮的批次数
    lr = 0.1
    epochs = 200
    iteration = 10
    # 2.创建数据集,y_true, x, w
    y_true = torch.tensor([0], dtype=torch.float32)
    # 输入特征
    x = torch.tensor([1.0], dtype=torch.float32)
    # 权重w,需要开启自动微分
    w = torch.tensor([1.0], requires_grad=True, dtype=torch.float32)

    # 3.创建优化器,动量法Momentum
    # 参数1:待优化的模型参数,参数2:学习率,参数3:动量系数
    optimizer = optim.SGD([w], lr=lr, momentum=0.9)

    # 4.创建学习率衰减策略的对象
    # 思路1:等间隔学习率衰减策略
    # scheduler = optim.lr_scheduler.StepLR(optimizer, step_size=50, gamma=0.5)   # [0.1, 0.05, 0.025, 0.0125, ...]
    # 思路2:指定间隔学习率衰减策略
    milestones = [50, 125, 160]
    scheduler = optim.lr_scheduler.MultiStepLR(optimizer, milestones=milestones, gamma=0.5)
    # 5.记录 训练轮数 和 每轮训练用的学习率
    lr_list = []
    epoch_list = []
    # 6.遍历训练轮数
    for epoch in range(epochs):
        # 7.获取 当前轮数 和 学习率,保存到记录列表中
        epoch_list.append(epoch)
        lr_list.append(scheduler.get_last_lr()[0])
        # 8.遍历批次,开始训练
        for batch in range(iteration):
            # 9.前向传播,计算预测值
            y_pred = w * x
            # 10.计算损失值, 平方差
            loss = (y_pred - y_true) ** 2
            # 11.梯度清零
            optimizer.zero_grad()
            # 12.反向传播
            loss.mean().backward()
            # 13.更新参数
            optimizer.step()

        # 14.更新学习率
        scheduler.step()

    # 15.打印结果
    print(f"lr_list: {lr_list}")
    # 16.绘制 学习率lr-轮数epoch 折线图
    plt.plot(epoch_list, lr_list)
    plt.xlabel("epoch")
    plt.ylabel("lr")
    plt.title("指定间隔学习率衰减")
    plt.show()

demo02()
lr_list: [0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.05, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.025, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125, 0.0125]
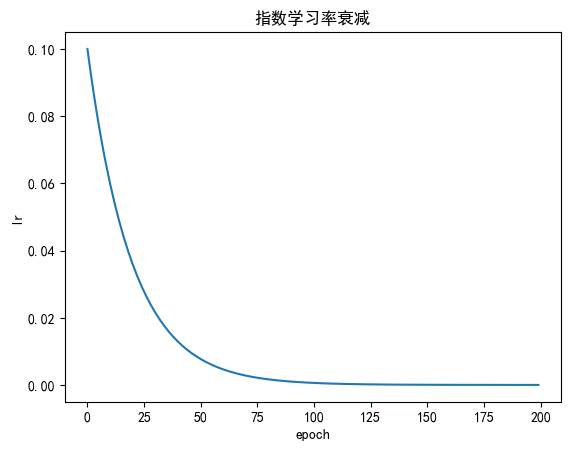
指数学习率衰减 optim.lr_scheduler.ExponentialLR
按照指数衰减,本轮的学习率 = 上一轮的学习率 * 衰减系数
# 定义函数,演示 指数学习率衰减
def demo03():
    # 1.定义变量,记录初始的 学习率,总训练轮数,每轮的批次数
    lr = 0.1
    epochs = 200
    iteration = 10
    # 2.创建数据集,y_true, x, w
    y_true = torch.tensor([0], dtype=torch.float32)
    # 输入特征
    x = torch.tensor([1.0], dtype=torch.float32)
    # 权重w,需要开启自动微分
    w = torch.tensor([1.0], requires_grad=True, dtype=torch.float32)

    # 3.创建优化器,动量法Momentum
    # 参数1:待优化的模型参数,参数2:学习率,参数3:动量系数
    optimizer = optim.SGD([w], lr=lr, momentum=0.9)

    # 4.创建学习率衰减策略的对象
    # 思路1:等间隔学习率衰减策略
    # scheduler = optim.lr_scheduler.StepLR(optimizer, step_size=50, gamma=0.5)   # [0.1, 0.05, 0.025, 0.0125, ...]
    # 思路2:指定间隔学习率衰减策略
    # milestones = [50, 125, 160]
    # scheduler = optim.lr_scheduler.MultiStepLR(optimizer, milestones=milestones, gamma=0.5)
    # 思路3:指数学习率衰减策略
    # 参数1:优化器对象,参数2:衰减因子
    scheduler = optim.lr_scheduler.ExponentialLR(optimizer, gamma=0.95)

    # 5.记录 训练轮数 和 每轮训练用的学习率
    lr_list = []
    epoch_list = []
    # 6.遍历训练轮数
    for epoch in range(epochs):
        # 7.获取 当前轮数 和 学习率,保存到记录列表中
        epoch_list.append(epoch)
        lr_list.append(scheduler.get_last_lr()[0])
        # 8.遍历批次,开始训练
        for batch in range(iteration):
            # 9.前向传播,计算预测值
            y_pred = w * x
            # 10.计算损失值, 平方差
            loss = (y_pred - y_true) ** 2
            # 11.梯度清零
            optimizer.zero_grad()
            # 12.反向传播
            loss.mean().backward()
            # 13.更新参数
            optimizer.step()

        # 14.更新学习率
        scheduler.step()

    # 15.打印结果
    print(f"lr_list: {lr_list}")
    # 16.绘制 学习率lr-轮数epoch 折线图
    plt.plot(epoch_list, lr_list)
    plt.xlabel("epoch")
    plt.ylabel("lr")
    plt.title("指数学习率衰减")
    plt.show()

demo03()
lr_list: [0.1, 0.095, 0.09025, 0.0857375, 0.08145062499999998, 0.07737809374999999, 0.07350918906249998, 0.06983372960937498, 0.06634204312890622, 0.0630249409724609, 0.05987369392383786, 0.05688000922764597, 0.05403600876626367, 0.05133420832795048, 0.04876749791155295, 0.046329123015975304, 0.04401266686517654, 0.04181203352191771, 0.039721431845821824, 0.037735360253530734, 0.035848592240854196, 0.03405616262881148, 0.03235335449737091, 0.030735686772502362, 0.029198902433877242, 0.027738957312183378, 0.026352009446574207, 0.025034408974245494, 0.023782688525533217, 0.022593554099256556, 0.021463876394293726, 0.020390682574579037, 0.019371148445850084, 0.01840259102355758, 0.0174824614723797, 0.016608338398760712, 0.015777921478822676, 0.014989025404881541, 0.014239574134637464, 0.01352759542790559, 0.012851215656510309, 0.012208654873684792, 0.011598222130000552, 0.011018311023500524, 0.010467395472325497, 0.009944025698709221, 0.00944682441377376, 0.00897448319308507, 0.008525759033430816, 0.008099471081759275, 0.007694497527671311, 0.007309772651287745, 0.006944284018723357, 0.006597069817787189, 0.006267216326897829, 0.005953855510552938, 0.005656162735025291, 0.005373354598274026, 0.005104686868360324, 0.004849452524942308, 0.004606979898695193, 0.004376630903760433, 0.0041577993585724116, 0.0039499093906437905, 0.0037524139211116006, 0.0035647932250560204, 0.003386553563803219, 0.003217225885613058, 0.0030563645913324047, 0.0029035463617657843, 0.002758369043677495, 0.00262045059149362, 0.002489428061918939, 0.002364956658822992, 0.002246708825881842, 0.00213437338458775, 0.0020276547153583622, 0.001926271979590444, 0.0018299583806109217, 0.0017384604615803755, 0.0016515374385013568, 0.0015689605665762888, 0.0014905125382474742, 0.0014159869113351004, 0.0013451875657683454, 0.001277928187479928, 0.0012140317781059316, 0.001153330189200635, 0.0010956636797406032, 0.001040880495753573, 0.0009888364709658944, 0.0009393946474175996, 0.0008924249150467197, 0.0008478036692943836, 0.0008054134858296644, 0.0007651428115381812, 0.000726885670961272, 0.0006905413874132084, 0.0006560143180425479, 0.0006232136021404205, 0.0005920529220333994, 0.0005624502759317294, 0.0005343277621351429, 0.0005076113740283857, 0.00048223080532696635, 0.00045811926506061804, 0.0004352133018075871, 0.00041345263671720774, 0.00039278000488134735, 0.00037314100463728, 0.000354483954405416, 0.00033675975668514516, 0.0003199217688508879, 0.00030392568040834347, 0.0002887293963879263, 0.00027429292656852995, 0.00026057828024010345, 0.00024754936622809826, 0.00023517189791669334, 0.00022341330302085867, 0.00021224263786981574, 0.00020163050597632494, 0.0001915489806775087, 0.00018197153164363326, 0.0001728729550614516, 0.00016422930730837902, 0.00015601784194296006, 0.00014821694984581206, 0.00014080610235352146, 0.0001337657972358454, 0.0001270775073740531, 0.00012072363200535044, 0.00011468745040508291, 0.00010895307788482875, 0.00010350542399058731, 9.833015279105794e-05, 9.341364515150504e-05, 8.874296289392978e-05, 8.430581474923329e-05, 8.009052401177162e-05, 7.608599781118304e-05, 7.228169792062389e-05, 6.866761302459269e-05, 6.523423237336306e-05, 6.19725207546949e-05, 5.8873894716960144e-05, 5.5930199981112136e-05, 5.3133689982056524e-05, 5.0477005482953695e-05, 4.7953155208806006e-05, 4.55554974483657e-05, 4.327772257594741e-05, 4.111383644715004e-05, 3.9058144624792534e-05, 3.7105237393552906e-05, 3.524997552387526e-05, 3.34874767476815e-05, 3.1813102910297426e-05, 3.0222447764782554e-05, 2.8711325376543424e-05, 2.727575910771625e-05, 2.5911971152330435e-05, 2.461637259471391e-05, 2.3385553964978216e-05, 2.2216276266729303e-05, 2.1105462453392836e-05, 2.0050189330723194e-05, 1.9047679864187035e-05, 1.8095295870977683e-05, 1.71905310774288e-05, 1.6331004523557357e-05, 1.5514454297379488e-05, 1.4738731582510512e-05, 1.4001795003384986e-05, 1.3301705253215736e-05, 1.2636619990554949e-05, 1.2004788991027201e-05, 1.140454954147584e-05, 1.0834322064402047e-05, 1.0292605961181944e-05, 9.777975663122847e-06, 9.289076879966705e-06, 8.82462303596837e-06, 8.38339188416995e-06, 7.964222289961452e-06, 7.566011175463379e-06, 7.18771061669021e-06, 6.8283250858556995e-06, 6.4869088315629144e-06, 6.162563389984768e-06, 5.85443522048553e-06, 5.561713459461253e-06, 5.28362778648819e-06, 5.019446397163781e-06, 4.768474077305592e-06, 4.530050373440312e-06, 4.303547854768296e-06, 4.088370462029881e-06, 3.883951938928387e-06, 3.689754341981967e-06]
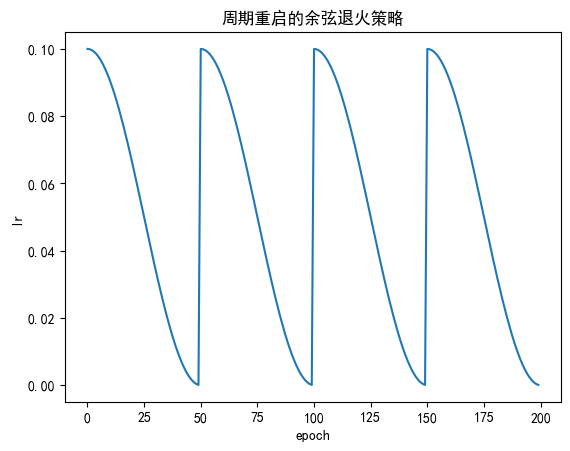
余弦退火学习率调度策略
- torch.optim.lr_scheduler.CosineAnnealingLR(optimizer, T_0, T_mult=1, eta_min=0, last_epoch=-1)
- torch.optim.lr_scheduler.CosineAnnealingWarmRestarts(optimizer, T_0, T_mult=1, eta_min=0, last_epoch=-1)
余弦退火(Cosine Annealing)学习率调度公式:
其中:
- \(\eta_t\) :第 \(t\) 步的学习率
- \(\eta_{\min}\) :最小学习率
- \(\eta_{\max}\) :初始/最大学习率
- \(T_{\max}\) :一个周期的总步数
- \(t\) :当前步数(或 epoch 数),\(0 \le t \le T_{\max}\)
# 演示 周期重启的余弦退火策略

# 导包
import torch
import torch.nn as nn
import torch.optim as optim
import numpy as np
import matplotlib.pyplot as plt
# 设置中文字体
plt.rcParams['font.sans-serif'] = ['SimHei']  # 微软雅黑
plt.rcParams['axes.unicode_minus'] = False            # 解决负号显示问题
# 设置设备
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")

# 1.定义变量,记录初始的 学习率,总训练轮数,每轮的批次数
lr = 0.1
epochs = 200
iteration = 10
# 2.创建数据集,y_true, x, w
y_true = torch.tensor([0], dtype=torch.float32)
# 输入特征
x = torch.tensor([1.0], dtype=torch.float32)
# 权重w,需要开启自动微分
w = torch.tensor([1.0], requires_grad=True, dtype=torch.float32)

# 3.创建优化器,动量法Momentum
# 参数1:待优化的模型参数,参数2:学习率,参数3:动量系数
optimizer = optim.SGD([w], lr=lr, momentum=0.9)

# 4.创建学习率衰减策略的对象
# T_0=50:第一个周期长度为50 epoch
# T_mult=1:周期增大的倍数(1 表示始终50 epoch;2 表示第一个周期为100,第二个周期为200)
# eta_min=0:学习率最小值
# last_epoch=-1:初始轮数,-1 表示从0开始
scheduler = optim.lr_scheduler.CosineAnnealingWarmRestarts(
    optimizer,
    T_0=50,        # 核心:第一个周期的长度
    T_mult=1,      # 周期增大的倍数
    eta_min=0,      # 学习率最小值
)
# 5.记录 训练轮数 和 每轮训练用的学习率
lr_list = []
epoch_list = []
# 6.遍历训练轮数
for epoch in range(epochs):
    # 7.获取 当前轮数 和 学习率,保存到记录列表中
    epoch_list.append(epoch)
    lr_list.append(scheduler.get_last_lr()[0])
    # 8.遍历批次,开始训练
    for batch in range(iteration):
        # 9.前向传播,计算预测值
        y_pred = w * x
        # 10.计算损失值, 平方差
        loss = (y_pred - y_true) ** 2
        # 11.梯度清零
        optimizer.zero_grad()
        # 12.反向传播
        loss.mean().backward()
        # 13.更新参数
        optimizer.step()

    # 14.更新学习率
    scheduler.step()

# 15.打印结果
print(f"lr_list: {lr_list}")
# 16.绘制 学习率lr-轮数epoch 折线图
# plt.figure(figsize=(10, 5))
plt.plot(epoch_list, lr_list)
plt.xlabel("epoch")
plt.ylabel("lr")
# plt.grid()
plt.title("周期重启的余弦退火策略")
plt.show()
lr_list: [0.1, 0.09990133642141358, 0.0996057350657239, 0.09911436253643445, 0.09842915805643156, 0.09755282581475769, 0.09648882429441258, 0.09524135262330098, 0.09381533400219318, 0.09221639627510075, 0.09045084971874738, 0.08852566213878947, 0.08644843137107058, 0.08422735529643444, 0.08187119948743449, 0.07938926261462367, 0.07679133974894983, 0.07408768370508577, 0.07128896457825364, 0.06840622763423392, 0.06545084971874737, 0.062434494358242734, 0.05936906572928624, 0.05626666167821523, 0.05313952597646568, 0.05, 0.04686047402353433, 0.0437333383217848, 0.04063093427071377, 0.03756550564175726, 0.03454915028125265, 0.03159377236576612, 0.02871103542174637, 0.02591231629491423, 0.02320866025105016, 0.02061073738537635, 0.018128800512565515, 0.015772644703565566, 0.013551568628929435, 0.011474337861210543, 0.009549150281252633, 0.007783603724899258, 0.006184665997806821, 0.004758647376699033, 0.0035111757055874327, 0.0024471741852423235, 0.0015708419435684518, 0.000885637463565564, 0.0003942649342761118, 9.866357858642206e-05, 0.1, 0.09990133642141358, 0.0996057350657239, 0.09911436253643445, 0.09842915805643156, 0.09755282581475769, 0.09648882429441258, 0.09524135262330098, 0.09381533400219318, 0.09221639627510075, 0.09045084971874738, 0.08852566213878947, 0.08644843137107058, 0.08422735529643444, 0.08187119948743449, 0.07938926261462367, 0.07679133974894983, 0.07408768370508577, 0.07128896457825364, 0.06840622763423392, 0.06545084971874737, 0.062434494358242734, 0.05936906572928624, 0.05626666167821523, 0.05313952597646568, 0.05, 0.04686047402353433, 0.0437333383217848, 0.04063093427071377, 0.03756550564175726, 0.03454915028125265, 0.03159377236576612, 0.02871103542174637, 0.02591231629491423, 0.02320866025105016, 0.02061073738537635, 0.018128800512565515, 0.015772644703565566, 0.013551568628929435, 0.011474337861210543, 0.009549150281252633, 0.007783603724899258, 0.006184665997806821, 0.004758647376699033, 0.0035111757055874327, 0.0024471741852423235, 0.0015708419435684518, 0.000885637463565564, 0.0003942649342761118, 9.866357858642206e-05, 0.1, 0.09990133642141358, 0.0996057350657239, 0.09911436253643445, 0.09842915805643156, 0.09755282581475769, 0.09648882429441258, 0.09524135262330098, 0.09381533400219318, 0.09221639627510075, 0.09045084971874738, 0.08852566213878947, 0.08644843137107058, 0.08422735529643444, 0.08187119948743449, 0.07938926261462367, 0.07679133974894983, 0.07408768370508577, 0.07128896457825364, 0.06840622763423392, 0.06545084971874737, 0.062434494358242734, 0.05936906572928624, 0.05626666167821523, 0.05313952597646568, 0.05, 0.04686047402353433, 0.0437333383217848, 0.04063093427071377, 0.03756550564175726, 0.03454915028125265, 0.03159377236576612, 0.02871103542174637, 0.02591231629491423, 0.02320866025105016, 0.02061073738537635, 0.018128800512565515, 0.015772644703565566, 0.013551568628929435, 0.011474337861210543, 0.009549150281252633, 0.007783603724899258, 0.006184665997806821, 0.004758647376699033, 0.0035111757055874327, 0.0024471741852423235, 0.0015708419435684518, 0.000885637463565564, 0.0003942649342761118, 9.866357858642206e-05, 0.1, 0.09990133642141358, 0.0996057350657239, 0.09911436253643445, 0.09842915805643156, 0.09755282581475769, 0.09648882429441258, 0.09524135262330098, 0.09381533400219318, 0.09221639627510075, 0.09045084971874738, 0.08852566213878947, 0.08644843137107058, 0.08422735529643444, 0.08187119948743449, 0.07938926261462367, 0.07679133974894983, 0.07408768370508577, 0.07128896457825364, 0.06840622763423392, 0.06545084971874737, 0.062434494358242734, 0.05936906572928624, 0.05626666167821523, 0.05313952597646568, 0.05, 0.04686047402353433, 0.0437333383217848, 0.04063093427071377, 0.03756550564175726, 0.03454915028125265, 0.03159377236576612, 0.02871103542174637, 0.02591231629491423, 0.02320866025105016, 0.02061073738537635, 0.018128800512565515, 0.015772644703565566, 0.013551568628929435, 0.011474337861210543, 0.009549150281252633, 0.007783603724899258, 0.006184665997806821, 0.004758647376699033, 0.0035111757055874327, 0.0024471741852423235, 0.0015708419435684518, 0.000885637463565564, 0.0003942649342761118, 9.866357858642206e-05]
| 方法 | 衰减方式 | 适用场景 | PyTorch API |
|---|---|---|---|
| 等间隔衰减 (Step Decay) | 固定步长衰减 | 大型数据集、简单任务 | torch.optim.lr_scheduler.StepLR |
| 指定间隔衰减 (MultiStep Decay) | 指定间隔衰减 | 需分段调整学习率的任务 | torch.optim.lr_scheduler.MultiStepLR |
| 指数衰减 (Exponential Decay) | 指数比例衰减 | 对训练平稳性要求高的任务 | torch.optim.lr_scheduler.ExponentialLR |
| 周期重启的余弦退火 (Cosine Annealing Warm Restarts) | 周期性余弦下降并重启 | 复杂非凸优化、易陷局部极小值的任务 | torch.optim.lr_scheduler.CosineAnnealingWarmRestarts |
3.正则化方法
什么是正则化
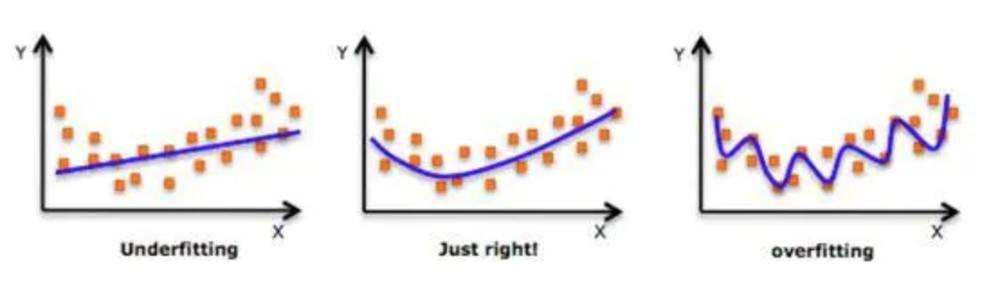
- 在设计机器学习算法时希望在新样本上的泛化能力强。许多机器学习算法都采用相关的策略来减小测试误差,这些策略被统称为正则化
- 神经网络强大的表示能力经常遇到过拟合,所以需要使用不同形式的正则化策略
- 目前在深度学习中使用较多的策略有范数惩罚,DropOut,特殊的网络层等,接下来我们对其进行详细的介绍
L1与L2正则化
L1和L2正则化通过在损失函数上添加惩罚项来实现。
| 内容 | L1 正则化(Lasso) | L2 正则化(Ridge / 权重衰减) |
|---|---|---|
| 公式 | \(loss = loss + λ \sum \|w\|\) | \(loss = loss + \frac{λ}{2} \sum w^2\) |
| 核心特点 | 稀疏解、特征选择、鲁棒性强 | 权重衰减、平滑解、稳定性高 |
| 适用场景 | 高维特征选择、模型压缩 | 深度学习防过拟合、数值稳定 |
Dropout正则化
在训练深层神经网络时,由于模型参数较多,在数据量不足的情况下,很容易过拟合。Dropout 随机失活 是一个简单有效的正则化方法。
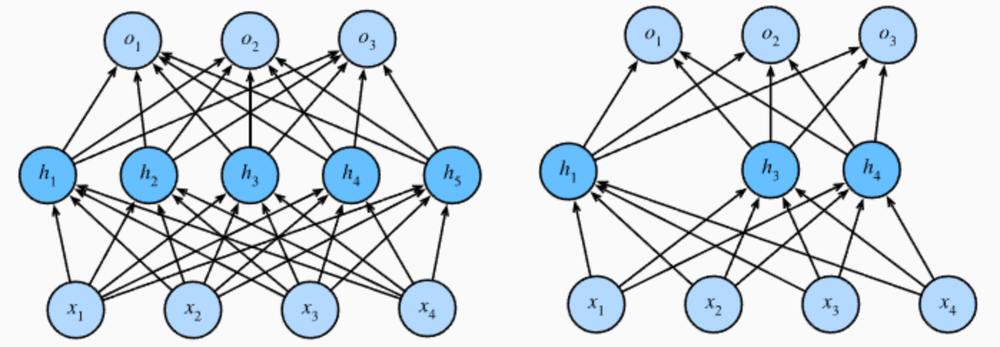
- 在训练过程中,Dropout的实现是让神经元以超参数p(丢弃概率)的概率停止工作或者激活被置为0,未被置为0的进行缩放,缩放比例为1/(1-p)。训练过程可以认为是对完整的神经网络的一些子集进行训练,每次只更新子网络的参数
- 在实际应用中,Dropout参数丢弃概率p通常取值在0.2到0.5之间
- 对于较小的模型或较复杂的任务,丢弃概率p可以选择0.3或更小
- 对于非常深的网络,较大的丢弃概率p(如0.5或0.6)可能会有效防止过拟合
- 实际应用中,通常会在全连接层(激活函数后)之后添加Dropout层
- 在测试过程中,随机失活不起作用
- 在测试阶段,使用所有的神经元进行预测,以获得更稳定的结果
- 直接使用训练好的模型进行测试,由于所有的神经元都参与计算,输出的期望值会比训练阶段高。测试阶段的期望输出是 E[x_test] = x
- 测试/推理模式:==model.eval()==
- 缩放的必要性
- 在训练阶段,将参与计算的神经元的输出除以(1-p)
- 经过Dropout后的期望输出变为 E[x_dropout] = [(1-p) * x] / (1-p) = x,与测试阶段的期望输出一致
- 训练模型:==model.train()==
# 1.创建输入数据
t1 = torch.randint(0,10,size=(1,4))
# 转换为float类型
t1 = t1.to(dtype=torch.float32)
print(f"输入特征t1: {t1}")
# 2.进行下一层 加权求和 和 激活函数计算
linear1 = nn.Linear(4,10)
# 输入linear1,进行加权求和
t2 = linear1(t1)
print(f"linear1输出t2: {t2}")
# 激活函数
t3 = torch.relu(t2)
print(f"激活函数输出t3: {t3}")
# 3.对激活函数的输出t3 进行dropout随机失活
dropout = nn.Dropout(p=0.5)
# 输入dropout
t4 = dropout(t3)
print(f"dropout输出t4: {t4}")
输入特征t1: tensor([[9., 8., 1., 6.]])
linear1输出t2: tensor([[ 0.4872, -4.8918,  1.5698,  7.4191, -0.4140, -2.0614,  3.9062, -1.5255,
         -2.3680, -8.5525]], grad_fn=<AddmmBackward0>)
激活函数输出t3: tensor([[0.4872, 0.0000, 1.5698, 7.4191, 0.0000, 0.0000, 3.9062, 0.0000, 0.0000,
         0.0000]], grad_fn=<ReluBackward0>)
dropout输出t4: tensor([[0.0000, 0.0000, 0.0000, 0.0000, 0.0000, 0.0000, 7.8123, 0.0000, 0.0000,
         0.0000]], grad_fn=<MulBackward0>)
批量归一正则化(Batch Normalization)
在神经网络的训练过程中,流经网络的数据都是一个batch,每个batch之间的数据分布变化非常剧烈,==这就使得网络参数频繁的进行大的调整以适应流经网络的不同分布的数据==,给模型训练带来非常大的不稳定性,使得模型难以收敛。如果我们对每一个batch的数据进行标准化之后,数据分布就变得稳定,参数的梯度变化也变得稳定,有助于加快模型的收敛。
通过标准化每一层的输入,使其均值接近0,方差接近1,从而加速训练并提高泛化能力。
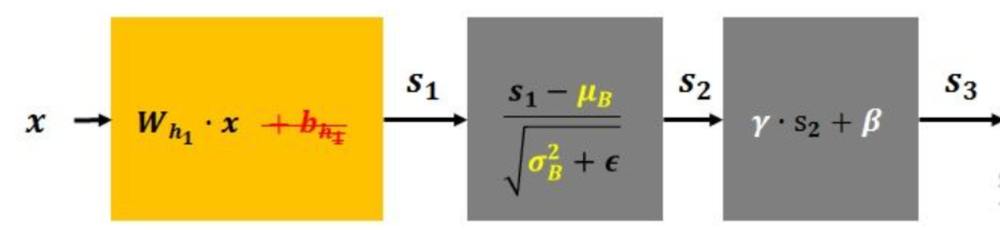
先对数据标准化,再对数据重构(缩放+平移),写成公式如下所示:
$$
f(x) = \lambda \cdot \frac{x - \mathbb{E}(x)}{\sqrt{\mathrm{Var}(x)} + \epsilon} + \beta
$$
λ和β是可学习的参数,它相当于对标准化后的值做了一个线性变换,λ为系数,β为偏置;
eps 通常指为 1e-5,避免分母为 0;
E(x) 表示变量的均值;
Var(x) 表示变量的方差;
批量归一化的步骤如下:
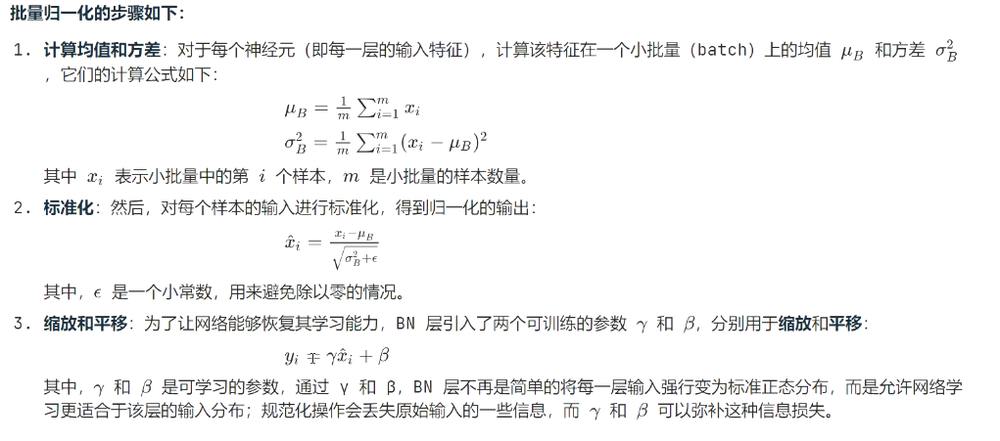
批量归一化的作用:
-
减少内部协方差偏移: 通过对每层的输入进行标准化,减少了输入数据分布的变化,从而加速了训练过程,并使得网络在训练过程中更加稳定。
-
加速训练:
- 在没有批量归一化的情况下,神经网络的训练通常会很慢,尤其是深度网络。因为在每层的训练过程中,输入数据的分布(特别是前几层)会不断变化,这会导致网络学习速度缓慢。
-
批量归一化通过确保每层的输入数据在训练时分布稳定,有效减少了这种变化,从而加速了训练过程。
-
起到正则化作用: 批量归一化可以视作一种正则化方法,因为它引入了对训练样本的噪声(不同批次的统计信息不同,批次较小的均值和方差估计会更加不准确),使得模型不容易依赖特定的输入特征,从而起到一定的正则化效果,减少了对其他正则化技术(如Dropout)的需求。
-
提升泛化能力: 由于其正则化效果,批量归一化能帮助网络在测试集上取得更好的性能。
==批量归一化层在计算机视觉领域使用较多==
Batch Normalization 的使用步骤:
- 在网络层后添加 BN 层:
- 通常,BN 层会添加在卷积层 (Conv2d) 或全连接层 (Linear) 之后,激活函数之前。
- 例如:Conv2d -> BN -> ReLU 或者 Linear -> BN -> ReLU。 - 训练时: ==model.train()==
- BN 层会计算当前批次的均值 \(μ\) 和方差 \(σ²\)。
- 然后,利用这两个统计量对当前批次的数据进行规范化。
- 规范化后的数据会被缩放 \(γ\) 和平移 \(β\)。
- 同时,BN 层还会维护一个全局均值和全局方差的移动平均值,用于推理阶段。 - 推理时: ==model.eval()==
- 推理时,不会再使用当前批次的均值和方差,而是使用训练阶段计算的全局均值和全局方差。
- 同样,规范化后的数据会被缩放 \(γ\) 和平移 \(β\)。
"""
案例:
    演示 批量归一化,属于正则化方法,缓解 模型过拟合
批量归一化:
    先标准化为均值0,方差1的分布, 再进行 缩放(✖λ) 和 平移(➕β), 数据分布(均值β, 标准差λ),找回一些数据信息
应用场景:
    计算机视觉领域应用较多
    BatchNorm1d:处理2D/3D数据, 主要应用于全连接层或处理一维数据的网络,例如文本处理。它接收形状为 (N, num_features) 的张量作为输入。
    BatchNorm2d:处理4D数据, 为主要应用于卷积神经网络,处理二维图像数据或特征图。它接收形状为 (N, C, H, W) 的张量作为输入。
    图片数据CHW,输入到CNN里面,需要转换为NCHW格式,批次大小N,通道C,高度H,宽度W
    BatchNorm3d:处理5D数据, 主要用于三维卷积神经网络 (3D CNN),处理三维数据,例如视频或医学图像。它接收形状为 (N, C, D, H, W) 的张量作为输入。

"""

# 导包
import torch
import torch.nn as nn

# 定义函数,演示 BatchNorm2d 批量归一化, 处理4D数据
def demo01():
    # 1.创建图像样本数据
    # 批次大小1,通道数2,高度3,宽度4
    input_2d = torch.rand(size=(1,2,3,4))
    print(f"input_2d: {input_2d}, shape: {input_2d.shape}")

    # 2.创建 BatchNorm2d 层
    # 参数1:输入特征数,也就是通道数;参数2:极小值;参数4:是否启用可学习的缩放和平移参数
    # 参数3:用于计算运行统计量的动量参数
    # running_mean = (1 - momentum) * running_mean + momentum * batch_mean
    # running_var = (1 - momentum) * running_var + momentum * batch_var
    bn_2d = nn.BatchNorm2d(num_features=2, eps=1e-5, momentum=0.1, affine=True)

    # 3.输入数据 到 BatchNorm2d层
    output = bn_2d(input_2d)

    # 4.打印BatchNorm2d层输出
    print(f"output: {output}, shape: {output.shape}")

# 定义函数,演示 BatchNorm1d 批量归一化, 处理3D/2D数据
def demo02():
    # 1.创建样本数据
    # 批次大小1,通道数2,长度3
    input_1d = torch.rand(size=(1,2,3))
    print(f"input_1d: {input_1d}, shape: {input_1d.shape}")

    # 2.创建 BatchNorm2d 层
    # 参数1:输入特征数,也就是通道数;参数2:极小值;参数4:是否启用可学习的缩放和平移参数
    # 参数3:用于计算运行统计量的动量参数
    # running_mean = (1 - momentum) * running_mean + momentum * batch_mean
    # running_var = (1 - momentum) * running_var + momentum * batch_var
    # bn_2d = nn.BatchNorm2d(num_features=2, eps=1e-5, momentum=0.1, affine=True)
    # 创建 BatchNorm1d 层
    bn_1d = nn.BatchNorm1d(num_features=2, eps=1e-5, momentum=0.1, affine=True)

    # 3.输入数据 到 BatchNorm2d层
    output = bn_1d(input_1d)

    # 4.打印BatchNorm2d层输出
    print(f"output: {output}, shape: {output.shape}")
# 测试
if __name__ == "__main__":
    demo01()
    demo02()
input_2d: tensor([[[[0.3020, 0.4624, 0.2669, 0.6466],
          [0.4142, 0.2483, 0.6573, 0.9378],
          [0.1171, 0.7750, 0.9441, 0.3912]],

         [[0.1435, 0.9811, 0.7332, 0.5805],
          [0.1117, 0.3462, 0.6789, 0.6437],
          [0.4877, 0.6269, 0.6914, 0.9162]]]]), shape: torch.Size([1, 2, 3, 4])
output: tensor([[[[-0.8033, -0.1941, -0.9364,  0.5049],
          [-0.3774, -1.0070,  0.5457,  1.6102],
          [-1.5049,  0.9925,  1.6343, -0.4644]],

         [[-1.6857,  1.5606,  0.6000,  0.0080],
          [-1.8087, -0.8999,  0.3894,  0.2530],
          [-0.3516,  0.1878,  0.4379,  1.3090]]]],
       grad_fn=<NativeBatchNormBackward0>), shape: torch.Size([1, 2, 3, 4])
input_1d: tensor([[[0.8270, 0.7527, 0.6871],
         [0.4526, 0.0340, 0.1730]]]), shape: torch.Size([1, 2, 3])
output: tensor([[[ 1.2475, -0.0509, -1.1967],
         [ 1.3367, -1.0676, -0.2691]]], grad_fn=<NativeBatchNormBackward0>), shape: torch.Size([1, 2, 3])
4. ANN手机价格分类案例
小明创办了一家手机公司,他不知道如何估算手机产品的价格。为了解决这个问题,他收集了多家公司的手机销售数据。该数据为二手手机的各个性能的数据,最后根据这些性能得到4个价格区间,作为这些二手手机售出的价格区间。主要包括:
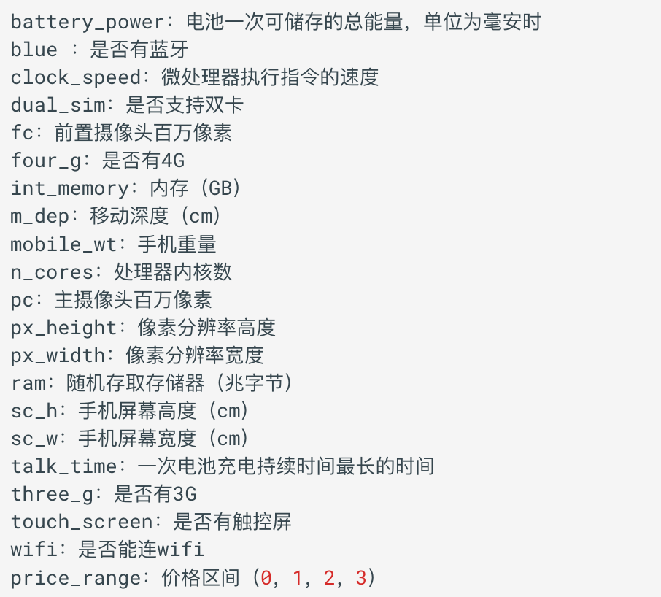
我们需要帮助小明找出手机的功能 与 其售价 之间的某种关系。可以使用机器学习的方法,也可以构建一个全连接的神经网络。
需要注意的是: 在这个问题中,不需要预测实际价格,而是预测一个价格范围,使用 0、1、2、3 来表示,所以该问题是一个分类问题。
神经网络训练的一般工作流:
- 1.准备数据集
- 2.搭建神经网络模型
- 3.模型训练
1. 前向传播:\(y\_pred = model(X)\)
2. 计算损失:\(loss = loss\_fn(y\_pred, y)\)
3. 梯度清零:\(optimizer.zero\_grad()\)
4. 反向传播:\(loss.backward()\)
5. 更新参数:\(optimizer.step()\)
- 4.模型测试
import torch                                                # pytorch框架
from torch.utils.data import TensorDataset                  # 数据集对象
from torch.utils.data import DataLoader                     # 数据加载器
import torch.nn as nn                                       # 神经网络层的操作
import torch.optim as optim                                 # 优化器
from sklearn.model_selection import train_test_split        # 拆分 训练集 和 测试集
import matplotlib.pyplot as plt                             # 绘图
import numpy as np                                          # 数组操作
import pandas as pd                                         # 数据处理
import time                                                 # 时间模块

from torchsummary import summary

device = "cuda" if torch.cuda.is_available() else "cpu"
# 1.准备数据集
def create_dataset():
    # 1.加载CSV数据集
    data = pd.read_csv("./data/手机价格预测.csv")
    # 2.获取特征x 和 标签y
    x = data.iloc[:, :-1]
    y = data.iloc[:, -1]
    # print(f"x: {x.head()}")
    # print(f"y: {y.head()}")
    # 3.特征列 转换为 float
    x = x.astype(np.float32)
    # print(f"x: {x}")

    # 4.拆分数据集
    x_train, x_test, y_train, y_test = train_test_split(x, y, test_size=0.2, random_state=6, stratify=y)

    # 5.把数据集转换为张量, numpy数组 -> 张量 -> 数据集对象TensorDataset -> 数据加载器DataLoader
    train_dataset = TensorDataset(torch.tensor(x_train.values), torch.tensor(y_train.values))
    test_dataset = TensorDataset(torch.tensor(x_test.values), torch.tensor(y_test.values))

    # 6.返回结果
    return train_dataset, test_dataset, x_train.shape[1], len(y_train.unique())

# 2.搭建神经网络
class PhonePriceClassifier(nn.Module):
    # 1.定义__init__方法, 初始化父类成员,搭建神经网络
    def __init__(self, input_dim, output_dim):
        # 初始化父类成员
        super().__init__()
        # 搭建神经网络
        self.linear1 = nn.Linear(input_dim, 128)
        self.linear2 = nn.Linear(128, 256)
        self.linear3 = nn.Linear(256, output_dim)

    # 2.定义forward方法,实现前向传播
    def forward(self, x):
        # 隐藏层1
        x = torch.relu(self.linear1(x))
        # 隐藏层2
        x = torch.relu(self.linear2(x))
        # 输出层
        x = self.linear3(x)
        # 返回结果
        return x

# 3.模型训练
def train(train_dataset, input_dim, output_dim):
    # 1.创建数据加载器DataLoader
    # 参数1:数据集对象;参数2:批量大小;参数3:是否打乱数据
    train_loader = DataLoader(train_dataset, batch_size=16, shuffle=True)
    # 2.创建神经网络模型
    model = PhonePriceClassifier(input_dim, output_dim)
    model.to(device)
    # 3.定义损失函数
    loss_fn = nn.CrossEntropyLoss()
    # 4.创建优化器对象
    optimizer = optim.SGD(model.parameters(), lr=1e-3)
    # 5.模型训练
    # 定义变量,记录 训练总轮数
    epochs = 50
    # 遍历轮数
    for epoch in range(epochs):
        # 记录 每次训练的 损失值,训练样本数
        total_loss = 0.
        total_sample = 0
        # 记录训练开始时间
        start_time = time.time()
        # 遍历批次
        for x, y in train_loader:
            # 训练模式
            model.train()
            # 移动数据到GPU
            x = x.to(device)
            y = y.to(device)
            # 前向传播
            y_pred = model(x)
            # 计算损失值
            loss = loss_fn(y_pred, y)
            # 更新总损失
            batch_size = x.shape[0]
            total_loss += loss.item()*batch_size
            # 更新总样本数
            total_sample += batch_size
            # 梯度清零
            optimizer.zero_grad()
            # 反向传播
            loss.backward()
            # 更新参数
            optimizer.step()

        # 打印训练信息
        print(f"epoch: {epoch}, loss: {total_loss / total_sample}, time: {time.time() - start_time:.2f}")

    # 6.保存模型参数
    # print(f"\n\n模型的参数信息: {model.state_dict()}\n\n")
    torch.save(model.state_dict(), "./model/phone_price_classifier.pth")    # 模型文件,后缀名 .pth, .pkl, .pickle 均可


# 4.模型测试
@torch.no_grad()
def evaluate(test_dataset, input_dim, output_dim):
    # 1. 创建神经网络分类对象.
    model = PhonePriceClassifier(input_dim, output_dim)
    model.to(device)
    # 2.加载模型参数
    model.load_state_dict(torch.load('./model/phone_price_classifier.pth'))
    # 3.创建数据加载器DataLoader
    # 参数1:数据集对象;参数2:批量大小;参数3:是否打乱数据
    test_loader = DataLoader(test_dataset, batch_size=16, shuffle=False)
    # 4.记录正确样本的数量
    correct_sample = 0
    total_sample = 0
    # 5.开始测试, 遍历数据加载器的批次数据
    for x, y in test_loader:
        # 切换到测试模式
        model.eval()
        # 张量 迁移 到 GPU
        x = x.to(device)
        y = y.to(device)
        # 6.前向传播,模型预测
        y_pred = model(x)   # 形状(batch_size, 4), 每个类别的输出logits
        # print(f"预测结果y_pred:{y_pred}")
        # 7.计算预测正确的数量
        correct = y_pred.argmax(dim=1) == y
        correct_sample += correct.sum().item()
        total_sample += y.size(0)
    print(f"测试集准确率:{correct_sample / total_sample}")

# 5.测试
if __name__ == '__main__':
    # 1.准备数据集
    train_dataset, test_dataset, input_dim, output_dim = create_dataset()
    # 打印
    print(f"train_dataset: {train_dataset}")
    print(f"test_dataset: {test_dataset}")
    print(f"input_dim: {input_dim}")
    print(f"output_dim: {output_dim}")
    # 2.构建神经网络
    model = PhonePriceClassifier(input_dim, output_dim)
    # 3.统计模型参数
    model.to(device)
    # summary(model,input_size=(input_dim,))
    # 4.模型训练
    train(train_dataset, input_dim, output_dim)
    # 5.模型测试
    evaluate(test_dataset, input_dim, output_dim)
train_dataset: <torch.utils.data.dataset.TensorDataset object at 0x00000197BA052BA0>
test_dataset: <torch.utils.data.dataset.TensorDataset object at 0x00000197F9C17610>
input_dim: 20
output_dim: 4
epoch: 0, loss: 10.34764018535614, time: 0.22
epoch: 1, loss: 0.8868235325813294, time: 0.10
epoch: 2, loss: 0.8461017781496047, time: 0.10
epoch: 3, loss: 0.8364109423756599, time: 0.10
epoch: 4, loss: 0.8181111803650856, time: 0.13
epoch: 5, loss: 0.8058439743518829, time: 0.10
epoch: 6, loss: 0.8025904560089111, time: 0.10
epoch: 7, loss: 0.8014548885822296, time: 0.10
epoch: 8, loss: 0.779120919406414, time: 0.12
epoch: 9, loss: 0.7771800068020821, time: 0.11
epoch: 10, loss: 0.7424208781123162, time: 0.10
epoch: 11, loss: 0.7729402646422386, time: 0.12
epoch: 12, loss: 0.7419938072562218, time: 0.12
epoch: 13, loss: 0.7461637026071548, time: 0.10
epoch: 14, loss: 0.7451482152938843, time: 0.10
epoch: 15, loss: 0.7622780457139016, time: 0.10
epoch: 16, loss: 0.7363531678915024, time: 0.11
epoch: 17, loss: 0.7171687591075897, time: 0.10
epoch: 18, loss: 0.7375901317596436, time: 0.10
epoch: 19, loss: 0.7328856790065765, time: 0.10
epoch: 20, loss: 0.7176006978750229, time: 0.10
epoch: 21, loss: 0.7251139596104622, time: 0.10
epoch: 22, loss: 0.7137130743265152, time: 0.10
epoch: 23, loss: 0.7312264454364776, time: 0.10
epoch: 24, loss: 0.7118452110886574, time: 0.10
epoch: 25, loss: 0.7094027370214462, time: 0.10
epoch: 26, loss: 0.690052843093872, time: 0.10
epoch: 27, loss: 0.6843650743365288, time: 0.10
epoch: 28, loss: 0.6829788282513618, time: 0.10
epoch: 29, loss: 0.6869563218951226, time: 0.10
epoch: 30, loss: 0.6813377672433854, time: 0.10
epoch: 31, loss: 0.6886233869194984, time: 0.11
epoch: 32, loss: 0.7100735640525818, time: 0.11
epoch: 33, loss: 0.6711059054732322, time: 0.10
epoch: 34, loss: 0.7061515259742737, time: 0.10
epoch: 35, loss: 0.6886743503808975, time: 0.10
epoch: 36, loss: 0.6809764394164085, time: 0.10
epoch: 37, loss: 0.6769312492012978, time: 0.10
epoch: 38, loss: 0.6803314900398254, time: 0.10
epoch: 39, loss: 0.6642144033312798, time: 0.10
epoch: 40, loss: 0.6802034932374954, time: 0.10
epoch: 41, loss: 0.6694290074706077, time: 0.10
epoch: 42, loss: 0.683846652507782, time: 0.10
epoch: 43, loss: 0.6785068655014038, time: 0.10
epoch: 44, loss: 0.6693502110242844, time: 0.10
epoch: 45, loss: 0.6568958036601543, time: 0.10
epoch: 46, loss: 0.6516988828778267, time: 0.10
epoch: 47, loss: 0.6618712189793586, time: 0.11
epoch: 48, loss: 0.6546808457374573, time: 0.10
epoch: 49, loss: 0.684197007715702, time: 0.10
测试集准确率:0.59
- 模型优化
1. 对输入数据进行标准化
2. 调整优化方法
3. 调整学习率
4. 增加批量归一化层
5. 增加网络层数、神经元个数
6. 增加训练轮数
7. 使用GPU加速训练
8. 等等...
import torch                                                # pytorch框架
from torch.utils.data import TensorDataset                  # 数据集对象
from torch.utils.data import DataLoader                     # 数据加载器
import torch.nn as nn                                       # 神经网络层的操作
import torch.optim as optim                                 # 优化器
from sklearn.model_selection import train_test_split        # 拆分 训练集 和 测试集
import matplotlib.pyplot as plt                             # 绘图
import numpy as np                                          # 数组操作
import pandas as pd                                         # 数据处理
import time                                                 # 时间模块

from torchsummary import summary
from sklearn.preprocessing import StandardScaler

device = "cuda" if torch.cuda.is_available() else "cpu"
print(f"使用设备:{device}")
# 1.准备数据集
def create_dataset():
    # 1.加载CSV数据集
    data = pd.read_csv("./data/手机价格预测.csv")
    # 2.获取特征x 和 标签y
    x = data.iloc[:, :-1]
    y = data.iloc[:, -1]
    # print(f"x: {x.head()}")
    # print(f"y: {y.head()}")
    # 3.特征列 转换为 float
    x = x.astype(np.float32)
    # print(f"x: {x}")

    # 4.拆分数据集
    x_train, x_test, y_train, y_test = train_test_split(x, y, test_size=0.2, random_state=6, stratify=y)

    # 优化1:数据标准化
    transfer = StandardScaler()
    x_train = transfer.fit_transform(x_train)
    x_test = transfer.transform(x_test)

    # 5.把数据集转换为张量, numpy数组 -> 张量 -> 数据集对象TensorDataset -> 数据加载器DataLoader
    train_dataset = TensorDataset(torch.tensor(x_train), torch.tensor(y_train.values))
    test_dataset = TensorDataset(torch.tensor(x_test), torch.tensor(y_test.values))

    # 6.返回结果
    return train_dataset, test_dataset, x_train.shape[1], len(y_train.unique())

# 2.搭建神经网络
class PhonePriceClassifier(nn.Module):
    # 1.定义__init__方法, 初始化父类成员,搭建神经网络
    def __init__(self, input_dim, output_dim):
        # 初始化父类成员
        super().__init__()
        # 搭建神经网络
        # 优化2:增加网络深度
        self.linear1 = nn.Linear(input_dim, 512)
        # self.linear2 = nn.Linear(512, 512)
        self.linear3 = nn.Linear(512, 256)
        self.linear4 = nn.Linear(256, 256)
        self.linear5 = nn.Linear(256, output_dim)
        self.dropout = nn.Dropout(0.1)

    # 2.定义forward方法,实现前向传播
    def forward(self, x):
        # 隐藏层1
        x = torch.relu(self.linear1(x))
        # 隐藏层2
        # x = torch.relu(self.linear2(x))
        x = torch.relu(self.linear3(x))
        x = torch.relu(self.linear4(x))
        x = self.dropout(x)
        # 输出层
        x = self.linear5(x)
        # 返回结果
        return x

# 3.模型训练
def train(train_dataset, input_dim, output_dim):
    # 1.创建数据加载器DataLoader
    # 参数1:数据集对象;参数2:批量大小;参数3:是否打乱数据
    train_loader = DataLoader(train_dataset, batch_size=32, shuffle=True)
    # 2.创建神经网络模型
    model = PhonePriceClassifier(input_dim, output_dim)
    model.to(device)
    # 3.定义损失函数
    loss_fn = nn.CrossEntropyLoss()
    # 4.创建优化器对象
    # 优化3:使用Adam优化方法
    optimizer = optim.Adam(model.parameters(), lr=1e-4)
    # 优化4:添加学习率调度,optim.lr_scheduler.CosineAnnealingWarmRestarts
    scheduler = optim.lr_scheduler.CosineAnnealingWarmRestarts(optimizer, T_0=10, T_mult=1)
    # 5.模型训练
    # 定义变量,记录 训练总轮数
    epochs = 50
    # 遍历轮数
    for epoch in range(epochs):
        # 记录 每次训练的 损失值,训练样本数
        total_loss = 0.
        total_sample = 0
        # 记录训练开始时间
        start_time = time.time()
        # 遍历批次
        for x, y in train_loader:
            # 训练模式
            model.train()
            # 移动数据到GPU
            x = x.to(device)
            y = y.to(device)
            # 前向传播
            y_pred = model(x)
            # 计算损失值
            loss = loss_fn(y_pred, y)
            # 更新总损失
            batch_size = x.shape[0]
            total_loss += loss.item()*batch_size
            # 更新总样本数
            total_sample += batch_size
            # 梯度清零
            optimizer.zero_grad()
            # 反向传播
            loss.backward()
            # 更新参数
            optimizer.step()
            scheduler.step()

        # 打印训练信息
        print(f"epoch: {epoch}, loss: {total_loss / total_sample}, time: {time.time() - start_time:.2f}")

    # 6.保存模型参数
    # print(f"\n\n模型的参数信息: {model.state_dict()}\n\n")
    torch.save(model.state_dict(), "./model/phone_price_classifier.pth")    # 模型文件,后缀名 .pth, .pkl, .pickle 均可


# 4.模型测试
@torch.no_grad()
def evaluate(test_dataset, input_dim, output_dim):
    # 1. 创建神经网络分类对象.
    model = PhonePriceClassifier(input_dim, output_dim)
    model.to(device)
    # 2.加载模型参数
    model.load_state_dict(torch.load('./model/phone_price_classifier.pth'))
    # 3.创建数据加载器DataLoader
    # 参数1:数据集对象;参数2:批量大小;参数3:是否打乱数据
    test_loader = DataLoader(test_dataset, batch_size=32, shuffle=False)
    # 4.记录正确样本的数量
    correct_sample = 0
    total_sample = 0
    # 5.开始测试, 遍历数据加载器的批次数据
    for x, y in test_loader:
        # 切换到测试模式
        model.eval()
        # 张量 迁移 到 GPU
        x = x.to(device)
        y = y.to(device)
        # 6.前向传播,模型预测
        y_pred = model(x)   # 形状(batch_size, 4), 每个类别的输出logits
        # print(f"预测结果y_pred:{y_pred}")
        # 7.计算预测正确的数量
        correct = y_pred.argmax(dim=1) == y
        correct_sample += correct.sum().item()
        total_sample += y.size(0)
    print(f"测试集准确率:{correct_sample / total_sample}")

# 5.测试
if __name__ == '__main__':
    # 1.准备数据集
    train_dataset, test_dataset, input_dim, output_dim = create_dataset()
    # 打印
    print(f"train_dataset: {train_dataset}")
    print(f"test_dataset: {test_dataset}")
    print(f"input_dim: {input_dim}")
    print(f"output_dim: {output_dim}")
    # 2.构建神经网络
    model = PhonePriceClassifier(input_dim, output_dim)
    # 3.统计模型参数
    model.to(device)
    # summary(model,input_size=(input_dim,))
    # 4.模型训练
    train(train_dataset, input_dim, output_dim)
    # 5.模型测试
    evaluate(test_dataset, input_dim, output_dim)
使用设备:cuda
train_dataset: <torch.utils.data.dataset.TensorDataset object at 0x00000197F9C17890>
test_dataset: <torch.utils.data.dataset.TensorDataset object at 0x00000197F9CF4C30>
input_dim: 20
output_dim: 4
epoch: 0, loss: 1.3706597256660462, time: 0.11
epoch: 1, loss: 1.3022879910469056, time: 0.07
epoch: 2, loss: 1.1458162045478821, time: 0.08
epoch: 3, loss: 0.9078893768787384, time: 0.07
epoch: 4, loss: 0.6967931640148163, time: 0.08
epoch: 5, loss: 0.5534972769021987, time: 0.09
epoch: 6, loss: 0.4496357005834579, time: 0.08
epoch: 7, loss: 0.37318617820739747, time: 0.07
epoch: 8, loss: 0.32060630530118944, time: 0.08
epoch: 9, loss: 0.2785828632116318, time: 0.08
epoch: 10, loss: 0.2471187022328377, time: 0.07
epoch: 11, loss: 0.22411519527435303, time: 0.08
epoch: 12, loss: 0.20272956281900406, time: 0.07
epoch: 13, loss: 0.18643852710723877, time: 0.07
epoch: 14, loss: 0.17427322000265122, time: 0.07
epoch: 15, loss: 0.157532174885273, time: 0.07
epoch: 16, loss: 0.14617112323641776, time: 0.07
epoch: 17, loss: 0.14078537061810492, time: 0.08
epoch: 18, loss: 0.12825253903865813, time: 0.08
epoch: 19, loss: 0.11951646484434604, time: 0.07
epoch: 20, loss: 0.11523462533950805, time: 0.08
epoch: 21, loss: 0.10727430664002896, time: 0.07
epoch: 22, loss: 0.10047829926013946, time: 0.08
epoch: 23, loss: 0.09744384035468101, time: 0.07
epoch: 24, loss: 0.09036574810743332, time: 0.07
epoch: 25, loss: 0.08763951905071736, time: 0.08
epoch: 26, loss: 0.08140164084732532, time: 0.07
epoch: 27, loss: 0.07587030805647373, time: 0.07
epoch: 28, loss: 0.0731380008906126, time: 0.08
epoch: 29, loss: 0.07344199813902379, time: 0.08
epoch: 30, loss: 0.06597149554640054, time: 0.08
epoch: 31, loss: 0.06322498302906751, time: 0.07
epoch: 32, loss: 0.06085667755454779, time: 0.08
epoch: 33, loss: 0.06113092955201864, time: 0.08
epoch: 34, loss: 0.057474353462457654, time: 0.08
epoch: 35, loss: 0.05293474618345499, time: 0.08
epoch: 36, loss: 0.05207266837358475, time: 0.09
epoch: 37, loss: 0.04969668610021472, time: 0.09
epoch: 38, loss: 0.04556395657360554, time: 0.09
epoch: 39, loss: 0.04432915959507227, time: 0.07
epoch: 40, loss: 0.04232580278068781, time: 0.08
epoch: 41, loss: 0.0396079907566309, time: 0.08
epoch: 42, loss: 0.03937803667970002, time: 0.09
epoch: 43, loss: 0.03654556540772319, time: 0.07
epoch: 44, loss: 0.033677131067961455, time: 0.07
epoch: 45, loss: 0.03449654405936599, time: 0.07
epoch: 46, loss: 0.030163878463208674, time: 0.08
epoch: 47, loss: 0.029301316421478988, time: 0.07
epoch: 48, loss: 0.02753810239955783, time: 0.08
epoch: 49, loss: 0.02798120280727744, time: 0.08
测试集准确率:0.9175
常见面试题
1. 常见的学习率衰减策略 或 学习率调度策略 有哪些?
2. 常用的正则化方法有哪些?
3. 简述dropout的计算原理?
4. dropout训练时为什么要将输出/(1-p)?
5. 简述BN批量归一化的计算原理?
6. 简述神经网络训练的一般工作流?
7. 神经网络训练中,如何避免或缓解梯度爆炸或者梯度消失?
1. 常见的学习率衰减策略 或 学习率调度策略 有哪些?
- 等间隔衰减:每隔固定训练轮次,将学习率乘以一个固定比例
- 余弦退火:学习率按余弦曲线平滑下降,可周期性重启来跳出局部最优解。
- 自适应学习率:根据梯度自动调整学习率,如 Adam、RMSProp
- 其他
- 指定间隔衰减:指定间隔衰减学习率
- 指数衰减:学习率按指数连续衰减
2. 常用的正则化方法有哪些?
- L1/L2正则化:L1惩罚权重绝对值,L2惩罚权重的平方。
- dropout:训练时随机失活神经元,防止过拟合。
- 批量归一化:标准化输入数据,减小数据分布偏差。
3. 简述dropout的计算原理?
- 训练时,dropout让神经元以随机概率p 随机失活,将输出置为0, 其余输出 /(1-p)。
- 测试时,dropout随机失活不起作用。
4. dropout训练时为什么要将输出/(1-p)?
- Dropout以概率p让神经元随机失活,将输出置为0,会使得输出的期望变为原始期望*(1-p),
- 为了保持 训练 和 预测 时的数值一致性,Dropout之后需要/(1-p),缩放为原始期望
5. 简述BN批量归一化的计算原理?
批量归一化在训练时,先对数据标准化,再进行 缩放+平移,从而减小数据分布的偏差。
- 训练时,BN层先将数据标准化为均值0,方差1的分布,然后进行缩放和平移,同时还会维护一个全局均值和全局方差,用于测试时进行归一化。
- 测试时,BN层使用训练时的全局均值和方差先对数据进行标准化,然后使用训练时的缩放和平移参数进行缩放和平移。
- 缩放参数和平移参数是在训练过程中学习的。
6. 简述神经网络训练的一般工作流?
- 1.准备数据集
- 2.搭建神经网络模型
- 3.模型训练
- 前向传播:\(\hat{y} = model(X)\)
- 计算损失:\(loss = loss\_fn(\hat{y}, y)\)
- 梯度清零:\(optimizer.zero\_grad()\)
- 反向传播:\(loss.backward()\)
- 更新参数:\(optimizer.step()\)
- 4.模型测试
7. 神经网络训练中,如何避免或缓解梯度爆炸或者梯度消失?
-
梯度爆炸
-
- 降低学习率
-
- 合理参数初始化方法(Kaiming / Xavier)
-
- 使用稳定激活函数(ReLU / Leaky ReLU)
-
- 使用批归一化(BatchNorm)改善输入分布
-
- 梯度裁剪
-
-
梯度消失
-
- 非饱和激活函数(ReLU)
-
- 合理参数初始化方法(Kaiming / Xavier)
-
- 批量归一化(BatchNorm)
-
- 残差或跳跃连接(ResNet / DenseNet)
-
代码作业
- 1.使用两层dropout处理数据。输入数据形状为(2,4),隐藏层形状为(4,20),后接dropout(p=0.5),输出层形状为(20,10),得到输出结果,并打印。注意通常输出层之后不加dropout
- 2.修改手机价格分类案例代码。采用周期启动的余弦退火学习率调度策略torch.optim.lr_scheduler.CosineAnnealingWarmRestarts来调整学习率,训练模型,并打印最终的测试准确率。
- 3.修改手机价格分类案例代码。模型中添加dropout层,优化器改为AdamW, 采用周期启动的余弦退火学习率调度策略torch.optim.lr_scheduler.CosineAnnealingWarmRestarts来调整学习率,训练模型,并打印最终的测试准确率。注意dropout的p应该小于0.1,因为数据集较小。
Day05 代码:损失函数 / EMA
4 个文件- 📄 01_多分类交叉熵损失函数.py 2.0KB 下载
- 📄 02_二分类交叉熵损失函数.py 2.8KB 下载
- 📄 03_回归任务_损失函数.py 2.4KB 下载
- 📄 04_演示指数移动加权平均.py 2.5KB 下载
每日一图
- 🖼️ day05.png 99.7KB