第 3 节 / 共 4 节
计算机视觉:目标检测
01-目标检测-目标检测概述
计算机视觉基础CV笔记
一、今日课程内容
- 目标检测的任务(了解)
- 目标检测的常用数据集(了解)
- 目标检测算法的评价指标(了解)
- 非极大值NMS算法的应用(掌握)
- 常用的目标检测算法分类(了解)
二、目标检测(了解)
1、定义
- 找出图像中所有感兴趣的目标,并确定它们的【类别】和【位置】。
2、主要内容
-
类别:取决于当前任务(数据集)需要检测的物体类别
-
位置:极坐标表示和中心点坐标表示
-
1、极坐标表示:(xmin, ymin, xmax, ymax)
- xmin , ymin: x,y坐标的最小值
- xmin , ymin: x,y坐标的最大值
-
2、中心点坐标:(x_center , y_center, w , h)
-
x_center , y_center: 目标检测框的中心点坐标
-
w , h: 目标检测框的宽、高
三、常用的开源数据集(了解)
1、PASCAL VOC数据集
- 目标检测领域的经典基准数据集
- 包含约10,000张带有边界框的图片用于训练和验证
- 共20个类别
- 1.人: 人
- 2.动物: 鸟,猫,牛,狗,马,羊
- 3.交通工具: 飞机,自行车,船,公共汽车,汽车,摩托车,火车
- 4.室内: 瓶子,椅子,餐桌,盆栽,沙发,电视/显示器
- 常用的是VOC2007和VOC2012两个版本
- 下载地址:https://pjreddie.com/projects/pascal-voc-dataset-mirror/
- 目录结构
- JPEGImages存放图片文件
- Annotations下存放的是xml文件,描述了图片信息
- xmin , ymin构成了boundingbox的左上角
- xmax , ymax构成了boundingbox的右下角
- ImageSets包含以下4个文件夹:
- Action下存放的是人的动作(例如running、jumping等等)
- Layout下存放的是具有人体部位的数据(人的head、hand、feet等等)
- Segmentation下存放的是可用于分割的数据。
- Main下存放的是图像物体识别的数据,总共分为20类,这是进行目标检测的重点。
2、MS COCO数据集
- 全称是Microsoft Common Objects in Context
- 微软于2014年出资标注的Microsoft COCO数据集
- 一个大型的、丰富的物体检测,分割和字幕数据集
- 以场景理解为目标,主要从复杂的日常场景中截取,图像中的目标通过精确的分割进行位置的标定
- 图像包括91类目标,328,000影像和2,500,000个label
- 80 类,有超过33 万张图片,其中20 万张有标注,整个数据集中个体的数目超过150 万个。
- 标签文件:
- segmentation+bounding box (精度均为小数点后两位)
四、常用的评价指标(了解)
1、IOU
-
IoU(intersection over union,交并比)是目标检测算法中用来评价2个矩形框之间相似度的指标
-
IoU = 两个矩形框相交的面积 / 两个矩形框相并的面积
-
代码实现
python
  import numpy as np
  # 1.定义方法计算IOU
  def Iou(box1, box2):
      # 2.使用极坐标形式表示:直接获取两个bbox的坐标
      # 2.1 获取两个框的左上角坐标和右下角坐标
      xmin1, ymin1, xmax1, ymax1 = box1
      xmin2, ymin2, xmax2, ymax2 = box2
      # 3.获取矩形框交集对应的左上角和右下角的坐标(intersection)
      xx1 = np.max([xmin1, xmin2])
      yy1 = np.max([ymin1, ymin2])
      xx2 = np.min([xmax1, xmax2])
      yy2 = np.min([ymax1, ymax2])
      # 4.计算两个矩形框面积
      area1 = (xmax1-xmin1) * (ymax1-ymin1)
      area2 = (xmax2-xmin2) * (ymax2-ymin2)
      # 5.计算交集面积
      inter_area = (np.max([0, xx2-xx1])) * (np.max([0, yy2-yy1]))
      # 6.计算交并比
      iou = inter_area / (area1+area2-inter_area)
      return iou
2、mAP
- 评估模型的物体分类和定位性能的指标
- mAP是多个分类任务的AP的平均值,而AP(average precision)是PR曲线下的面积
- TP、FP、FN、TN
- TP(True Positive):IOU大于阈值的检测框数量
- FP(False Positive):IOU小于等于阈值的检测框数量
- FN(False Negative ):没有检测到的真实框的数量
-
TN(True Negative):真负例,在 mAP 评价指标中不会使用到
-
查准率、查全率
- 查准率(Precision): TP/(TP + FP)
-
查全率(Recall): TP/(TP + FN)
-
AP值计算方法
- (1)VOC2010以前
- 选取当Recall >= 0, 0.1, 0.2, ..., 1共11个点时的Precision最大值,然后AP就是这11个Precision的平均值
- (2)VOC2010以后
- 针对每一个不同的Recall值(包括0和1),选取其大于等于这些Recall值时的Precision最大值
五、NMS(非极大值抑制)
1、基本内容
-
非极大值抑制(Non-Maximum Suppression,NMS),顾名思义就是抑制不是极大值的元素
-
选取那些邻域里分数最高,并且抑制那些分数低的窗口
-
目的就是去除冗余的检测框,保留最好的一个。
-
使用流程
-
首先是检测出一系列的检测框
- 将检测框按照类别进行分类
-
对同一类别的检测框应用NMS获取最终的检测结果
-
代码实现
```python
import numpy as np
def nms(bboxes, confidence_score, threshold):
"""非极大抑制过程
:param bboxes: 同类别候选框坐标
:param confidence: 同类别候选框分数
:param threshold: iou阈值
:return:
"""
# 1、强转数组,并取出每个框左上角坐标和右下角坐标
bboxes = np.array(bboxes)
score = np.array(confidence_score)
  # 取出n个的极坐标点(左上角坐标和右下角坐标)
  x1 = bboxes[:, 0]
  y1 = bboxes[:, 1]
  x2 = bboxes[:, 2]
  y2 = bboxes[:, 3]
  # 计算每个框的面积
  areas = (x2 - x1) * (y2 - y1)
  # 2、对候选框进行NMS筛选
  # 2.1 返回的框坐标和分数
  picked_boxes = []
  picked_score = []
  # 2.2 对置信度进行排序, 获取排序后的下标序号, argsort默认从小到大排序
  order = np.argsort(score)
  while order.size > 0:
      # 2.3 将当前置信度最大的框加入返回值列表中
      index = order[-1]
      # 2.4 保留该类剩余box中得分最高的一个
      picked_boxes.append(bboxes[index])
      picked_score.append(confidence_score[index])
      # 2.5 计算交并比
      # 2.5.1 获取当前置信度最大的候选框与其他任意候选框的相交面积
      x11 = np.maximum(x1[index], x1[order[:-1]])
      y11 = np.maximum(y1[index], y1[order[:-1]])
      x22 = np.minimum(x2[index], x2[order[:-1]])
      y22 = np.minimum(y2[index], y2[order[:-1]])
      # 2.5.2 计算交集的面积,不重叠时面积为0
      w = np.maximum(0.0, x22 - x11)
      h = np.maximum(0.0, y22 - y11)
      intersection = w * h
      # 2.5.3 利用相交的面积和两个框自身的面积计算框的交并比
      ratio = intersection / (areas[index] + areas[order[:-1]] - intersection)
      # 2.5.4 保留IoU小于阈值的box
      keep_boxes_indics = np.where(ratio < threshold)
      # 2.5.5 保留剩余的框
      order = order[keep_boxes_indics]

  # 2.6 返回NMS后的框及分类结果
  return picked_boxes, picked_score
```
六、目标检测方法分类
1、基本内容
- two-stage(两阶段)
- 先由算法生成一系列作为样本的候选框,再通过卷积神经网络进行样本分类
- 特点:网络的准确度高、速度相对较慢
- 代表算法:RCNN系列:R-CNN到Faster R-CNN网络
- one-stage(单阶段)
- 直接通过主干网络给出目标的类别和位置信息,没有使用候选区域的筛选网路
- 特点:算法速度快,但是精度相对Two-stage目标检测网络降低了很多。
- 代表算法: YOLO系列:YOLOv1、YOLOv2、YOLOv3、 SSD等
02-目标检测-R-CNN网络基础
计算机视觉基础CV笔记
一、今日课程内容
- Overfeat模型的移动窗口方法(了解)
- RCNN目标检测的思想(掌握)
- fastRCNN目标检测的思想(掌握)
- 多任务损失(掌握)
二、Overfeat模型(了解)
1、定义
- Overfeat方法:使用滑动窗口和神经网络来检测目标的方法
- 实现方法:滑动窗口使用固定宽度和高度的矩形区域,在图像上“滑动”,并将扫描结果送入到神经网络中进行分类和回归。
- 缺点:类似一种暴力穷举的方式,会消耗大量的计算力,并且由于窗口大小问题可能会造成效果不准确。
三、RCNN模型(掌握)
1、基本内容
- 2014年提出,使用候选区域方法(region proposal method)创建目标检测的区域来完成目标检测的任务
- R-CNN是以深度神经网络为基础的目标检测的模型 ,以R-CNN为基点,后续的Fast R-CNN、Faster R-CNN模型都延续了这种目标检测思路。
2、算法流程
- 候选区域生成:使用选择性搜索(Selective Search)的方法找出图片中可能存在目标的侯选区域
- 候选区域搜索依据:使用语义分割的方法,将颜色、边界、纹理等信息作为合并条件,采用多尺度的综合方法 - CNN网络提取特征:选取预训练卷积神经网网络(AlexNet或VGG)用于进行特征提取。
- 采用预训练模型(AlexNet或VGG)在生成的候选区域上进行特征提取
- 特征提取流程:- (1)候选区域需进行裁剪或变形为固定的尺寸,再送入CNN网络中进行特征提取(全连接层输入数据的尺寸是固定的)
- (2)全连接层由1000修改为N+1(预训练模型在ImageNet数据集上获得)
- (3)利用微调后的CNN网络,提取每一个候选区域的特征,获取一个4096维的特征,一幅图像就是2000x4096维特征存储到磁盘中。
- 目标分类:训练支持向量机(SVM)来辨别目标物体和背景,对每个类别,都要训练一个二元SVM。
- 对于N个类别的检测任务,需要训练N(目标类别数目)个SVM分类器
- 对候选区域的特征向量(4096维)进行二分类,判断其是某一类别的目标,还是背景来完成目标分类。 - 目标定位:训练一个线性回归模型,为每个辨识到的物体生成更精确的边界框。
- 训练一个线性回归模型在给定的候选区域的结果上去预测一个新的检测窗口,能够获得更精确的位置 - 模型预测
- 使用选择性搜索的方法从一张图片中提取2000个候选区域
- 将每个区域送入CNN网络中进行特征提取,然后送入到SVM中进行分类
- 使用候选框回归器,计算出每个候选区域的位置。
- 候选区域较多,有2000个,需要剔除掉部分检测结果。 针对每个类,通过计算IOU,采取非最大值抑制NMS的方法,保留比较好的检测结果。
3、算法总结
1、训练阶段多,训练耗时: 微调CNN网络+训练SVM+训练边框回归器。
2、预测速度慢: 使用GPU, VGG16模型处理一张图像需要47s。
3、占用磁盘空间大:5000张图像产生几百G的特征文件。
4、数据的形状变化:候选区域要经过缩放来固定大小,无法保证目标的不变形
四、Fast RCNN模型(了解)
1、基本内容
- 提出时间:2015年
- 改进点:
- 1、提高训练和预测的速度
- 将整张图输入到CNN中提取特征,将候选区域映射到特征图上,这样就避免了对图像区域进行重复处理,提高效率减少时间
- 2、不需要额外的空间保存CNN网络提取的特征向量
- 将类别判断和边框回归统一使用CNN实现,不需要在额外的空间存储特征
- 3、不在直接对候选区域进行缩放
- 使用ROIpooling的方法进行尺寸的调整。
2、算法流程
-
1、候选区域生成:使用选择性搜索(Selective Search)的方法找出图片中可能存在目标的侯选区域,只需要候选区域的位置信息
-
2、CNN网络特征提取:将整张图像输入到CNN网络中,得到整副图的特征图,并将上一步获取的候选区域位置从原图映射到该特征图上
-
3、ROIPooling: 对于每个特征图上候选框,RoI pooling层从特征图中提取固定长度的特征向量每个特征向量被送入一系列全连接(fc)层中。
- 候选区域从原图映射到特征图中后,进行ROIpooling的计算
- ROI Pooling层使用最大池化将输入的特征图中的任意区域(候选区域对应的区域)内的特征转化为固定的𝐻×𝑊的特征图,其中𝐻和𝑊是超参数
-
对于任意输入的ℎ×𝑤的候选区域,将其分割为𝐻×𝑊的子网格,每个子网格的大小为:(h/H) x (w/W),取每个子网格中的最大值,送入后续网络中进行处理
-
4、目标检测:分两部分完成,一个输出各类别加上1个背景类别的Softmax概率估计,另一个为各类别的每一个类别输出四个实数值,来确定目标的位置信息。
- 原网络的最后一个全连接层替换为两个同级层:K+1个类别的SoftMax分类层和边框的回归层。
3、模型训练
- R-CNN中的特征提取和检测部分是分开进行的
- Fast R-CNN提出一个高效的训练方法:多任务训练
- (1)一部分输出在K+1个类别上的离散概率分布(每个候选区域)
- (2)另一部分输出对于由K个类别中的每一个检测框回归偏移
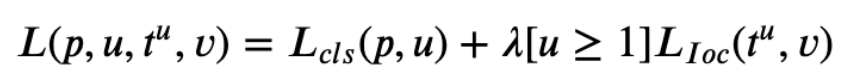
4、模型预测
(1)输入图像
(2)图像被送入到卷积网络进行特征提取,将通过选择性搜索获取的候选区域映射到特征图中
(3)在特征图上Rol中应用RoIPooling,获取尺寸相同的特征向量
(4)将这些区域传递到全连接的网络中进行分类和回归,得到目标检测的结果。
5、模型总结
Fast R-CNN是对R-CNN模型的一种改进:
- CNN网络不再对每个候选区域进行特征提取,而是直接对整张图像进行出路,这样减少了很多重复计算。
- 用ROI pooling进行特征的尺寸变换,来满足FC全连接层对输入数据尺度的要求。
- 将目标的回归和分类统一在一个网络中,使用FC+softmax进行目标分类,使用FC Layer进行目标框的回归。
缺点:候选区域提取方法耗时较长,而且和目标检测网络是分离的,并不是端到端的
后续优化:2016年,提出了Faster-RCNN模型
03-目标检测-Faster-RCNN网络
计算机视觉基础CV笔记
一、今日课程内容
- FasterRCNN目标检测的思想(了解)
- anchor(锚框)的思想(了解)
- RPN网络是如何进行候选区域的生成的(了解)
- ROIPooling的使用方法(掌握)
- FasterRCNN的训练方法(掌握)
二、网络工作流程(了解)
1、基本流程
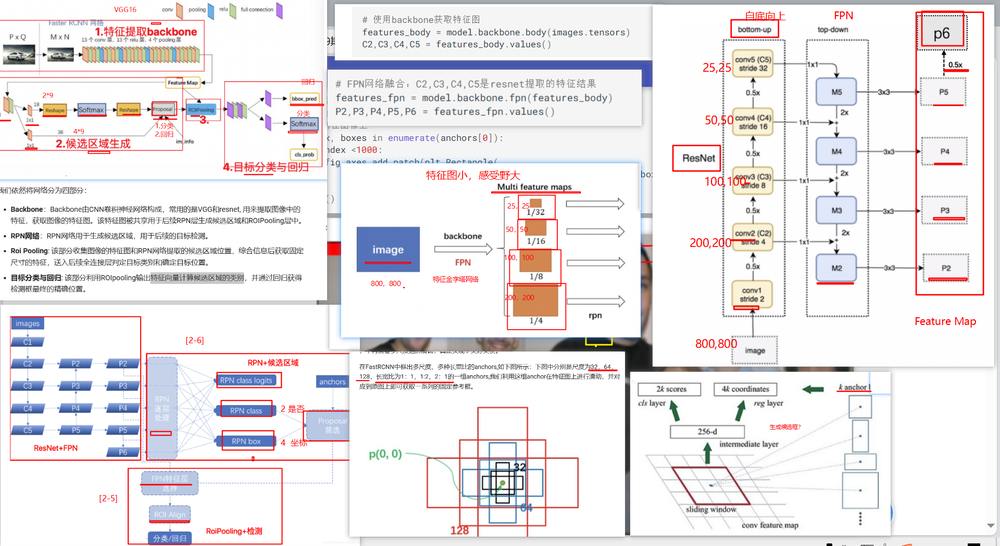
- 1、特征提取:将整个图像缩放至固定的大小输入到CNN网络中进行特征提取,得到特征图。
- 2、候选区域提取:输入特征图,使用区域生成网络RPN,产生一些列的候选区域
- 3、ROIPooling: 与Fast RCNN网络中一样,使用最大池化固定候选区域的尺寸,送入后续网络中进行处理
- 4、目标分类和回归:与Fast RCNN网络中一样,使用两个同级层:K+1个类别的SoftMax分类层和边框的回归层,来完成目标的分类和回归。
2、数据加载及转换
(1)代码架构
# 1.导入依赖包
# 1.1 pytorh相关的工具包
# 1.2 读取图像的工具包
# 1.3 绘图工具包

# 2.获取图片

# 3.将图片格式转换为tensor形式,大小转换为800x800的大小
# 3.1 查看图像大小
# 3.2 展示图像
#### (2)完整代码
# 1.导入依赖包
# 1.1 pytorh相关的工具包
import torch
import torchvision
import torchvision.transforms as transforms
from torchvision.io import read_image
# 1.2 读取图像的工具包
from PIL import Image
# 1.3 绘图工具包
import matplotlib.pyplot as plt

# 2.获取图片
img = Image.open('img3.jpg')   # [C,H,W]      opencv     # BGR
plt.imshow(img)
plt.show()

# 3.将图片格式转换为tensor形式,大小转换为800x800的大小
transform = transforms.Compose([transforms.ToTensor(),transforms.Resize((800,800))])
img = transform(img)
# 3.1 查看图像大小
img.shape
# 3.2 展示图像
plt.imshow(img.permute(1,2,0))   # [H,W,C]
3、模型加载
(1)代码架构
# 1.实例化模型
# 2.将模型设置为eval模式
(2)完整代码
backbone   + Neck   +  head

# 1.实例化模型
model = torchvision.models.detection.fasterrcnn_resnet50_fpn(pretrained=True)
# 2.将模型设置为eval模式
model.eval()
4、模型预测过程
(1)代码架构
# 1.直接进行预测

# 2.获取类别名称,框及对应的置信度

# 3.将框绘制在图像上
# 3.1 图像读取
# 3.2 图像展示
# 3.3 将框绘制在图像上

# 4.过滤分数较低的预测
# 4.1 因pred_score是从大大小进行排列的,只要获取最后一个索引即可

# 5.将过滤后的结构绘制在图像上
# 5.1 绘制图像
# 5.2 将框绘制在图像上
(2)完整代码
# 1.直接进行预测
pred = model([img])

# 2.获取类别名称,框及对应的置信度
pred_class = [coco_names[i] for i in list(pred[0]['labels'].numpy())]
pred_boxes = [[(i[0], i[1]), (i[2], i[3])] for i in list(pred[0]['boxes'].detach().numpy())]
pred_score = list(pred[0]['scores'].detach().numpy())

# 3.将框绘制在图像上
# 3.1 图像读取
img = Image.open('img3.jpg').resize((800,800))
# 3.2 图像展示
fig = plt.imshow(img)
# 3.3 将框绘制在图像上
for index, boxes in enumerate(pred_boxes):
    fig.axes.add_patch(plt.Rectangle(
    xy=(boxes[0]), width=boxes[1][0]-boxes[0][0], height=boxes[1][1]-boxes[0][1],
    fill=False, edgecolor="blue", linewidth=1))
plt.show()

# 4.过滤分数较低的预测
threshold=0.5
# 4.1 因pred_score是从大大小进行排列的,只要获取最后一个索引即可
pred_t = [pred_score.index(x) for x in pred_score if x > threshold][-1]
pred_boxes = pred_boxes[:pred_t + 1]
pred_class = pred_class[:pred_t + 1]

# 5.将过滤后的结构绘制在图像上
img = Image.open('img3.jpg').resize((800,800))
# 5.1 绘制图像
fig = plt.imshow(img)
# 5.2 将框绘制在图像上
for index, boxes in enumerate(pred_boxes):
    fig.axes.add_patch(plt.Rectangle(
    xy=(boxes[0]), width=boxes[1][0]-boxes[0][0], height=boxes[1][1]-boxes[0][1],
    fill=False, edgecolor="g", linewidth=1))
plt.show()
三、模型结构详解(了解)
1、基本结构
-
Backbone:Backbone由CNN卷积神经网络构成,常用的是VGG和resnet, 用来提取图像中的特征,获取图像的特征图。该特征图被共享用于后续RPN层生成候选区域和ROIPooling层中。
-
一般为VGG,ResNet等网络构成
-
主要进行特征提取,将最后的全连接层舍弃,得到特征图送入后续网络中进行处理。
-
Resnet进行特征提取,FPN结构作用是当前层的特征图会融合未来层的特征进行上采样,并加以利用
-
完整流程:Resnet进行特征提取,FPN网络进行特征融合获取多个特征图后,输入到RPN网络中的特征图是[p2,p3,p4,p5,p6] ,而作为后续目标检测网络FastRCNN的输入则是 [p2,p3,p4,p5] 。
-
代码实现
```python
1.使用backbone获取特征图
features_body = model.backbone.body(images.tensors)
C2,C3,C4,C5 = features_body.values()2.FPN网络融合:C2,C3,C4,C5是resnet提取的特征结果
features_fpn = model.backbone.fpn(features_body)
P2,P3,P4,P5,P6 = features_fpn.values()
``` -
RPN网络:RPN网络用于生成候选区域,用于后续的目标检测。
-
特点:极大提升检测速度
-
主要流程:
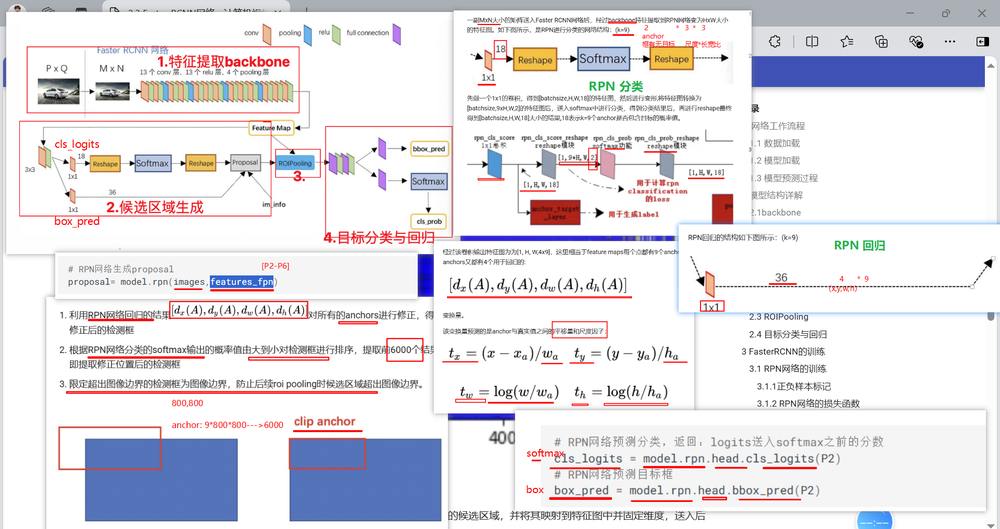
- 1、生成一系列的固定参考框anchors,覆盖图像的任意位置,然后送入后续网络中进行分类和回归
- 2、分类分支:通过softmax分类判断anchor中是否包含目标
- 3、回归分支:计算目标框对于anchors的偏移量,以获得精确的候选区域
- 4、最后的Proposal层则负责综合含有目标的anchors和对应bbox回归偏移量获取候选区域,同时剔除太小和超出边界的候选区域。
-
anchor:表示固定的参考框,预设一组不同尺度不同长宽比的固定参考框,覆盖几乎所有位置, 每个参考框负责检测与其交并比大于阈值 (训练预设值,常用0.5或0.7) 的目标
-
FastRCNN中anchor设置:尺度为32,64,128,长宽比为1:1,1:2,2:1的一组anchors
-
代码实现
```python
1.生成anchors,送入图片信息及相应的特征图
anchors=model.rpn.anchor_generator(images,[P2,P3,P4,P5,P6])
2.将生成的anchor绘制在图像上
img = Image.open('img3.jpg').resize((800,800))
2.1 绘制图像
fig = plt.imshow(img)
2.2 将框绘制在图像上
for index, boxes in enumerate(anchors[0]):
if index <1000:
fig.axes.add_patch(plt.Rectangle(
xy=(boxes[0],boxes[1]), width=boxes[2]-boxes[0], height=boxes[3]-boxes[1],
fill=False, edgecolor="red", linewidth=1))
plt.show()
``` -
RPN分类和回归
```python
RPN网络预测分类,返回:logits送入softmax之前的分数
cls_logits = model.rpn.head.cls_logits(P2)
RPN网络预测目标框
box_pred = model.rpn.head.bbox_pred(P2)
``` -
Proposal层
- 负责综合RPN网络对anchors分类和回归的结果,利用回归的结果对包含目标的anchors进行修正,计算出候选区域,送入后续RoI Pooling层中。
-
Roi Pooling: 该部分收集图像的特征图和RPN网络提取的候选区域位置,综合信息后获取固定尺寸的特征,送入后续全连接层判定目标类别和确定目标位置。
-
负责收集RPN网络生成的候选区域,并将其映射到特征图中并固定维度,送入后续网络中进行分类和回归。
-
使用最大池化将任何有效的RoI区域内的特征转换成具有pool_H×pool_W的固定空间范围的小的特征图,其中pool_H和pool_W是超参数,比如设置为7x7, 它们独立于任何特定的RoI
-
代码实现
```python
ROI Pooling层实现:
pool_region_list = model.roi_heads.box_roi_pool(features_fpn, proposal[0],images.image_sizes)
``` -
目标分类与回归: 该部分利用ROIpooling输出特征向量计算候选区域的类别,并通过回归获得检测框最终的精确位置。
-
利用获得的候选区域的特征图,通过全连接层与softmax计算每个候选区域具体属于的类别(如人,车,电视等),输出概率值;
-
同时再次利用回归方法获得每个候选区域的位置偏移量,用于回归更加精确的目标检测框。
-
代码实现:
```python
1.模型最终输出的结果
detection = model.roi_heads(features, proposal[0],images.image_sizes)
2.检测结果的绘制
detection_boxes = detection[0][0]['boxes'].detach().numpy()
img = Image.open('img3.jpg').resize((800,800))2.1 显示图像
fig = plt.imshow(img)
2.2 将检测结果绘制在图像上
for index, boxes in enumerate(detection_boxes):
fig.axes.add_patch(plt.Rectangle(
xy=(boxes[0],boxes[1]), width=boxes[2]-boxes[0], height=boxes[3]-boxes[1],
fill=False, edgecolor="purple", linewidth=1))
plt.show()
```
四、FasterRCNN的训练(了解)
1、基本内容
-
(1)数据集加载
-
(2)模型加载
-
(3)RPN网络的训练
-
1.正负样本标记
- 与真实框ground truth(GT)交并比IOU大于0.7的anchor是正样本,即anchor中包含目标,目标值设为1
- 与真实框ground truth(GT)交并比IOU小于0.3的anchor是负样本,即anchor中不包含目标,目标值设为-1
- 其他的anchor舍弃,不参与网络的训练,目标值设为0
-
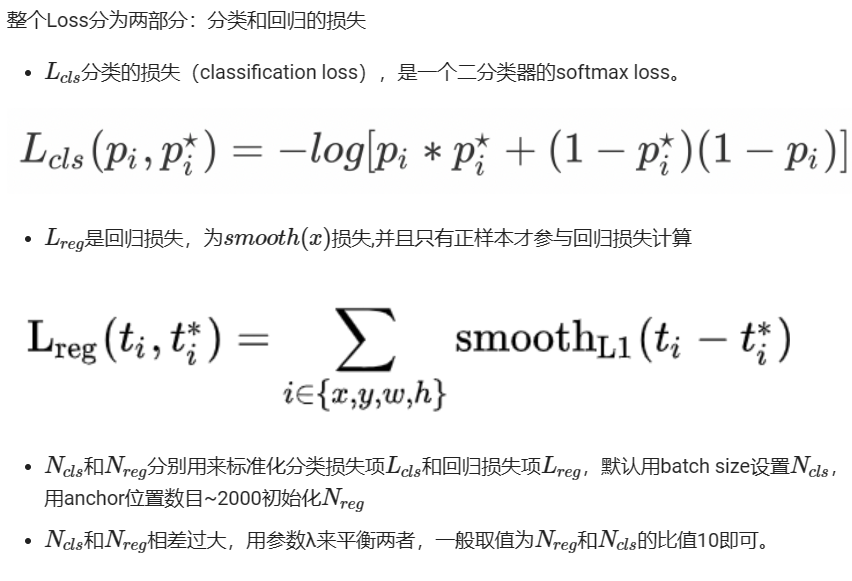
2.RPN网络的损失函数
-
(4)FastRCNN网络的训练
-
训练流程
- 首先将与真实框ground truth(GT)交并比IOU大于0.5的候选区域设为正样本,类别的目标值是GT的类别1
- 将与真实框ground truth(GT)交并比IOU小于0.5的候选区域设为负样本,类别的目标值是0
-
FastRCNN的损失函数
- FastRCNN的输出由两部分组成:一部分是softmax层进行分类,输出类别有K个类别加上”背景”类,另一部分是回归bounding box regressor
- 一部分输出在K+1个类别上的离散概率分布(每个候选区域)
- 另一部分输出对于由K个类别中的每一个检测框回归偏移
-
(5)FasterRCNN的训练
-
训练流程
- 使用Dataloader加载训练数据
- 指定优化器:在这里我们使用加动量的SGD方法
-
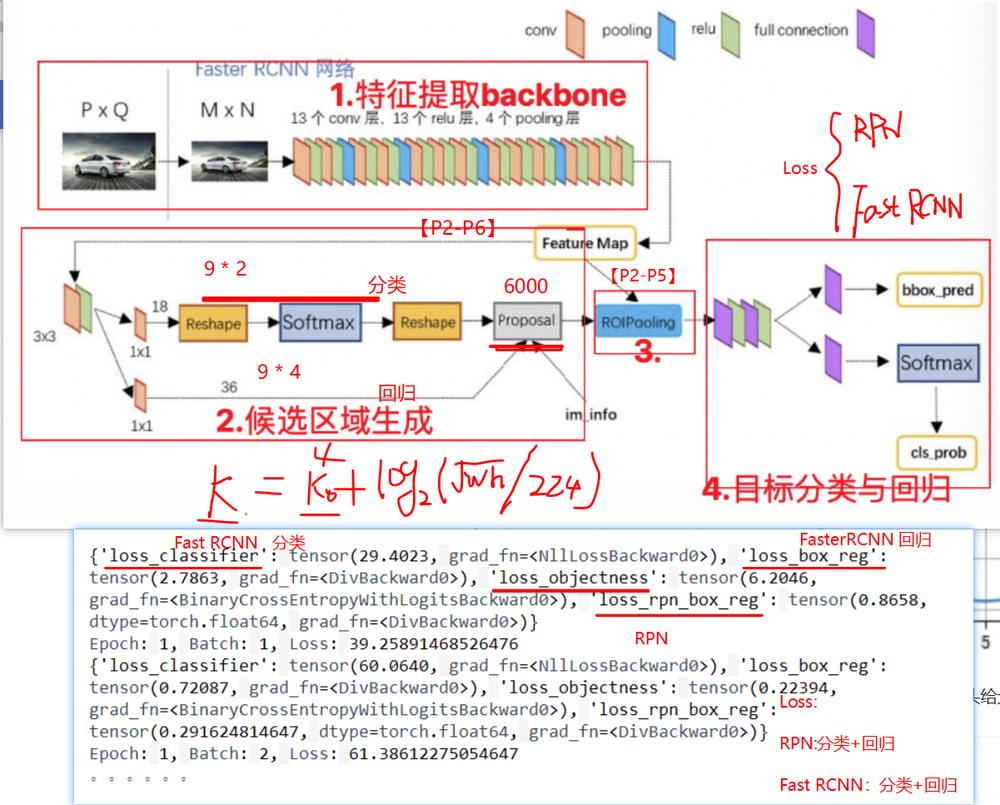
设置轮次epoch,遍历每个轮次获取batch数据送入网络中进行预测,计算损失函数,使用反向传播更新参数,完成模型训练
-
loss_dict = model(images,targets)
- fast RCNN loss
- RPN loss
课堂笔记
04-目标检测-麦穗检测案例-FasterRCNN
计算机视觉基础CV笔记
一、今日课程内容
- 麦穗检测的数据集的构成(了解)
- 项目解决的全流程(了解)
- 能够利用fasterRCNN网络模型进行训练和预测(实操 + 掌握)
二、麦穗数据集介绍与数据分析(了解)
1、基本内容
-
来自Global Wheat Head detection (GWHD) dataset,是第一个从现场光学图像进行小麦头检测的大型数据集
-
包括多个地区的不同品种,涵盖了由欧洲(法国,英国,瑞士),亚洲(中国,日本),大洋洲(澳大利亚)和北美(加拿大)的标注图像
- 图像的通用格式为1024 × 1024 px,分辨率为每像素0.1~0.3 mm
2、数据读取
# 数据获取与分析:指定训练集和验证集的路径
train_data_dir = 'wheatData/train'
test_data_dir = 'wheatData/test'
# 读取CSV文件
train_data_label = pd.read_csv('wheatData/train_data.csv')
print(train_data_label.head())
- 主要内容包括:
- image_id:图像文件的名称,指当前标注框所在的图像
- width和height: 图像的宽高,在当前数据集中,所有图片的大小均为1024x1024
- x和y: 表示当前标注框的左上角坐标
- w和h: 表示标注框的宽和高。
3、数据分析
- 数据量的分析
# 训练数据大小(这里指的是目标框)
print("目标框个数:{}".format(train_data_label.shape))
- 训练集图片的数量
# 有标注信息图片的数量
print("图片数量:{}".format(train_data_label['image_id'].nunique()))
# 所有图片的数量
print("所有图片数量:{}".format(len(os.listdir(train_data_dir))))
- 图片中目标框数量分布
counts = train_data_label['image_id'].value_counts()
print("单张图片中标注框的最大值{}和最小值{}".format(max(counts), min(counts)))
sns.displot(counts, kde=True, color="g")
plt.xlabel('boxes')
plt.ylabel('images')
plt.show()
- 标注框位置左上角坐标的分布
# 标注框左上角坐标的分布
sns.histplot(data=train_data_label, x='x', y='y', bins=50, pmax=0.9)
plt.xlabel('x')
plt.ylabel('y')
plt.show()
- 标注框位置中心点坐标的分布
# 获取数据的中心点坐标
train_data_label['cx'] = train_data_label['x'] + train_data_label['w'] / 2
train_data_label['cy'] = train_data_label['y'] + train_data_label['h'] / 2
# 绘制分布图像
sns.histplot(data=train_data_label, x='cx', y='cy', bins=50, pmax=0.9)
# 设置轴描述
plt.xlabel('cx')
plt.ylabel('cy')
plt.show()
- 标注框的宽高的分布
# 标注框宽高的分布
sns.histplot(data=train_data_label, x='w', y='h', bins=50, pmax=0.9)
# 轴描述
plt.xlabel('w')
plt.ylabel('h')
plt.show()
- 标注框面积的分布
# 标注框面积的分布:用来设置anchor的尺度
aeras = train_data_label['w'] * train_data_label['h']
print("目标框最小面积为{}最大面积为{}".format(min(aeras), max(aeras)))
sns.histplot(aeras, bins=50, kde=False)
plt.show()
- 数据展示
# 图片及标注框预览
# 设置坐标轴的个数
num_rows, num_cols = 1, 2
# 获取标注信息
ids = train_data_label['image_id'].unique()[100:100 + num_rows * num_cols]
# 读取图片
imgs = [plt.imread(f'{train_data_dir}/{n}.jpg') for n in ids]
# 图片显示
axes = show_images(imgs, num_rows, num_cols)
# 显示标注框
for ax, id in zip(axes, ids):
    datas = train_data_label[train_data_label['image_id'] == id]
    bboxes = [(d['x'], d['y'], d['x'] + d['w'], d['y'] + d['h']) for _, d in datas.iterrows()]
    show_bboxes(ax, bboxes, labels=None, colors=['r'])
    plt.show()
三、数据加载DataSet的构建(了解)
1、基本内容
-
继承
torch.utils.data.Dataset抽象类,实现__init____len____getitem__ -
__init__方法进行参数的初始化,包括 -
__len__方法获取数量集中图片的数量 -
__getitem__获取数据: -
image: 图像数据
-
target: 字典数据,包括模型训练时的目标值信息,介绍如下:
boxes: 表示标注框的左上角坐标和右下角坐标[x0, y0, x1, y1]。label: 标志标注框的类别,在当前任务中只有小麦一个类别,所以所有标注框的类别标签值设为1
四、模型训练(掌握)
1、基本内容
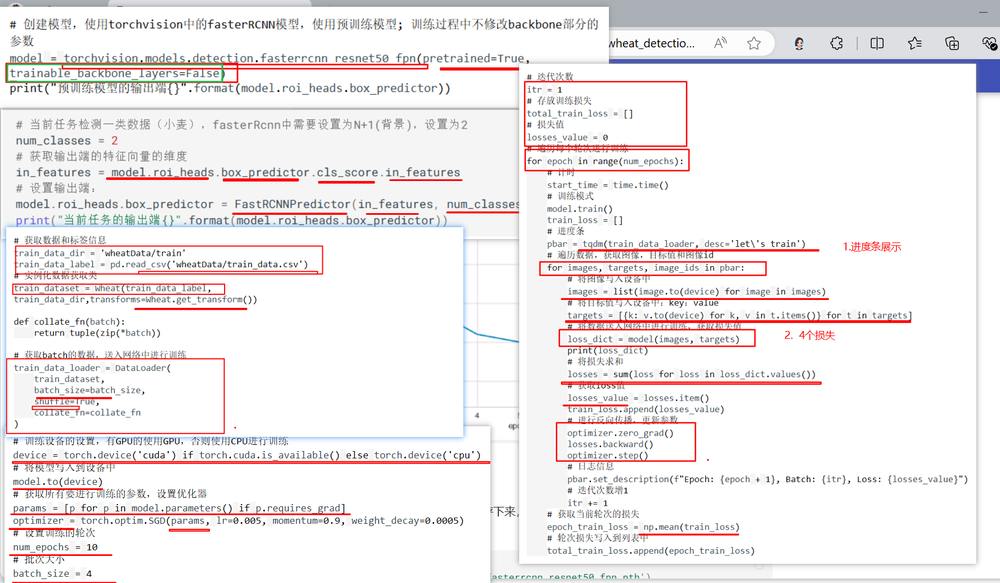
# 1.创建模型,使用torchvision中的fasterRCNN模型,使用预训练模型; 训练过程中不修改backbone部分的参数
model = torchvision.models.detection.fasterrcnn_resnet50_fpn(pretrained=True, trainable_backbone_layers=False)
print("预训练模型的输出端{}".format(model.roi_heads.box_predictor))

# 2.当前任务检测一类数据(小麦),fasterRcnn中需要设置为N+1(背景),设置为2
num_classes = 2
# 2.1 获取输出端的特征向量的维度
in_features = model.roi_heads.box_predictor.cls_score.in_features
# 2.2 设置输出端:
model.roi_heads.box_predictor = FastRCNNPredictor(in_features, num_classes)
print("当前任务的输出端{}".format(model.roi_heads.box_predictor))
2、训练参数设置
- 设置设备信息,优化器,轮次,批量大小等参数
- 代码实现
# 训练设备的设置,有GPU的使用GPU,否则使用CPU进行训练
device = torch.device('cuda') if torch.cuda.is_available() else torch.device('cpu')
# 将模型写入到设备中
model.to(device)
# 获取所有要进行训练的参数,设置优化器
params = [p for p in model.parameters() if p.requires_grad]
optimizer = torch.optim.SGD(params, lr=0.005, momentum=0.9, weight_decay=0.0005)
# 设置训练的轮次
num_epochs = 10
# 批次大小
batch_size = 4
3、数据加载
-
需要按照批次的大小来获取数据送入网络中进行训练,创建DataLoader来获取数据
-
代码实现
```python
# 获取数据和标签信息
train_data_dir = 'wheatData/train'
train_data_label = pd.read_csv('wheatData/train_data.csv')
# 实例化数据获取类
train_dataset = Wheat(train_data_label, train_data_dir,transforms=Wheat.get_transform())
def collate_fn(batch):
return tuple(zip(*batch))
# 获取batch的数据,送入网络中进行训练
train_data_loader = DataLoader(
train_dataset,
batch_size=batch_size,
shuffle=True,
collate_fn=collate_fn
)
```
4、模型训练
-
基本流程
-
遍历每个轮次
- 遍历每个batch的图像
- 模型前向传播进行预测
- 损失计算
- 反向传播更新梯度
-
模型保存
-
代码实现
```python
# 迭代次数
itr = 1
# 存放训练损失
total_train_loss = []
# 损失值
losses_value = 0
# 遍历每个轮次进行训练
for epoch in range(num_epochs):
# 计时
start_time = time.time()
# 训练模式
model.train()
train_loss = []
# 进度条
pbar = tqdm(train_data_loader, desc='let\'s train')
# 遍历数据,获取图像,目标值和图像id
for images, targets, image_ids in pbar:
# 将图像写入设备中
images = list(image.to(device) for image in images)
# 将目标值写入设备中:key:value
targets = [{k: v.to(device) for k, v in t.items()} for t in targets]
# 将数据送入网络中进行训练,获取损失值
loss_dict = model(images, targets)
print(loss_dict)
# 将损失求和
losses = sum(loss for loss in loss_dict.values())
# 获取loss值
losses_value = losses.item()
train_loss.append(losses_value)
# 进行反向传播,更新参数
optimizer.zero_grad()
losses.backward()
optimizer.step()
# 日志信息
pbar.set_description(f"Epoch: {epoch + 1}, Batch: {itr}, Loss: {losses_value}")
# 迭代次数增1
itr += 1
# 获取当前轮次的损失
epoch_train_loss = np.mean(train_loss)
# 轮次损失写入到列表中
total_train_loss.append(epoch_train_loss)
# 模型保存
torch.save(model.state_dict(), 'fasterrcnn_resnet50_fpn.pth')
```
五、模型测试(掌握)
1、基本内容
- 加载要预测的图片数据,加载训练好的模型,并利用训练好的模型进行预测
2、数据和模型加载
-
基本流程
-
1 数据的加载
- 设置要预测的图片的路径
- 实例化测试数据集的读取类
- 创建dataloader获取送入网络中的数据
-
2 模型参数加载
- 指定训练好的模型参数的路径
- 加载模型结构(与训练阶段是一样的),并加载模型参数
- 将模型设置为预测模式,并写入到设备中
-
代码实现
```python
# 1.数据加载
# 设置测试数据集路径
test_data_dir = 'wheatData/test'
# 加载数据
test_data = pd.read_csv('wheatData/submission.csv')
print(test_data.tail())
# 实例化数据读取类
test_data = Wheat(test_data, test_data_dir, phase="test", transforms=Wheat.get_test_transform())
def collate_fn(batch):
return tuple(zip(*batch))
# 设置batch_size
batchsize = 2
# 加载测试集数据
test_data_loader = DataLoader(
# 测试数据
test_data,
# 批次大小
batch_size=batchsize,
# 测试集不需要打乱
shuffle=False,
# 不满batch的数据依然要进行预测
drop_last=False,
collate_fn=collate_fn
)
# 2.模型参数加载
# 指明模型参数的路径
weight_dir = 'weights/fasterrcnn_resnet50_fpn.pth'
# 2.加载训练好的模型
# 设置设备信息
device = torch.device('cuda') if torch.cuda.is_available() else torch.device('cpu')
# 构建fasterRCNN模型
model = torchvision.models.detection.fasterrcnn_resnet50_fpn(pretrained=False, pretrained_backbone=False)
# 类别个数:N+1
num_classes = 2
# 获取输出层输入特征向量的维度
in_features = model.roi_heads.box_predictor.cls_score.in_features
# 构建fasterRCNN的输出端
model.roi_heads.box_predictor = FastRCNNPredictor(in_features, num_classes)
print("当前任务的输出端{}".format(model.roi_heads.box_predictor))
# 加载训练好的参数
model.load_state_dict(torch.load(weight_dir, map_location=device))
# 模型预测模式
model.eval()
# 将模型写入到设备中
model.to(device)
```
### 3、模型预测
-
基本流程
- 设置预测的置信度阈值
- 遍历每个batch的图片进行预测
- 遍历预测结果,使用置信度阈值进行筛选
-
代码实现
```python
类别概率的阈值
score_threshold = 0.7
存放预测结果
image_outputs = []
遍历每个批次的测试数据
for images, image_ids in test_data_loader:
# 获取每一幅图片并写入到设备中
images = list(image.to(device) for image in images)
# 模型预测返回结果
outputs = model(images)
# 遍历图像和预测结果
for image_id, output in zip(image_ids, outputs):
# 框
boxes = output['boxes'].data.cpu().numpy()
# 类别概率值
scores = output['scores'].data.cpu().numpy()
# 使用预测进行筛选
mask = scores >= score_threshold
# 获取最终的检测框和类别概率值
boxes = boxes[mask].astype(np.int32)
scores = scores[mask]
# 添加到列表中进行保存
image_outputs.append((image_id, boxes, scores))
```
#### 课堂笔记
05-目标检测-YOLO系列
计算机视觉基础CV笔记
一、今日课程内容
- yolo网络架构,及其输入输出(了解)
- yolo模型的训练样本构建的方法(了解)
- yolo模型的损失函数(了解)
- yoloV2模型的改进方法
- yoloV3模型的网络结构及网络输出
- yoloV3模型正负样本设计和损失函数的计算
二、yolo算法(了解)
1、基本内容
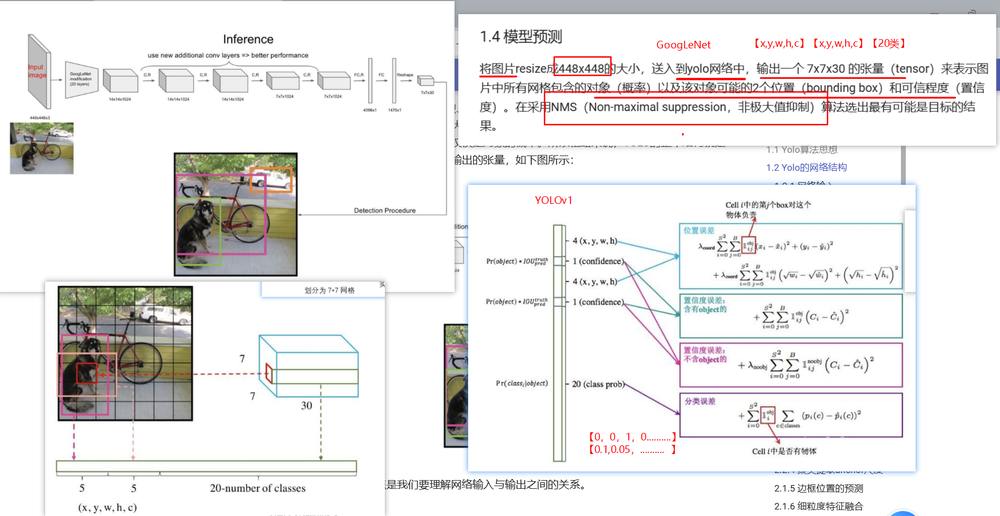
- (You Only Look Once),采用一个单独的CNN模型实现end-to-end的目标检测
- 核心思想:利用整张图作为网络的输入,直接在输出层回归 bounding box(边界框) 的位置及其所属的类别
- 创造性的将候选区和目标分类合二为一,看一眼图片就能知道有哪些对象以及它们的位置。
- 采用预定义预测区域的方法来完成目标检测,具体而言是将原始图像划分为 7x7=49 个网格(grid),每个网格允许预测出2个边框(bounding box,包含某个对象的矩形框),总共 49x2=98 个bounding box。我们将其理解为98个预测区,很粗略的覆盖了图片的整个区域,就在这98个预测区中进行目标检测。
2、损失函数
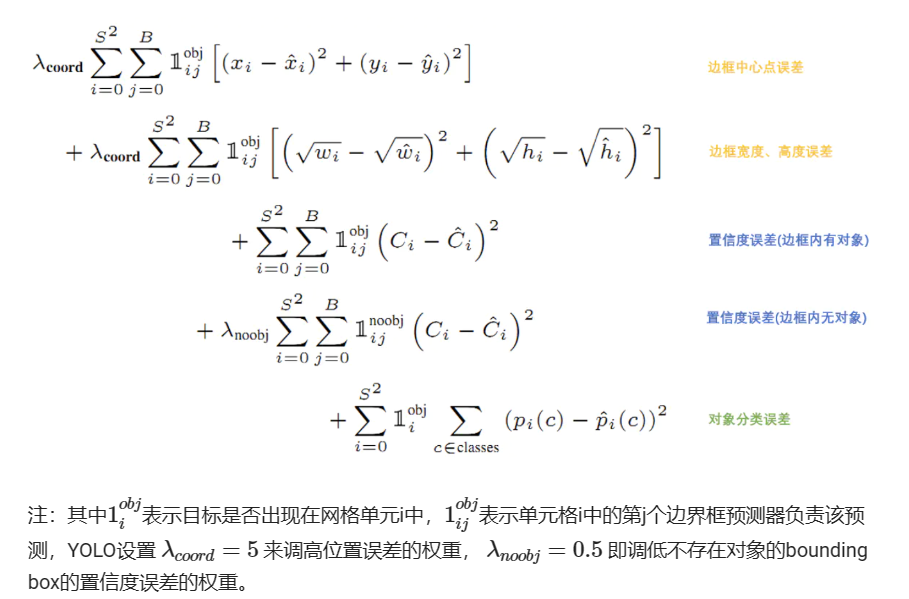
3、模型预测
- 将图片resize成448x448的大小,送入到yolo网络中
- 输出一个 7x7x30 的张量(tensor)来表示图片中所有网格包含的对象(概率)以及该对象可能的2个位置(bounding box)和可信程度(置信度)。
- 再采用NMS(Non-maximal suppression,非极大值抑制)算法选出最有可能是目标的结果。
4、总结
优点
- 速度非常快,处理速度可以达到45fps,其快速版本(网络较小)甚至可以达到155fps。
- 训练和预测可以端到端的进行,非常简便。
缺点
- 准确率会打折扣
- 对于小目标和靠的很近的目标检测效果并不好
三、YOLOv2(了解)
1、基本内容
- 相对v1版本,在继续保持处理速度的基础上,从预测更准确(Better),速度更快(Faster),识别对象更多(Stronger)这三个方面进行了改进
- 识别更多对象也就是扩展到能够检测9000种不同对象,称之为YOLO9000
- 优化点:
- batch normalization
- 使用高分辨率图像微调分类模型
- 采用Anchor Boxes
- 聚类提取anchor尺度
- 边框位置的预测
- 细粒度特征融合
- 多尺度训练
四、YOLOv3(了解)
1、基本内容
-
以V1,V2为基础进行的改进,主要有:利用多尺度特征进行目标检测;先验框更丰富;调整了网络结构;对象分类使用logistic代替了softmax,更适用于多标签分类任务。
-
相比之前的算法,尤其是针对小目标,精度有显著提升。
- 网络结构
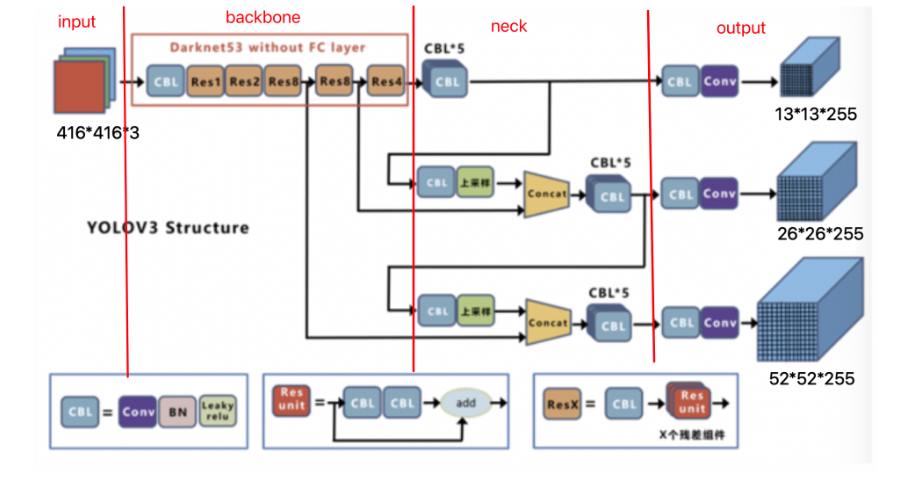
- 整个v3结构里面,没有池化层和全连接层,网络的下采样是通过设置卷积的步长为2来达到的,每当通过这个卷积层之后图像的尺寸就会减小到一半。
- 基本组件
- 1、CBL:Yolov3网络结构中的最小组件,由Conv+Bn+Leaky_relu激活函数三者组成。
- 2、Res unit:借鉴Resnet网络中的残差结构,让网络可以构建的更深。
- 3、ResX:由一个CBL和X个残差组件构成,是Yolov3中的大组件。每个Res模块前面的CBL都起到下采样的作用,因此经过5次Res模块后,得到的特征图是416->208->104->52->26->13大小。
- 网络输入:在V3版本中默认是416x416。
- Backbone:采用了Darknet-53的网络结构(含有53个卷积层),借鉴了残差网络ResNet的做法,在层之间设置了shortcut,来解决深层网络梯度的问题
- neck部分:引入了FPN网络进行特征融合,并获取多种尺度的特征图,进而完成多尺度检测
- 输出部分:采用K-means聚类得到先验框的尺寸,为每种尺度设定3种先验框,总共聚类出9种尺寸的先验框。
- 网络训练
- 正负样本
- 正样本:首先计算目标中心点落在哪个grid上,然后计算这个grid对应的3个先验框(anchor)和目标真实位置的IOU值,取IOU值最大的先验框和目标匹配。那么该anchor 就负责预测这个目标,那这个anchor就作为正样本,将其置信度设为1,其他的目标值根据标注信息设置。
- 负样本:所有不是正样本的anchor都是负样本,将其置信度设为0,参与损失计算,其它的值不参与损失计算,默认为0
- 损失函数
- box的损失
- 置信度的损失
- 分类的损失
-
基本流程
- 根据训练集的标注信息获取每幅图像对应的目标值,即设置正负样本(三个尺度的目标值)
- 将图像送入网络中进行预测,计算预测结果与目标值之间的差异(损失函数)
- 反向传播更新参数,直到损失收敛。
-
模型预测
- 图片resize成416x416的大小,送入到yoloV3网络中,输出3个尺度的预测结果,每个结果中包含边框坐标(4个数值),边框置信度(1个数值),对象类别的概率(对于COCO数据集,有80种对象)。
- 筛选出置信度较高的检测结果(>0.5),在采用NMS(Non-maximal suppression,非极大值抑制)算法选出最有可能是目标的结果,就完成了目标的检测
06-目标检测-YOLOv4算法详解
计算机视觉基础CV笔记
一、今日课程内容
- yoloV4网络架构(了解)
- 目标检测中常见的数据增强方法(掌握)
- yoloV4的损失函数的计算方法(掌握)
二、算法简介(了解)
1、基本内容
- YOLO之父在2020年初宣布退出CV界,YOLOv4 的作者并不是YOLO系列 的原作者
- 得到了Joseph Redmon的官方认可,被认为是当时最强的实时对象检测模型之一
- 作者总结了目标检测的各种技巧,然后经过筛选,排列组合,挨个实验(ablation study)哪些方法有效,提升了yolo在COCO数据集上的检测效果。
- 在COCO数据集上,yoloV4的检测速度和检测精度都有较大的提升。
三、YOLOv4的网络结构(了解)
1、基本内容
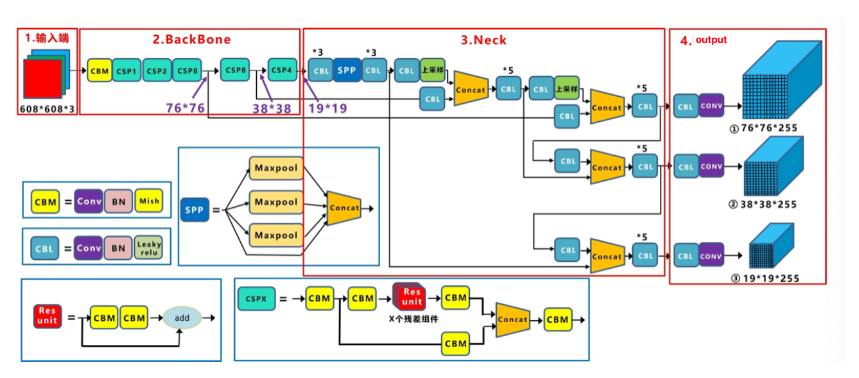
- 整体架构与YOLOv3相似
-
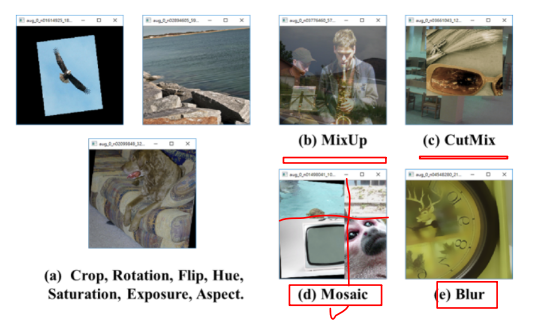
-
基本组件:
- CBM:Yolov4网络结构中的最小组件,由Conv+Bn+Mish激活函数三者组成。
- CBL:由Conv+Bn+Leaky_relu激活函数三者组成。
- Res unit:借鉴Resnet网络中的残差结构,让网络可以构建的更深。
- CSPX:由三个卷积层和X个Res unint模块Concate组成。
-
SPP:采用1×1,5×5,9×9,13×13的最大池化的方式,进行多尺度融合。
-
其他基础操作:
- Concat:张量拼接,通道维度会扩充。
- Add:张量相加,不会扩充维度。
-
Backbone中卷积层的数量: 每个CSPX中包含3+2×X个卷积层,因此整个主干网络Backbone中一共包含2+(3+2×1)+2+(3+2×2)+2+(3+2×8)+2+(3+2×8)+2+(3+2×4)+1=72。
-
基本架构
- 输入(input)
- backbone
- neck
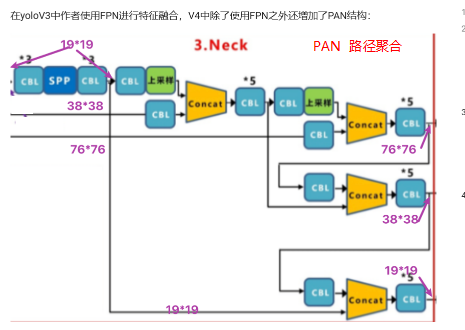
- 输出(output)
四、模型训练(了解)
1、基本内容
- 正负样本的设置方式,损失函数的构成及训练过程与YOLOv3一致
- 唯一不同是在计算回归值得损失时,V4中采用了IOU的损失
2、IOU损失
- GIOU损失
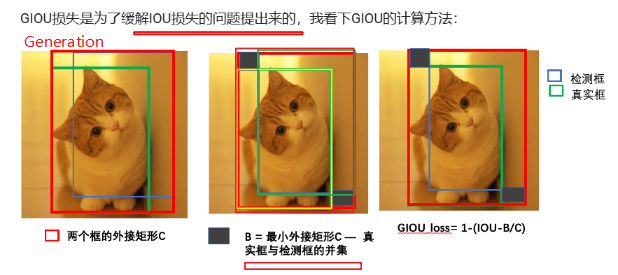
- DIOU损失
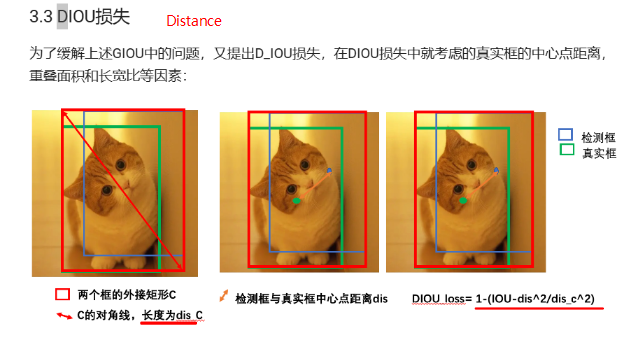
- CIOU损失
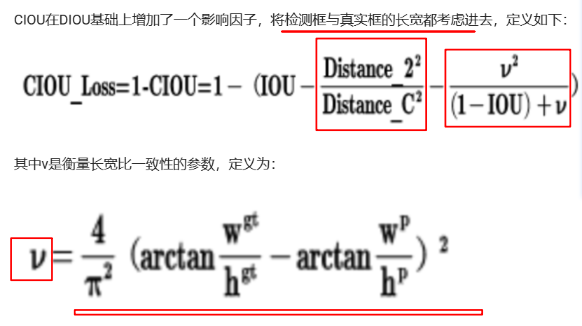
- .........
五、模型预测
- 将图片resize成608x608【32倍数】的大小,送入到yoloV4网络中,输出3个尺度的预测结果,每个结果中包含边框坐标(4个数值),边框置信度(1个数值),对象类别的概率(对于COCO数据集,有80种对象)。
- 筛选出置信度较高的检测结果(>0.5),在采用DIOU-NMS算法选出最有可能是目标的结果,就完成了目标的检测。
07-目标检测-YOLOv5算法详解及案例
计算机视觉基础CV笔记
一、今日课程内容
- YOLOv5网络架构(了解)
- YOLOv5中使用的策略(掌握)
- 能够使用YOLOv5框架进行目标检测(掌握)
二、YOLOv5模型介绍(了解)
1、基本内容
- 基于pytorch实现
- 包含多种类型的网络结构,按模型大小从小到大是yoloV5n,yoloV5s,yoloV5m,yoloV5l,yoloV5x
2、网络架构
- 基本组件:
- CBL:由Conv+Bn+Leaky_relu激活函数三者组成。
- Res unit:借鉴Resnet网络中的残差结构,让网络可以构建的更深。
- CSP1_X:由三个卷积层和X个Res unint模块Concate组成,模型实现使用C3来完成,将shortcut设为True即可
- CSP2_X:这个在V4中没有使用,由三个卷积层和2X个Res unint模块Concate组成,模型实现使用C3来完成,将shortcut设为False即可
-
SPPF:V4中使用的SPP进行融合,在这里采用1x1卷积和3个串联的5x5的最大池化的方式,进行多尺度融合。
-
其他基础操作:
- Concat:张量拼接,通道维度会扩充。
-
Add:张量相加,不会扩充维度。
-
基础结构
- 输入(input)
- backbone
- neck
- 输出(output)
3、模型训练
- anchor的自动调整
- 正负样本的设计
4、模型预测
- 将图片resize后,送入到yoloV5网络中,输出3个尺度的预测结果,每个结果中包含边框坐标(4个数值),边框置信度(1个数值),对象类别的概率(对于COCO数据集,有80种对象)。
- 筛选出置信度较高的检测结果(>0.5),在采用NMS算法选出最有可能是目标的结果,就完成了目标的检测。
三、案例实现(掌握)
1、数据构建
- 数据标注:labelImg
- 数据加载:coco128.yaml
2、模型选择(构建)
- yolov5-master/models文件夹中yaml文件
3、模型训练
4、模型预测
目标检测代码(IoU/NMS/FasterRCNN/YOLO)
154 个文件📁 yolov5-master/
📁 .github/
📁 ISSUE_TEMPLATE/
- 📄 bug-report.yml 2.9KB 下载
- 📄 config.yml 360B 下载
- 📄 feature-request.yml 1.7KB 下载
- 📄 question.yml 1.1KB 下载
📁 workflows/
- 📄 ci-testing.yml 6.8KB 下载
- 📄 cla.yml 1.6KB 下载
- 📄 codeql-analysis.yml 2.0KB 下载
- 📄 docker.yml 1.7KB 下载
- 📄 format.yml 1.0KB 下载
- 📄 greetings.yml 5.4KB 下载
- 📄 links.yml 2.4KB 下载
- 📄 merge-main-into-prs.yml 1.7KB 下载
- 📄 stale.yml 2.3KB 下载
- 📄 dependabot.yml 647B 下载
📁 classify/
- 📄 predict.py 11.7KB 下载
- 📄 train.py 16.0KB 下载
- 📄 tutorial.ipynb 101.2KB 下载
- 📄 val.py 7.9KB 下载
📁 data/
📁 hyps/
- 📄 hyp.Objects365.yaml 674B 下载
- 📄 hyp.VOC.yaml 1.1KB 下载
- 📄 hyp.no-augmentation.yaml 1.6KB 下载
- 📄 hyp.scratch-high.yaml 1.6KB 下载
- 📄 hyp.scratch-low.yaml 1.6KB 下载
- 📄 hyp.scratch-med.yaml 1.6KB 下载
📁 scripts/
- 📄 download_weights.sh 641B 下载
- 📄 get_coco.sh 1.5KB 下载
- 📄 get_coco128.sh 619B 下载
- 📄 get_imagenet.sh 1.6KB 下载
- 📄 get_imagenet10.sh 734B 下载
- 📄 get_imagenet100.sh 738B 下载
- 📄 get_imagenet1000.sh 742B 下载
- 📄 AI_coco128.yaml 1.8KB 下载
- 📄 Argoverse.yaml 2.7KB 下载
- 📄 GlobalWheat2020.yaml 1.8KB 下载
- 📄 ImageNet.yaml 18.4KB 下载
- 📄 ImageNet10.yaml 932B 下载
- 📄 ImageNet100.yaml 2.6KB 下载
- 📄 ImageNet1000.yaml 18.4KB 下载
- 📄 Objects365.yaml 9.0KB 下载
- 📄 SKU-110K.yaml 2.3KB 下载
- 📄 VOC.yaml 3.4KB 下载
- 📄 VisDrone.yaml 2.9KB 下载
- 📄 coco.yaml 2.4KB 下载
- 📄 coco128-seg.yaml 1.8KB 下载
- 📄 coco128.yaml 1.8KB 下载
- 📄 xView.yaml 5.0KB 下载
- 📄 zcy880.yaml 14.6KB 下载
📁 models/
📁 hub/
- 📄 anchors.yaml 3.3KB 下载
- 📄 yolov3-spp.yaml 1.6KB 下载
- 📄 yolov3-tiny.yaml 1.2KB 下载
- 📄 yolov3.yaml 1.5KB 下载
- 📄 yolov5-bifpn.yaml 1.4KB 下载
- 📄 yolov5-fpn.yaml 1.2KB 下载
- 📄 yolov5-p2.yaml 1.7KB 下载
- 📄 yolov5-p34.yaml 1.2KB 下载
- 📄 yolov5-p6.yaml 1.7KB 下载
- 📄 yolov5-p7.yaml 2.1KB 下载
- 📄 yolov5-panet.yaml 1.4KB 下载
- 📄 yolov5l6.yaml 1.8KB 下载
- 📄 yolov5m6.yaml 1.8KB 下载
- 📄 yolov5n6.yaml 1.8KB 下载
- 📄 yolov5s-LeakyReLU.yaml 1.5KB 下载
- 📄 yolov5s-ghost.yaml 1.5KB 下载
- 📄 yolov5s-transformer.yaml 1.4KB 下载
- 📄 yolov5s6.yaml 1.8KB 下载
- 📄 yolov5x6.yaml 1.8KB 下载
📁 segment/
- 📄 yolov5l-seg.yaml 1.4KB 下载
- 📄 yolov5m-seg.yaml 1.4KB 下载
- 📄 yolov5n-seg.yaml 1.4KB 下载
- 📄 yolov5s-seg.yaml 1.4KB 下载
- 📄 yolov5x-seg.yaml 1.4KB 下载
- 📄 AI_yolov5s.yaml 1.4KB 下载
- 📄 __init__.py 0B 下载
- 📄 common.py 49.4KB 下载
- 📄 experimental.py 5.1KB 下载
- 📄 tf.py 31.2KB 下载
- 📄 yolo.py 20.1KB 下载
- 📄 yolov5l.yaml 1.4KB 下载
- 📄 yolov5m.yaml 1.4KB 下载
- 📄 yolov5n.yaml 1.4KB 下载
- 📄 yolov5s.yaml 1.4KB 下载
- 📄 yolov5x.yaml 1.4KB 下载
📁 segment/
- 📄 predict.py 15.8KB 下载
- 📄 train.py 34.2KB 下载
- 📄 tutorial.ipynb 42.4KB 下载
- 📄 val.py 23.6KB 下载
📁 utils/
📁 aws/
- 📄 __init__.py 0B 下载
- 📄 mime.sh 780B 下载
- 📄 resume.py 1.2KB 下载
- 📄 userdata.sh 1.2KB 下载
📁 docker/
- 📄 Dockerfile 2.5KB 下载
- ⚙️ Dockerfile-arm64 1.5KB 下载
- ⚙️ Dockerfile-cpu 1.8KB 下载
📁 flask_rest_api/
- 📄 README.md 1.7KB 下载
- 📄 example_request.py 368B 下载
- 📄 restapi.py 1.5KB 下载
📁 google_app_engine/
- 📄 Dockerfile 821B 下载
- 📄 additional_requirements.txt 186B 下载
- 📄 app.yaml 174B 下载
📁 loggers/
- 📄 __init__.py 19.6KB 下载
📁 segment/
- 📄 __init__.py 0B 下载
- 📄 augmentations.py 3.6KB 下载
- 📄 dataloaders.py 13.0KB 下载
- 📄 general.py 5.8KB 下载
- 📄 loss.py 8.9KB 下载
- 📄 metrics.py 5.5KB 下载
- 📄 plots.py 6.5KB 下载
- 📄 __init__.py 3.1KB 下载
- 📄 activations.py 4.5KB 下载
- 📄 augmentations.py 18.2KB 下载
- 📄 autoanchor.py 7.3KB 下载
- 📄 autobatch.py 3.0KB 下载
- 📄 callbacks.py 2.7KB 下载
- 📄 dataloaders.py 58.6KB 下载
- 📄 downloads.py 5.1KB 下载
- 📄 general.py 49.9KB 下载
- 📄 loss.py 10.9KB 下载
- 📄 metrics.py 15.1KB 下载
- 📄 plots.py 20.0KB 下载
- 📄 torch_utils.py 20.9KB 下载
- 📄 triton.py 3.7KB 下载
- 📄 .dockerignore 3.6KB 下载
- ⚙️ .gitattributes 75B 下载
- 📄 .gitignore 3.9KB 下载
- ⚙️ CITATION.cff 393B 下载
- 📄 CONTRIBUTING.md 4.9KB 下载
- 📄 LICENSE 33.7KB 下载
- 📄 README.md 41.4KB 下载
- 📄 README.zh-CN.md 41.3KB 下载
- 📄 YOLOv5_demo.py 1.8KB 下载
- 📄 benchmarks.py 7.9KB 下载
- 📄 detect.py 15.8KB 下载
- 📄 export.py 41.6KB 下载
- 📄 hubconf.py 8.6KB 下载
- 📄 main.sh 121B 下载
- 📄 pyproject.toml 5.3KB 下载
- 📄 requirements.txt 1.6KB 下载
- 📄 train.py 38.9KB 下载
- 📄 tutorial.ipynb 40.4KB 下载
- 📄 val.py 20.2KB 下载
- 📄 01.iou.py 1011B 下载
- 📄 02.nms.py 2.3KB 下载
- 📄 03.fasterRCNN.ipynb 1.5MB 下载
- 📄 03.fasterRCNN.py 3.4KB 下载
- 📄 04.fasterRCNN结构介绍.py 3.2KB 下载
- 📄 05.fasterRCNN训练.py 3.7KB 下载
- ⚙️ img.jpg 245.9KB 下载
- ⚙️ img1.jpg 161.0KB 下载
- ⚙️ img2.jpg 182.6KB 下载
- ⚙️ img3.jpg 154.7KB 下载
- 📄 voc_data_util.py 3.8KB 下载
- 📄 yolo_detect.py 937B 下载