第 2 节 / 共 4 节
计算机视觉:图像分类
01-计算机视觉基础知识
计算机视觉基础CV笔记
一、今日课程内容
- 计算机视觉的定义(了解)
- 计算机视觉常见任务(了解)
- 计算机视觉的应用场景(了解)
二、计算机视觉介绍(了解)
1、定义
- 用【摄像机和电脑】及其他相关设备,对【生物视觉】的一种模拟,任务:理解图片和视频
2、主要任务
- 让【计算机】理解【图片或者视频】中的内容,就像人类和许多其他生物每天所做的那样。
3、任务目标
- 让计算机【理解】图片中的场景(办公室,客厅,咖啡厅等)
- 让计算机【识别】场景中包含的物体(宠物,交通工具,人等)
- 让计算机【定位】物体在图像中的位置(物体的大小,边界等)
- 让计算机理解物体之间的【关系或行为】(是在对话,比赛或吵架等),以及图像表达的意义(喜庆的,悲伤的等)
三、计算机视觉常见任务(了解)
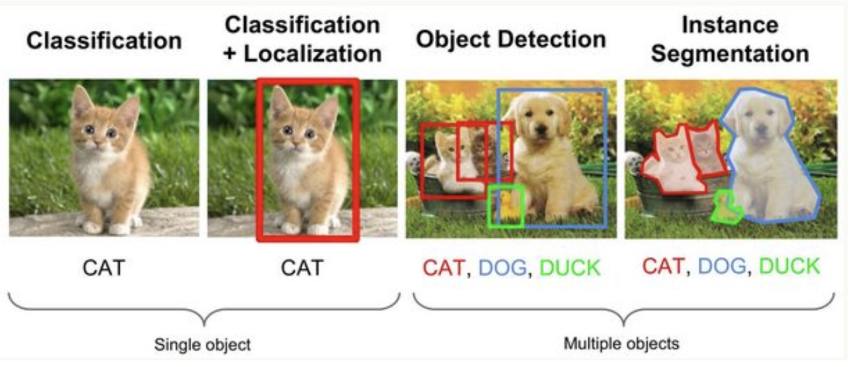
1、三大经典任务
-
图像分类(Classification)
-
将图像结构化为某一【类别】的信息,用事先确定好的【类别】(category)来描述图片。
-
分类任务关心【整体】,给出的是整张图片的【内容描述】。
-
目标检测(Detection)
-
将图像中的某一目标的【类别】信息和【位置】信息获取到
-
关注【特定】的物体目标的类别信息和位置信息(classification + localization)。
-
图像分割(Segmentation)
-
赋予每个像素类别(实例)意义,适用于理解要求较高的场景,如无人驾驶中对道路和非道路的分割。
- 是对图像的【像素级】描述
四、计算机视觉的应用场景(了解)
1、基本内容
- 涉及的领域复杂,具有广泛的实际应用范围,从电子商务行业到更经典的各种类型和规模的公司都可以利用其强大的功能
- 代表企业:
- “CV四小天鹅” “AI四小龙”(商汤科技、旷视科技、云从科技、依图科技)
- 人脸识别:旷视科技、依图科技、商汤科技、深醒科技、云从科技等。
- 视频监控:商汤科技、DeepGlint 格灵深瞳、依图科技、云天励飞、深网视界
- 辅助驾驶(纵目科技、TuSimple 图森科技、驭势科技、MINIEYE 佑驾创新、中天安驰)
2、发展史
- CV领域的第一篇专业论文:
1963年,Larry Roberts发表,用以对简单几何体进行边缘提取和三维重建。 - 计算机视觉作为一个科学领域的正式诞生:
1966年,麻省理工学院(MIT)发起了一个夏季项目,目标是搭建一个机器视觉系统,完成模式识别(pattern recognition)等工作。 -
计算机视觉成为了一门独立学科:
1982年,学者David Marr发表的著作《Vision》从严谨又长远的角度给出了CV的发展方向和一些基本算法,其中不乏现在为人熟知的“图层”的概念、边缘提取、三维重建等 -
SIFT(尺度不变特征变换):
1999年David Lowe提出了尺度不变特征变换(SIFT, Scale-invariant feature transform)目标检测算法,用于匹配不同拍摄方向、纵深、光线等图片中的相同元素。 -
HOG(方向梯度直方图Histogram of Oriented Gradient):
2009年,由Felzenszwalb教授在提出基于HOG的deformable parts model,可变形零件模型开发,它是深度学习之前最好的最成功的objectdetection & recognition算法。 -
PASCAL:
2006年至2012年间,Everingham等人搭建了一个大型图片数据库,供机器识别和训练,称为PASCAL Visual Object Challenge,该数据库中有20种类别的图片,每种图片数量在一千至一万张不等。 -
ImageNet:
2009年,李飞飞教授等在CVPR2009上发表了一篇名为《ImageNet: A Large-Scale Hierarchical Image Database》的论文,发布了ImageNet数据集,这是为了检测计算机视觉能否识别自然万物,回归机器学习,克服过拟合问题。 -
AlexNet:
2012 年,Alex Krizhevsky、Ilya Sutskever 和 Geoffrey Hinton 创造了一个“大型的深度卷积神经网络”,也即现在众所周知的 AlexNet,赢得了当年的 ILSVRC。这是史上第一次有模型在 ImageNet 数据集表现如此出色。自那时起,CNN 才成了家喻户晓的名字。 -
生成对抗网络(GAN):
2014年,蒙特利尔大学提出生成对抗网络(GAN):拥有两个相互竞争的神经网络可以使机器学习得更快。一个网络尝试模仿真实数据生成假的数据,而另一个网络则试图将假数据区分出来。随着时间的推移,两个网络都会得到训练,生成对抗网络(GAN)被认为是计算机视觉领域的重大突破。 -
视频到视频生成(Video-to-Video synthesis):
2018年末,英伟达发布的视频到视频生成(Video-to-Video synthesis),它通过精心设计的发生器、鉴别器网络以及时空对抗物镜,合成高分辨率、照片级真实、时间一致的视频,实现了让AI更具物理意识,更强大,并能够推广到新的和看不见的更多场景。 -
BigGAN:
2019年,更强大的GAN,BigGAN,是拥有了更聪明的学习技巧的GAN,由它训练生成的图像连它自己都分辨不出真假,因为除非拿显微镜看,否则将无法判断该图像是否有任何问题,因而,它更被誉为史上最强的图像生成器.
02-图像分类-图像分类简介
计算机视觉基础CV笔记
一、今日课程内容
- 图像分类的目的(了解)
- CIFAR数据集(了解)
- ImageNet数据集(了解)
- 鲜花分类数据集(了解)
二、图像分类的目的(了解)
1、定义
- 从给定的【类别集合】中为图像分配对应【标签】的任务
- 分析一个【输入图像】并返回一个该图像类别的【标签】
2、主要任务
- 模型给图像分配多个标签,每个标签的【概率值】不同
- 选取【概率值】最大的类别作为标签
三、常用数据集(了解)
1、CIFAR-10和CIFAR-100
-
CIFAR-10
-
5w+张训练图像、1w+张测试图像、10个类别、每个类别有6k个图像
-
图像大小:【32x32】×3
-
CIFAR-100
-
5w+张训练图像、1w+张测试图像、包含100个类别
-
图像大小:【32x32】×3
-
数据加载(torchvision)
-
导入依赖包:【import torchvision】
- 调用接口函数:【torchvision.datasets.CIFAR10(root=root,train=True,download=True)】
- root:【数据集路径】
- train:【True/False 是否是训练集】
- download:【True/False,是否下载数据】
2、ImageNet
-
【ILSVRC】(ImageNet Large-Scale Visual Recognition Challenge)使用的数据集
-
斯坦福大学李飞飞教授主导
-
包含超过1400万张全尺寸的有标记图片,大约有【22000】个类别的数据。比赛数据集选用其中【1000】类
-
举办时间:2010年~2017年
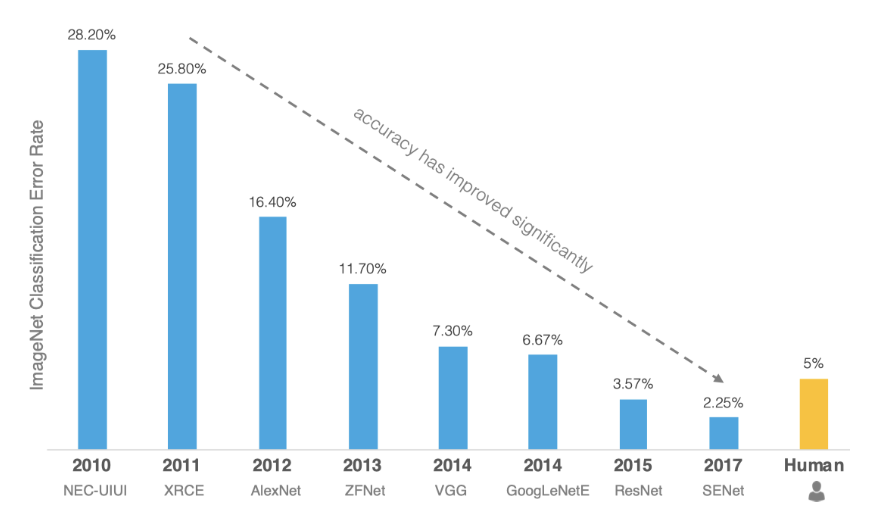
- ILSVRC历届冠军
- 2012年:冠军是
AlexNet,由于准确率远超传统方法的第二名(top5错误率为15.3%,第二名为26.2%),引起了很大的轰动。自此之后,CNN成为在图像识别分类的核心算法模型,带来了深度学习的大爆发。 - 2013年:冠军是
ZFNet,结构和AlexNet区别不大,分类效果也差不多。 - 2014年:亚军是
VGG网络,网络结构十分简单,因此至今VGG-16仍在广泛使用。 - 2014年:冠军网络是
GoogLeNet,核心模块是Inception Module。Inception历经了V1、V2、V3、V4等多个版本的发展,不断趋于完善。GoogLeNet取名中L大写是为了向LeNet致敬,而Inception的名字来源于盗梦空间中的"we need to go deeper"梗。 - 2015年:冠军网络是
ResNet。核心是带短连接的残差模块,其中主路径有两层卷积核(Res34),短连接把模块的输入信息直接和经过两次卷积之后的信息融合,相当于加了一个恒等变换。短连接是深度学习又一重要思想,除计算机视觉外,短连接思想也被用到了机器翻译、语音识别/合成领域 - 2017年:冠军
SENet是一个模块,可以和其他的网络架构结合,比如GoogLeNet、ResNet等。
3、鲜花分类数据集
-
3670 张图像,其中训练图像和测试图像分别为 3306 张和 364张
-
5 种类型:菊花,蒲公英,玫瑰,向日葵、郁金香
-
数据集解析:
-
导入依赖包:from torchvision.datasets import ImageFolder
-
获取数据:flowers_train = ImageFolder(root, transform=dataset_transform)
-
root:数据路径
-
transform:数据转换处理,例如类型转换、尺寸调整
python # 先将数据转换为tensor类型,并调整数据的大小为224x224 dataset_transform = torchvision.transforms.Compose([ torchvision.transforms.ToTensor(), torchvision.transforms.Resize((224,224)) -
-
获取数据集样本数量
python len(flowers_train.imgs) len(flowers_test.imgs) -
展示数据
python
import matplotlib.pyplot as plt
plt.imshow(flowers_train.__getitem__(3000)[0].permute(1,2,0))
plt.show()
03-图像分类-AlexNet
计算机视觉基础CV笔记
一、今日课程内容
- AlexNet网络背景及模型地位(了解)
- AlexNet网络结构(理解)
- 利用AlexNet完成图像分类(操作+掌握)
二、AlexNet模型背景及模型地位(了解)
1、AlexNet模型背景
(1)发表时间:【2012】
(2)模型名称来源:【论文第一作者的姓名Alex Krizhevsky】
(3)模型荣誉:【赢得了ImageNet 2012图像识别挑战赛】
2、AlexNet模型地位
(1)首次证明:【学习到的特征可以超越手工设计的特征】
(2)时代里程碑:【一举打破计算机视觉研究的方向,计算机视觉进入CNN时代】
三、AlexNet网络结构(理解)
1、网络结构
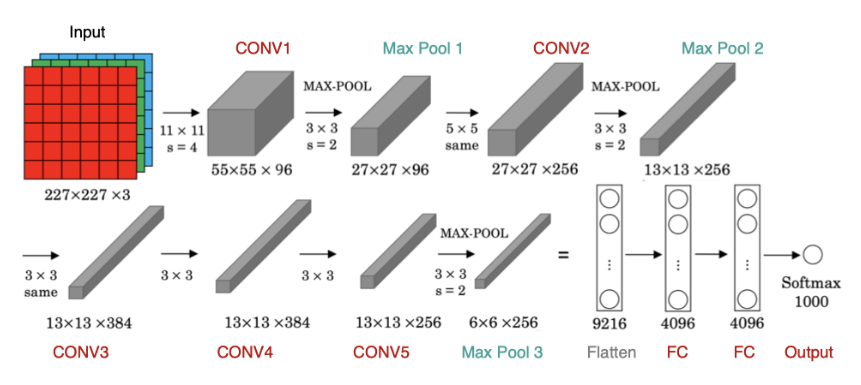
2、网络特点
(1)网络层数:【8】
(2)卷积层和池化层参数:【卷积核:11,5,3 池化:3X3 ,步长2】
(3)激活函数:【ReLU】
(4)模型复杂度调节:【Dropout】
(5)缓解过拟合操作:【引入了大量的图像增强,如翻转、裁剪和颜色变化,扩大数据集】
3、网络层参数计算
(1)计算公式
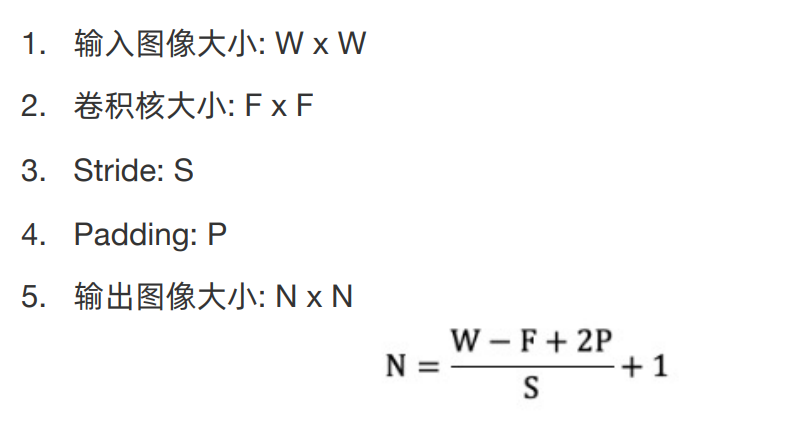
(2)AlexNet网络层计算
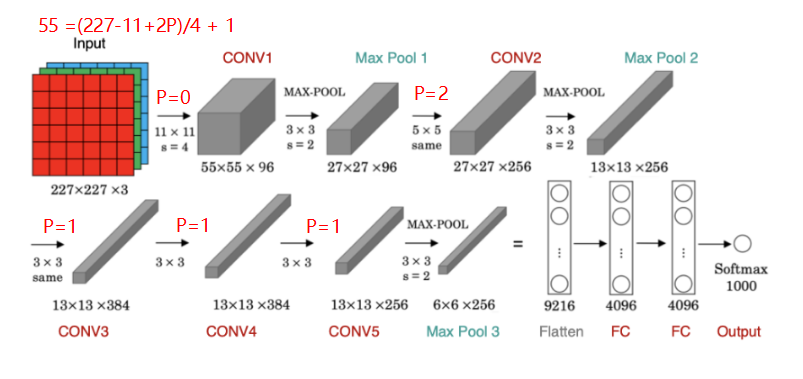
4、Pytorch构建AlexNet网络流程
(1)网络构建基本方法
-
一个继承:【继承自类nn.Module】
-
两个方法:【__init__和forward方法】
(2)网络构建代码架构
# 1 导入工具包
import torch
from torch import nn

# 2 定义网络类
class AlexNet(nn.Module):
    # 3 构建网络层
    def __init__(self,in_dim,n_class):
        super().__init__()
        # 卷积部分
        self.conv = nn.Sequential(【代码块】)
        # 全连接部分
        self.fc = nn.Sequential(【代码块】)
    # 4 构建前向传播
    def forward(self, x):
        【代码块】
        return out
(3)完整代码
# AlexNet 模型构建
# 1 导入工具包
import torch
from torch import nn

# 2 定义网络类
class AlexNet(nn.Module):
    # 3 构建网络层
    def __init__(self,in_dim,n_class):
        super().__init__()
        # 卷积部分
        self.conv = nn.Sequential(
            nn.Conv2d(in_channels=in_dim,out_channels=96,kernel_size=11,stride=4,padding=0),
            nn.ReLU(inplace=True),
            nn.MaxPool2d(kernel_size=3,stride=2),
            nn.Conv2d(96,256,5,1,2),
            nn.ReLU(True),
            nn.MaxPool2d(3,2),
            nn.Conv2d(256,384,3,1,1),
            nn.ReLU(True),
            nn.Conv2d(384, 384, 3, 1, 1),
            nn.ReLU(True),
            nn.Conv2d(384, 256, 3, 1, 1),
            nn.ReLU(True),
            nn.MaxPool2d(3,2)
        )
        # 全连接部分
        self.fc = nn.Sequential(
            nn.Linear(9216,4096),
            nn.ReLU(True),
            nn.Dropout(0.5),
            nn.Linear(4096,4096),
            nn.ReLU(True),
            nn.Dropout(0.5),
            nn.Linear(4096,n_class)

        )
    # 4 构建前向传播
    def forward(self, x):
        # 输入数据送入卷积部分进行处理
        x = self.conv(x)
        #将特征图抻成一维向量
        x = x.view(x.size(0), -1)
        # 全连接层获取输出结果
        output = self.fc(x)
        return output
(4)查看网络架构(代码)
调用模块介绍
from torchsummary import summary
# 【参数解读】
summary(model, input_size, batch_size, device)
代码实操
import torch
from torchsummary import summary

# 模型实例化
net = Alexnet(3,1000)
# 查看网络的形状
summary(model=net,input_size=(3,227,227),batch_size=1,device='cpu')
四、利用AlexNet完成图像分类(操作+掌握)
1、基本流程
【数据读取】—>【模型实例化和参数设置】—>【定义模型评估方法】—>【模型训练】
2、读取数据
(1)代码架构
# 数据获取
# 1 指定数据集路径
# 2 定义数据处理方法(resize)
# 3 ImageFolder读取数据
# 4 DataLoader获取batch数据
(2)完整代码
from torchvision import transforms
from torch.utils.data import DataLoader
from torchvision.datasets import ImageFolder
# 指定批次大小
batch_size = 2
# 指定数据集路径
flower_train_path = './dataset/flower_datas/train/'
flower_test_path = './dataset/flower_datas/val/'
# 先将数据转换为tensor类型,并调整数据的大小为227x227
dataset_transform = transforms.Compose(
    [transforms.ToTensor(),
     transforms.Resize((227, 227))])
# 获取训练集数据和测试集数据
flower_train = ImageFolder(flower_train_path, transform=dataset_transform)
flower_test = ImageFolder(flower_test_path, transform=dataset_transform)
# 获取数据的迭代
train_loader = DataLoader(dataset=flower_train,
                          batch_size=batch_size,
                          shuffle=True)
test_loader = DataLoader(dataset=flower_ttest
                         batch_size=batch_size,
                         shuffle=False)
3、模型实例化和参数设置
(1)代码架构
# 模型实例化
# 1 模型实例化

# 参数设置
# 1 学习率lr设置
# 2 轮次设置
# 3 损失函数设置
# 4 优化器设置
(2)完整代码
# 模型实例化:输入数据3通道,进行5类的分类处理
model = Alexnet(3, 5)
# 模型训练的参数设置
# 学习率
learning_rate = 1e-3
# 训练轮数
num_epochs = 10
# 优化算法Adam = RMSProp + Momentum
optimizer = torch.optim.Adam(model.parameters(), lr=learning_rate)
# 交叉熵损失函数
loss_fn = torch.nn.CrossEntropyLoss()
4、定义模型评估方法
(1)代码架构
# 评估方法:准确率
# 1 定义模型准确率评估方法
def eval_acc(test_data,model):
    # 2 设置参数初始值(预测正确个数corr,预测总个数total)
    # 3 遍历数据,进行模型预测
    with torch.no_grad():
        model.eval()  # 将模型切换到评估模式
        【模型预测和准确率计算】
    return corr/total
(2)完整代码
# 计算模型预测精度:测试集数据,模型
def evaluate_accuracy(data_iter, model):
    total = 0
    correct = 0
    # 不进行梯度计算
    with torch.no_grad():
        # 模型是验证模式
        model.eval()
        # 获取每一个batch的数据,进行预测
        for images, labels in data_iter:
            outputs = model(images)
            # 获取预测结果
            _, predicts = torch.max(outputs.data, dim=1)
            # 预测的次数
            total += labels.size(0)
            # 预测正确的个数
            correct += (predicts == labels).cpu().sum()
    # 获取准确率
    return correct / total
5、模型训练
(1)代码架构
# 模型训练
# 1 定义train方法
def train(data_loader = flower_train_loader,model = model,optim = opti,loss_fn = loss):
    # 2 遍历每个轮次
    for epoch in range(num_epoch):
        # 3 定义参数初始值
        # 4 遍历每个batch
        for i,(image,targtes) in enumerate(data_loader):
            ## 将模型切换到训练模式
            model.train()
            # (1)模型前向传播计算
            # (2)损失计算
            # (3)优化器梯度归零
            # (4)反向传播
            # (5)参数更新

            ## 计算准确率,loss的变化
        # 5 评估模型效果
(2)完整代码
# 定义模型训练过程:指定数据集,优化器,损失函数和轮次
def train(data_loader=train_loader,
          optimizer=optimizer,
          loss_fn=loss_fn,
          epochs=num_epochs):
    # 遍历每一个轮次进行训练
    for epoch in range(epochs):
        print('current epoch = {}'.format(epoch))
        # 每一个轮次的损失,预测个数和预测正确个数的初始化
        train_accuracy_total = 0
        train_correct = 0
        # 损失和的初始化
        train_loss_sum = 0
        # 迭代次数
        iter = 0
        for i, (images, labels) in enumerate(data_loader):
            # 模型定义为训练模式
            model.train()
            # 对数据进行预测
            outputs = model(images)
            # 计算模型的损失
            loss = loss_fn(outputs, labels)
            # 在做反向传播前先清除网络状态
            optimizer.zero_grad()
            # 损失值进行反向传播
            loss.backward()
            # 参数迭代更新
            optimizer.step()
            # 求损失的和
            train_loss_sum += loss.item()
            # 输出模型预测结果
            _, predicts = torch.max(outputs.data, dim=1)
            # 获取训练集预测正确的个数
            train_accuracy_total += labels.size(0)
            train_correct += (predicts == labels).cpu().sum().item()
            iter += 1
        # 测试集预测的准确率
        test_acc = evaluate_accuracy(test_loader, model)
        print(f'epoch:{epoch},   loss:{train_loss_sum / iter:.4f},   train accuracy:{train_correct / train_accuracy_total:.3f},  test accuracy:{test_acc:.3f}')
    print('------------finish training-------------')


train()    # 99.99%   95% +
(3)运行结果
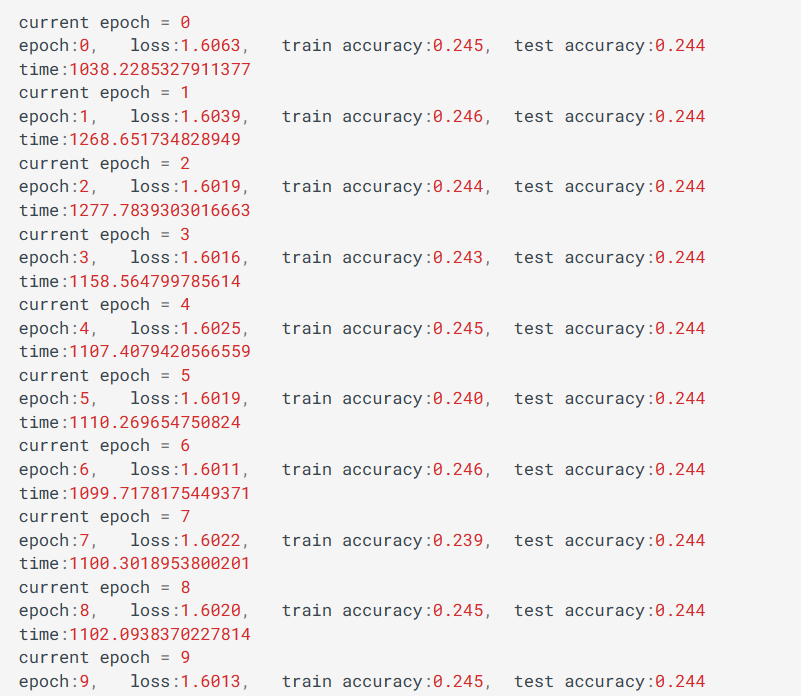
04-图像分类-VGG
计算机视觉基础CV笔记
一、今日课程内容
- VGG网络结构的特点(了解)
- 能够利用VGG完成图像分类(实操+掌握)
二、VGG的网络架构(了解)
1、基本内容
- 模型归属:牛津大学计算机视觉组(Visual Geometry Group)和 Google DeepMind公司的研究员
- 荣誉:ILSVRC2014比赛分类项目的第二名
- 特点:【3X3】的小卷积核 + 【2X2】的池化核,能够取得较好的识别精度
- 常用模型:
- VGG-16(【13】层卷积+2层全连接隐藏层+1层全连接输出层)
- VGG-19(【16】层卷积+2层全连接隐藏层+1层全连接输出层)
2、模型调用及查看
- 模型调用:
python
  import torch
  import torchvision.models as models
  # 模型实例化
  model = models.vgg16()
- 模型架构查看
python
  from torchsummary import summary
  # 通过net.summay()查看网络的形状
  summary(model=model,input_size=(3,224,224),batch_size=1,device='cpu')
三、鲜花种类识别案例(实操+掌握)
1、读取数据
-
图像Resize:224 X 224
-
读取数据
```python
# 1.导入依赖包
from torchvision import transforms
from torch.utils.data import DataLoader
from torchvision.datasets import ImageFolder
# 2.定义数据转换方式
dataset_transform = transforms.Compose(
[transforms.ToTensor(),
transforms.Resize((224, 224))])
# 3.获取训练集数据和测试集数据,并进行数据转换
flower_train = ImageFolder(flower_train_path, transform=dataset_transform)
# 4.加载数据
train_loader = DataLoader(dataset=flower_train,
batch_size=batch_size,
shuffle=True)
```
- 展示数据
python
  # 1.导入依赖包
  import matplotlib.pyplot as plt
  # 2.定义图像和坐标1行2列
  fig, axes = plt.subplots(1, 2)
  # 3.展示图像
  axes.imshow(imgs.permute(1, 2, 0))
  plt.show()
2、模型实例化和参数设置
(1)代码架构
# 1.模型实例化:输入数据3通道,进行5类的分类处理
# 2.模型训练的参数设置
# 2.1 学习率
# 2.2 训练轮数
# 2.3 优化算法Adam = RMSProp + Momentum
# 2.4 交叉熵损失函数
(2)完整代码
# 1.模型实例化:输入数据3通道,进行5类的分类处理
model = models.vgg16(num_classes=5)
# 2.模型训练的参数设置
# 2.1 学习率
learning_rate = 1e-3
# 2.2 训练轮数
num_epochs = 10
# 2.3 优化算法Adam = RMSProp + Momentum
optimizer = torch.optim.Adam(model.parameters(), lr=learning_rate)
# 2.4 交叉熵损失函数
loss_fn = torch.nn.CrossEntropyLoss()
3、模型评估
(1)代码架构
# 1.定义模型评估函数
def evaluate_accuracy(data_iter, model):
    # 2.不进行梯度计算
        # 3.模型设置验证模式
        # 4.获取每一个batch的数据,进行预测
            # 4.1 获取预测结果
            # 4.2 预测的次数
            # 4.3 预测正确的个数
    # 5.获取准确率
(2)完整代码
# 1.定义模型评估函数
def evaluate_accuracy(data_iter, model):
    total = 0
    correct = 0
    # 2.不进行梯度计算
    with torch.no_grad():
        # 3.模型设置验证模式
        model.eval()
        # 4.获取每一个batch的数据,进行预测
        for images, labels in data_iter:
            outputs = model(images)
            # 4.1 获取预测结果
            _, predicts = torch.max(outputs.data, dim=1)
            # 4.2 预测的次数
            total += labels.size(0)
            # 4.3 预测正确的个数
            correct += (predicts == labels).cpu().sum()
            break
    # 5.获取准确率
    return correct / total
4、模型训练
(1)代码架构
# 1.定义模型训练过程:指定数据集,优化器,损失函数和轮次
def train(data_loader, optimizer, loss_fn, epochs):
    # 2.遍历每一个轮次进行训练
        # 3.每一个轮次的损失,预测个数和预测正确个数的初始化
        # 3.1 预测个数和预测正确个数的初始化
        # 3.2 损失值的和
        # 3.3 迭代次数
        # 4.遍历数据进行模型训练
            # 4.1 模型定义为训练模式
            # 4.2 对数据进行预测
            # 4.3 计算模型的损失
            # 4.4 在做反向传播前先清除网络状态
            # 4.5 损失值进行反向传播
            # 4.6 参数迭代更新
            # 4.7 求损失的和
            # 4.8 输出模型预测结果
            # 4.9 获取训练集预测正确的个数
        # 5.测试集预测的准确率
(2)完整代码
# 1.定义模型训练过程:指定数据集,优化器,损失函数和轮次
def train(data_loader=train_loader,
          optimizer=optimizer,
          loss_fn=loss_fn,
          epochs=num_epochs):
    # 2.遍历每一个轮次进行训练
    for epoch in range(epochs):
        print('current epoch = {}'.format(epoch))
        # 3.每一个轮次的损失,预测个数和预测正确个数的初始化
        # 3.1 预测个数和预测正确个数的初始化
        train_accuracy_total = 0
        train_correct = 0
        # 3.2 损失值的和
        train_loss_sum = 0
        # 3.3 迭代次数
        iter = 0
        # 4.遍历数据进行模型训练
        for i, (images, labels) in enumerate(data_loader):
            # 4.1 模型定义为训练模式
            model.train()
            # 4.2 对数据进行预测
            outputs = model(images)
            # 4.3 计算模型的损失
            loss = loss_fn(outputs, labels)
            # 4.4 在做反向传播前先清除网络状态
            optimizer.zero_grad()
            # 4.5 损失值进行反向传播
            loss.backward()
            # 4.6 参数迭代更新
            optimizer.step()
            # 4.7 求损失的和
            train_loss_sum += loss.item()
            # 4.8 输出模型预测结果
            _, predicts = torch.max(outputs.data, dim=1)
            # 4.9 获取训练集预测正确的个数
            train_accuracy_total += labels.size(0)
            train_correct += (predicts == labels).cpu().sum().item()
            iter += 1
        # 5.测试集预测的准确率
        test_acc = evaluate_accuracy(test_loader, model)
        print('epoch:{0},   loss:{1:.4f},   train accuracy:{2:.3f},  test accuracy:{3:.3f}'
            .format(epoch, train_loss_sum / (iter + 0.01),
                    train_correct / train_accuracy_total, test_acc))
05-图像分类-GoogLeNet
计算机视觉基础CV笔记
一、今日课程内容
- GoogLeNet网络结构的特点(了解)
- 能够利用GoogLeNet完成图像分类(实操+掌握)
二、GoogLeNet网络结构的特点(了解)
1、基本内容
- 模型归属:Google
- 荣誉:在ImageNet2014分类比赛上的Top-5错误率降低到了6.7%
- 特点:22层网络,在加深度的同时做了结构上的创新,引入叫做Inception的结构来代替之前的卷积加激活的经典组件。
- 常用模块:
- InceptionV1
- InceptionV2
- InceptionV3
2、Inception 块
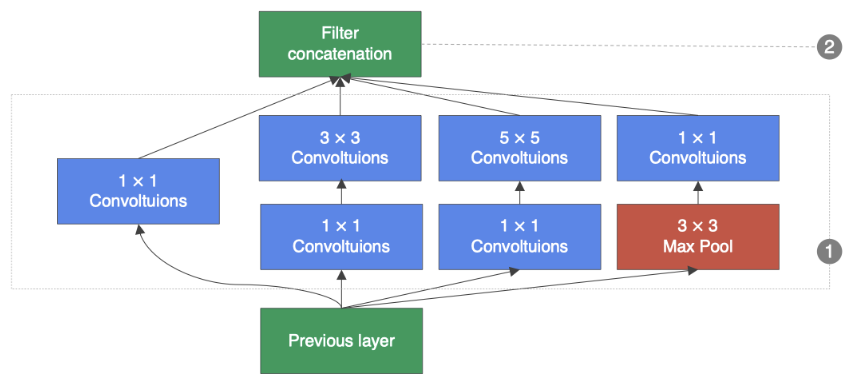
- 4条并行线路
- 前3条线路使用窗口大小分别是1×1、3×3和5×5的卷积层来抽取不同空间尺寸下的信息
- 中间2个线路会对输入先做【1X1】卷积来减少输入通道数,以降低模型复杂度
-
第4条线路则使用3×3最大池化层,后接1×1卷积层来改变通道数
-
1 X 1卷积
- 实现跨通道的交互和信息整合
- 卷积核通道数的降维和升维,减少网络参数
2、GoogLeNet模型
-
由Inception模块构成
-
整个网络架构我们分为五个模块,每个模块之间使用步幅为2的3×3最大池化层来减小输出高宽。
- B1模块:使用一个64通道的7×7卷积层
- B2模块:使用2个卷积层:首先是64通道的1×1卷积层,然后是将通道增大3倍的3×3卷积层。
- B3模块:串联2个完整的Inception块, 分别是Inception3a和Inception3b
- B4模块:串联了5个Inception块,分别是Inception4a,Inception4b,Inception4c,Inception4d和Inception4e,并且在4b和4e模块添加了辅助输出端,用于模型训练
-
B5模块:串联了2个Inception块,分别是Inception5a,Inception5b,后面紧跟输出层,该模块使用全局平均池化层(GAP)来将每个通道的高和宽变成1。最后输出变成二维数组后接输出个数为标签类别数的全连接层。
-
模型调用
```python
# 1.导入相关的工具包
import torch
import torchvision.models as models
# 2.模型实例化
model = models.googlenet()
# 3.B1模块
model.conv1
model.maxpool1
# 4.B2模块
model.conv2
model.conv3
model.maxpool2
# 5.B3模块(串联2个完整的Inception块)
model.inception3a
model.inception3b
# 6.B4模块(串联了5个Inception块)
model.inception4a
......
model.inception4e
model.aux1 # 4b和4e模块添加辅助输出端
# 7.B5模块(串联了2个Inception块,后面紧跟输出层)
model.inception5a
model.inception5b
```
三、鲜花种类识别案例(实操+掌握)
1、读取数据
-
图像Resize:224 X 224
-
读取数据
```python
# 1.导入依赖包
from torchvision import transforms
from torch.utils.data import DataLoader
from torchvision.datasets import ImageFolder
# 2.设置初始参数
# 2.1 指定批次大小
batch_size = 2
# 2.2 指定数据集路径
flower_train_path = './dataset/flower_datas/train/'
flower_test_path = './dataset/flower_datas/val/'
# 3.定义转换类型(先将数据转换为tensor类型,并调整数据的大小为224x224)
dataset_transform = transforms.Compose(
[transforms.ToTensor(),
transforms.Resize((224, 224))])
# 4.获取训练集数据和测试集数据
flower_train = ImageFolder(flower_train_path, transform=dataset_transform)
flower_test = ImageFolder(flower_test_path, transform=dataset_transform)
# 5.获取数据的迭代
train_loader = DataLoader(dataset=flower_train,
batch_size=batch_size,
shuffle=True)
test_loader = DataLoader(dataset=flower_test,
batch_size=batch_size,
shuffle=False)
```
- 展示数据
python
  # 1.导入依赖包
  import matplotlib.pyplot as plt
  # 2.定义图像和坐标1行2列
  fig, axes = plt.subplots(1, 2)
  # 3.展示图像
  axes.imshow(imgs.permute(1, 2, 0))
  plt.show()
2、模型实例化和参数设置
(1)代码架构
# 1.模型实例化:输入数据3通道,进行5类的分类处理
# 2.模型训练的参数设置
# 2.1 学习率
# 2.2 训练轮数
# 2.3 优化算法Adam = RMSProp + Momentum
# 2.4 交叉熵损失函数
(2)完整代码
# 1.模型实例化:输入数据3通道,进行5类的分类处理
model = models.googlenet(num_classes=5)
# 2.模型训练的参数设置
# 2.1 学习率
learning_rate = 1e-3
# 2.2 训练轮数
num_epochs = 10
# 2.3 优化算法Adam = RMSProp + Momentum
optimizer = torch.optim.Adam(model.parameters(), lr=learning_rate)
# 2.4 交叉熵损失函数
loss_fn = torch.nn.CrossEntropyLoss()
3、模型评估
(1)代码架构
# 1.定义模型评估函数
def evaluate_accuracy(data_iter, model):
    # 2.不进行梯度计算
        # 3.模型设置验证模式
        # 4.获取每一个batch的数据,进行预测
            # 4.1 获取预测结果
            # 4.2 预测的次数
            # 4.3 预测正确的个数
    # 5.获取准确率
(2)完整代码
# 1.定义模型评估函数
def evaluate_accuracy(data_iter, model):
    total = 0
    correct = 0
    # 2.不进行梯度计算
    with torch.no_grad():
        # 3.模型设置验证模式
        model.eval()
        # 4.获取每一个batch的数据,进行预测
        for images, labels in data_iter:
            outputs = model(images)
            # 4.1 获取预测结果
            _, predicts = torch.max(outputs.data, dim=1)
            # 4.2 预测的次数
            total += labels.size(0)
            # 4.3 预测正确的个数
            correct += (predicts == labels).cpu().sum()
    # 5.获取准确率
    return correct / total
4、模型训练
(1)代码架构
# 1.定义模型训练过程:指定数据集,优化器,损失函数和轮次
def train(data_loader, optimizer, loss_fn, epochs):
    # 2.遍历每一个轮次进行训练
        # 3.每一个轮次的损失,预测个数和预测正确个数的初始化
        # 3.1 预测个数和预测正确个数的初始化
        # 3.2 损失值的和
        # 3.3 迭代次数
        # 4.遍历数据进行模型训练
            # 4.1 模型定义为训练模式
            # 4.2 对数据进行预测
            # 4.3 各个输出端和模型的损失
            # 4.4 在做反向传播前先清除网络状态
            # 4.5 损失值进行反向传播
            # 4.6 参数迭代更新
            # 4.7 求损失的和
            # 4.8 输出模型预测结果
            # 4.9 获取训练集预测正确的个数
        # 5.测试集预测的准确率
(2)完整代码
# 1.定义模型训练过程:指定数据集,优化器,损失函数和轮次
def train(data_loader=train_loader,
          optimizer=optimizer,
          loss_fn=loss_fn,
          epochs=num_epochs):
    # 2.遍历每一个轮次进行训练
    for epoch in range(epochs):
        print('current epoch = {}'.format(epoch))
        # 3.每一个轮次的损失,预测个数和预测正确个数的初始化
        # 3.1 预测个数和预测正确个数的初始化
        train_accuracy_total = 0
        train_correct = 0
        # 3.2 损失值的和
        train_loss_sum = 0
        # 3.3 迭代次数
        iter = 0
        # 4.遍历数据进行模型训练
        for i, (images, labels) in enumerate(data_loader):
            # 4.1 模型定义为训练模式
            model.train()
            # 4.2 对数据进行预测
            outputs,aux2,aux1 = model(images)
            # 4.3 各个输出端和模型的损失
            loss0 = loss_fn(outputs, labels)
            loss1 = loss_fn(aux1,labels)
            loss2 = loss_fn(aux2,labels)
            loss = loss0 + 0.3*loss2+0.2*loss1
            # 4.4 在做反向传播前先清除网络状态
            optimizer.zero_grad()
            # 4.5 损失值进行反向传播
            loss.backward()
            # 4.6 参数迭代更新
            optimizer.step()
            # 4.7 求损失的和
            train_loss_sum += loss.item()
            # 4.8 输出模型预测结果
            _, predicts = torch.max(outputs.data, dim=1)
            # 4.9 获取训练集预测正确的个数
            train_accuracy_total += labels.size(0)
            train_correct += (predicts == labels).cpu().sum().item()
            iter += 1
        # 5.测试集预测的准确率
        test_acc = evaluate_accuracy(test_loader, model)
        print('epoch:{0},   loss:{1:.4f},   train accuracy:{2:.3f},  test accuracy:{3:.3f}'
            .format(epoch, train_loss_sum / (iter + 0.01),
                    train_correct / train_accuracy_total, test_acc))
四、拓展知识
1、InceptionV2
- 在InceptionV2中将大卷积核拆分为小卷积核
- 将V1中的5×5的卷积用两个3×3的卷积替代
- 增加网络的深度,减少了参数
2、InceptionV3
- 将n×n卷积分割为1×n和n×1两个卷积
- 参数量和计算量都比原来降低
06-图像分类-ResNet
计算机视觉基础CV笔记
一、今日课程内容
- ResNet网络结构的特点(了解)
- 能够利用ResNet完成图像分类(实操+掌握)
二、ResNet模型及残差块(了解)
1、基本内容
- 模型归属:何恺明等人
- 荣誉:ILSVRC2015比赛分类项目的第一名
- 特点:提出残差结构,使用shortcut使得模型网络可以更深
2、残差块
- 直接从输入连接到输出的结构也称为shortcut
- 整个结构就是残差块,ResNet的基础模块。
- 2种模块
- 基础模块:2个有相同输出通道数的3×3卷积层。每个卷积层后接BN层和ReLU激活函数,然后将输入直接加在最后的ReLU激活函数前。
- ResNet18和ResNet34
- 瓶颈模块(bottleneck):引入1×1卷积层来调整输入的通道数,达到减少模型参数量的作用。
- ResNet50,ResNet101和ResNet152
3、ResNet模型
- 网络结构
- 第一个模块使用输出通道数为64、步幅为2的7×7卷积层,后接步幅为2的3×3的最大池化层。
- 之后的每个模块在第一个残差块里将上一个模块的通道数翻倍,并将高和宽减半。
- 最后,与GoogLeNet一样,加入全局平均池化层(GAP)后接上全连接层输出。
- Max Pooling(固定窗口,固定步长,取最大值)
- Avg Pooling(固定窗口,固定步长,取平均值)
- GAP(不固定窗口,不固定步长,动态调整窗口和步长)
4、模型调用及查看
- 模型调用:
python
  # 导入相关的工具包
  import torch
  import torchvision.models as models
  # 模型实例化
  model = models.resnet18()
- 模型架构查看
python
  model.parameters
- 模型网络层参看
python
  model.layer1
三、鲜花种类识别案例(实操+掌握)
1、读取数据
-
图像Resize:224 X 224
-
读取数据
```python
# 1.导入依赖包
from torchvision import transforms
from torch.utils.data import DataLoader
from torchvision.datasets import ImageFolder
# 2.定义数据转换方式
dataset_transform = transforms.Compose(
[transforms.ToTensor(),
transforms.Resize((224, 224))])
# 3.获取训练集数据和测试集数据,并进行数据转换
flower_train = ImageFolder(flower_train_path, transform=dataset_transform)
# 4.加载数据
train_loader = DataLoader(dataset=flower_train,
batch_size=batch_size,
shuffle=True)
```
- 展示数据
python
  # 1.导入依赖包
  import matplotlib.pyplot as plt
  # 2.定义图像和坐标1行2列
  fig, axes = plt.subplots(1, 2)
  # 3.展示图像
  axes.imshow(imgs.permute(1, 2, 0))
  plt.show()
2、模型实例化和参数设置
(1)代码架构
# 1.模型实例化:输入数据3通道,进行5类的分类处理
# 2.模型训练的参数设置
# 2.1 学习率
# 2.2 训练轮数
# 2.3 优化算法Adam = RMSProp + Momentum
# 2.4 交叉熵损失函数
(2)完整代码
# 1.模型实例化:输入数据3通道,进行5类的分类处理
model = models.resnet18(num_classes=5)
# 2.模型训练的参数设置
# 2.1 学习率
learning_rate = 1e-3
# 2.2 训练轮数
num_epochs = 10
# 2.3 优化算法Adam = RMSProp + Momentum
optimizer = torch.optim.Adam(model.parameters(), lr=learning_rate)
# 2.4 交叉熵损失函数
loss_fn = torch.nn.CrossEntropyLoss()
3、模型评估
(1)代码架构
# 1.定义模型评估函数
def evaluate_accuracy(data_iter, model):
    # 2.不进行梯度计算
        # 3.模型设置验证模式
        # 4.获取每一个batch的数据,进行预测
            # 4.1 获取预测结果
            # 4.2 预测的次数
            # 4.3 预测正确的个数
    # 5.获取准确率
(2)完整代码
# 1.定义模型评估函数
def evaluate_accuracy(data_iter, model):
    total = 0
    correct = 0
    # 2.不进行梯度计算
    with torch.no_grad():
        # 3.模型设置验证模式
        model.eval()
        # 4.获取每一个batch的数据,进行预测
        for images, labels in data_iter:
            outputs = model(images)
            # 4.1 获取预测结果
            _, predicts = torch.max(outputs.data, dim=1)
            # 4.2 预测的次数
            total += labels.size(0)
            # 4.3 预测正确的个数
            correct += (predicts == labels).cpu().sum()
    # 5.获取准确率
    return correct / total
4、模型训练
(1)代码架构
# 1.定义模型训练过程:指定数据集,优化器,损失函数和轮次
def train(data_loader, optimizer, loss_fn, epochs):
    # 2.遍历每一个轮次进行训练
        # 3.每一个轮次的损失,预测个数和预测正确个数的初始化
        # 3.1 预测个数和预测正确个数的初始化
        # 3.2 损失值的和
        # 3.3 迭代次数
        # 4.遍历数据进行模型训练
            # 4.1 模型定义为训练模式
            # 4.2 对数据进行预测
            # 4.3 计算模型的损失
            # 4.4 在做反向传播前先清除网络状态
            # 4.5 损失值进行反向传播
            # 4.6 参数迭代更新
            # 4.7 求损失的和
            # 4.8 输出模型预测结果
            # 4.9 获取训练集预测正确的个数
        # 5.测试集预测的准确率
(2)完整代码
# 1.定义模型训练过程:指定数据集,优化器,损失函数和轮次
def train(data_loader=train_loader,
          optimizer=optimizer,
          loss_fn=loss_fn,
          epochs=num_epochs):
    # 2.遍历每一个轮次进行训练
    for epoch in range(epochs):
        print('current epoch = {}'.format(epoch))
        # 3.每一个轮次的损失,预测个数和预测正确个数的初始化
        # 3.1 预测个数和预测正确个数的初始化
        train_accuracy_total = 0
        train_correct = 0
        # 3.2 损失值的和
        train_loss_sum = 0
        # 3.3 迭代次数
        iter = 0
        # 4.遍历数据进行模型训练
        for i, (images, labels) in enumerate(data_loader):
            # 4.1 模型定义为训练模式
            model.train()
            # 4.2 对数据进行预测
            outputs = model(images)
            # 4.3 计算模型的损失
            loss = loss_fn(outputs, labels)
            # 4.4 在做反向传播前先清除网络状态
            optimizer.zero_grad()
            # 4.5 损失值进行反向传播
            loss.backward()
            # 4.6 参数迭代更新
            optimizer.step()
            # 4.7 求损失的和
            train_loss_sum += loss.item()
            # 4.8 输出模型预测结果
            _, predicts = torch.max(outputs.data, dim=1)
            # 4.9 获取训练集预测正确的个数
            train_accuracy_total += labels.size(0)
            train_correct += (predicts == labels).cpu().sum().item()
            iter += 1
        # 5.测试集预测的准确率
        test_acc = evaluate_accuracy(test_loader, model)
        print('epoch:{0},   loss:{1:.4f},   train accuracy:{2:.3f},  test accuracy:{3:.3f}'
            .format(epoch, train_loss_sum / (iter + 0.01),
                    train_correct / train_accuracy_total, test_acc))
07-图像分类-图像增强
计算机视觉基础CV笔记
一、今日课程内容
- 图像增强的常用方法(了解)
- 能够利用torchvision来完成图像增强(实操 + 掌握)
二、常用的图像增强方法(了解)
1、定义
- 通过剪切、旋转/反射/翻转变换、缩放变换、平移变换、尺度变换、对比度变换、噪声扰动、颜色变换等一种或多种组合数据增强变换的方式来【transforms.Compose】
2、主要任务
- 通过对训练图像做一系列随机改变,来产生相似但又不同的训练样本,从而扩大训练数据集的规模,而且随机改变训练样本可以降低模型对某些属性的依赖,从而提高模型的【泛化性能】。
3、常见方式
- 几何变换类
- 对图像进行几何变换操作
- 翻转,旋转,裁剪,变形,缩放等
- 颜色变换类
- 通过模糊、颜色变换、擦除、填充等方式对图像进行处理
4、API实现
torchvision.transforms
三、torchvision.transforms进行图像增强(实操+掌握)
1、基本实现方式
-
主要针对 PIL.Image 对象和 torch.Tensor 对象
-
代码实现
python
  # 1.导入相应的工具包:图像读取,图像增强和绘制图像的
  from PIL import Image  # pip install pillow
  from torchvision import transforms
  import matplotlib.pyplot as plt
  # 2.读取图像并进行显示
  dog = Image.open('./dog.jpg')
  plt.imshow(dog)
  plt.show()
2、几何变换
-
1 左右翻转(水平翻转)
-
API
python transforms.RandomHorizontalFlip(p=0.5) -
案例
```python
水平翻转:以0.5的概率进行水平翻转
transforms_HF =transforms.RandomHorizontalFlip(p=0.5)
dog_HF = transforms_HF(dog)
plt.imshow(dog_HF)
plt.show()
``` -
2 上下翻转(垂直翻转)
-
API
python transforms.RandomVerticalFlip(p=0.5) -
案例
```python
垂直上下翻转:以0.5的概率进行翻转
transforms_VF=transforms.RandomVerticalFlip(p=0.5)
dog_VF = transforms_VF(dog)
plt.imshow(dog_VF)
``` -
3 随机裁剪
-
API
python transforms.RandomCrop(size=(H, W)) -
案例
```python
随机裁剪:宽高要小于原始图像的宽高
transforms_RC=transforms.RandomCrop(size=(600, 600))
dog_RC = transforms_RC(dog)
plt.imshow(dog_RC)
``` -
4 尺寸调整
-
API
python transforms.Resize(size=(H, W)) -
案例
```python
尺寸调整
transforms_RS=transforms.Resize(size=(224, 224))
dog_RS = transforms_RS(dog)
plt.imshow(dog_RS)
```
3、颜色变换
-
从4个方面改变图像的颜色:亮度、对比度、饱和度和色调
-
API:
python
  transforms.ColorJitter(brightness=0, contrast=0, saturation=0, hue=0)
- brightness:亮度,取值范围为 [0.0, 1.0]
- 当取值为0.5时,表示将图像的亮度随机变化为原图亮度的50%(即1−0.5)∼150%(即1+0.5)。
- contrast:对比度,取值范围为 [0.0, 1.0]
- 当取值为0.5时,表示将图像的对比度随机变化为原图对比度的50%(即1−0.5)∼150%(即1+0.5)。
- saturation:饱和度,取值范围为 [0.0, 1.0]
- 当取值为0.5时,表示将图像的饱和度随机变化为原图饱和度的50%(即1−0.5)∼150%(即1+0.5)。
-
hue:色调,取值范围为 [-0.5, 0.5]
- 当取值为0.2时,表示将图像的色调就在[-0.2,0.2]之间取值。
-
案例
python
  # 颜色调整
  transforms_color =transforms.ColorJitter(brightness=0.5, contrast=0.5, saturation=0.5, hue=0.2)
  dog_color = transforms_color(dog)
  plt.imshow(dog_color)
  plt.show()
4、增强方法的组合
-
多种增强方式组合在一起,例如:几何增强+ 颜色增强
-
API
python
  transforms.Compose([transforms])
- 案例
python
  # 将几何变换和颜色变换组合在一起
  transform = transforms.Compose([transforms_RS,transforms_color])
  dog_ = transform(dog)
  plt.imshow(dog_)
  plt.show()
08-图像分类-模型微调
计算机视觉基础CV笔记
一、今日课程内容
- 微调的原理(了解)
- 能够利用微调模型来完成图像的分类任务(实操 + 掌握)
二、微调(了解)
1、定义
- 给定大规模数据集训练好预训练模型,基于该预训练模型在指定小数据集上进行训练,调整模型。
- 相对于从头开始训练,微调会省去大量计算资源和计算时间,提高了计算效率,甚至提高准确率。
2、主要步骤
(1)预训练源模型:在源数据集(如ImageNet数据集)上预训练一个神经网络模型,即源模型。
(2)创建目标模型:创建一个新的神经网络模型,即目标模型。
(3)修改目标模型输出层:为目标模型添加一个输出大小为目标数据集类别个数的输出层,并随机初始化该层的模型参数。
(4)在目标数据集(如鲜花数据集)上训练目标模型
三、鲜花种类识别(实操 + 掌握)
1、基本内容
-
对在ImageNet数据集上训练好的VGG模型进行微调
-
依赖包
python
  import torch
  import torch.nn as nn
  from torchvision import transforms
  from torch.utils.data import DataLoader
  from torchvision.datasets import ImageFolder
  import torchvision.models as models
2、获取数据集
-
Resize到224 X224
-
代码实现
```python
# 1.初始化参数设置
# 1.1 指定批次大小
batch_size = 8
# 1.2 指定数据集路径
flower_train_path = './dataset/flower_datas/train/'
flower_test_path = './dataset/flower_datas/val/'
# 2.定义数据转换方式,先将数据转换为tensor类型,并调整数据的大小为224x224
dataset_transform = transforms.Compose([
transforms.ToTensor(),
transforms.Resize((224,224))
])
# 3.获取训练集数据和测试集数据
flower_train = ImageFolder(flower_train_path, transform=dataset_transform)
flower_test = ImageFolder(flower_test_path,transform=dataset_transform)
# 4.获取数据的迭代
train_loader = DataLoader(dataset = flower_train, batch_size = batch_size, shuffle = True)
test_loader = DataLoader(dataset = flower_test, batch_size = batch_size, shuffle = False)
```
3、构建微调模型
-
使用在ImageNet数据集上预训练的Vgg-16作为源模型
-
torchvision小于等于0.12版本我们指定pretrain=True即可
-
torchvision大于0.12版本的指定
weights来自动下载并加载预训练的模型参数 -
模型构建
python
  class VGG16_finetune(nn.Module):
      def __init__(self, num_class=5):
          super(VGG16_finetune, self).__init__()
          # 获取预训练模型
          # 0.12
          vgg16_net = models.vgg16(pretrained=True)
          # >0.12
          # weights= models.VGG16_Weights.DEFAULT
          # vgg16_net = model.vgg16(weights = weights)
          self.num_class = num_class
          # 获取预训练模型的特征和GAP的结果
          self.features = vgg16_net.features
          self.avgpool = vgg16_net.avgpool
          # 构建当前任务的输出端:FC
          self.classifier = nn.Sequential(
              nn.Linear(25088, 512),
              nn.ReLU(True),
              nn.Dropout(),
              nn.Linear(512, 128),
              nn.ReLU(True),
              nn.Dropout(),
              nn.Linear(128, self.num_class),
          )
      # 前向传播过程
      def forward(self, x):
          x = self.features(x)
          x = self.avgpool(x)
          x = torch.flatten(x, 1)
          x = self.classifier(x)
          return x
- 实例化并冻结卷积层部分的参数
python
  # 模型实例化
  model = VGG16_finetune(num_class = 5)
  # 冻结特征提取部分的参数,不进行梯度计算
  for param in model.features.parameters():
      param.requires_grad = False
  # 学习率
  learning_rate = 1e-3
  # 训练轮数
  num_epochs = 10
  # 优化算法Adam = RMSProp + Momentum,在这里我们只更新后面的分类输出层的参数。卷积层的参数使用预训练模型的结果
  optimizer = torch.optim.Adam(model.classifier.parameters(), lr=learning_rate)
  # 交叉熵损失函数
  loss_fn = torch.nn.CrossEntropyLoss()
4、模型训练
- 定义评估函数
# 1.计算模型预测精度:测试集数据,模型
def evaluate_accuracy(data_iter, model):
    total = 0
    correct = 0
    # 2.不进行梯度计算
    with torch.no_grad():
        # 3.模型是验证模式
        model.eval()
        # 4.获取每一个batch的数据,进行预测
        for images, labels in data_iter:
            outputs = model(images)
            # 4.1 获取预测结果
            _, predicts = torch.max(outputs.data, dim=1)
            # 4.2 预测的次数
            total += labels.size(0)
            # 4.3 预测正确的个数
            correct += (predicts == labels).cpu().sum()
    # 5.获取准确率
    return correct / total
- 模型训练
# 1.定义模型训练过程:指定数据集,优化器,损失函数和轮次
def train(data_loader=train_loader,
          optimizer=optimizer,
          loss_fn=loss_fn,
          epochs=num_epochs):
    # 2.遍历每一个轮次进行训练
    for epoch in range(epochs):
        print('current epoch = {}'.format(epoch))
        # 2.1 每一个轮次的损失,预测个数和预测正确个数的初始化
        train_accuracy_total = 0
        train_correct = 0
        # 2.2 损失值的和
        train_loss_sum = 0
        # 2.3 迭代次数
        iter = 0
        # 3.遍历数据集进行训练
        for i, (images, labels) in enumerate(data_loader):
            # 3.1 模型定义为训练模式
            model.train()
            # 3.2 对数据进行预测
            outputs = model(images)
            # 3.3 计算模型的损失
            loss = loss_fn(outputs, labels)
            # 3.4 在做反向传播前先清除网络状态
            optimizer.zero_grad()
            # 3.5 损失值进行反向传播
            loss.backward()
            # 3.6 参数迭代更新
            optimizer.step()
            # 3.7 求损失的和
            train_loss_sum += loss.item()
            # 3.8 输出模型预测结果
            _, predicts = torch.max(outputs.data, dim=1)
            # 3.9获取训练集预测正确的个数
            train_accuracy_total += labels.size(0)
            train_correct += (predicts == labels).cpu().sum().item()
            iter+=1
        # 4.测试集预测的准确率
        test_acc = evaluate_accuracy(test_loader, model)
        print(
            'epoch:{0},   loss:{1:.4f},   train accuracy:{2:.3f},  test accuracy:{3:.3f}'
            .format(epoch, train_loss_sum / (iter+0.01),
                    train_correct / train_accuracy_total, test_acc))
09-图像分类-汽车车型分类案例
计算机视觉基础CV笔记
一、今日课程内容
- 数据增强的使用方法(了解)
- 能够实现模型微调的网络构建(实操 + 掌握)
- 能够实现模型训练(实操 + 掌握)
- 能够使用训练好的模型进行预测(实操 + 掌握)
二、数据集介绍(了解)
1、基本内容
- 斯坦福汽车数据集
- 196 种汽车类型的图像数据集
- 共有 16,185 张图像,其中训练图像和测试图像分别为 8,144 张和 8,041 张
- 分类基于汽车品牌、车型和年份
三、数据增强及获取(实操+掌握)
1、基本内容
- 几何增强 + 颜色增强
2、代码架构
# 图像增强方法
# 1.水平翻转
# 2.随机旋转
# 3.尺寸调整
# 4.颜色调整

# 5.训练集增强方法的组合:首先转换为tensor,然后进行几何和颜色增强

# 6.验证集增强方法

# 7.获取并加载数据

# 8.展示数据
3、完整代码
# 图像增强方法
# 1.水平翻转
transforms_HF =transforms.RandomHorizontalFlip(p=0.5)
# 2.随机旋转
transforms_RR=transforms.RandomRotation(45)
# 3.尺寸调整
transforms_RS=transforms.Resize(size=(256,256))
# 4.颜色调整
transforms_color =transforms.ColorJitter(brightness=0.5, contrast=0.5, saturation=0.5, hue=0.2)

# 5.训练集增强方法的组合:首先转换为tensor,然后进行几何和颜色增强
train_transform = transforms.Compose([
    transforms.ToTensor(),
    transforms_HF,
    transforms_RR,
    transforms_RS,
    transforms_color
])

# 6.验证集增强方法
test_transform = transforms.Compose([
    transforms.ToTensor(),
    transforms_RS,
])

# 7.获取并加载数据
cars_train = ImageFolder(cars_train_path, transform=train_transform)
cars_test = ImageFolder(cars_test_path,transform=test_transform)

batch_size = 2
train_loader = DataLoader(dataset = cars_train, batch_size = batch_size, shuffle = True)
test_loader = DataLoader(dataset = cars_test, batch_size = batch_size, shuffle = False)

# 8.展示数据
import matplotlib.pyplot as plt
# 8.1 遍历每个迭代的数据,将其结果展示出来
for b, (imgs, targets) in enumerate(train_loader):
    # 8.2 获取第一个batch的图像
    if b == 1:
        # 8.3 将其进行展示
        fig, axes = plt.subplots(1, 2)
        # 8.4 遍历batch中的每个图像
        for i in range(batch_size):
            # 8.5 图像显示出来
            axes[i].imshow(imgs[i].permute(1, 2, 0))
            # 8.6 设置图像标题
            axes[i].set_title(targets[i].item())
        plt.show()
    elif b > 0:
        break
四、模型构建(实操+掌握)
1、基本内容
- 使用imageNet的预训练模型RestNet34进行微调
2、代码架构
# 1.模型加载:进行模型微调,使用imageNet的预训练模型
# 2.将所有的参数层进行冻结
# 3.获取到fc层的输入
# 4.定义一个新的FC层,作为模型的输出层,进行车辆的分类
3、完整代码
# 1.模型加载:进行模型微调,使用imageNet的预训练模型
model = models.resnet34(pretrained=True)
# 2.将所有的参数层进行冻结
for param in model.parameters():
    param.requires_grad = False
# 3.获取到fc层的输入
num_fc_ftr = model.fc.in_features
# 4.定义一个新的FC层,作为模型的输出层,进行车辆的分类
model.fc = nn.Linear(num_fc_ftr, 196)
五、模型训练(实操+掌握)
1、基本内容
- 定义训练过程中的评估方法和模型训练方法
2、代码架构
# 1.初始参数设置
# 1.1 学习率
# 1.2 训练轮数
# 1.3 优化算法Adam = RMSProp + Momentum (梯度、lr两方面优化下降更快更稳)
# 1.4 交叉熵损失函数

# 2.计算模型预测精度:测试集数据,模型
def evaluate_accuracy(data_iter, model):
    # 2.1 不进行梯度计算
        # 2.2 模型是验证模式
        # 2.3 获取每一个batch的数据,进行预测
        for images, labels in data_iter:
            # 2.4 获取预测结果
            # 2.5 预测的次数
            # 2.6 预测正确的个数
    # 2.7 获取准确率
    return correct / total

# 3.定义模型训练过程:指定数据集,优化器,损失函数和轮次
def train(data_loader=train_loader,
          optimizer=optimizer,
          loss_fn=loss_fn,
          epochs=num_epochs):
    # 3.1 遍历每一个轮次进行训练
    for epoch in range(epochs):
        # 3.2 每一个轮次的损失,预测个数和预测正确个数的初始化
        # 3.3 损失值的和
        # 3.4 迭代次数
        # 3.5 遍历数据进行模型训练
        for i, (images, labels) in enumerate(data_loader):
            # 3.5.1 模型定义为训练模式
            # 3.5.2 对数据进行预测
            # 3.5.3 计算模型的损失
            # 3.5.4 在做反向传播前先清除网络状态
            # 3.5.5 损失值进行反向传播
            # 3.5.6 参数迭代更新
            # 3.5.7 求损失的和
            # 3.5.8 输出模型预测结果
            # 3.5.9 获取训练集预测正确的个数
        # 3.6 测试集预测的准确率
3、完整代码
# 1.初始参数设置
# 1.1 学习率
learning_rate = 1e-3
# 1.2 训练轮数
num_epochs = 10
# 1.3 优化算法Adam = RMSProp + Momentum (梯度、lr两方面优化下降更快更稳)
optimizer = torch.optim.Adam(model.fc.parameters(), lr=learning_rate)
# 1.4 交叉熵损失函数
loss_fn = torch.nn.CrossEntropyLoss()
# 2.计算模型预测精度:测试集数据,模型
def evaluate_accuracy(data_iter, model):
    total = 0
    correct = 0
    # 2.1 不进行梯度计算
    with torch.no_grad():
        # 2.2 模型是验证模式
        model.eval()
        # 2.3 获取每一个batch的数据,进行预测
        for images, labels in data_iter:
            outputs = model(images)
            # 2.4 获取预测结果
            _, predicts = torch.max(outputs.data, dim=1)
            # 2.5 预测的次数
            total += labels.size(0)
            # 2.6 预测正确的个数
            correct += (predicts == labels).cpu().sum()
    # 2.7 获取准确率
    return correct / total

# 3.定义模型训练过程:指定数据集,优化器,损失函数和轮次
def train(data_loader=train_loader,
          optimizer=optimizer,
          loss_fn=loss_fn,
          epochs=num_epochs):
    # 3.1 遍历每一个轮次进行训练
    for epoch in range(epochs):
        print('current epoch = {}'.format(epoch))
        # 3.2 每一个轮次的损失,预测个数和预测正确个数的初始化
        train_accuracy_total = 0
        train_correct = 0
        # 3.3 损失值的和
        train_loss_sum = 0
        # 3.4 迭代次数
        iter = 0
        # 3.5 遍历数据进行模型训练
        for i, (images, labels) in enumerate(data_loader):
            # 3.5.1 模型定义为训练模式
            model.train()
            # 3.5.2 对数据进行预测
            outputs = model(images)
            # 3.5.3 计算模型的损失
            loss = loss_fn(outputs, labels)
            # 3.5.4 在做反向传播前先清除网络状态
            optimizer.zero_grad()
            # 3.5.5 损失值进行反向传播
            loss.backward()
            # 3.5.6 参数迭代更新
            optimizer.step()
            # 3.5.7 求损失的和
            train_loss_sum += loss.item()
            # 3.5.8 输出模型预测结果
            _, predicts = torch.max(outputs.data, dim=1)
            # 3.5.9 获取训练集预测正确的个数
            train_accuracy_total += labels.size(0)
            train_correct += (predicts == labels).cpu().sum().item()
            iter+=1
        # 3.6 测试集预测的准确率
        test_acc = evaluate_accuracy(test_loader, model)
        torch.save(model.state_dict(), "./weights/model-{}.pth".format(epoch))
        print(
            'epoch:{0},   loss:{1:.4f},   train accuracy:{2:.3f},  test accuracy:{3:.3f}'
            .format(epoch, train_loss_sum / (iter+0.01),
                    train_correct / train_accuracy_total, test_acc))
四、模型预测(实操+掌握)
1、基本内容
- 加载训练好的模型,对图片数据进行预测
2、代码架构
# 1.导入工具包
# 2.加载训练好的模型参数
# 3.指定要预测的图像
# 4.对图像进行预测
with torch.no_grad():
    # 4.1 指定模型为验证模式
    # 4.2 获取图像的路径
    # 4.3 遍历每一幅图像进行预测
    for img_path in image_paths:
        # 4.3.1 打开图片
        # 4.3.2 增加batch维度
        # 4.3.3 将图像送入网络中进行预测
        # 4.3.4 获取预测结果:类别索引
        # 4.3.5 获取预测结果:类别分数
        # 4.3.6 获取对应的类别名称
        # 4.3.7 预测结果的展示
3、完整代码
# 1.导入工具包
import glob
import os
from PIL import Image
# 2.加载训练好的模型参数
model.load_state_dict(torch.load("./weights/model.pth",map_location=torch.device('cpu')))
# 3.指定要预测的图像
file_path= "./car_image/"
# 4.对图像进行预测
with torch.no_grad():
    # 4.1 指定模型为验证模式
    model.eval()
    # 4.2 获取图像的路径
    image_paths = glob.glob(os.path.join(file_path, '*.jpg'))
    # 4.3 遍历每一幅图像进行预测
    for img_path in image_paths:
        # 4.3.1 打开图片
        img = Image.open(img_path)
        # 4.3.2 增加batch维度
        batch = test_transform(img).unsqueeze(0)
        # 4.3.3 将图像送入网络中进行预测
        outputs = model(batch).squeeze(0).softmax(0)
        # 4.3.4 获取预测结果:类别索引
        class_id = outputs.argmax().item()
        # 4.3.5 获取预测结果:类别分数
        score = outputs[class_id].item()
        # 4.3.6 获取对应的类别名称
        category_name = cars_train.classes[class_id]
        # 4.3.7 预测结果的展示
        plt.imshow(img)
        plt.title(category_name)
        plt.show()
图像分类代码
18 个文件- 📄 01-dataset.py 1.0KB 下载
- 📄 02-AlexNet.py 5.0KB 下载
- 📄 03-VGGNet.py 5.1KB 下载
- 📄 04-googleNet.py 4.7KB 下载
- 📄 05-resnet.py 5.1KB 下载
- 📄 06-imageAgu.py 1.2KB 下载
- 📄 07-finetune.py 6.1KB 下载
- 📄 08-carcls.py 6.4KB 下载
- 📄 AlexNet_Flower.py 4.2KB 下载
- 📄 Alexnet_demo.py 1.7KB 下载
- 📄 IA_img_Aug.py 1.2KB 下载
- 📄 dataset_demo.py 1.2KB 下载
- ⚙️ dog.jpg 143.6KB 下载