第 2 节 / 共 4 节
大模型蒸馏(下):训练与高效部署
模型训练
第三章 【掌握】模型训练
1、学习目标
训练模型三重点:
训练方式、基座模型、工具
2、LoRA微调
2.1 全参数微调的缺陷
- 成本高:算力需求高,需要大规模语料集,需要高级调优人才,需要大量时间
- 灾难性遗忘:如果训练集覆盖不到所有相关知识,有可能导致原有的知识表征被破坏,导致新任务上表现虽好,但是旧任务上的表现急剧下降。
2.3 LoRA微调怎样避免这些问题?
- 实际训练的是旁路权重
需要训练一个巨大的参数矩阵\(W_{M*N}\),为了避免灾难性遗忘,训练的时候,我们不能调整原始矩阵,而是要调整一个同样大小的矩阵\(ΔW_{M*N}\),使得推理时可以用\(W_{M*N}+αΔW_{M*N}\)代替原来的\(W_{M*N}\)。
- 用矩阵分解的思路降低计算量
机器学习里的PCA使用过一个思路:矩阵分解。很多算法都使用类似的方法降低计算量(潜在语义分析LSA,推荐系统里的协同过滤)
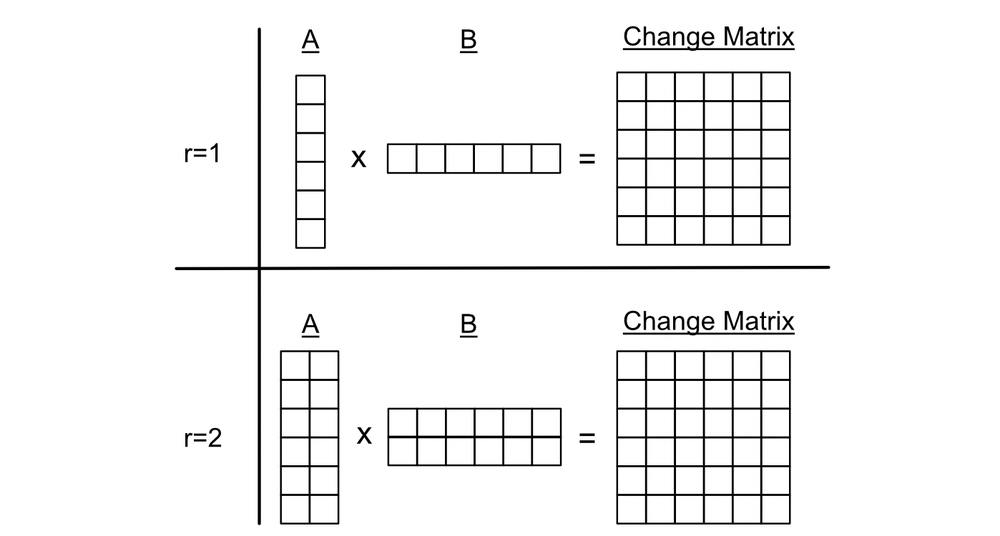
不是真正地训练一个巨大的矩阵\(ΔW_{M*N}\),而是训练两个小型矩阵\(A_{M*r}\)和\(B_{r*N}\),使得\(A_{M*r}*B_{r*N}≈ΔW_{M*N}\),只要这两个结果足够近似,在工程上就是可行的。
2.4 实际做法
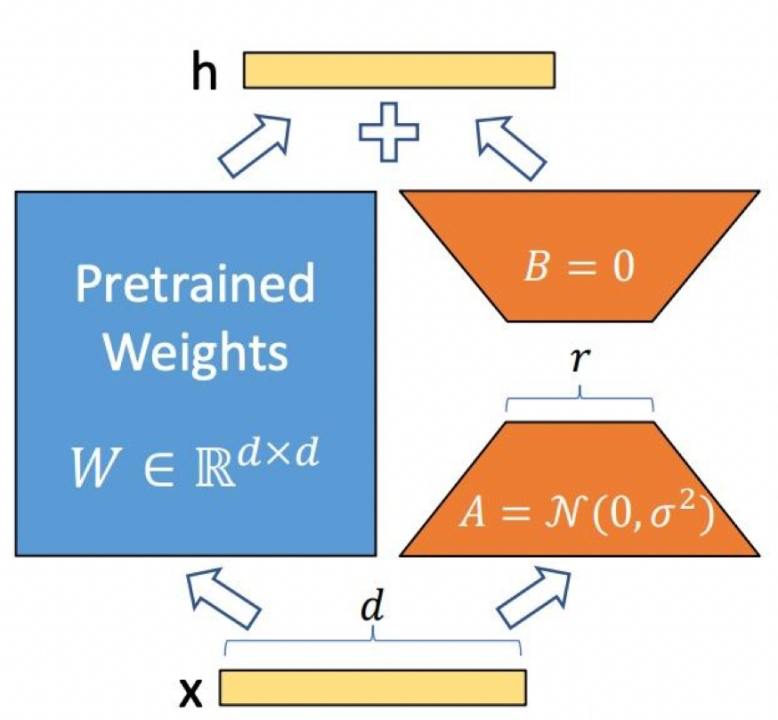
- 每个transformer块都添加低秩旁路
- 矩阵A高斯初始化
- 矩阵B初始化为全0矩阵
2.5 小结
问题:1. 使用全参数微调有什么缺点?
2. LoRA微调为什么能避免灾难性遗忘?
3. LoRA微调为什么能减小训练参数量?
4. LoRA的A,B矩阵是怎样初始化的?为什么不能全部初始化为0?为什么不能全部做高斯初始化?
3、训练过程
3.1 启动webui
在Anaconda Prompt中输入以下命令
conda activate llamafactory-3.11
llamafactory-cli webui
本地操作系统,启动后在浏览器上输入 http://localhost:7860,进入webui页面
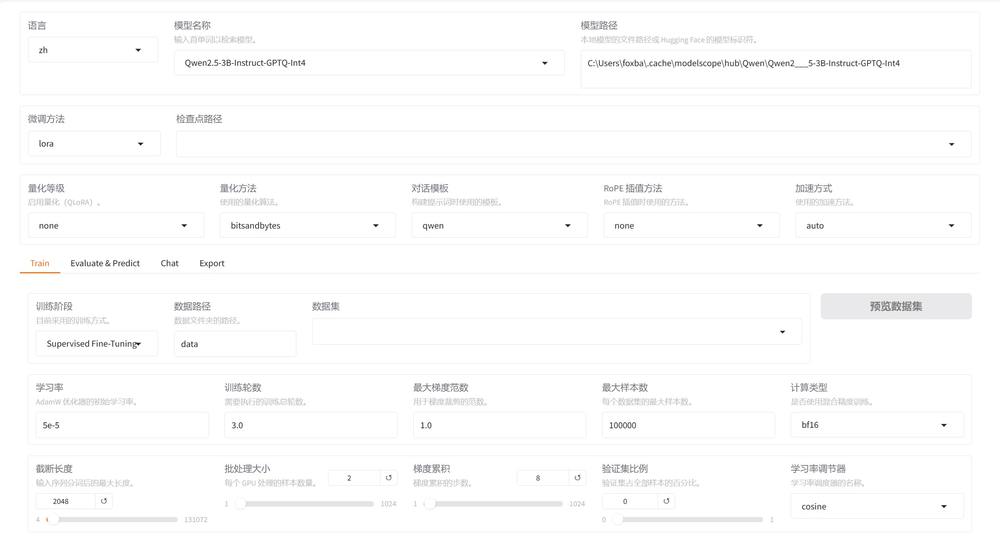
3.2 指定基座模型
模型名称:Qwen2.5-3B-Instruct-GPTQ-Int4
模型路径:D:\docker-volume\llamafactory\models\Qwen2.5-3B-Instruct-GPTQ-Int4
检查点路径:
3.3 指定数据集
数据路径:D:\工作\狂野大模型-5期\专题\2026-7-23 大模型蒸馏\03-数据\
数据集:chat-train
3.4 指定训练的基本性质
微调方法:LoRA
量化等级:4
训练阶段:Supervised fine-tuning
3.5 指定重要参数
学习率:1e-4 或者 5e-5
截断长度:6000
训练轮数:3.0
批处理大小:1
梯度累计:2
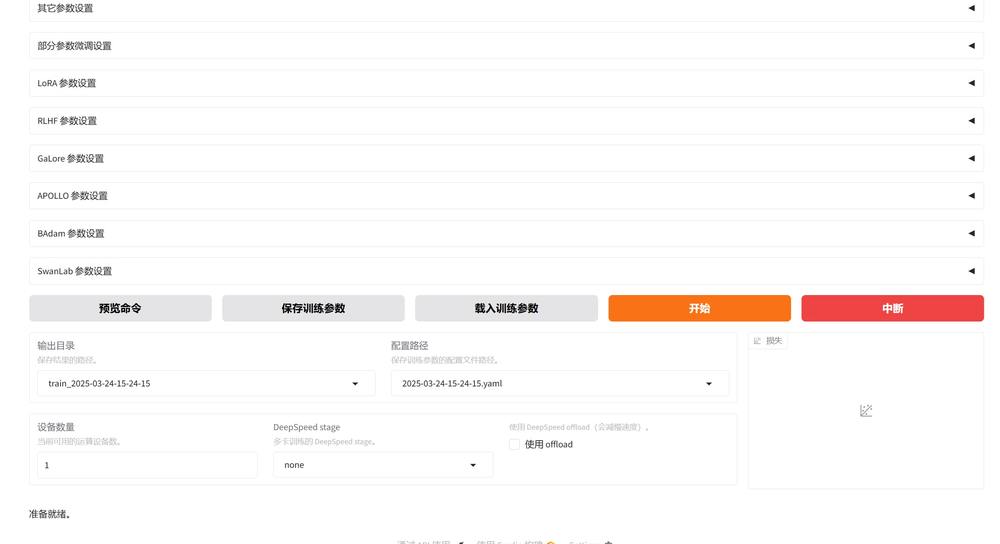
预热步数:10
LoRA的秩:8
LoRA缩放系数:16
LoRA随机丢弃:0.1
3.6 指定训练完成后的模型存储位置
在输出目录前面添加:D:/docker-volume/llamafactory/saves/
3.7 开始训练
点击开始按钮
3.8 小结
实操:启动webui,设置好各类参数,启动一次训练,并检查模型文件和参数文件
4、 检查训练效果
4.1 加载基座模型
CUDA_VISIBLE_DEVICES=0 API_PORT=8000 llamafactory-cli api ^
    --model_name_or_path C:\Users\foxba\.cache\modelscope\hub\Qwen\Qwen2___5-3B-Instruct-GPTQ-Int4
4.2 加载基座模型+LoRA
CUDA_VISIBLE_DEVICES=0 API_PORT=8000 && llamafactory-cli api ^
    --model_name_or_path /workspace/deepseekDistllation/models/Qwen/Qwen2.5-3B-Instruct-GPTQ-Int4 \
    --adapter_name_or_path /workspace/deepseekDistllation/models/lora/Qwen2.5-3B-instruct-GPTQ-Int4/train_2025-03-20-20-41-50/checkpoint-1250 \
    --finetuning_type lora
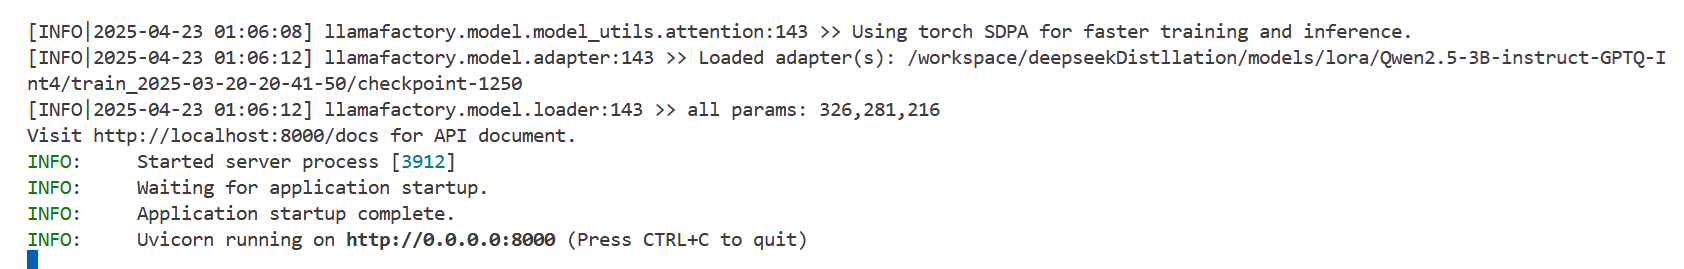
如果见到下面的信息,就代表api服务已经启动完毕
4.3 使用代码访问服务
可以用代码访问部署好的api server
import os
from openai import OpenAI
from transformers.utils.versions import require_version
import time

require_version("openai>=1.5.0", "To fix: pip install openai>=1.5.0")

def callServer(input):
    port = 8000
    client = OpenAI(
        api_key="0",
        base_url="http://localhost:{}/v1".format(os.environ.get("API_PORT", port)),
    )
    messages = []
    messages.append({"role": "user", "content": input})
    result = client.chat.completions.create(messages=messages, model="test",max_tokens=6000)
    return result.choices[0].message.content


if __name__ == "__main__":
    # 测试思维链
    input1 = "对于「初三女生在搀扶跌倒老奶奶后反被冤枉,但仍选择资助她千元」的新闻事件,你有什么看法?"

    # 测试分类
    input2 = """你是一位电商评论文本的分类专家,在【分类体系】规定的类别中,【输入文本】最可能分到哪个类别?只允许输出类别名称,不允许输出其他字符。
                    【分类体系】
                     ["电脑","水果","平板","衣服","酒店","洗浴","书籍","蒙牛","电器","手机"]
                     【输入文本】
                     很不错的一家5星级酒店。房间也很干净,就是电视太小,而且离床比较远,看不太清楚。服务人员态度也很好。下次一定会再住。"""

    # 测试SPO
    input3 = """你是一位电商评论文本的分类专家,在【输入文本】中检测所有的SPO三元组,并且以【指定格式】输出。只允许输出【指定格式】规定的答案,不允许输出任何其他字符。
                    【指定格式】
                    [{'predicate': '编剧', 'object_type': '人物', 'subject_type': '影视作品', 'object': '神尾叶子', 'subject': '花样男子'}, {'predicate': '出版社', 'object_type': '出版社', 'subject_type': '书籍', 'object': '集英社', 'subject': '花样男子'}]
                    【输入文本】
                     王炳煌(1924-1951),福建省南安县水头镇山前村人。"""

    a = time.time()
    result = callServer(input1)
    b = time.time()
    print("输出长度:" + str(len(result)) + "字  耗时:" + str(round(b - a, 2)) + "秒  输出速度:" + str(round(len(result) / (b - a), 2)) + "字/秒")
    print(result)
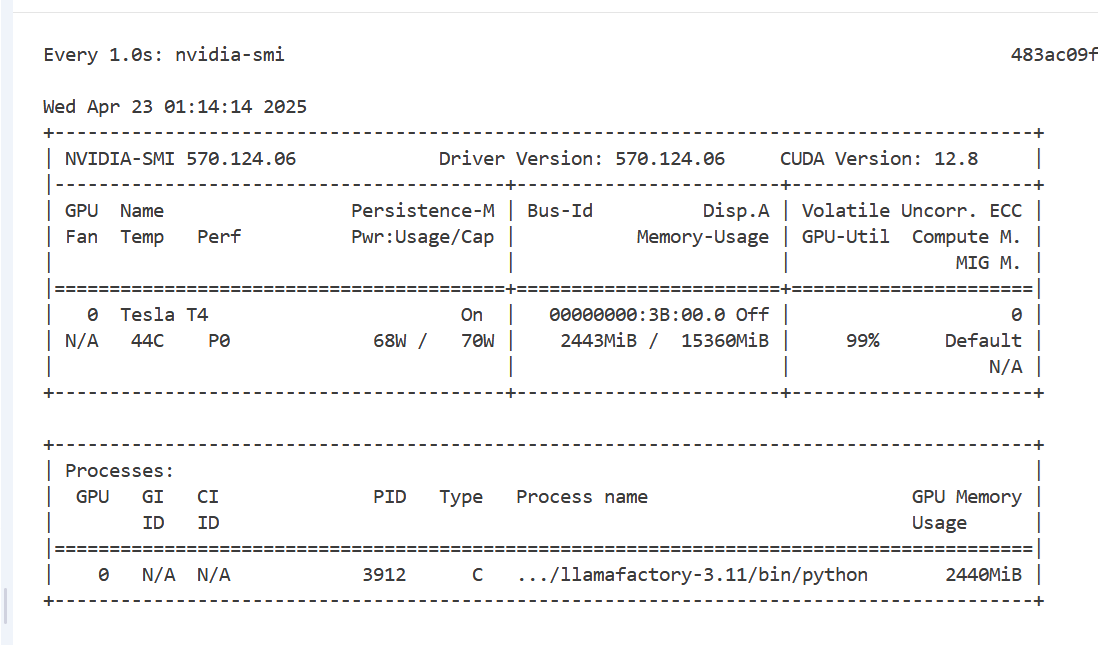
访问时,可以观察显卡的实时状态,windows在命令行里启动nvidia-smi -l 1,linux 使用 watch -n 1 nvidia-smi
测试问题:"对于「初三女生在搀扶跌倒老奶奶后反被冤枉,但仍选择资助她千元」的新闻事件,你有什么看法?"
输出长度:1902字 耗时:376.63秒 输出速度:5.05 字/秒
嗯,用户问的是关于“初三女生搀扶跌倒老奶奶后反被冤枉,但仍选择资助她千元”的新闻事件的看法。首先,我需要理解这个事件的核心,也就是事件的背景、双方的立场,以及事件的结果。可能用户想知道事件背后的道德问题,或者社会对这类事件的看法。接下来,我应该考虑用户可能的背景。他们可能对社会伦理问题比较感兴趣,或者关注类似新闻事件的处理方式。用户可能是家长、学生,或者普通读者,想要了解事件中的道德选择和法律问题。
然后,我需要分析事件本身。初三女生搀扶老奶奶,但被冤枉,可能是因为有人看到她搀扶老奶奶,然后又离开,导致误会。她选择资助老奶奶,这可能是因为她没有得到应有的尊重,或者出于道德感。需要考虑的是,这种行为是否值得赞扬,是否能改变事件的处理方式。
还要考虑法律和道德的平衡。虽然法律可能无法完全解决问题,但道德上的处理可能对事件有影响。用户可能希望了解法律是否介入,或者是否应该通过法律手段解决问题。
另外,用户可能想知道类似事件的处理方式,或者这种行为在社会中的普遍性。是否需要更多的人站出来,或者是否应该改变对这类行为的处理方式。可能需要探讨公众的反应,以及媒体的报道方式是否合理。
还要考虑事件中的其他因素,比如老奶奶的情况,是否真的需要帮助,或者是否有人故意诬陷。但用户的问题没有涉及这些细节,所以可能不需要深入讨论,但可以简要提及。
最后,总结观点,强调道德的重要性,社会的尊重和责任,以及媒体和法律的作用。同时,可能需要建议公众如何正确处理类似事件,或者呼吁对这类事件的公正处理。
关于“初三女生搀扶跌倒老奶奶后反被冤枉,但仍选择资助她千元”的事件,可以从以下几个角度进行思考:
一、事件的核心价值与道德选择
道德选择的合理性
- 女生在搀扶老奶奶后主动资助其千元,体现了“善良”与“正义”的双重价值。这种行为超越了简单地“助人”,更传递了“不因误解而放弃责任”的精神。
- 在道德层面,这种选择往往能引发社会对“诚信”“尊重”的反思,有助于塑造社会向善的氛围。法律与道德的博弈
- 事件中的“冤枉”可能源于法律与道德的界限模糊。法律通常关注事实真相,而道德则强调“心怀善意”的价值。当法律无法完全还原真相时,道德选择往往成为最后的救赎方式。二、事件的深层反思
社会信任的重构
- 这个事件可能引发公众对“诚信”“尊重”的再思考。当社会对“善意”的怀疑加深,个体的道德选择反而成为维系社会信任的关键。媒体与舆论的角色
- 新闻报道中,媒体对“冤枉”事件的过度渲染可能加剧公众的负面情绪,但同时,对事件的积极报道也展示了社会对正义的渴望。这种“反转”的新闻价值,本身可能成为社会进步的催化剂。制度与法律的完善
- 这类事件暴露了法律体系在处理“道德争议”时的局限性。例如,法律难以完全覆盖“好人”被诬陷的情况,这可能促使社会法律体系在伦理责任方面进行完善。三、对社会的启示
公众责任的提升
- 女生的资助行为不仅改变了事件的走向,也提醒公众:当遇到道德困境时,个体的善行可能比法律更具影响力。这种“道德补救”需要社会机制的支持,例如公众的监督、法律的宽容。法律与道德的平衡
- 事件可能促使社会对“法律”与“道德”的边界重新定义。法律不应过度介入道德纠纷,但道德行为的法律化可能成为未来社会发展的方向。尊重与责任的传承
- 事件中的老奶奶被资助,可能激发社会对“被尊重”的重视。这种行为不仅改变了事件本身,也传递了“被尊重”的价值,可能成为社会文明进步的隐喻。四、可能的建议
加强公共道德教育
- 通过教育引导公众在面对道德困境时,能够理解“善良”的价值,避免因误解而放弃善意。完善法律与社会机制
- 建立“道德补偿机制”,当法律无法完全还原真相时,社会通过制度化方式对“善行”给予支持。媒体与公众的角色
- 媒体应引导公众理性看待事件,避免过度渲染负面情绪,同时鼓励公众对道德行为的记录和传播。结语
事件本身没有对错,但其结果展现了社会对“善意”的认知和尊重。当“好人”被冤枉时,选择资助老奶奶的女生用行动证明了“善良”的价值。这种行为不仅是对事件的救赎,更是对社会伦理的重新定义。
4.4 小结
实操:启动api server,并使用代码访问,注意观察原版模型和训练后模型输出结果的不同
5、主要参数
LLaMA-Factory训练过程中用到的参数非常多,按照重要程度整理如下:
5.1 极重要,本次训练模型和数据路径
| 参数名称 | 说明 |
|---|---|
| 模型名称 | 基座模型的名称 |
| 模型路径 | 基座模型的路径 |
| 检查点路径 | 开始的checkpoint路径,如果不需要可以为空 |
| 数据路径 | 数据存放的目录 |
| 数据集 | dataset_info.json中记录的哪一个数据集 |
| 输出目录 | 训练好的模型的路径 |
| 训练参数目录 | 本次训练的参数 |
| 对话模板 | 和使用的基座模型一致 |
5.2 极重要,决定本次训练的基本性质
| 参数名称 | 说明 |
|---|---|
| 微调方法 | full--全参数训练 freeze--冻结一部分参数 LoRA--使用LoRA微调 |
| 训练阶段 | 属于哪个训练阶段 Supervised Fine-Tuning:进一步做有监督训练 Reward Modeling:奖励建模,用于强化学习 PPO:强化学习算法之一,用于增强多次迭代中的稳定性 DPO:强化学习算法之一,用于避免策略和价值函数之间的相互影响,提高学习效率 KTO:知识转移方法,可以强化学习效率和最终效果 Pre-Training:预训练 本次实验选Supervised Fine-Tuning |
| 量化等级 | none:不做量化 8:8位量化 4:4位量化 |
5.3 重要,决定本次训练的整体效果
| 参数名称 | 说明 |
|---|---|
| 学习率 | 0.1 一般只用于探索,没人会真的用 0.01 从头训练的标准模型初始学习率 0.001 已经快接近优化目标时做细致调整时采用 0.0001 模型接近收敛时做微调 0.00005 预训练阶段的最后微调 |
| 截断长度 | 本次实验选6000 |
| 训练轮数 | 学习的特性较简单 ,1轮即可,如果数据集太小,不应选择太多轮数,可以考虑数据增强。 |
| 批处理大小 | 根据显存的情况调整 |
| 梯度累计 | 批处理大小*梯度累计决定了梯度更新的频率 |
| 预热步数 | 建议使用,防止参数剧烈震荡 |
| LoRA的秩 | 学到信息的丰富程度 |
| LoRA缩放系数 | LoRA的重要程度 |
| LoRA随机丢弃 | 随机丢弃LoRA层权重的概率,是一种正则化方法,方式模型过度依赖LoRA |
5.4 小结
问题:1. 有哪两类参数是做任何训练都必须设置的
2.我想学习电气自动化的数据集,共有1500条,使用了0.01的学习率,做了10轮训练,为什么效果不好?
3.启动训练过程后不久即停止,日志里最后的错误如下:
torch.OutOfMemoryError:CUDA out of memory,Tried to allocate 7.26G,GPU 0 has a total capacity of 23.64GB which 16.56MB is free
问题可能出在哪里?怎么解决?
模型高效部署
第四章 【掌握】模型高效部署
1、学习目标
优化部署四条路:模型、工具、prompt、业务
2、vllm介绍
2.1 推理速度对比
第三章的最后已经用LLaMA-Factory部署了一个api server,实测速度5.05字/秒
微调后的模型使用vllm的api server部署
CUDA_VISIBLE_DEVICES=0 API_PORT=8000 vllm serve /workspace/deepseekDistllation/models/Qwen/Qwen2.5-3B-Instruct-GPTQ-Int4 \
    --enable-lora \
    --lora-modules cot=/workspace/deepseekDistllation/models/lora/Qwen2.5-3B-instruct-GPTQ-Int4/train_2025-03-20-20-41-50/checkpoint-1250/ cat=/workspace/deepseekDistllation/models/lora/Qwen2.5-3B-Instruct-GPTQ-Int4/train_2025-05-24-17-56-24/checkpoint-120/ spo=/workspace/deepseekDistllation/models/lora/Qwen2.5-3B-Instruct-GPTQ-Int4/train_2025-05-24-20-00-00/checkpoint-375/
测试问题:"对于「初三女生在搀扶跌倒老奶奶后反被冤枉,但仍选择资助她千元」的新闻事件,你有什么看法?"
输出长度:1794字 耗时:16.03秒 输出速度:111.92字/秒
嗯,用户问的是关于“初三女生搀扶跌倒老奶奶后反被冤枉,但仍选择资助她千元”的新闻事件的看法。首先,我需要回顾一下这个新闻的背景,确保自己了解所有细节。新闻中提到的事件发生在浙江杭州,涉及一名15岁的初中生和一位78岁高龄的老奶奶。女生在帮助老奶奶后被误认为是肇事者,但她坚持支付了1000元作为赔偿,同时承诺每月资助老奶奶。
接下来,我应该分析这个事件中的道德与法律问题。首先,女生的行为是否正确?根据法律,她是否需要承担责任?如果当时确实有证据证明她是受害者而非施救者,那么她可能需要承担法律责任,但如果没有足够的证据,法律可能会倾向于保护无辜者的权益。因此,她资助老人的行为可以被视为一种道德补偿,但法律层面可能无法完全消除争议。
然后要考虑公众舆论的影响。新闻事件引发了广泛的讨论,有人支持她的勇气和善良,也有人质疑她的行为是否值得如此大笔资助。这里需要探讨媒体报道对事件影响的两面性:一方面,正面报道可能强化了助人为乐的社会价值;另一方面,负面报道可能加剧对无辜者的误解和歧视。
再者,社会对老人权益的保护措施是否到位?新闻中提到老奶奶的受伤情况,可能涉及医疗费用或其他损失。如果相关部门没有及时介入调查,导致误会持续存在,这反映出社会在处理类似事件时的效率问题。此外,媒体和公众的反应速度是否足够迅速,能否有效澄清事实,避免二次伤害?
还要考虑青少年的教育问题。这个事件可能引发关于青少年社会责任感培养的讨论。家长、学校和社会是否应该通过教育引导孩子在遇到类似情况时如何正确应对,同时尊重法律程序,避免草率行动导致的误解。
另外,经济因素也是关键点。1000元虽然不算大数目,但对于一个贫困家庭来说,可能意味着生活开支的一部分。女生资助老人的行为是否值得,可能取决于家庭的具体情况。如果她的家庭能够承受这笔钱,或许是一种积极的举动;但如果家庭经济压力很大,资助可能带来负担。
最后,总结观点时需要平衡各方利益,既肯定女生的善良和勇敢,也要关注法律、社会和经济等多方面的因素,呼吁建立更完善的制度来预防此类事件的发生,并保护无辜者的权益不受损害。
关于"初三女生搀扶跌倒老奶奶后反被冤枉,仍选择资助她千元"的事件,我从多个角度进行了思考:
一、法律与道德的界限
- 责任认定困境:若女生确系"肇事者",法律应保障其合法权益,防止冤枉;若无证据指向,需秉持"疑罪从无"原则,避免草率定责。但现实中,部分案件因证据不足陷入"公义难辨"的尴尬。
- 道德补偿的意义:即便法律未明确责任,资助行为可视为"精神补偿",弥补法律救济的滞后。这种行为本身体现了社会伦理对弱势群体的关怀。
二、社会认知的裂痕
- 真相传播滞后:事件发酵过程中,部分媒体将事件归咎于"善意惹祸",加剧了公众对助人的恐惧。这种认知偏差可能使类似事件频发,形成恶性循环。
- 制度修复空间:现有法律体系尚缺乏针对"意外救助"的清晰指引,建议完善《民法典》第184条"紧急避险"条款,明确救助人权益保护机制。
三、青少年成长的启示
- 规则意识的塑造:教育机构需引导学生在"助人"与"自我保护"间找到平衡点,通过案例教学增强法治意识。
- 社会支持网络缺失:事件暴露出我国在老年人权益保障、公共安全预警等方面存在的短板,呼吁建立社区互助机制,提升社会抗风险能力。
四、经济维度的考量
- 家庭经济成本:1000元虽小,但对低收入家庭而言可能构成较大负担。若资助引发后续纠纷,反而加重家庭困境。
- 资源分配效率:建议政府设立"意外救助基金池",为类似事件提供快速赔付渠道,减轻家庭经济压力。
五、文化心理的反思
- 传统美德的现代转化:在"见义勇为"观念普遍化的同时,需警惕道德绑架现象。建议通过影视作品重塑"见义智为"的价值观。
- 数字时代的信任危机:社交媒体放大事件争议,凸显信息时代信任重建的重要性。
结语:事件本质是对公共治理效能的拷问。我们期待的不仅是对"善行"的表彰,更希望构建一个既能守护善良,又能维护公平正义的社会生态。未来需要在立法、制度、教育、技术等多个层面协同发力,让每一次"搀扶"都能成为温暖的起点。
2.2 vllm的优势
2.2.1 缓存优化
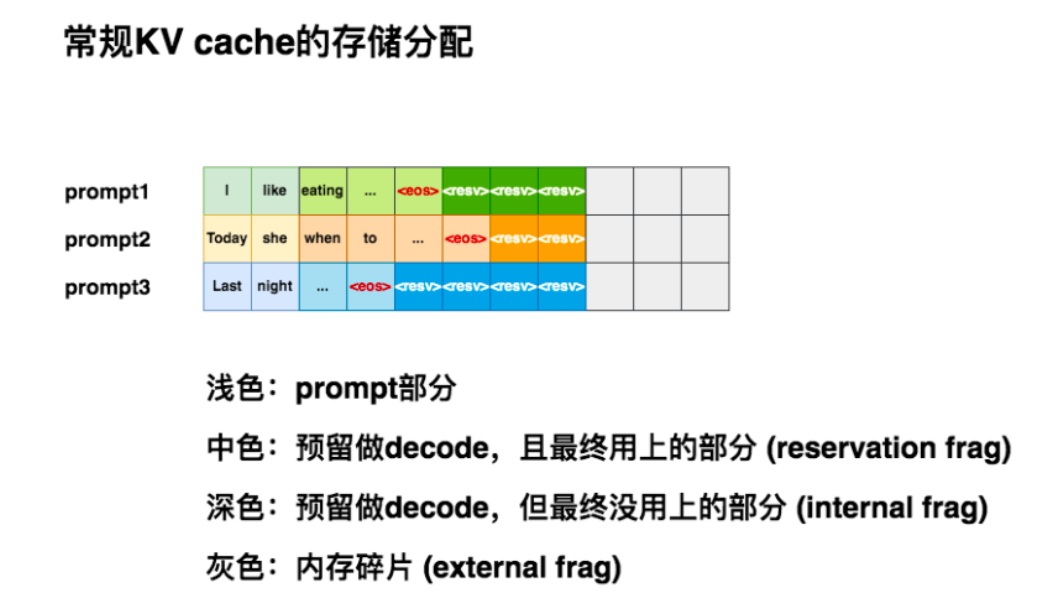
2.2.1.1 传统的KV Cache管理方式
大模型计算复杂度最高的就是自注意力QKV的计算,如果每输出一个字符都要从头计算的话,成本太高,所以可以把中间阶段的K和V值存入缓存,这就是KV Cache。
传统KV Cache是直接分配一段物理显存,这段物理显存随着prompt变长和输出序列变长,会不断增长,更糟糕的是,由于输出序列长度无法预测,无法为KV Cache量身分配大小,导致大量显存浪费。
2.2.1.2 vllm的改进-PageAttention
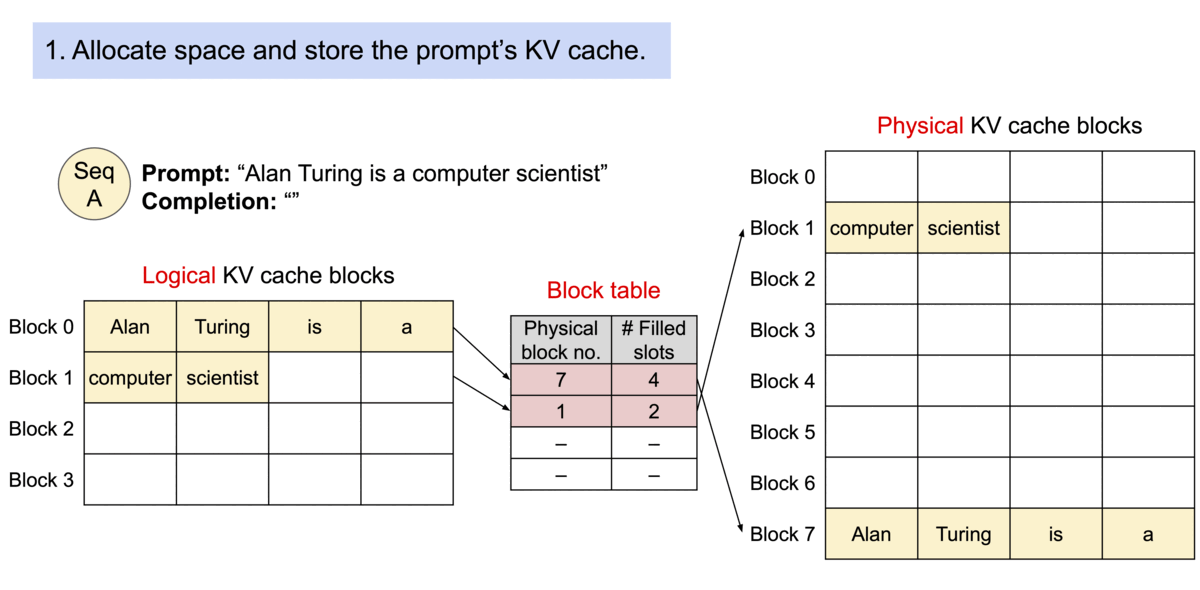
在显存上分配一块固定大小的连续空间(vllm中默认为16),类似于内存页
多个进程运行时,可以每个进程分配自己的虚拟内存,虚拟内存通过块表(block table)关联到内存页
只有进程内存不足时,才会请求增加,每次增加一个内存页,最坏的结果就是最后一个内存页没写满.
这种方式显存的利用率能达到96%
2.2.2 批量任务优化
批量推理时,PageAttention因为提高的显存的使用率,所以可以增加推理任务并行的数量。
vllm不再要求所有并行任务处于同一阶段,当其他推理任务进行时,只要资源充足,可以随时开始新推理任务,减少了任务批次间的等待。
如果超出并行量,最后的请求会被抢占(preemption),退出所有占用资源,等待运行中的任务完成
2.2.3 加载多个LoRA
vllm能够同时加载多个LoRA,随时可以指定使用其中的任意一个,这个特性在实际生产中非常方便。
2.2.3.1 方便对比测试
可以同时加载对比测试的N个LoRA,无缝切换使用任意一个,随时对比在不同输入下的表现。
2.2.3.2 节约服务器资源
如果有多个低频使用的LoRA,可以加载到少数几台服务器上,节省部署服务的硬件资源
2.2.3.3 方便负载均衡
如果多个LoRA分开部署,每个LoRA需要做自己的服务器组,组内资源共享,但组间无法共享;
如果多个LoRA统一部署,可以共享所有资源。
2.3 小结
问题:1. vllm在显存管理方面做了哪些优化?
2. vllm中有一批任务正在推理中,这是又收到一条推理请求,vllm会怎么处理?
2. 同时加载多个LoRA有哪些优点?
3、性能优化的思路
3.1 模型优化
模型裁剪
模型量化
模型蒸馏
3.2 工具优化
vllm
HuggingFace TGI
FasterTransformer
DeepSpeed-Inference
3.3 提示词优化
3.3.1 假设身份或情境
你是一位萌萌的小姑娘,今天看了一部严肃的二战纪录片,描述一下你的感受。
你是一位稳重严肃的政府官员,今天陪孩子看了一部喜剧动画片《功夫熊猫》,描述一下你的
感受。
3.3.2 清晰地描述任务
你是一位中国婚姻法方面的专家,我需要整理一份婚姻法方面的训练语料,共5000条,需要
考虑婚姻法的哪几个子领域,各自语料的数量是多少?
你是一位中国婚姻法方面的专家,我需要整理一份婚姻法方面的训练语料,共5000条,需要
考虑婚姻法的哪几个子领域,各自语料的数量是多少?用一个表格输出结果,每一行是一个子领
域,第一列是子领域的名称,第二列是语料的数量,第三列是对这个子领域的详细说明。不允许输
出其他字符。
3.3.3 提示词结构化
你是一位婚姻法方面的专家,根据【特定类别】的定义,针对其中夫妻权利义务方面的规定,
向学生提供20道练习题,你能提出哪些问题?每个问题单独一行,只允许输出问题本身,不允许输
出任何其他字符。
【特定类别】
["结婚登记与条件","夫妻权利义务","离婚程序与条件","财产分割","子女抚养与监护权","家庭暴力与
保护令","继承权与婚姻关系","无效婚姻与可撤销婚姻","涉外婚姻","法律责任与救济措施"]
各类别详细说明如下:
结婚登记与条件:涉及结婚年龄、自愿原则、禁止近亲结婚、疾病限制、登记程序及法律效力等。
夫妻权利义务:涵盖共同财产管理、相互扶养义务、姓名权、生育权及日常家事代理权等。
离婚程序与条件:包括协议离婚冷静期、诉讼离婚标准、分居认定、感情破裂证明及调解程序等。
财产分割:涉及共同财产界定、个人财产保护、债务承担、房产分割规则及隐匿财产追责等。
子女抚养与监护权:包含抚养费计算标准、探视权实施、非婚生子女权益、抚养关系变更及教育责
任等。
家庭暴力与保护令:涵盖暴力行为认定、人身保护令申请、证据收集、紧急庇护措施及刑事责任关
联等。
继承权与婚姻关系:涉及配偶继承顺位、遗嘱效力、遗产分割冲突、再婚继承权及代位继承问题
等。
无效婚姻与可撤销婚姻:包括重婚无效、胁迫婚姻撤销、隐瞒疾病撤销的程序及法律后果等。
涉外婚姻:涉及跨国婚姻登记、域外结婚效力认定、财产跨境分割及国际子女抚养公约适用等。
法律责任与救济措施:包含虚假登记处罚、拒不执行判决后果、损害赔偿计算及强制执行程序等。
3.3.4 输入的批处理
如果每条数据单独处理,会浪费大量的token用于做任务说明
你是一位婚姻法方面的专家,如果要把【输入文本】分类到【特定类别】中,那么【输入文本】属于夫妻权利义务是否准确?。
【特定类别】
["结婚登记与条件","夫妻权利义务","离婚程序与条件","财产分割","子女抚养与监护权","家庭暴力与保护令","继承权与婚姻关系","无效婚姻与可撤销婚姻","涉外婚姻","法律责任与救济措施"]
各类别详细说明如下:
结婚登记与条件:涉及结婚年龄、自愿原则、禁止近亲结婚、疾病限制、登记程序及法律效力等。
夫妻权利义务:涵盖共同财产管理、相互扶养义务、姓名权、生育权及日常家事代理权等。
离婚程序与条件:包括协议离婚冷静期、诉讼离婚标准、分居认定、感情破裂证明及调解程序等。
财产分割:涉及共同财产界定、个人财产保护、债务承担、房产分割规则及隐匿财产追责等。
子女抚养与监护权:包含抚养费计算标准、探视权实施、非婚生子女权益、抚养关系变更及教育责任等。
家庭暴力与保护令:涵盖暴力行为认定、人身保护令申请、证据收集、紧急庇护措施及刑事责任关联等。
继承权与婚姻关系:涉及配偶继承顺位、遗嘱效力、遗产分割冲突、再婚继承权及代位继承问题等。
无效婚姻与可撤销婚姻:包括重婚无效、胁迫婚姻撤销、隐瞒疾病撤销的程序及法律后果等。
涉外婚姻:涉及跨国婚姻登记、域外结婚效力认定、财产跨境分割及国际子女抚养公约适用等。
法律责任与救济措施:包含虚假登记处罚、拒不执行判决后果、损害赔偿计算及强制执行程序等。【输入文本】
妻子单方面决定终止妊娠是否侵犯丈夫的生育权?
可以考虑一次性输入多条数据,但要解释清楚数据之间如何分割
你是一位婚姻法方面的专家,如果要把【输入文本】分类到【特定类别】中,那么【输入文本】属于夫妻权利义务是否准确?【输入文本】中的每一行是一条独立数据,需要单独判定。输出时每条数据的结果单独输出一行。
【特定类别】
["结婚登记与条件","夫妻权利义务","离婚程序与条件","财产分割","子女抚养与监护权","家庭暴力与保护令","继承权与婚姻关系","无效婚姻与可撤销婚姻","涉外婚姻","法律责任与救济措施"]
各类别详细说明如下:
结婚登记与条件:涉及结婚年龄、自愿原则、禁止近亲结婚、疾病限制、登记程序及法律效力等。
夫妻权利义务:涵盖共同财产管理、相互扶养义务、姓名权、生育权及日常家事代理权等。
离婚程序与条件:包括协议离婚冷静期、诉讼离婚标准、分居认定、感情破裂证明及调解程序等。
财产分割:涉及共同财产界定、个人财产保护、债务承担、房产分割规则及隐匿财产追责等。
子女抚养与监护权:包含抚养费计算标准、探视权实施、非婚生子女权益、抚养关系变更及教育责任等。
家庭暴力与保护令:涵盖暴力行为认定、人身保护令申请、证据收集、紧急庇护措施及刑事责任关联等。
继承权与婚姻关系:涉及配偶继承顺位、遗嘱效力、遗产分割冲突、再婚继承权及代位继承问题等。
无效婚姻与可撤销婚姻:包括重婚无效、胁迫婚姻撤销、隐瞒疾病撤销的程序及法律后果等。
涉外婚姻:涉及跨国婚姻登记、域外结婚效力认定、财产跨境分割及国际子女抚养公约适用等。
法律责任与救济措施:包含虚假登记处罚、拒不执行判决后果、损害赔偿计算及强制执行程序等。【输入文本】
妻子单方面决定终止妊娠是否侵犯丈夫的生育权?
夫妻婚后是否必须统一姓氏?法律对姓名权的规定如何体现?
跨国婚姻登记的流程是什么?
离婚后,子女抚养费的计算标准是什么?
哪些合同不具有法律效力?
3.3.4 压缩输出长度
刚才的结果太冗长了,用起来不方便,而且输出的token更贵,应该尽可能压缩输出长度
你是一位婚姻法方面的专家,如果要把【输入文本】分类到【特定类别】中,那么【输入文本】属于夫妻权利义务是否准确?给出一个准确性评分,该评分是0到9之间的正整数,其中0表示完全错误,9表示非常准确。【输入文本】中的每一行是一条独立数据,需要单独判定。输出时每条数据的结果单独输出一行, 只允许输出准确性评分,不允许输出其他任何字符。
【特定类别】
["结婚登记与条件","夫妻权利义务","离婚程序与条件","财产分割","子女抚养与监护权","家庭暴力与保护令","继承权与婚姻关系","无效婚姻与可撤销婚姻","涉外婚姻","法律责任与救济措施"]
各类别详细说明如下:
结婚登记与条件:涉及结婚年龄、自愿原则、禁止近亲结婚、疾病限制、登记程序及法律效力等。
夫妻权利义务:涵盖共同财产管理、相互扶养义务、姓名权、生育权及日常家事代理权等。
离婚程序与条件:包括协议离婚冷静期、诉讼离婚标准、分居认定、感情破裂证明及调解程序等。
财产分割:涉及共同财产界定、个人财产保护、债务承担、房产分割规则及隐匿财产追责等。
子女抚养与监护权:包含抚养费计算标准、探视权实施、非婚生子女权益、抚养关系变更及教育责任等。
家庭暴力与保护令:涵盖暴力行为认定、人身保护令申请、证据收集、紧急庇护措施及刑事责任关联等。
继承权与婚姻关系:涉及配偶继承顺位、遗嘱效力、遗产分割冲突、再婚继承权及代位继承问题等。
无效婚姻与可撤销婚姻:包括重婚无效、胁迫婚姻撤销、隐瞒疾病撤销的程序及法律后果等。
涉外婚姻:涉及跨国婚姻登记、域外结婚效力认定、财产跨境分割及国际子女抚养公约适用等。
法律责任与救济措施:包含虚假登记处罚、拒不执行判决后果、损害赔偿计算及强制执行程序等。【输入文本】
妻子单方面决定终止妊娠是否侵犯丈夫的生育权?
夫妻婚后是否必须统一姓氏?法律对姓名权的规定如何体现?
跨国婚姻登记的流程是什么?
离婚后,子女抚养费的计算标准是什么?
哪些合同不具有法律效力?
4.3.3 格式化输出
如果对输出不做明确要求,很可能无法得到比较规范的输出形式
你是一位人力资源专家,现在需要你分析一份【简历】,并从中抽取【特定信息】。
【特定信息】
姓名,年龄,籍贯,政治面貌,毕业院校,工作经历,项目经验
【简历】
姓名:张啸林
电话 +86 178589625487
籍贯 山东枣庄
邮箱 aabbcc@gmail.com
学历 本科
微信 aabbcc
毕业院校 青岛大学青岛大学,学士学位,软件工程专业
2015/09-2019/07
均分: 85+ (专业 10%);在校期间, 获得优秀学生奖学金*3
职业技能 / Skills
集成学习: 随机森林, AdaBoost, GBDT, XGBoost, 朴素贝叶斯.
深度学习: 卷积神经网络, 循环神经网络(RNN, GRU, LSTM, BiLSTM), Bert(RoBERTa), CRF,
Casrel,
Transformer, Agent, MCP.
python 框架: pytorch, transformers, langchain, llama_index, peft.
大语言模型调用: Decoder-Only: GPT2, Qwen 系列, Deepseek 系列. Encoder-Decoder:
ChatGLM
轻代码平台: Dify, Coze
数据库: Mysql, MongoDB, Neo4j, Milvus
模型微调: LlamaFactory
微调方法: LoRA, PPO, DPO, KTO
工作经历 / Experience
联通**(山东)**产业互联网有限公司
AI 算法工程师
**2021/04-**至今
业务实现:
使用 Python 编程语言,基于大语言模型(LLM)开展实际业务场景的模型搭建与训练工作,
涵盖
数据预处理、模型微调、评估优化等全流程;持续跟进项目迭代,结合业务需求进行效果分析
与功能升
级,确保模型在真实场景中的实用性与稳定性,有效支撑项目目标达成。
需求分析:
分析业务数据, 寻找将需求转换成实际业务流的实现方式, 参与技术选型, 整体架构搭建等工作,
根
据后续实际开发验证了可行性, 获得部门及业务方一致认可.
青岛思锐科技有限公司
软件工程师
2020/04-2021/03
业务实现:
使用 Java 协同自动化工程师,开发 IoT 应用层视觉识别数据到业务指令的转换服务,为客户
端软件提供后端支持. 该系统在面向 ToB 业务中落地应用,助力产品+软件服务模式实现.
需求分析:
从软件工程角度, 评估基于业务提出的需求可行性, 将复杂逻辑转移到软件接口层面, 将自动化
工程师工作与应用层冗杂业务解耦.
如果明确指定输出格式,输出结果就会规范得多,而且内容也比较简短
你是一位人力资源专家,现在需要你分析一份【简历】,并从中抽取【特定信息】,并且按照
【指定格式】输出,不允许输出其他任何字符,如果特定信息不存在,输出“无”,不允许自行编
造。
【特定信息】
姓名,年龄,籍贯,政治面貌,毕业院校,工作经历,项目经验
【指定格式】
{“姓名”:“张大彪”,
"年龄":"32",
"籍贯":"上海市宝安区",
"政治面貌":"群众",
"毕业院校":"上海龙腾职业技术学校",
"工作经历":[
{
“公司名称”:“上海新锐建筑有限公司”,
"职务":"工段长",
"起始时间":"2023年7月",
"结束时间":"2024年9月",
},
{
“公司名称”:“中国第四建筑集团黄埔分公司”,
"职务":"销售部经理",
"起始时间":"2024年9月",
"结束时间":"2025年3月",
}
]
}
【简历】
姓名:张啸林
电话 +86 178589625487
籍贯 山东枣庄
邮箱 aabbcc@gmail.com
学历 本科
微信 aabbcc
毕业院校 青岛大学
青岛大学,学士学位,软件工程专业
2015/09-2019/07
均分: 85+ (专业 10%);在校期间, 获得优秀学生奖学金*3
职业技能 / Skills
集成学习: 随机森林, AdaBoost, GBDT, XGBoost, 朴素贝叶斯.
深度学习: 卷积神经网络, 循环神经网络(RNN, GRU, LSTM, BiLSTM), Bert(RoBERTa), CRF,
Casrel,
Transformer, Agent, MCP.
python 框架: pytorch, transformers, langchain, llama_index, peft.
大语言模型调用: Decoder-Only: GPT2, Qwen 系列, Deepseek 系列. Encoder-Decoder:
ChatGLM
轻代码平台: Dify, Coze
数据库: Mysql, MongoDB, Neo4j, Milvus
模型微调: LlamaFactory
微调方法: LoRA, PPO, DPO, KTO
工作经历 / Experience
联通**(山东)**产业互联网有限公司
AI 算法工程师
**2021/04-**至今
业务实现:
使用 Python 编程语言,基于大语言模型(LLM)开展实际业务场景的模型搭建与训练工作,
涵盖
数据预处理、模型微调、评估优化等全流程;持续跟进项目迭代,结合业务需求进行效果分析
与功能升
级,确保模型在真实场景中的实用性与稳定性,有效支撑项目目标达成。
**需求分析:**分析业务数据, 寻找将需求转换成实际业务流的实现方式, 参与技术选型, 整体架构搭建等工作,
根
据后续实际开发验证了可行性, 获得部门及业务方一致认可.
青岛思锐科技有限公司
软件工程师
2020/04-2021/03
业务实现:
使用 Java 协同自动化工程师,开发 IoT 应用层视觉识别数据到业务指令的转换服务,为客户
端软
件提供后端支持. 该系统在面向 ToB 业务中落地应用,助力产品+软件服务模式实现.
需求分析:
从软件工程角度, 评估基于业务提出的需求可行性, 将复杂逻辑转移到软件接口层面, 将自动化
工程师工作与应用层冗杂业务解耦.
3.4 业务优化
3.4.1 大模型无法处理,慎用
大模型无法处理的任务有以下两种:
3.4.1.1 统计性任务
典型的统计性任务有文本聚类、信息检索
3.4.1.2 低延迟任务
典型的低延迟任务有高频交易、舆情监控
3.4.2 大模型无法体现优势,慎用
大模型在以下几类任务中没有明显优势:
3.4.2.1 较简单的分类任务
3.4.2.2 一般性的序列标注任务
如分词、词性标注、常见实体类型的识别
3.4.2.3 特别专业的领域
如医药、化工等领域非常依赖专业词典
3.4.3 大模型和传统方法有机结合
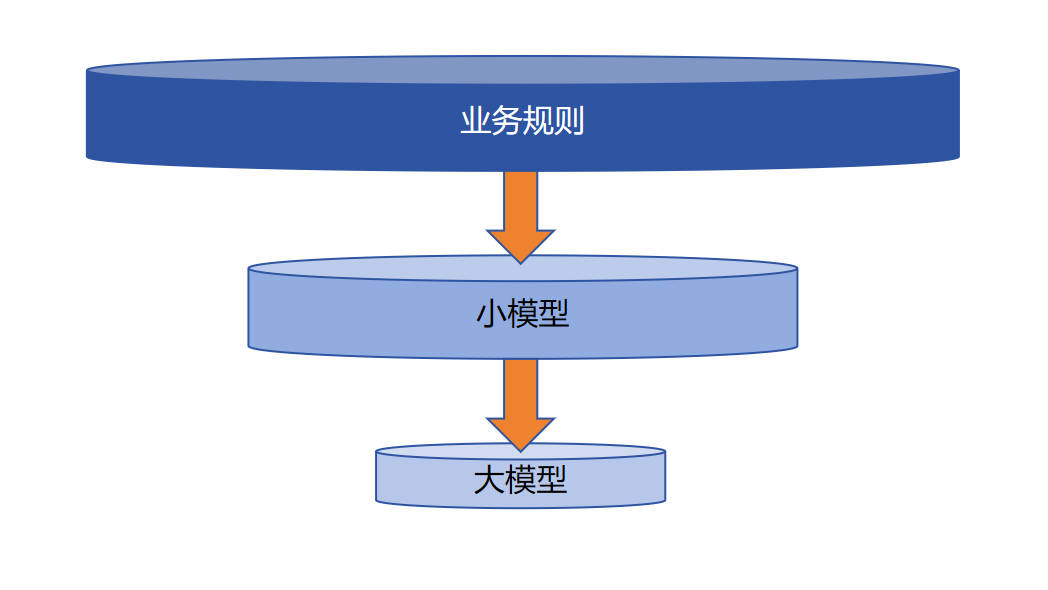
用简单快速的模型或方法处理大部分容易处理的数据
用大模型处理少量困难的数据
层层拦截,尽量减轻大模型的负担,使得整体效果最好,速度最快
示例场景:车系识别
3.4.3.1 背景
某汽车领域互联网企业需要短期内识别某时间段内所有文本中的车系,希望挖掘浏览者的购买意向,形成商业价值,这批数据有2.86亿左右的文章。要求速度快,时间短,资源消耗少。
3.4.3.2 考虑方案
用大模型实验,效果非常好,但是时间来不及,也没有这么多资源可用
考虑过序列标注模型,但没有语料,没有标注人员支持,即使有现成的模型,现有资源下2.86亿文章全部用序列模型跑一边时间仍然来不及。
4.4.3.3 深入挖掘任务的特性
车系基本情况如下:
| 类型 | 数量 | 例子 |
|---|---|---|
| 无歧义车系 | 3129 | 帕萨特、传祺、马自达、凯迪拉克 |
| 常用词歧义 | 116 | 几何、哪吒、指挥官 |
| 英文数字字符串歧义 | 513 | XC60、SL350 |
| 总数 | 3758 |
样本文章分析情况如下:
| 类型 | 占比 |
|---|---|
| 没有出现车系 | 84.3% |
| 仅出现无歧义车系 | 13.16% |
| 有潜在歧义车系 | 2.54% |
3.4.3.4 最终方案
用AC自动机在所有文章中扫描所有车系字符串
无车系的,丢弃
所有无歧义车系,记录文章ID,车系,出现位置
所有潜在歧义车系,取固定长度上下文(前后各20个字)送大模型判定
prompt: 你是一位汽车行业的专家,需要你确定一组文本片段的特定字符串是不是代表一个车系,如果是车系,输出是;否则输出否。不允许输出其他任何字符。下面提供一个例子
假如输入是:
[
["例如硬币、卡片、金属表面和物品)确保使用 XC360 安全充电。 您不需要拆卸智能手机", #第一条数据的文本片段
"xc360" #第一条数据的特定字符串
],
["现在行业内手自一体销量大增,XC360就是其中的佼佼者", #第二条数据的文本片段
"xc360" #第二条数据的特定字符串
],
]
那么对应的输出是:
否是
现在真实的输入是:
[
["今年哪吒大火,票房达到了惊人的120亿美元",
"哪吒"
],
["大部分朋友对此有一个误解,其实哪吒的目标从来都不是商务用车,而更偏向于表达用户的个性",
"哪吒"]
]
3.4.3.5 经济效益
前提
文章总量2.86亿,平均字数1000左右
在所有文章中,平均每篇含有车系0.31个,平均每个车系名称长度3.8
在所有含有潜在歧义车系的文章中,平均每篇含有潜在歧义车系2.5个,平均每个车系名称长度4.6
硅基流动上deepseek-R1目前输入为4元/M token,输出为16元/M token
方案一 直接使用大模型,提示词为:
你是一位汽车行业的专家,判断【输入文本】是否含有车系名称,并将结果以【指定格式】输出,不允许输出其他任何字符。
【指定格式】
["卡罗拉","指挥官","XC360"]
【输入文本】
总输入字数为:2.86亿*(1000+91)=3120.26亿字,成本为:3120.26亿X0.6/1000000X4 = 748862.4元
总输出字数为:2.86亿*(2+(2+3.8)X0.31) = 10.86亿字,成本为 10.86亿X0.6/1000000X16 = 10425.6元
总成本:759288元
方案二 使用混合策略方案
实际需要大模型判断的文章总量是2.86亿*2.54% = 726.44万篇
平均每个潜在歧义车系长度为4.6,添加上下文各20字,算上结构化增加的符号,每条数据共计60字
平均每篇文章含潜在歧义车系2.5个,总共有潜在歧义车系1816.1万个
每20条数据写入一条提示词,总共发送请求908050次
提示词模板长度305字,实际数据60*20,每次请求共计输入1505字,输出20字
实际送交大模型的13.666亿字,输出0.1816亿字
总输入字数为:13.666亿,成本为:13.666亿X0.6/1000000X4 = 3279.84元
总输出字数为:0.1816亿,成本为:0.1816亿X0.6/1000000X16 = 174.34元
总成本为:3454.18元
结论
| 输入字符数 | 输入字符数 | 输出字符数 | 总成本 |
|---|---|---|---|
| 方案一 | 3120.26亿 | 10.86亿 | 759288元 |
| 方案二 | 13.7亿 | 0.1816亿 | 3454.18元 |
| 方案二/方案一 | 0.439% | 1.672‰ | 0.455% |
3.5 小结
问题:1. 优化大模型性能有哪些方法
2.怎样利用prompt优化模型性能?
3.哪些任务大模型没有优势?为什么?
实操:针对一个实际问题,写一些prompt,试验教程中提到的优化方法
LlamaFactory / vLLM 测试代码
5 个文件- 📄 01_testLlamaFactory.py 1.4KB 下载
- 📄 02_testVllm.py 2.0KB 下载
- 📄 02_testVllm_local.py 1.9KB 下载
- 📄 03_vllm_demo_online.py 3.3KB 下载
- 📄 __init__.py 0B 下载
RLHF / PPO / 蒸馏导图
- 🖼️ PPO训练架构.png 64.3KB
- 🖼️ RLHF基础架构.png 26.5KB
- 🧠 deepseek蒸馏小模型.xmind 98.3KB
- 🖼️ llamafactory的训练阶段.png 65.5KB
- 🖼️ 微调训练环境的文件目录.png 40.9KB
- 🖼️ 改良意图识别.png 22.0KB
- 🖼️ 生产者消费者代码实现.png 27.7KB
- 🖼️ 生产者消费者模式.png 39.4KB
- 🖼️ 累积占比的方式进行句子长度截取.png 130.1KB
- 🖼️ 项目架构.png 86.8KB
蒸馏课程导图
- 🧠 大模型蒸馏课程.xmind 5.2MB