第 10 节 / 共 10 节
第10章 微调实战:推理部署(day14)
NLP 基础(day14)
NLP基础
【了解】今日内容介绍
- 微调任务
- 完形填空任务
- NSP任务
- NLP数据集
- BERT模型介绍
【实现】微调任务
完形填空任务
Bert模型内置2个任务:
#1.MLM:MASKed Language Model
遮蔽型语言建模任务(掩码语言模型),就是我们刚刚讲的完形填空。

#2.NSP:Next Sentence Prediction
下一句话预测任务。
需求说明
也称之为MLM任务,输入一句话,MASK一个字,训练模型,进行填空。
获取数据
和之前的一样,数据文件有三个train.csv,test.csv,validation.csv,数据样式都是一样的。
对文件中数据进行处理,以满足模型训练要求。
import torch
from torch.utils.data import DataLoader
from datasets import load_dataset
from transformers import BertTokenizer, BertModel
from transformers import AdamW
import time

# 加载字典和分词工具
my_tokenizer = BertTokenizer.from_pretrained('bert-base-chinese')

# 加载预训练模型
my_model_pretrained = BertModel.from_pretrained('bert-base-chinese')


# 数据集处理自定义函数
def collate_fn2(data):
    sents = [i['text'] for i in data]

    # 文本数值化
    data = my_tokenizer.batch_encode_plus(batch_text_or_text_pairs=sents,
                                   truncation=True,
                                   padding='max_length',
                                   max_length=32,
                                   return_tensors='pt',
                                   return_length=True)

    # input_ids 编码之后的数字
    # attention_mask 是补零的位置是0,其他位置是1
    input_ids = data['input_ids']
    attention_mask = data['attention_mask']
    token_type_ids = data['token_type_ids']

    # 把第16个词固定替换为mask
    labels = input_ids[:, 16].reshape(-1).clone()  # 取出数据8句话 在第16个位置clone出来 做标签
    input_ids[:, 16] = my_tokenizer.get_vocab()[my_tokenizer.mask_token]
    labels = torch.LongTensor(labels)

    # tmpa = input_ids[:, 16]
    # print('tmpa--->', tmpa, tmpa.shape)       # torch.Size([8]
    # print('labels-->', labels.shape, labels)  # torch.Size([8]

    return input_ids, attention_mask, token_type_ids, labels


# 数据源 数据迭代器 测试
def dm01_test_dataset():

    # 生成数据源dataset对象
    dataset_train_tmp = load_dataset('csv', data_files='./data/train.csv', split="train")
    # print('dataset_train_tmp--->', dataset_train_tmp)

    # 按照条件过滤数据源对象
    my_dataset_train = dataset_train_tmp.filter(lambda x: len(x['text']) > 32)
    # print('my_dataset_train--->', my_dataset_train)
    # print('my_dataset_train[0:3]-->', my_dataset_train[0:3])

    # 通过dataloader进行迭代
    mydataloader = DataLoader(my_dataset_train, batch_size=8, collate_fn=collate_fn2, shuffle=True, drop_last=True)
    print('mydataloader--->', mydataloader)

    # 不训练,不需要计算梯度
    for param in my_model_pretrained.parameters():
        param.requires_grad_(False)

    # 调整数据迭代器对象数据返回格式
    for i, (input_ids, attention_mask, token_type_ids, labels) in enumerate(mydataloader):

        print(input_ids.shape, attention_mask.shape, token_type_ids.shape, labels)

        print('\n第1句mask的信息')
        print(my_tokenizer.decode(input_ids[0]))
        print(my_tokenizer.decode(labels[0]))

        print('\n第2句mask的信息')
        print(my_tokenizer.decode(input_ids[1]))
        print(my_tokenizer.decode(labels[1]))
        break
定义模型
# 定义下游任务模型
class MyModel(torch.nn.Module):
    def __init__(self):
        super().__init__()
        # 定义全连接层
        self.linear = torch.nn.Linear(768, my_tokenizer.vocab_size)

    def forward(self, input_ids, attention_mask, token_type_ids):
        # 预训练模型不进行训练
        with torch.no_grad():
            out = my_model_pretrained(input_ids=input_ids,
                             attention_mask=attention_mask,
                             token_type_ids=token_type_ids)

        # 下游任务进行训练 形状[8,768] ---> [8, 21128]
        out = self.linear(out.last_hidden_state[:, 16])

        # 返回
        return out
模型训练
# 模型训练 - 填空
def dm03_train_model():

    # 实例化数据源对象my_dataset_train
    dataset_train_tmp = load_dataset('csv', data_files='./data/train.csv', split="train")
    my_dataset_train = dataset_train_tmp.filter(lambda x: len(x['text']) > 32)
    print('my_dataset_train--->', my_dataset_train)

    # 实例化下游任务模型my_model
    my_model = MyModel()

    # 实例化优化器my_optimizer
    my_optimizer = AdamW(my_model.parameters(), lr=5e-4)

    # 实例化损失函数my_criterion
    my_criterion = torch.nn.CrossEntropyLoss()

    # 不训练预训练模型 只让预训练模型计算数据特征 不需要计算梯度
    for param in my_model_pretrained.parameters():
        param.requires_grad_(False)

    # 设置训练参数
    epochs = 1

    # 设置模型为训练模型
    my_model.train()

    # 外层for循环 控制轮数
    for eporch_idx in range(epochs):

        # 实例化数据迭代器对象my_dataloader
        my_dataloader = torch.utils.data.DataLoader(my_dataset_train,
                                                    batch_size=8,
                                                    collate_fn=collate_fn2,
                                                    shuffle=True,
                                                    drop_last=True)
        starttime = (int)(time.time())
        # 内层for循环 控制迭代次数
        for i, (input_ids, attention_mask, token_type_ids, labels) in enumerate(my_dataloader, start=1):
            # 给模型喂数据 [8,32] --> [8,21128]
            my_out = my_model(input_ids=input_ids,
                        attention_mask=attention_mask,
                        token_type_ids=token_type_ids)

            # 计算损失
            my_loss = my_criterion(my_out, labels)

            # 梯度清零
            my_optimizer.zero_grad()

            # 反向传播
            my_loss.backward()

            # 梯度更新
            my_optimizer.step()

            # 每5次迭代 算一下准确率
            if i % 20 == 0:
                out = my_out.argmax(dim=1) # [8,21128] --> (8,)
                accuracy = (out == labels).sum().item() / len(labels)
                print('轮次:%d 迭代数:%d 损失:%.6f 准确率%.3f 时间%d' \
                      %(eporch_idx, i, my_loss.item(), accuracy, (int)(time.time())-starttime))

        # 每个轮次保存模型
        torch.save(my_model.state_dict(), './my_model_mask_%d.bin' % (eporch_idx + 1))
模型评估
# 模型测试:填空
def dm04_evaluate_model():

    # 实例化数据源对象my_dataset_test
    print('\n加载测试集')
    my_dataset_tmp = load_dataset('csv', data_files='./data/test.csv', split='train')
    my_dataset_test = my_dataset_tmp.filter(lambda x: len(x['text']) > 32)
    print('my_dataset_test--->', my_dataset_test)
    # print(my_dataset_test[0:3])

    # 实例化下游任务模型my_model
    path = './my_model_mask_3.bin'
    my_model = MyModel()
    my_model.load_state_dict(torch.load(path))
    print('my_model-->', my_model)

    # 设置下游任务模型为评估模式
    my_model.eval()

    # 设置评估参数
    correct = 0
    total = 0

    # 实例化化dataloader
    my_loader_test = torch.utils.data.DataLoader(my_dataset_test,
                                              batch_size=8,
                                              collate_fn=collate_fn2,
                                              shuffle=True,
                                              drop_last=True)

    # 给模型送数据 测试预测结果
    for i, (input_ids, attention_mask, token_type_ids,
            labels) in enumerate(my_loader_test):

        with torch.no_grad():
            my_out = my_model(input_ids=input_ids,
                        attention_mask=attention_mask,
                        token_type_ids=token_type_ids)

        out = my_out.argmax(dim=1)
        correct += (out == labels).sum().item()
        total += len(labels)

        if i % 25 == 0:
            print(correct / total)
所有代码
import torch
import torch.nn as nn
from transformers import BertTokenizer, BertModel, AdamW
import time
from datasets import load_dataset
from torch.utils.data import DataLoader
from tqdm import tqdm

bert_tokenizer = BertTokenizer.from_pretrained("./model/bert-base-chinese")
bert_model = BertModel.from_pretrained("./model/bert-base-chinese")


def collate_fn1(data):
    # print("data-->", data)
    sents = [x['text'] for x in data]

    data = bert_tokenizer.batch_encode_plus(sents,
                                            padding='max_length',
                                            max_length=50,
                                            truncation=True,
                                            return_tensors='pt')

    # print("data-->", data)

    input_ids = data['input_ids']
    token_type_ids = data['token_type_ids']
    attention_mask = data['attention_mask']

    labels = input_ids[:, 16].clone() # [4]
    input_ids[:, 16] = bert_tokenizer.mask_token_id # [4, 32]
    # print("input_ids-->", input_ids, input_ids.shape)
    # print("labels-->", labels, labels.shape)
    return input_ids, token_type_ids, attention_mask, labels


def load_data():
    my_datasets = load_dataset('csv', data_files='./data/train.csv', split='train')
    my_dataloader = DataLoader(dataset=my_datasets, batch_size=4, drop_last=True, shuffle=True, collate_fn=collate_fn1)
    for input_ids, token_type_ids, attention_mask, labels in my_dataloader:
        print("input_ids-->", input_ids)
        print("token_type_ids-->", token_type_ids)
        print("attention_mask-->", attention_mask)
        print("labels-->", labels)
        break

class MyModel(nn.Module):
    def __init__(self):
        super(MyModel, self).__init__()
        self.linear = nn.Linear(768, bert_tokenizer.vocab_size)

    def forward(self, input_ids, token_type_ids, attention_mask):
        with torch.no_grad():
            out = bert_model(input_ids=input_ids, token_type_ids=token_type_ids, attention_mask=attention_mask)
        # print("out-->", out)
        # print("out.last_hidden_state.shape-->", out.last_hidden_state.shape) # [4, 32, 768]
        # print("out.pooler_output.shape-->", out.pooler_output.shape) # [4, 768]
        # print('out.last_hidden_state[:, 16].shape-->', out.last_hidden_state[:, 16].shape) # [4, 768]
        output = self.linear(out.last_hidden_state[:, 16])
        # print("output-->", output.shape) # [4, 21128]
        return output


def test_mymodel():
    my_datasets = load_dataset('csv', data_files='./data/train.csv', split='train')
    my_dataloader = DataLoader(dataset=my_datasets, batch_size=4, drop_last=True, shuffle=True, collate_fn=collate_fn1)
    model = MyModel()
    for input_ids, token_type_ids, attention_mask, labels in my_dataloader:
        output = model(input_ids=input_ids, token_type_ids=token_type_ids, attention_mask=attention_mask)
        print("output-->", output, output.shape)
        break


def train2model():
    my_datasets = load_dataset('csv', data_files='../day11/data/train.csv', split='train')
    my_datasets = my_datasets.filter(lambda x:len(x['text']) > 50)
    my_dataloader = DataLoader(dataset=my_datasets, batch_size=4, drop_last=True, shuffle=True, collate_fn=collate_fn1)
    model = MyModel()
    optimizer = AdamW(params=model.parameters(), lr=5e-4, betas=[0.9, 0.99])
    criterion = nn.CrossEntropyLoss()
    for p in bert_model.parameters():
        p.requires_grad_(False)
    epochs = 3
    total_num = 0
    total_loss = 0
    accuracy = 0
    start_time = time.time()
    model.train()

    for epoch in range(epochs):
        for input_ids, token_type_ids, attention_mask, labels in tqdm(my_dataloader):
            out = model(input_ids=input_ids,
                        token_type_ids=token_type_ids,
                        attention_mask=attention_mask)
            loss = criterion(out, labels)
            optimizer.zero_grad()
            loss.backward()
            optimizer.step()

            total_loss += loss.item()
            total_num += len(labels)
            idx = torch.argmax(out, dim=-1)
            accuracy += (idx == labels).sum().item()

            if total_num % 20 == 0:
                end_time = time.time()
                avg_loss = total_loss / total_num
                avg_acc = accuracy / total_num
                print("轮次:", epoch + 1, "损失:", avg_loss, "准确率:", avg_acc, "耗时:", end_time - start_time)
        # 保存模型
        torch.save(model.state_dict(), './save_model/model_2.pth')


def predict2model():
    my_datasets = load_dataset('csv', data_files='./data/test.csv', split='train')
    my_datasets = my_datasets.filter(lambda x: len(x['text']) > 32)
    my_dataloader = DataLoader(dataset=my_datasets, batch_size=4, drop_last=True, shuffle=True, collate_fn=collate_fn1)
    model = MyModel()
    model.load_state_dict(torch.load('./save_model/model_2.pth'))
    model.eval()
    total_num = 0
    accuracy = 0
    start_time = time.time()
    for input_ids, token_type_ids, attention_mask, labels in tqdm(my_dataloader):
        out =  model(input_ids=input_ids,
                     token_type_ids=token_type_ids,
                     attention_mask=attention_mask)
        idx =torch.argmax(out, dim=-1)
        accuracy += (idx == labels).sum().item()
        total_num += len(labels)

        if total_num % 20 == 0:
            end_time = time.time()
            avg_acc = accuracy / total_num
            print("准确率:", avg_acc, "耗时:", end_time - start_time)


if __name__ == '__main__':
    # load_data()
    # test_mymodel()
    # train2model()
    predict2model()
NSP任务
需求说明
下一句话任务NSP(Next Sentence Prediction) 中文句子关系任务。输入2句话,判断第二句是否为第一句的下半句。
获取数据
和之前的一样,数据文件有三个train.csv,test.csv,validation.csv,数据样式都是一样的。
对文件中数据进行处理,以满足模型训练要求。
import random

import torch
import torch.nn as nn
from torch.utils.data import DataLoader, Dataset
from transformers import BertTokenizer, BertModel, AdamW
from datasets import load_dataset

bert_tokenizer = BertTokenizer.from_pretrained("../model/bert-base-chinese")
bert_model = BertModel.from_pretrained("../model/bert-base-chinese")

#1.定义数据处理函数
def collate_fn(data):
    # print("data-->", data)
    sents = [tuple1[0:2] for tuple1 in data]
    labels = [tuple1[2] for tuple1 in data]
    # print("sents-->", sents)
    # print("labels-->", labels)

    data = bert_tokenizer.batch_encode_plus(sents, truncation=True, padding=True, return_tensors='pt', max_length=50)

    input_ids = data["input_ids"]
    token_type_ids = data["token_type_ids"]
    attention_mask = data["attention_mask"]

    labels = torch.tensor(labels, dtype=torch.long)

    return input_ids, attention_mask, token_type_ids, labels


#2.定义数据集类
class MyDataset(Dataset):
    def __init__(self, path):
        tmp_dataset = load_dataset("csv", data_files=path, split="train")
        self.dataset = tmp_dataset.filter(lambda x: len(x['text']) > 44)

    def __len__(self):
        return len(self.dataset)

    def __getitem__(self, index):
        # print("index-->", index)
        data = self.dataset[index]["text"]
        # print("data-->", data)

        label = 1
        sent1 = data[:22]
        # print("sent1-->", sent1)
        sent2 = data[22:44]
        # print("sent2-->", sent2)
        flag = random.randint(0, 1)
        # print("flag-->", flag)
        while flag == 0:
            j = random.randint(0, len(data) - 1)
            if j == index:
                continue
            sent2 = self.dataset[j]['text'][22:44]
            label = 0
            break
        return sent1, sent2, label


#3.获取数据集
def get_dataloader():
    #1.获取dataset
    my_dataset = MyDataset("../data/train.csv")
    # sent1, sent2, label = my_dataset[0]
    # print('sent1-->', sent1)
    # print('sent2-->', sent2)
    # print('label-->', label)
    #2.构建dataloader
    my_dataloader = DataLoader(dataset=my_dataset, shuffle=True, batch_size=8, collate_fn=collate_fn, drop_last=True)

    # for input_ids, attention_mask, token_type_ids, labels in my_dataloader:
    #     print("input_ids-->", input_ids, input_ids.shape)
    #     print("labels-->", labels, labels.shape)
    #     break

    return my_dataloader


if __name__ == '__main__':
    get_dataloader()
定义模型
#4.定义模型
class MyModel(nn.Module):
    def __init__(self):
        super(MyModel, self).__init__()
        self.linear = nn.Linear(768, 2)

    def forward(self, input_ids, attention_mask, token_type_ids):
        with torch.no_grad():
            bert_out = bert_model(input_ids, attention_mask, token_type_ids=token_type_ids)
        #last_hidden_state:词向量, pooler_output:句向量
        # print("bert_out-->", bert_out)
        out = self.linear(bert_out['pooler_output'])
        return out
模型训练
#5.模型训练
def train_model():
    #1.准备物料
    my_dataloader = get_dataloader()
    my_model = MyModel()
    my_optimizer = AdamW(params=my_model.parameters(), lr=5e-4)
    my_loss_fn = nn.CrossEntropyLoss()
    epochs = 3

    for param in bert_model.parameters():
        param.requires_grad_(False)

    my_model.train()

    for epoch in range(epochs):
        for i, (input_ids, attention_mask, token_type_ids, labels) in enumerate(my_dataloader):
            my_out = my_model(input_ids=input_ids, attention_mask=attention_mask, token_type_ids=token_type_ids)
            loss = my_loss_fn(my_out, labels)
            my_optimizer.zero_grad()
            loss.backward()
            my_optimizer.step()

            # 打印日志
            if i % 10 == 0:
                out = torch.argmax(my_out, -1)
                acc = (out == labels).sum().item() / len(labels)
                print('轮次:%d 迭代数:%d 损失:%.6f 准确率%.3f' % (epoch, i, loss.item(), acc))
        #保存模型
        torch.save(my_model.state_dict(), '../save/nsp_model_%d.bin' % (epoch + 1))
模型评估
#6.模型评估
def evluate_model():
    my_dataset = MyDataset("../data/test.csv")
    my_dataloader = DataLoader(my_dataset, batch_size=8, shuffle=True, collate_fn=collate_fn, drop_last=True)
    my_model = MyModel()
    my_model.load_state_dict(torch.load("../save/nsp_model_3.bin"))

    correct = 0
    total = 0
    my_model.eval()

    for i,(input_ids, attention_mask, token_type_ids, labels) in enumerate(my_dataloader):
        with torch.no_grad():
            my_out = my_model(input_ids=input_ids, attention_mask=attention_mask, token_type_ids=token_type_ids)
        out = torch.argmax(my_out, dim=-1)
        correct += (out == labels).sum().item()
        total += len(labels)
        # 打印日志
        if i % 10 == 0:
            print("i-->", i, "准确率-->", correct/total)
所有代码
import random

import torch
import torch.nn as nn
from torch.utils.data import DataLoader, Dataset
from transformers import BertTokenizer, BertModel, AdamW
from datasets import load_dataset

bert_tokenizer = BertTokenizer.from_pretrained("../model/bert-base-chinese")
bert_model = BertModel.from_pretrained("../model/bert-base-chinese")

#1.定义数据处理函数
def collate_fn(data):
    # print("data-->", data)
    sents = [tuple1[0:2] for tuple1 in data]
    labels = [tuple1[2] for tuple1 in data]
    # print("sents-->", sents)
    # print("labels-->", labels)

    data = bert_tokenizer.batch_encode_plus(sents, truncation=True, padding=True, return_tensors='pt', max_length=50)

    input_ids = data["input_ids"]
    token_type_ids = data["token_type_ids"]
    attention_mask = data["attention_mask"]

    labels = torch.tensor(labels, dtype=torch.long)

    return input_ids, attention_mask, token_type_ids, labels


#2.定义数据集类
class MyDataset(Dataset):
    def __init__(self, path):
        tmp_dataset = load_dataset("csv", data_files=path, split="train")
        self.dataset = tmp_dataset.filter(lambda x: len(x['text']) > 44)

    def __len__(self):
        return len(self.dataset)

    def __getitem__(self, index):
        # print("index-->", index)
        data = self.dataset[index]["text"]
        # print("data-->", data)

        label = 1
        sent1 = data[:22]
        # print("sent1-->", sent1)
        sent2 = data[22:44]
        # print("sent2-->", sent2)
        flag = random.randint(0, 1)
        # print("flag-->", flag)
        while flag == 0:
            j = random.randint(0, len(data) - 1)
            if j == index:
                continue
            sent2 = self.dataset[j]['text'][22:44]
            label = 0
            break
        return sent1, sent2, label


#3.获取数据集
def get_dataloader():
    #1.获取dataset
    my_dataset = MyDataset("../data/train.csv")
    # sent1, sent2, label = my_dataset[0]
    # print('sent1-->', sent1)
    # print('sent2-->', sent2)
    # print('label-->', label)
    #2.构建dataloader
    my_dataloader = DataLoader(dataset=my_dataset, shuffle=True, batch_size=8, collate_fn=collate_fn, drop_last=True)

    # for input_ids, attention_mask, token_type_ids, labels in my_dataloader:
    #     print("input_ids-->", input_ids, input_ids.shape)
    #     print("labels-->", labels, labels.shape)
    #     break

    return my_dataloader


#4.定义模型
class MyModel(nn.Module):
    def __init__(self):
        super(MyModel, self).__init__()
        self.linear = nn.Linear(768, 2)

    def forward(self, input_ids, attention_mask, token_type_ids):
        with torch.no_grad():
            bert_out = bert_model(input_ids, attention_mask, token_type_ids=token_type_ids)
        #last_hidden_state:词向量, pooler_output:句向量
        # print("bert_out-->", bert_out)
        out = self.linear(bert_out['pooler_output'])
        return out


#测试模式类
def test_my_model():
    my_dataloader = get_dataloader()
    my_model = MyModel()
    print("my_model-->", my_model)
    for input_ids, attention_mask, token_type_ids, labels in my_dataloader:
        my_out = my_model(input_ids=input_ids, attention_mask=attention_mask, token_type_ids=token_type_ids)
        print("my_out-->", my_out)
        break

#5.模型训练
def train_model():
    #1.准备物料
    my_dataloader = get_dataloader()
    my_model = MyModel()
    my_optimizer = AdamW(params=my_model.parameters(), lr=5e-4)
    my_loss_fn = nn.CrossEntropyLoss()
    epochs = 3

    for param in bert_model.parameters():
        param.requires_grad_(False)

    my_model.train()

    for epoch in range(epochs):
        for i, (input_ids, attention_mask, token_type_ids, labels) in enumerate(my_dataloader):
            my_out = my_model(input_ids=input_ids, attention_mask=attention_mask, token_type_ids=token_type_ids)
            loss = my_loss_fn(my_out, labels)
            my_optimizer.zero_grad()
            loss.backward()
            my_optimizer.step()

            # 打印日志
            if i % 10 == 0:
                out = torch.argmax(my_out, -1)
                acc = (out == labels).sum().item() / len(labels)
                print('轮次:%d 迭代数:%d 损失:%.6f 准确率%.3f' % (epoch, i, loss.item(), acc))
        #保存模型
        torch.save(my_model.state_dict(), '../save/nsp_model_%d.bin' % (epoch + 1))

#6.模型评估
def evluate_model():
    my_dataset = MyDataset("../data/test.csv")
    my_dataloader = DataLoader(my_dataset, batch_size=8, shuffle=True, collate_fn=collate_fn, drop_last=True)
    my_model = MyModel()
    my_model.load_state_dict(torch.load("../save/nsp_model_3.bin"))

    correct = 0
    total = 0
    my_model.eval()

    for i,(input_ids, attention_mask, token_type_ids, labels) in enumerate(my_dataloader):
        with torch.no_grad():
            my_out = my_model(input_ids=input_ids, attention_mask=attention_mask, token_type_ids=token_type_ids)
        out = torch.argmax(my_out, dim=-1)
        correct += (out == labels).sum().item()
        total += len(labels)
        # 打印日志
        if i % 10 == 0:
            print("i-->", i, "准确率-->", correct/total)


if __name__ == '__main__':
    # get_dataloader()
    # test_my_model()
    # train_model()
    evluate_model()
【了解】NLP数据集
- CoLA 数据集
- SST-2 数据集
- MRPC 数据集
- STS-B 数据集
- QQP 数据集
- MNLI 数据集
- SNLI 数据集
- QNLI 数据集
- RTE 数据集
- WNLI 数据集
- diagnostics数据集
上述标准数据集,是用来衡量模型表现好坏的评估数据集。
也就是说,如果一个模型,在上述数据集上表现的都很好,那么这个模型就很Nice。也能够让业界接受。
【理解】BERT系列介绍
BERT概述
BERT是2018年10月由Google AI研究院提出的一种预训练模型。
全称:Bidirectional Encoder Representation from Transformers。
BERT模型架构
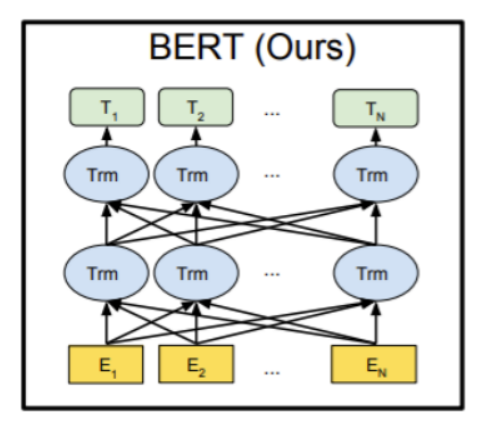
BERT中只使用了经典Transformer架构中的Encoder部分,完全舍弃了Decoder部分。
BERT模型由三部分组成:
- 最底层的Embedding模块
- token Embedding:第一个单词是CLS,可以用于之后的分类任务
- segment Embedding:段信息,区别两个句子
- position Embedding:位置信息
- 中间层的Transformer模块
- 双向Transformer,前后内容可以互相看得见
- 最顶层的预微调模块
- 最后一层任务可以根据需求做不同的调整
- 对于不同的任务,微调都集中在预微调模块
BERT预训练任务
BERT模型包含2个预训练任务
- 任务一: Masked LM (带mask的语言模型训练)
- 在原始训练文本中, 随机的抽取15%的token作为参与MASK任务的对象
- 在这些被选中的token中, 数据生成器并不是把它们全部变成[MASK], 而是有下列3种情况
- 在80%的概率下, 用[MASK]标记替换该token, 比如my dog is hairy -> my dog is [MASK]
- 在10%的概率下, 用一个随机的单词替换token, 比如my dog is hairy -> my dog is apple
- 在10%的概率下, 保持该token不变, 比如my dog is hairy -> my dog is hairy
- 任务二: Next Sentence Prediction (下一句话预测任务)
- 所有参与任务训练的语句都被选中作为句子A
- 其中50%的B是原始文本中真实跟随A的下一句话,标记为IsNext, 代表正样本
- 其中50%的B是原始文本中随机抽取的一句话,标记为NotNext, 代表负样本
BERT模型特点
优点
- 通过预训练, 加上Fine-tunning,在11项NLP任务上取得最优结果
- BERT的根基源于Transformer,相比传统RNN更加高效,可以并行化处理同时能捕捉长距离的语义和结构依赖
- BERT采用了Transformer架构中的Encoder模块,不仅仅获得了真正意义上的bidirectional context,而且为后续微调任务留出了足够的调整空间
缺点
-
BERT模型过于庞大,参数太多,不利于资源紧张的应用场景,也不利于上线的实时处理
-
BERT目前给出的中文模型中,是以字为基本token单位的,很多需要词向量的应用无法直接使用,同时该模型无法识别很多生僻词,只能以UNK代替
- BERT中第一个预训练任务MLM中,[MASK]标记只在训练阶段出现,而在预测阶段不会出现,这就造成了一定的信息偏差,因此训练时不能过多的使用[MASK],否则会影响模型的表现
- 按照BERT的MLM任务中的约定,每个batch数据中只有15%的token参与了训练,被模型学习和预测,所以BERT收敛的速度比left-to-right模型要慢很多(left-to-right模型中每一个token都会参与训练)
GPT模型介绍
GPT是OpenAI公司提出的一种语言预训练模型。
OpenAI GPT模型是在Google BERT模型之前提出的,与BERT最大的区别在于GPT采用了传统的语言模型方法进行预训练。即使用单词的上文来预测单词,而BERT是采用了双向上下文的信息共同来预测单词。
正是因为训练方法上的区别,使得GPT更擅长处理自然语言生成任务(NLG),而BERT更擅长处理自然语言理解任务(NLU)。
GPT模型架构
它是单向的Transformer模型。
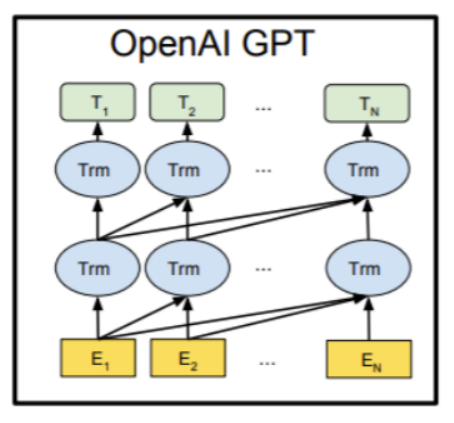
- 具体的遮掩操作是在slef-attention进行softmax之前进行的,一般的实现是将MASK的位置用一个无穷小的数值-inf来替换,替换后执行softmax计算得到新的结果矩阵。这样-inf的位置就变成了0。如上图所示,最后的矩阵可以很方便的做到当利用A预测B的时候,只能看到A的信息;当利用[A, B]预测C的时候,只能看到A,B的信息。
- 注意:对比于经典的Transformer架构,解码器模块采用了6个Decoder,GPT的架构中采用了12个Decoder。