第 3 节 / 共 8 节
线性回归(一)
线性回归
线性回归
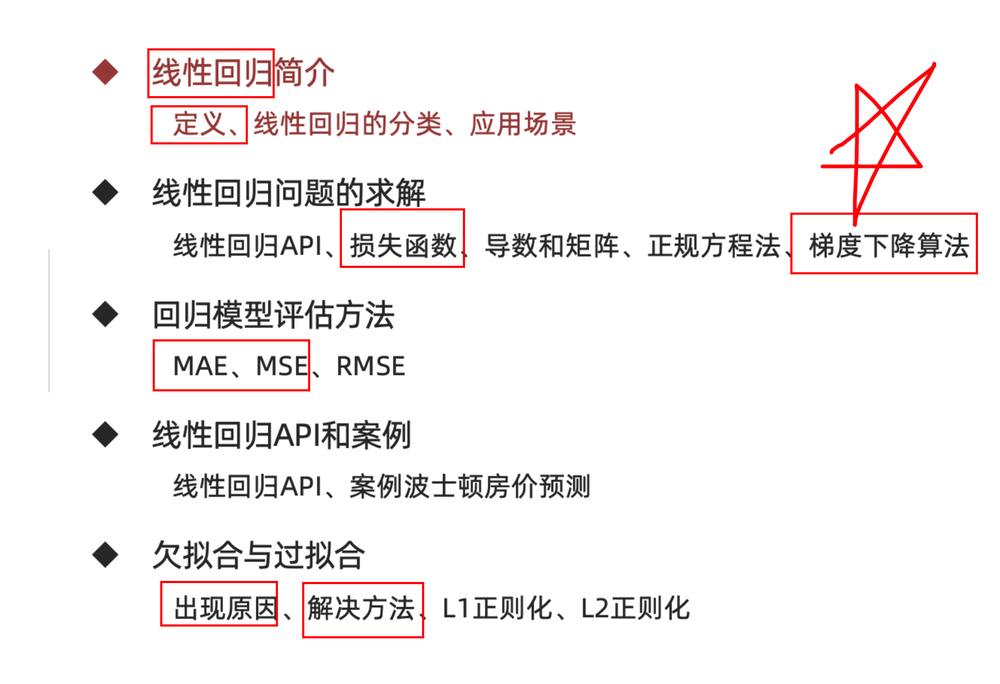
线性回归介绍
学习目标:
1.理解线性回归是什么?
2.知道一元线性回归和多元线性回归的区别
3.知道线性回归的应用场景
【理解】举个栗子
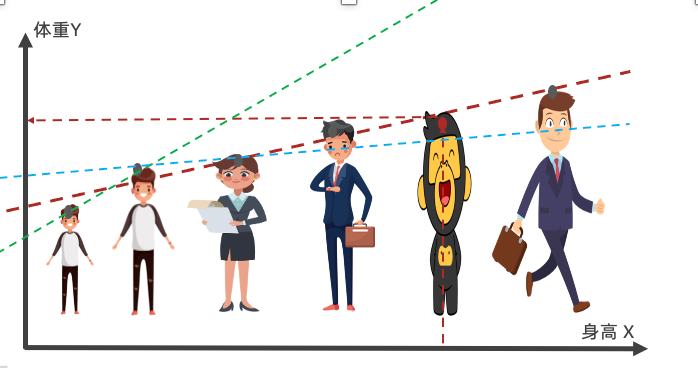
假若有了身高和体重数据,来了播仔的身高,你能预测播仔体重吗?
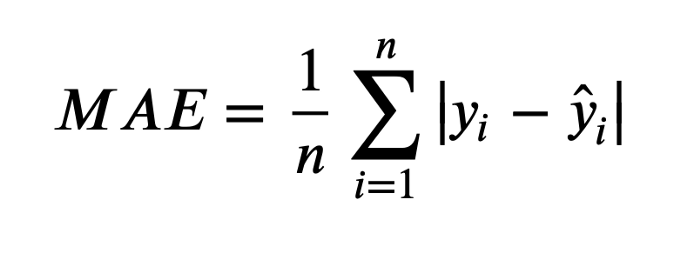
这是一个回归问题,该如何求解呢?
思路:先从已知身高X和体重Y中找规律,再预测
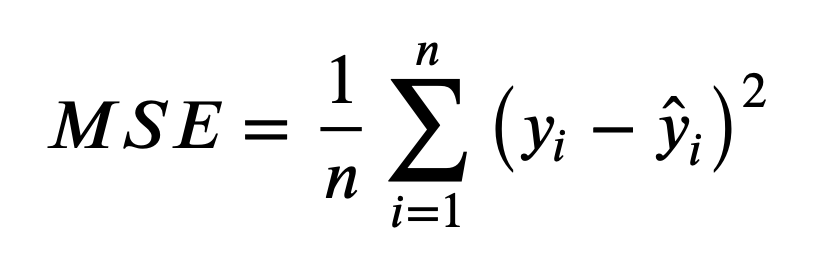
•数学问题:用一条线来拟合身高和体重之间的关系,再对新数据进行预测
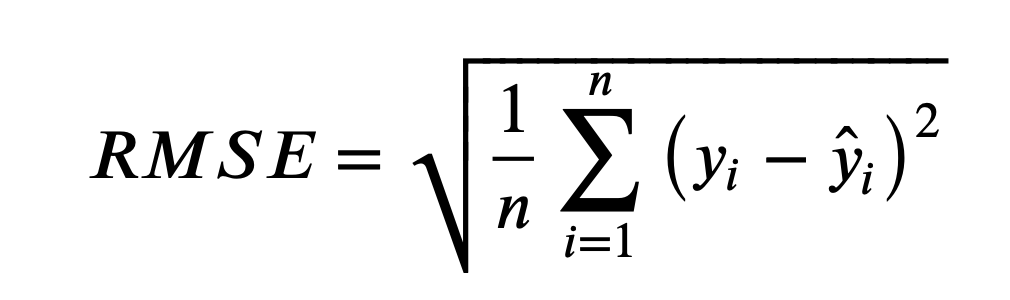
方程 Y = kX + b
k160 + b = 56.3 -- (1)
k166 + b = 60.6 –- (2)
。。。。
k: 斜率 b:截距
若:y = 0.9 x + (-93)
0.9*176 +(-93)= ?
【理解】线性回归
线性回归(Linear regression)是利用 回归方程(函数) 对 一个或多个自变量(特征值)和因变量(目标值)之间 关系进行建模的一种分析方式。
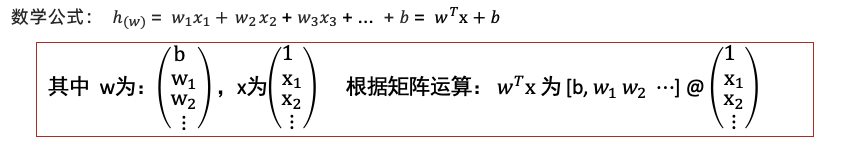
注意事项:
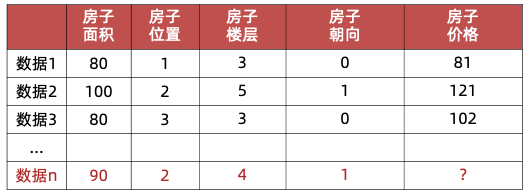
1 为什么叫线性模型?因为求解的w,都是w的零次幂(常数项)所以叫成线性模型
2 在线性回归中,从数据中获取的规律其实就是学习权重系数w
3 某一个权重值w越大,说明这个权重的数据对房子价格影响越大
【知道】线性回归分类
- 一元线性回归
y = kx +b
目标值只与一个因变量有关系
- 多元线性回归
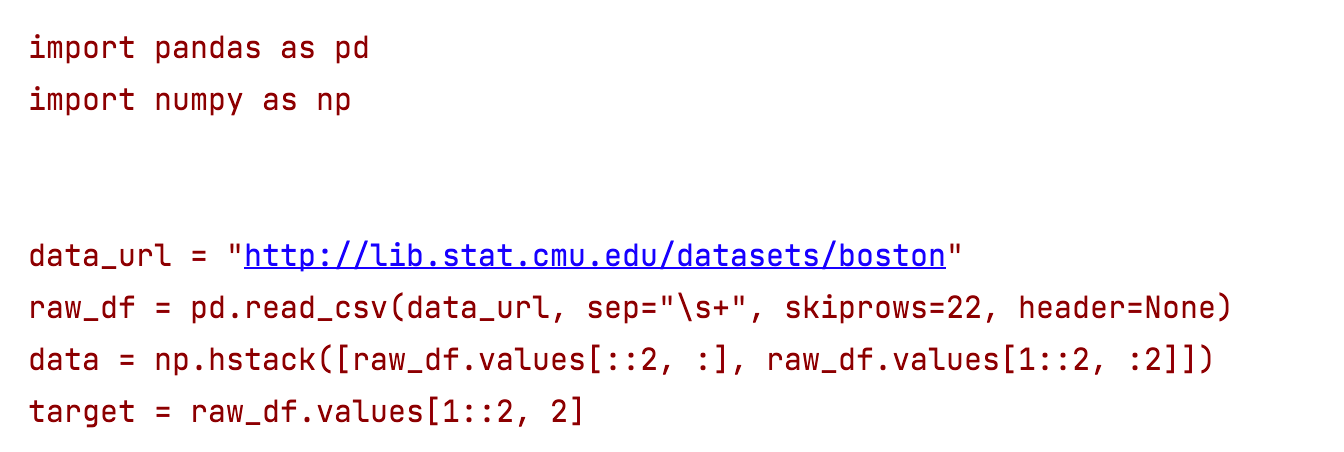
目标值只与多个因变量有关系
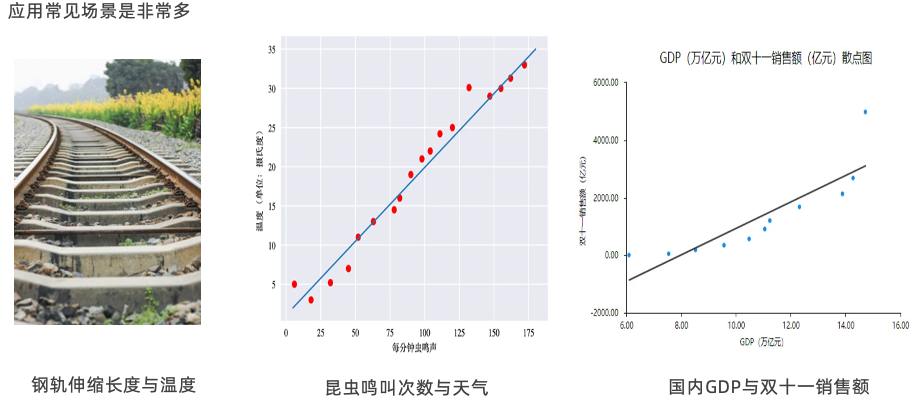
【知道】应用场景
线性回归问题的求解
学习目标:
1.知道线性回归API的使用
2.知道损失函数是什么
3.复习导数和矩阵的相关内容
4.理解正规方程法
5.掌握梯度下降算法的内容
【实操】线性回归API的应用
预测播仔身高
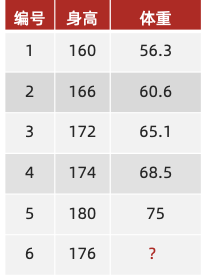
已知数据:
需求:播仔身高是176,请预测体重?
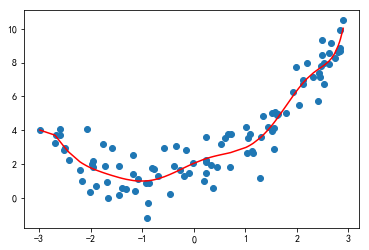
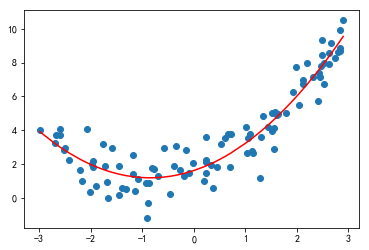
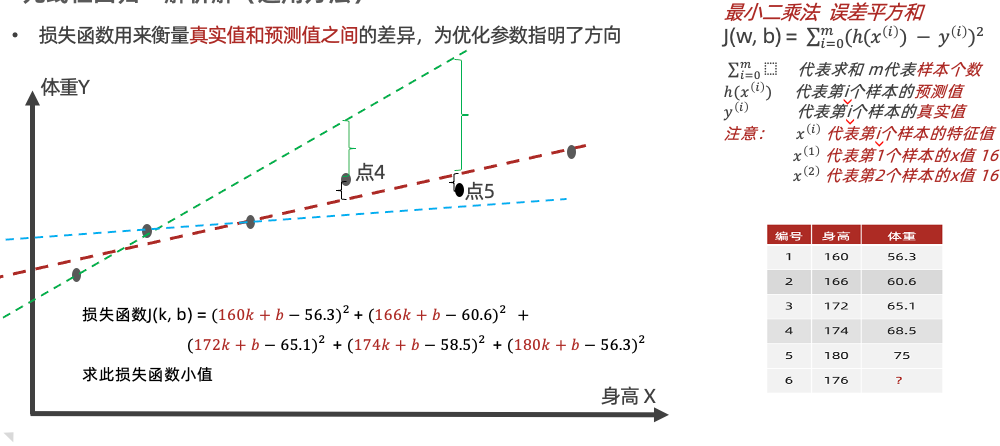
通过线性回归API可快速的找到一条红色直线,是怎么求解的呢?
【掌握】损失函数
需要设置一个评判标准
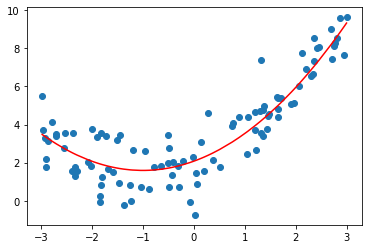
误差概念:用预测值y – 真实值y就是误差
损失函数:衡量每个样本预测值与真实值效果的函数
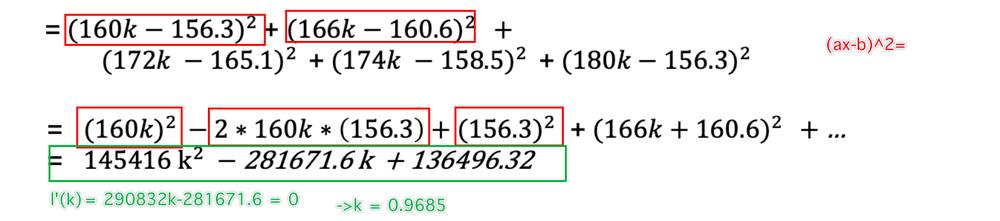
“红色直线能更好的拟合所有点”也就是误差最小,误差和最小
损失函数数学如何表达呢?又如何求损失函数的最小值呢?
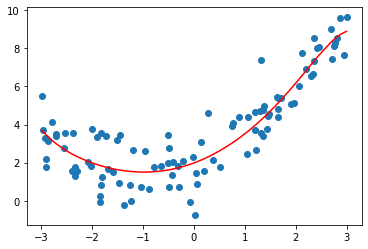
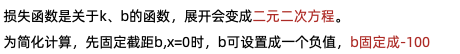
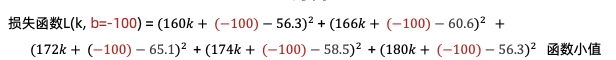
当损失函数取最小值时,得到k就是最优解
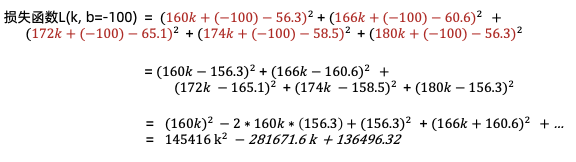
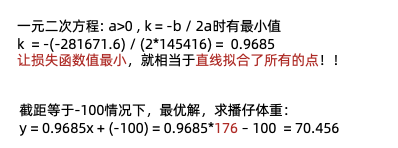
想求一条直线更好的拟合所有点 y = kx + b
-
引入损失函数(衡量预测值和真实值效果) Loss(k, b)
-
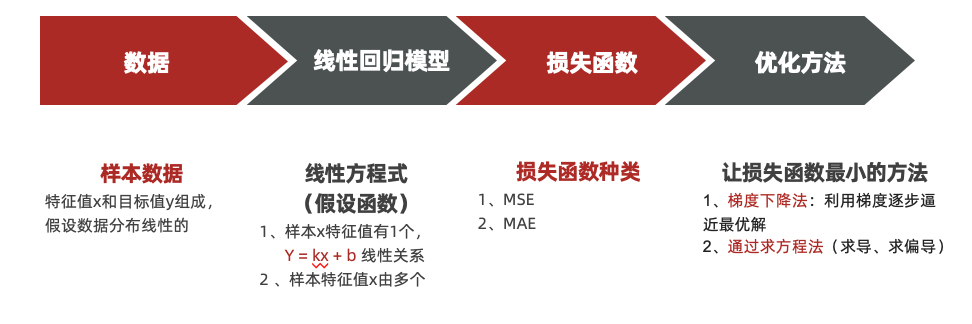
通过一个优化方法,求损失函数最小值,得到K最优解
回归的损失函数:
- 均方误差 (Mean-Square Error, MSE)
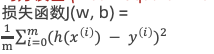
- 平均绝对误差 (Mean Absolute Error , MAE)
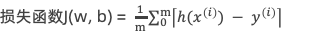
【复习】导数和矩阵
【知道】常见的数据表述
- 为什么要学习标量、向量、矩阵、张量?
- 因机器学习、深度学习中经常用,不要因是数学就害怕
- 宗旨:用到就学什么,不要盲目的展开、大篇幅学数学
- 标量scalar :一个独立存在的数,只有大小没有方向
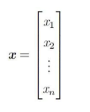
- 向量vector :向量指一列顺序排列的元素。默认是列向量
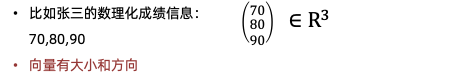
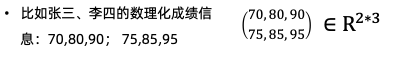
- 矩阵matrix :二维数组
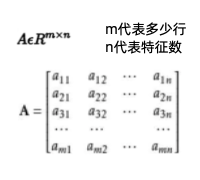
- 张量Tensor :多维数组,张量是基于向量和矩阵的推广
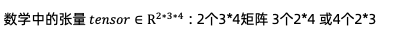
【知道】导数
当函数y=f(x)的自变量x在一点\(x_0\)上产生一个增量Δx时,函数输出值的增量Δy与自变量增量Δx的比值在Δx趋于0时的极限a如果存在,a即为在\(x_0\)处的导数,记作\(f^\prime(x_0)\)或df(\(x_0\))/dx。
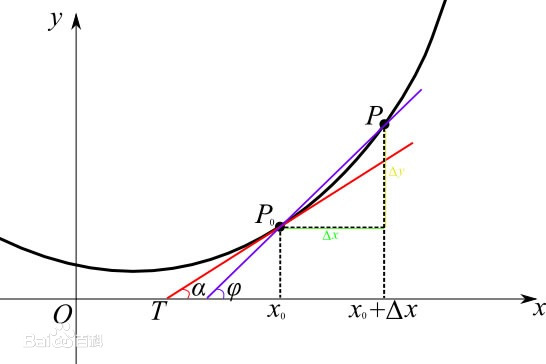
导数是函数的局部性质。一个函数在某一点的导数描述了这个函数在这一点附近的变化率。
函数在某一点的导数就是该函数所代表的曲线在这一点上的切线斜率
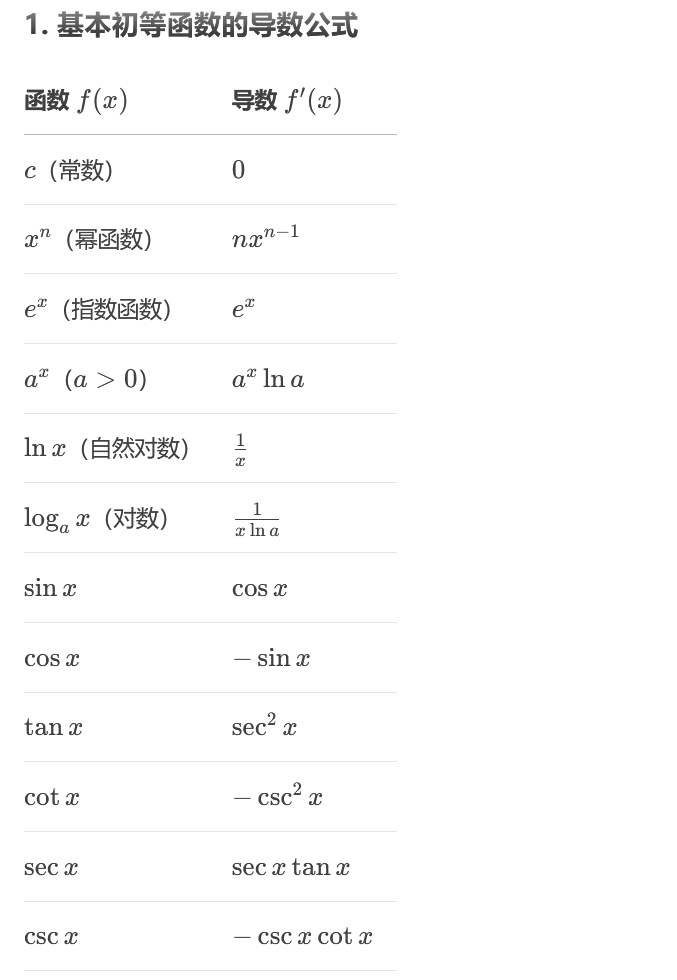
常见函数的导数:
| 公式 | 例子 |
|---|---|
| \((C)^\prime=0\) | \(\left(5\right)^\prime=0\) \(\left(10\right)^\prime=0\) |
| \(\left(x^\alpha\right)^\prime=\alpha x^{\alpha-1}\) | \(\left(x^3\right)^\prime=3 x^{2}\) \(\left(x^5\right)^\prime=5 x^{4}\) |
| \(\left(a^x\right)^\prime=a^{x}\ln{a}\) | \(\left(2^x\right)^\prime=2^x\ln{2}\) \(\left(7^x\right)^\prime=7^x\ln{7}\) |
| \(\left(e^x\right)^\prime=e^{x}\) | \(\left(e^x\right)^\prime=e^{x}\) |
| \(\left(\log{_a}x\right)^\prime=\frac{1}{x\ln{a}}\) | \(\left(\log{_{10}}x\right)^\prime=\frac{1}{x\ln{10}}\) \(\left(\log{_{6}}x\right)^\prime=\frac{1}{x\ln{6}}\) |
| \(\left(\ln{x}\right)^\prime=\frac{1}{x}\) | \(\left(\ln{x}\right)^\prime=\frac{1}{x}\) |
| \(\left(\sin{x}\right)^\prime=\cos{x}\) | \(\left(\sin{x}\right)^\prime=\cos{x}\) |
| \(\left(\cos{x}\right)^\prime=-\sin{x}\) | \(\left(\cos{x}\right)^\prime=-\sin{x}\) |
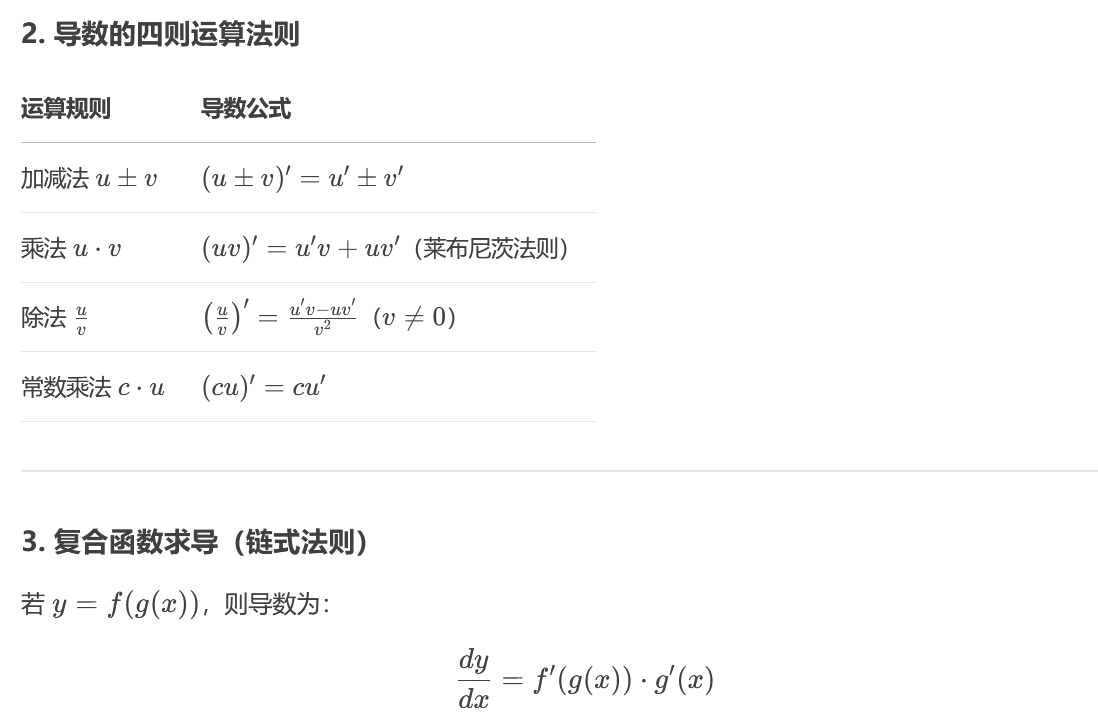
导数的四则运算:
| 公式 | 例子 |
|---|---|
| \(\left[u(x)\pm v(x)\right]^\prime=u^\prime(x) \pm v^\prime(x)\) | \((e^x+4\ln{x})^\prime=(e^x)^\prime+(4\ln{x})^\prime=e^x+\frac{4}{x}\) |
| \(\left[u(x)\cdot v(x)\right]^\prime=u^\prime(x) \cdot v(x) + u(x) \cdot v^\prime(x)\) | \((\sin{x}\cdot\ln{x})^\prime=\cos{x}\cdot\ln{x}+\sin{x}\cdot\frac{1}{x}\) |
| \(\left[\frac{u(x)}{v(x)}\right]^\prime=\frac{u^\prime(x) \cdot v(x) - u(x) \cdot v^\prime(x)}{v^2(x)}\) | \(\left(\frac{e^x}{\cos{x}}\right)^\prime=\frac{e^x\cdot\cos{x}-e^x\cdot(-\sin{x})}{cos^2(x)}\) |
| \(\{g[h(x)]\}^\prime=g^\prime(h)*h^\prime(x)\) | \((\sin{2x})^\prime=\cos{2x}\cdot(2x)^\prime=2\cos(2x)\) |
复合函数求导:g(h)是外函数 h(x)是内函数。先对外函数求导,再对内函数求导
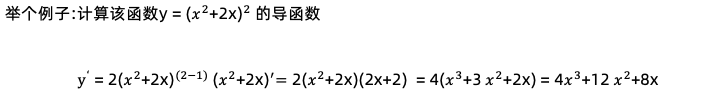
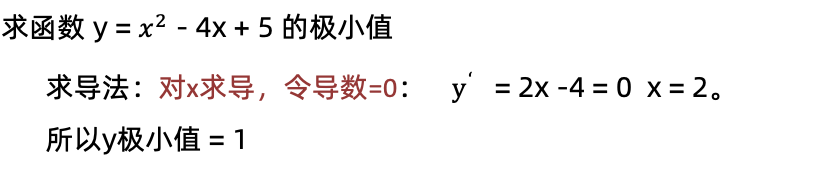
导数求极值:
导数为0的位置是函数的极值点
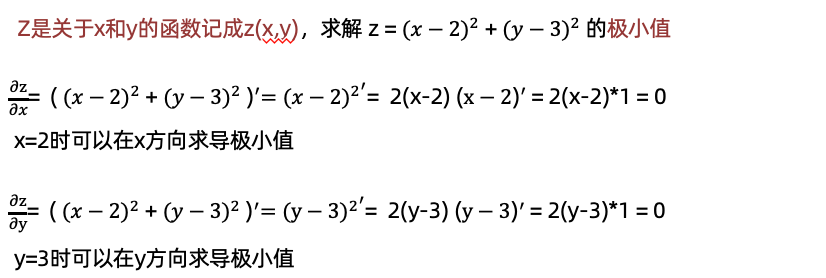
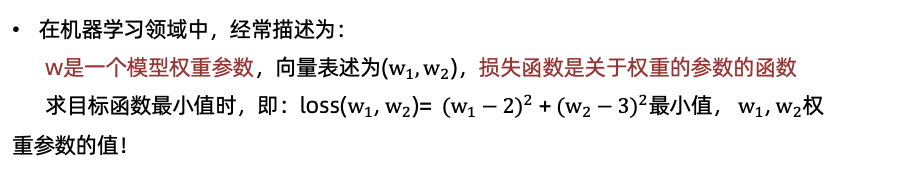
【知道】偏导
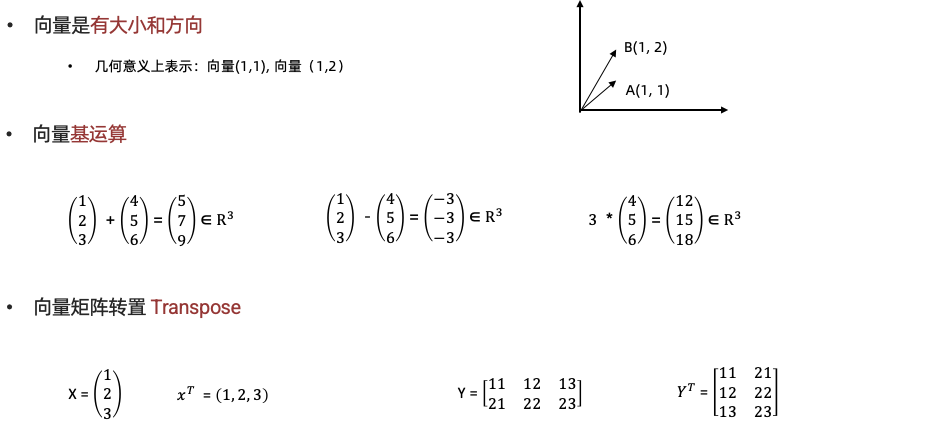
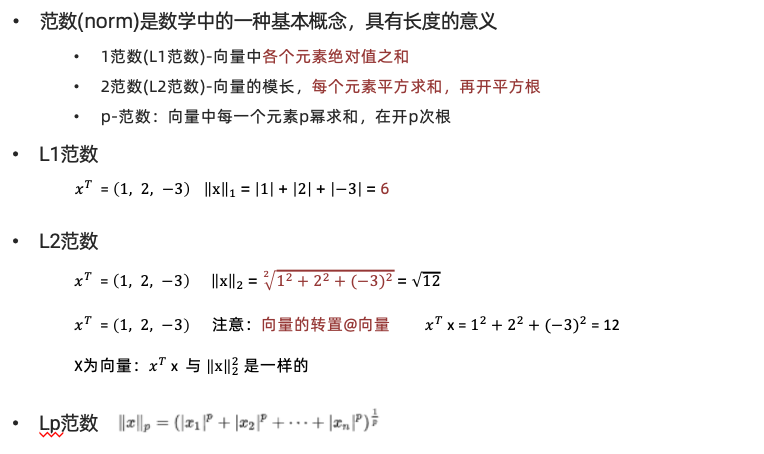
【知道】向量
向量运算:
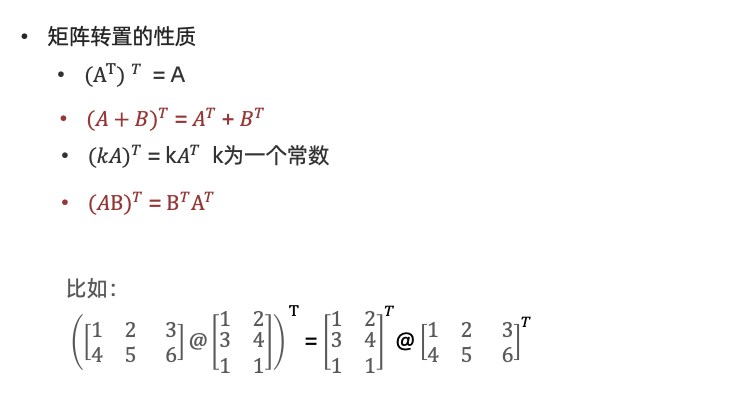
【知道】矩阵
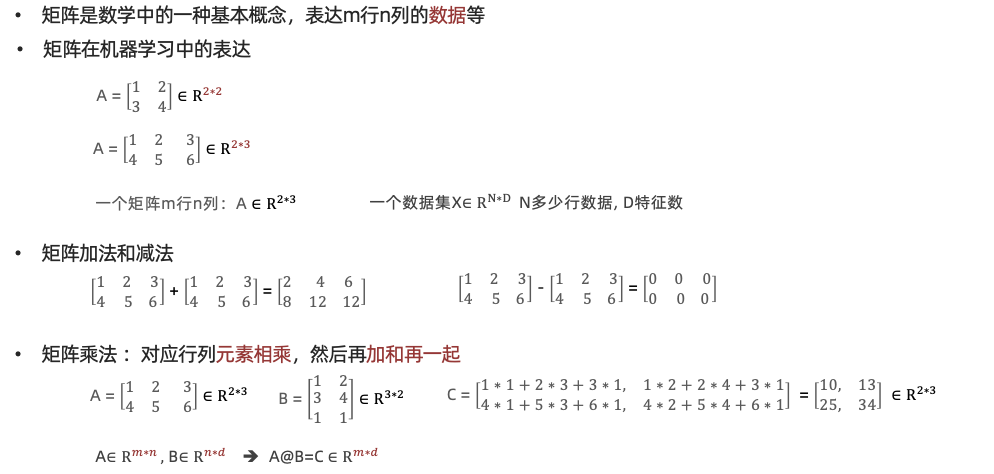
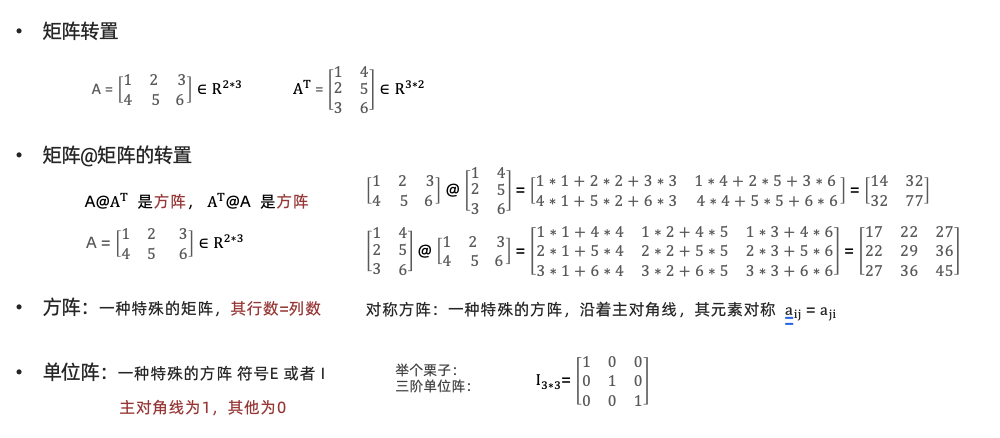
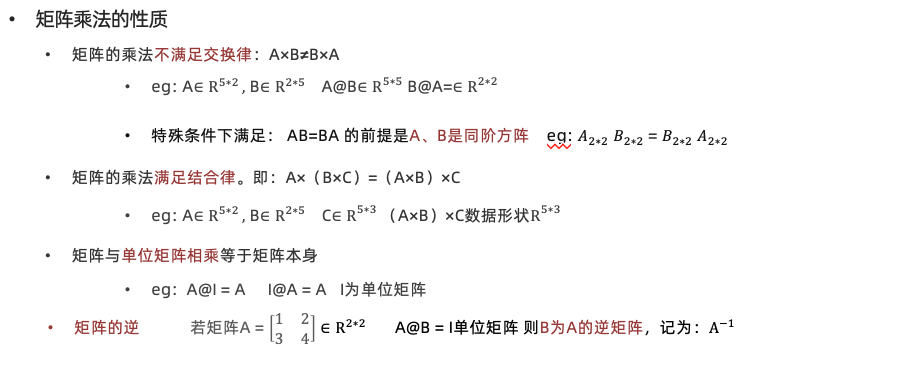
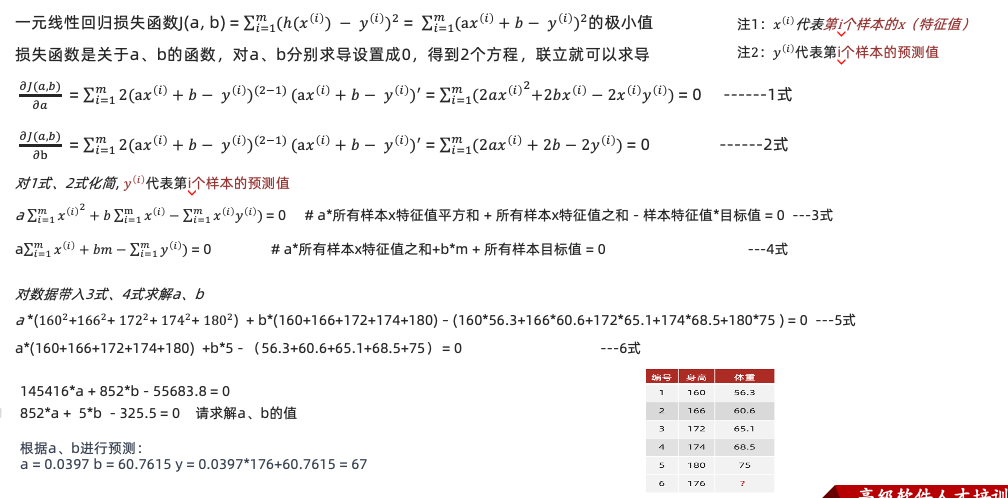
【了解】一元线性回归的解析解
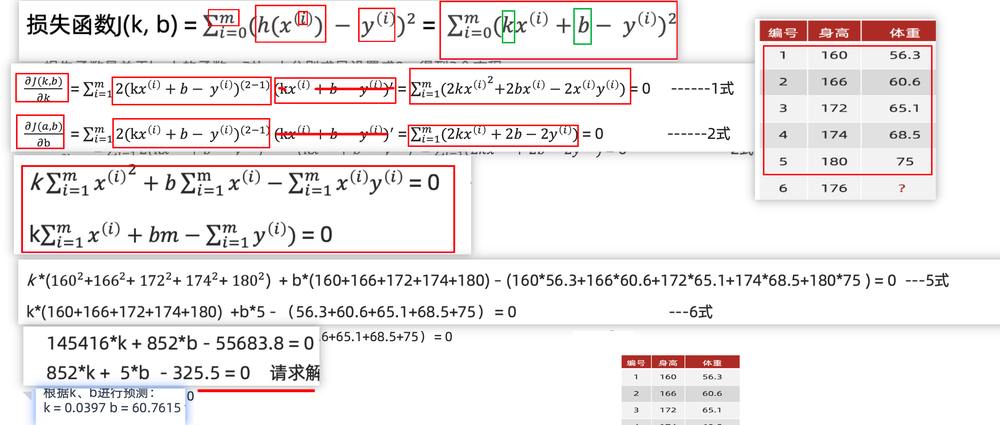
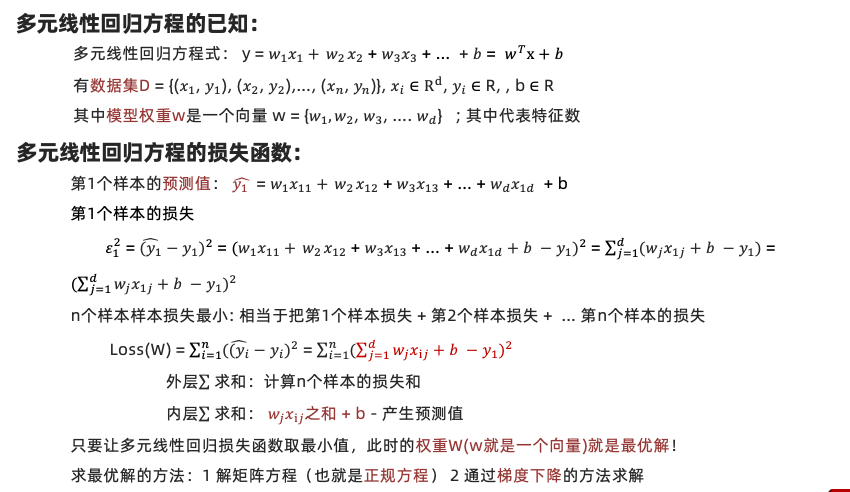
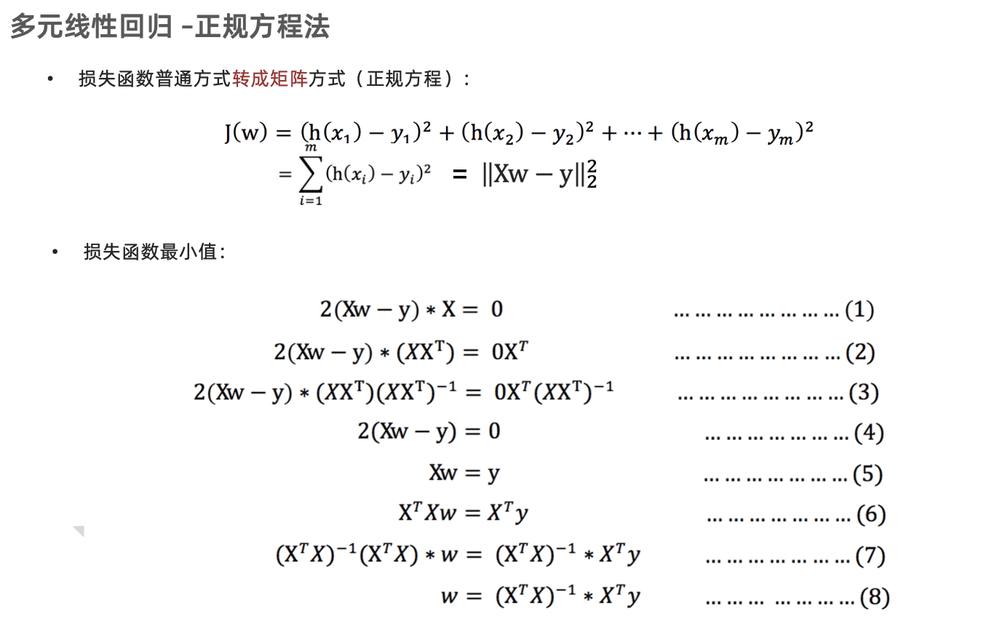
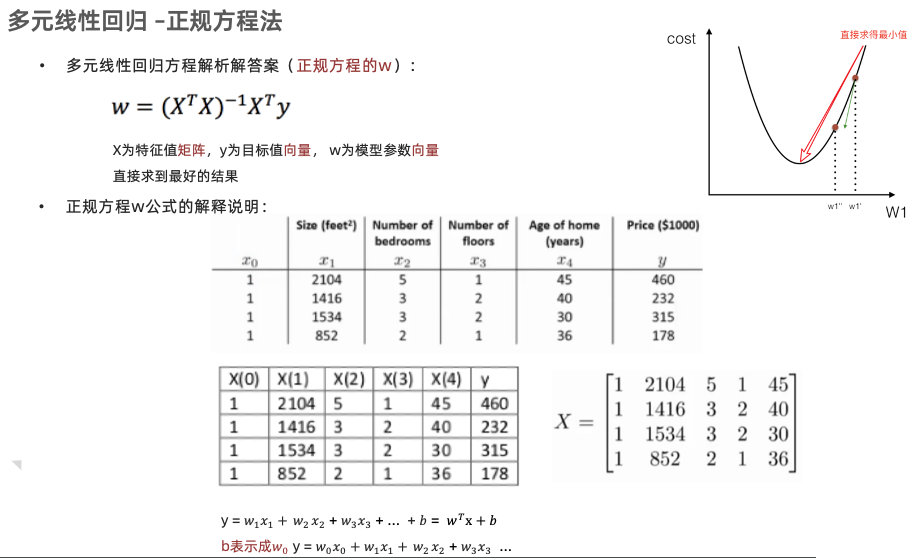
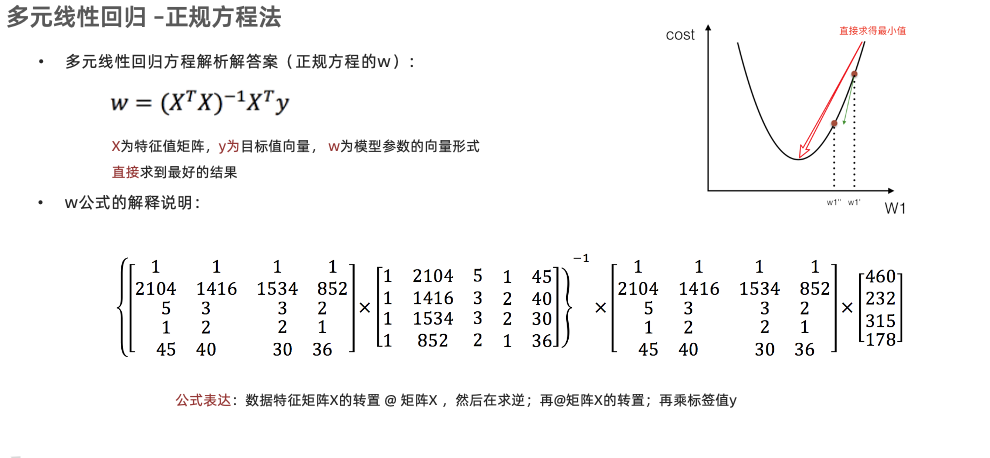
【了解】多元线性回归的解析解-正规方程法
梯度下降算法
【掌握】梯度下降算法思想
什么是梯度下降法
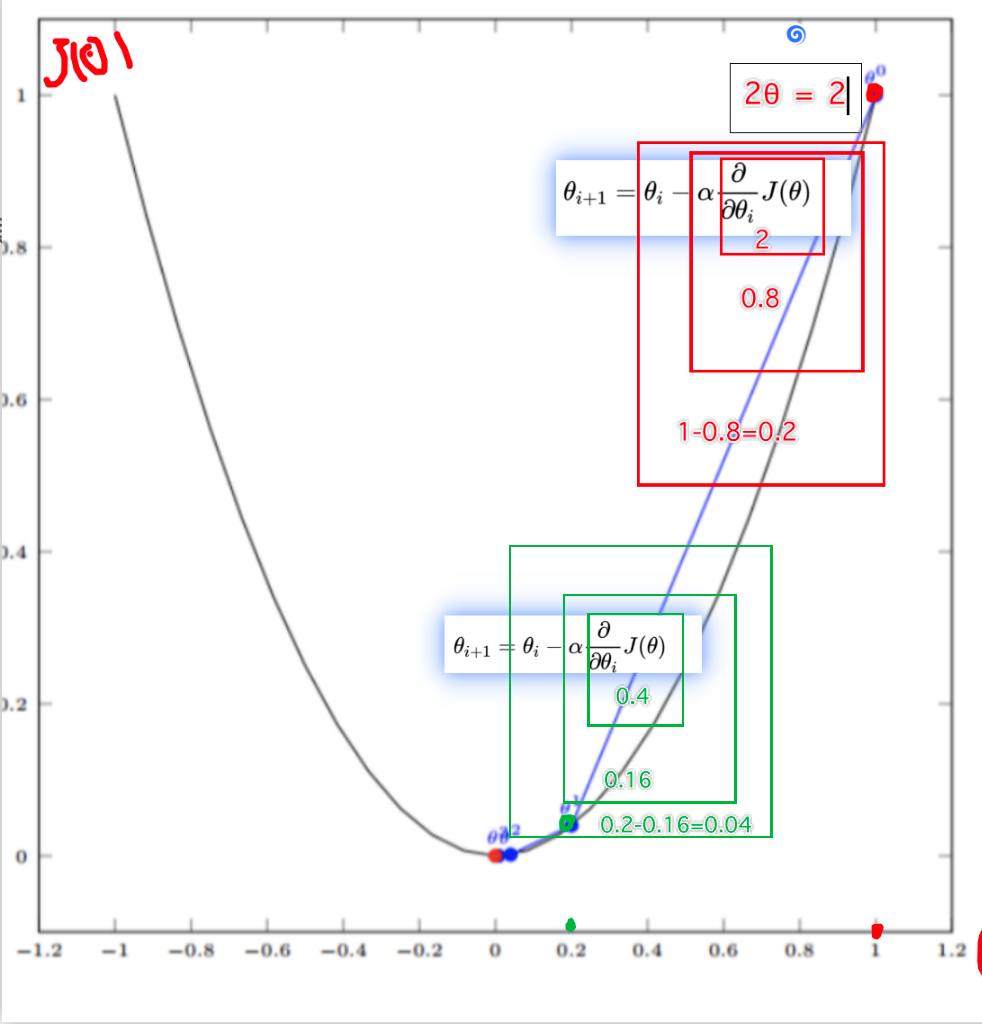
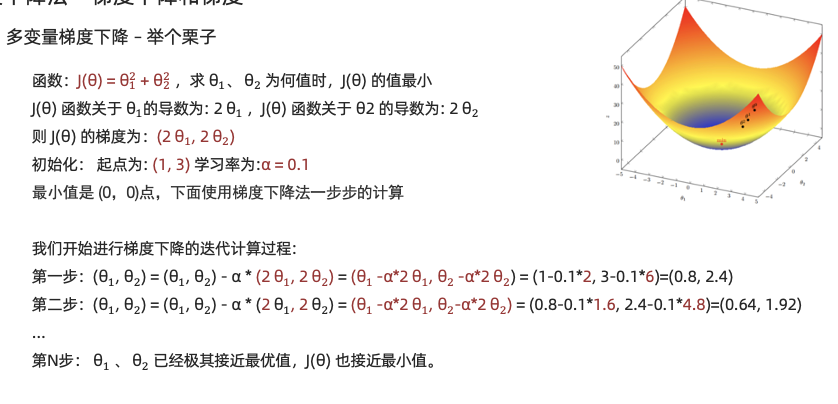
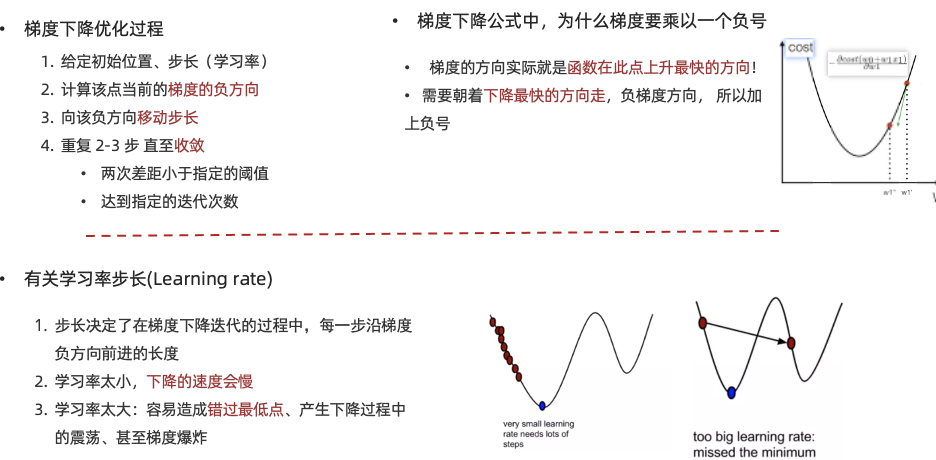
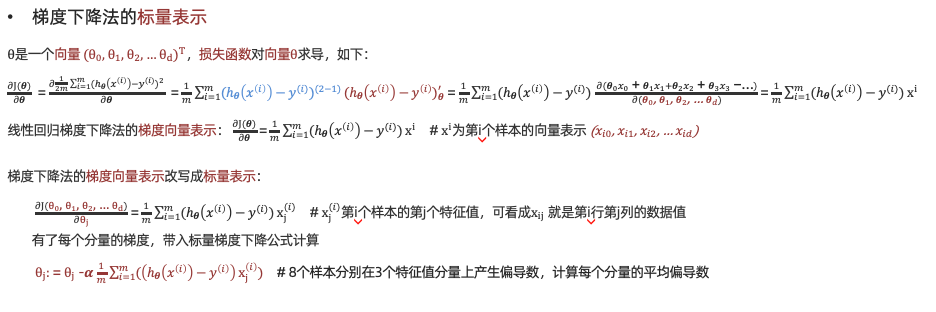
• 求解函数极值还有更通用的方法就是梯度下降法。顾名思义:沿着梯度下降的方向求解极小值 • 举个例子:坡度最陡下山法
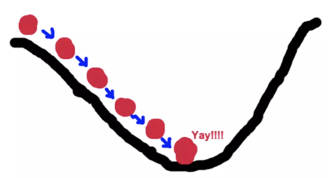
- 输入:初始化位置S;每步距离为a 。输出:从位置S到达山底
- 步骤1:令初始化位置为山的任意位置S
- 步骤2:在当前位置环顾四周,如果四周都比S高返回S;否则执行步骤3
- 步骤3: 在当前位置环顾四周,寻找坡度最陡的方向,令其为x方向
- 步骤4:沿着x方向往下走,长度为a,到达新的位置S‘
- 步骤5:在S‘位置环顾四周,如果四周都比S‘高,则返回S‘。否则转到步骤3
小结:通过循环迭代的方法不断更新位置S (相当于不断更新权重参数w)
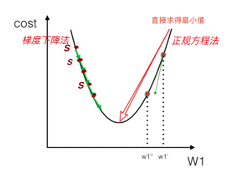
最终找到最优解 这个方法可用来求损失函数最优解, 比正规方程更通用
梯度下降过程就和下山场景类似
可微分的损失函数,代表着一座山
寻找的函数的最小值,也就是山底
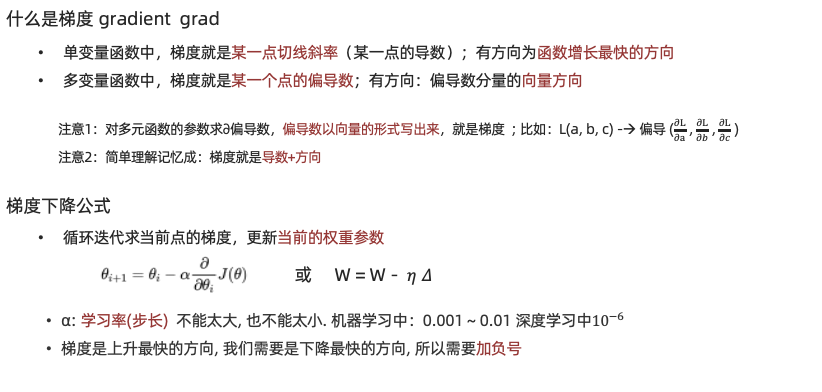
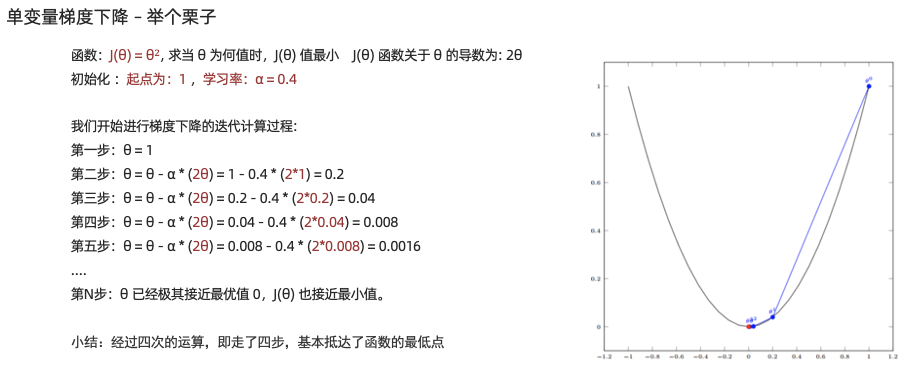
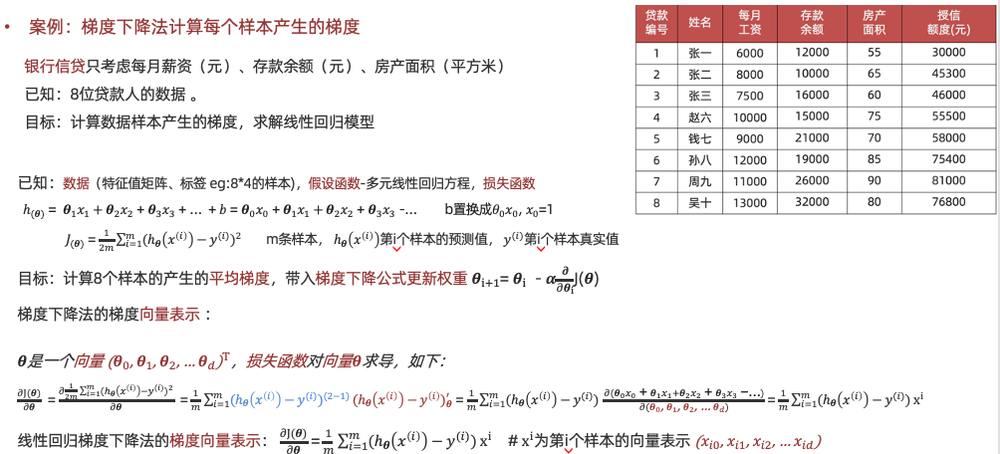
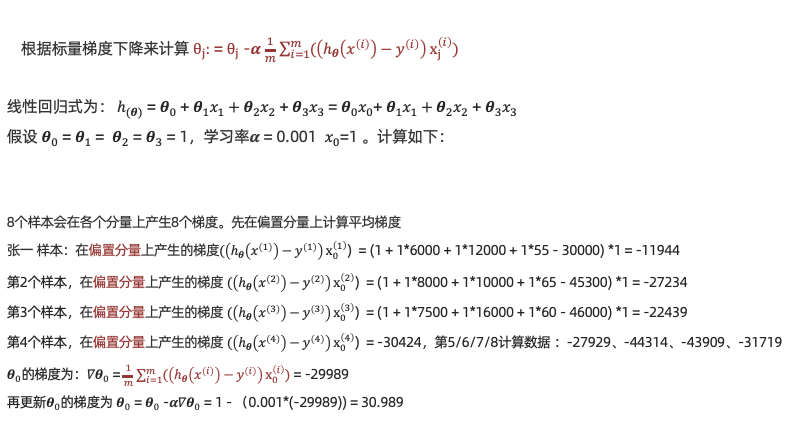
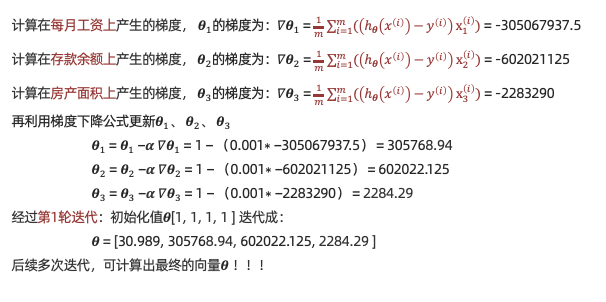
【理解】银行信贷案例
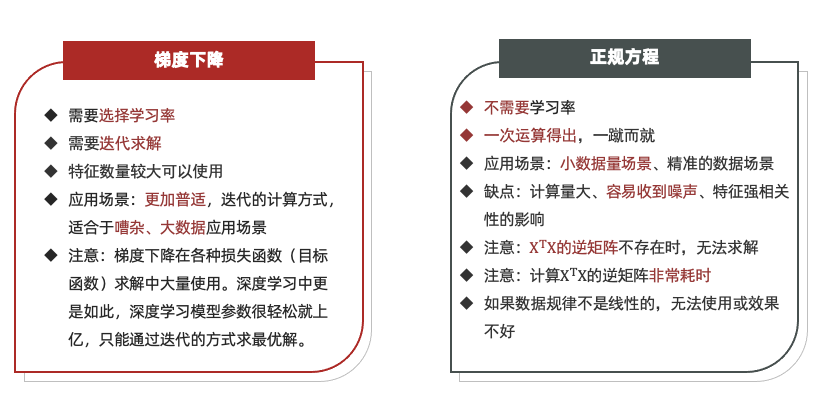
【理解】正规方程和梯度下降算法的对比
作业
1.完成线性回归部分的思维导图
2.知道线性回归是什么?及应用场景
3.损失函数是什么及其作用
4.梯度下降是什么以及其作用
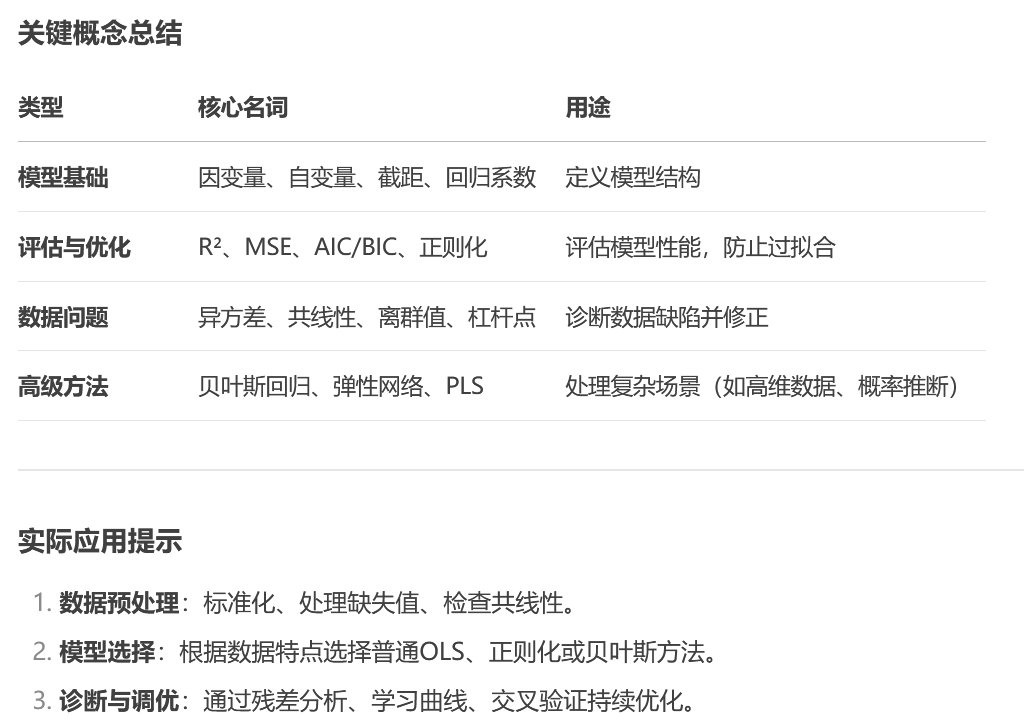
补充:线性回归概念汇总
线性回归概念汇总
线性回归是统计学和机器学习中最基础、最常用的监督学习算法之一,用于建模因变量(目标变量)与一个或多个自变量(特征)之间的线性关系。其核心思想是通过拟合一条直线(或超平面)来预测或解释数据的变化趋势。
常见:
1. 因变量(Dependent Variable)
- 解释:需要预测的目标变量(通常记为 yy)。
- 示例:预测房价时,房价就是因变量。
2. 自变量(Independent Variable)
- 解释:用于预测因变量的特征变量(通常记为 XX 或 x1,x2,…x1,x2,…)。
- 示例:预测房价时,房屋面积、卧室数量等是自变量。
3. 回归系数(Coefficients)
- 解释:自变量的权重(通常记为 β1,β2,…β1,β2,…),表示自变量对因变量的影响程度。
- 示例:模型 y=2x+3y=2x+3 中,22 是回归系数。
4. 截距(Intercept)
- 解释:当所有自变量为 0 时因变量的值(通常记为 β0β0)。
- 示例:模型 y=2x+3y=2x+3 中,33 是截距。
5. 残差(Residual)
- 解释:实际值 yy 与模型预测值 y^y^ 的差值(即 y−y^y−y^)。
- 作用:用于评估模型误差。
6. 损失函数(Loss Function)
- 解释:衡量模型预测误差的函数(如均方误差 MSE)。
- 公式:MSE=1n∑(yi−y^i)2MSE=n1∑(yi−y^i)2。
7. 最小二乘法(Ordinary Least Squares, OLS)
- 解释:通过最小化残差平方和来拟合模型的方法。
8. 拟合优度(Goodness of Fit)
- 指标:
- R²(决定系数):模型解释因变量变异的比例(0~1,越接近1越好)。
- 调整R²:考虑自变量数量后的修正R²,避免过拟合。
9. 多重共线性(Multicollinearity)
- 解释:自变量之间高度相关,导致回归系数估计不稳定。
- 检测方法:方差膨胀因子(VIF > 10 时需处理)。
10. 过拟合(Overfitting)
- 解释:模型在训练集上表现好,但在测试集上表现差。
- 解决方法:正则化(如Lasso/Ridge回归)、减少特征数量。
11. 正则化(Regularization)
- 目的:防止过拟合,通过在损失函数中增加惩罚项。
- 类型:
- L1(Lasso回归):稀疏化系数(某些系数变为0)。
- L2(Ridge回归):缩小系数但不归零。
12. 假设检验(Hypothesis Testing)
- 用途:检验回归系数是否显著(如 pp-值 < 0.05)。
- 常见检验:t检验(单个系数)、F检验(整体模型显著性)。
13. 标准化(Standardization)
- 解释:将自变量缩放到均值为0、标准差为1(如Z-score标准化)。
- 作用:解决不同量纲对系数的影响。
14. 梯度下降(Gradient Descent)
-
解释:迭代优化算法,用于最小化损失函数(尤其适用于大数据)。
-
类型:批量梯度下降、随机梯度下降(SGD)。
其他:
15. 误差项(Error Term / Residual Error)
- 解释:模型无法解释的随机波动部分(记为 ϵϵ),代表实际值与预测值的偏差。
- 假设:通常假设误差服从均值为0、方差为 σ2σ2 的正态分布(即 ϵ∼N(0,σ2)ϵ∼N(0,σ2))。
16. 异方差性(Heteroscedasticity)
- 解释:误差项的方差随自变量变化而变化(违反同方差假设)。
- 影响:导致回归系数估计不准确。
- 解决方法:加权最小二乘法(WLS)、变量变换(如取对数)。
17. 同方差性(Homoscedasticity)
- 解释:误差项的方差恒定(是线性回归的理想假设之一)。
18. 杠杆点(Leverage Point)
- 解释:自变量取值极端的观测点,可能对模型拟合产生过大影响。
- 检测:通过帽子矩阵(Hat Matrix)的杠杆值(如 > 2k/n2k/n 时需注意,kk 为变量数)。
19. 离群值(Outlier)
- 解释:与大多数数据明显偏离的观测点,可能扭曲模型结果。
- 检测方法:学生化残差(Studentized Residual)、Cook距离(Cook’s Distance)。
20. 共线性(Collinearity)
- 解释:自变量间存在线性关系(多重共线性是极端情况)。
- 影响:回归系数不稳定,难以解释。
- 处理:删除冗余变量、主成分分析(PCA)。
21. 交互项(Interaction Term)
- 解释:两个自变量的乘积项(如 x1×x2x1×x2),用于捕捉变量间的协同效应。
- 示例:广告投入和季节对销量的联合影响。
22. 虚拟变量(Dummy Variable)
- 解释:用于表示分类变量的二元变量(0或1)。
- 示例:性别(男=1,女=0)在回归中的编码。
23. 岭回归(Ridge Regression)
- 解释:L2正则化的线性回归,通过惩罚系数平方和防止过拟合。
- 公式:损失函数增加 λ∑βi2λ∑βi2。
24. 拉索回归(Lasso Regression)
- 解释:L1正则化的线性回归,可将某些系数压缩为0(特征选择)。
- 公式:损失函数增加 λ∑∣βi∣λ∑∣βi∣。
25. 弹性网络(Elastic Net)
- 解释:结合L1和L2正则化的回归,适用于高维数据。
- 公式:λ1∑∣βi∣+λ2∑βi2λ1∑∣βi∣+λ2∑βi2。
26. 偏最小二乘法(Partial Least Squares, PLS)
- 解释:适用于自变量高度相关的降维回归方法。
27. 稳健回归(Robust Regression)
- 解释:减少离群值影响的回归方法(如Huber损失函数)。
28. 贝叶斯线性回归(Bayesian Linear Regression)
- 解释:基于贝叶斯定理的回归,提供参数的概率分布而非点估计。
29. 特征缩放(Feature Scaling)
- 方法:归一化(Min-Max)、标准化(Z-Score)。
- 目的:加速梯度下降收敛,避免量纲差异。
30. 学习曲线(Learning Curve)
- 解释:训练集和验证集误差随样本量变化的曲线,用于诊断偏差/方差问题。
31. 交叉验证(Cross-Validation)
- 常用方法:k折交叉验证(k-Fold CV),评估模型泛化能力。
32. AIC / BIC(信息准则)
- 解释:用于模型选择,平衡拟合优度和复杂度(越小越好)。
- AIC:2k−2ln(L)2k−2ln(L)
- BIC:kln(n)−2ln(L)kln(n)−2ln(L)
33. 方差膨胀因子(VIF)
- 解释:量化多重共线性程度(VIF > 10 表示严重共线性)。
34. 逐步回归(Stepwise Regression)
- 方法:前向选择、后向剔除、双向逐步,用于特征筛选。
35. 非线性关系的线性化
- 方法:对变量进行变换(如对数、多项式),拟合非线性关系。
补充:导数公式汇总
导数公式汇总
求导公式是微积分中的基本工具,用于计算函数的导数(瞬时变化率)
今日板书
- 🖼️ 今日板书-上.png 258.6KB
- 🖼️ 今日板书-下.png 281.7KB